


 Hogar
Los laboratorios de IA pagan a XDOF por la recopilación de datos desordenados para el entrenamiento de robots
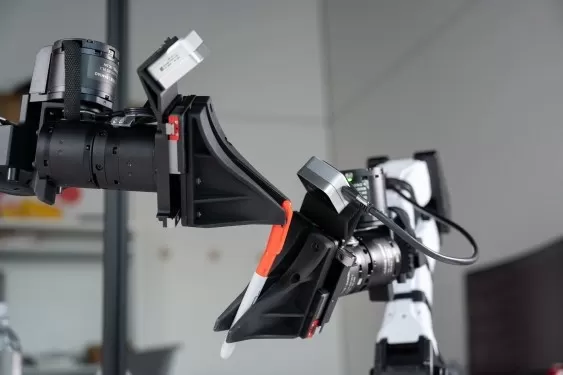
Hace dos semanas, OpenAI anunció que reactivaría el programa de robótica que había cerrado en 2021, la última señal de que los principales laboratorios de IA compiten por enseñar a las máquinas a desenvolverse en el mundo físico. Pero construir robots capaces requiere algo de lo que la industria de la IA aún carece: datos de entrenamiento equivalentes a los que utilizan los modelos de lenguaje.
Esta carencia está impulsando un nuevo tipo de negocio de infraestructuras. A diferencia de los modelos de lenguaje a gran escala (LLM), que se entrenaron con enormes cantidades de texto disponible públicamente, los robots necesitan datos que capturen interacciones físicas —y ese tipo de datos apenas existe—. Los vídeos de YouTube y las grabaciones de trabajadores autónomos son de baja calidad y difíciles de alinear con el mundo físico.
XDOF (que se pronuncia «ecks-doff»), que hoy sale del modo sigiloso, cree que el próximo gran cuello de botella en la IA no serán los modelos ni los chips, sino el ciclo de retroalimentación de datos necesario para enseñar a los robots a interactuar con el mundo físico.
La startup tiene como objetivo crear los canales de datos, las herramientas de recopilación y los sistemas de anotación que los laboratorios de vanguardia y las empresas de robótica no pueden desarrollar fácilmente por sí mismos, y para ello ha recaudado 70 millones de dólares de Thrive Capital, Spark Capital, a16z, Lux y WndrCo. El cofundador y director ejecutivo, Philippe Wu, afirma que XDOF, que cuenta con una plantilla de unas 60 personas, ya está trabajando con 20 clientes, entre los que se incluyen varios laboratorios punteros de IA, aunque no puede revelar sus nombres.
«Todos los laboratorios punteros están intentando avanzar en robótica», afirmó Wu. «Ya hemos visto algunas de las desventajas de quedarnos ligeramente rezagados en la carrera por los modelos de lenguaje… No quieres acabar en una situación en la que te lances a por esta tecnología demasiado tarde, y todo el mundo se encuentre en la misma situación, en la que la IA física es la próxima frontera».
Wu se topó con este problema de primera mano cuando era estudiante de doctorado en la Universidad de California en Berkeley. Su objetivo era conseguir que los robots aprendieran habilidades a partir de conjuntos de datos a gran escala. Solo había un problema.
«No disponíamos de datos a gran escala con los que trabajar», explicó a TechCrunch. «Se trataba de un problema del huevo y la gallina: primero teníamos que recopilar datos antes incluso de poder plantearnos cómo entrenar un modelo base para la robótica».
Wu y su futuro cofundador y director técnico de XDOF, Fred Shentu, trabajaron en un proyecto llamado GELLO, un sistema de teleoperación de bajo coste que permite a un operador humano controlar un brazo robótico para generar datos de entrenamiento. «Acabó convirtiéndose en un artículo muy influyente en el ámbito de la robótica, porque mucha gente tenía necesidades y obstáculos similares, y muchos empezaron a aprovechar este tipo de dispositivos para la recopilación de datos», explicó Wu.
Al detectar la oportunidad, Wu, Shentu y el tercer cofundador y director de operaciones, Nemo Jin, lanzaron XDOF en octubre de 2024 con el objetivo de proporcionar un ecosistema de datos a las empresas que desarrollan modelos robóticos. Conscientes de que el mero suministro de datos puede ser un negocio sin futuro, la empresa también se centra en la limpieza de datos, las herramientas y la anotación, creando así un bucle de retroalimentación que se refuerza a sí mismo para los entrenadores de robots.
Como punto de partida, la empresa se ha asociado con el laboratorio de investigación en IA de la Universidad de California en Berkeley para publicar lo que considera la mayor colección de datos de entrenamiento de robots de alta calidad jamás recopilada, denominada ABC. Incluye 130 000 trayectorias de datos de manipulación robótica, 300 horas de simulación y 100 horas de evaluaciones. Nunca antes se había puesto a disposición del mundo académico un conjunto de datos de preentrenamiento a tan gran escala.
«Hemos visto en el ámbito del lenguaje, la generación de imágenes y otros campos que, cuando se publican modelos y datos, la comunidad logra cosas que no necesariamente se habrían esperado», explicó a TechCrunch David McAllister, un estudiante de doctorado de Berkeley que ayudó a organizar la publicación.
El equipo ya ha utilizado los datos para entrenar a robots en tareas de referencia como doblar camisetas y aplanar cajas, o colocar AirPods en sus estuches.
Grados de libertad ilimitados
La empresa tiene previsto trabajar en tres niveles de una pirámide de datos. El nivel más valioso es el de los datos de teleoperación recopilados en el propio robot que se está utilizando; a continuación, están los robots teleoperados que recopilan datos más generales, como en el caso de GELLO; y, por último, los datos «egocéntricos» recopilados por personas que realizan tareas cotidianas, para lo cual XDOF tiene previsto desarrollar sus propios sensores portátiles.
«La elección de la cámara va a afectar a la calidad de los datos, lo que a su vez influirá en el rendimiento del algoritmo de seguimiento de manos», explicó Wu. «Si no se diseña bien el hardware desde el principio, los datos recopilados podrían presentar problemas muy específicos que no se habían previsto».
La empresa tiene previsto contratar y formar a un gran número de teleoperadores y operadores de datos egocéntricos en todo el mundo —un modelo que requiere mucha mano de obra y que plantea una pregunta obvia: ¿por qué los principales laboratorios no realizan ellos mismos esta labor de producción de datos?
«Se necesita un almacén de cientos de miles de pies cuadrados con cientos de robots», explicó Wu. «Hay que mantener estos robots, calibrar sus parámetros físicos y formar adecuadamente a los operadores».
Se trata de una inversión que requiere dedicación, capital y una escala operativa que la mayoría de los laboratorios de IA preferirían externalizar —que es precisamente el mercado por el que apuesta XDOF—.
El nombre XDOF es un juego de palabras con el término robótico «grados de libertad», que describe el número de movimientos independientes que puede realizar un robot. Tu brazo, desde el hombro hasta la muñeca, tiene siete grados de libertad. El último robot de la empresa de robótica humanoide Figure.AI tiene 30. La «X» del nombre de la empresa refleja su ambición: «Grados de libertad arbitrarios, grados de libertad ilimitados», afirma Wu.
Artículo relacionado
 Suno añade marcas de agua a las canciones en medio de batallas legales
Suno, la plataforma que permite a los usuarios generar música creada por inteligencia artificial, ha presentado nuevas funciones para etiquetar las pistas producidas en la plataforma, restringir las descargas y actualizar las normas de la comunidad c
Musk admite que Grok filtró código de usuarios, promete borrar todos los datos históricos
Elon Musk abordó directamente la controversia por privacidad relacionada con Grok Build, comenzando con un simple "Verdadero" para confirmar la validez del incidente. Se comprometió a que todos los datos de usuario cargados previamente en SpaceXAI se
Las acciones de EE. UU. alcanzan un hito histórico mientras gigantes de la IA y la aeroespacial se preparan para su debut de un billón de dólares
Elon Musk, Sam Altman y Dario Amodei, tres titanes del sector tecnológico, están avanzando hacia ofertas públicas iniciales para sus respectivas empresas. Con SpaceX, OpenAI y Anthropic, tres gigantes de la industria que se acercan a valoraciones de
Recomendaciones de temas especiales relacionados
SEO
 Las mejores herramientas de análisis de SERP basadas en IA para la estrategia de búsqueda
Las mejores herramientas de análisis de SERP con IA mejor valoradas de 2026 para la estrategia de búsqueda han sido seleccionadas por XIX.AI tras rigurosas pruebas en condiciones reales y clasificaciones que se actualizan semanalmente. Estas potentes herramientas te ayudan a descubrir oportunidades de optimización ocultas, a mejorar el rendimiento de tu contenido y a obtener una ventaja competitiva en los motores de búsqueda. Descubre hoy mismo la herramienta perfecta para mejorar tu estrategia de búsqueda. ¡Explora ahora!
 13 herramientas
 xix.ai
Análisis de datos
Mejores herramientas de IA para la detección de anomalías en el monitoreo de KPIs para equipos de SaaS y comercio electrónico
¡Las mejores herramientas de detección de anomalías con IA de 2026, más valoradas y destacadas para el monitoreo de KPI en equipos de SaaS y comercio electrónico! XIX.AI ha recopilado una poderosa colección transformadora basada en rigurosas pruebas del mundo real y clasificaciones actualizadas semanalmente. Encontrarás comparaciones detalladas entre versiones gratuitas y de pago que te ayudarán a identificar la solución imprescindible para aumentar la productividad y desbloquear tu ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai
escribiendo
Los mejores generadores de esquemas basados en IA para artículos largos optimizados para SEO
Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai
Educación y aprendizaje
Herramientas de estudio basadas en IA para los deberes y la preparación de exámenes
¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai
composicion musical
Herramientas de demostración vocal con IA para compositores, ganchos, melodías principales y sesiones de borrador multilingüe
¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai
Negocio
Las mejores herramientas de investigación competitiva basadas en IA para pequeñas empresas
¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai

 comentario (0)
0/500
Hace dos semanas, OpenAI anunció que reactivaría el programa de robótica que había cerrado en 2021, la última señal de que los principales laboratorios de IA compiten por enseñar a las máquinas a desenvolverse en el mundo físico. Pero construir robots capaces requiere algo de lo que la industria de la IA aún carece: datos de entrenamiento equivalentes a los que utilizan los modelos de lenguaje.
Esta carencia está impulsando un nuevo tipo de negocio de infraestructuras. A diferencia de los modelos de lenguaje a gran escala (LLM), que se entrenaron con enormes cantidades de texto disponible públicamente, los robots necesitan datos que capturen interacciones físicas —y ese tipo de datos apenas existe—. Los vídeos de YouTube y las grabaciones de trabajadores autónomos son de baja calidad y difíciles de alinear con el mundo físico.
XDOF (que se pronuncia «ecks-doff»), que hoy sale del modo sigiloso, cree que el próximo gran cuello de botella en la IA no serán los modelos ni los chips, sino el ciclo de retroalimentación de datos necesario para enseñar a los robots a interactuar con el mundo físico.
La startup tiene como objetivo crear los canales de datos, las herramientas de recopilación y los sistemas de anotación que los laboratorios de vanguardia y las empresas de robótica no pueden desarrollar fácilmente por sí mismos, y para ello ha recaudado 70 millones de dólares de Thrive Capital, Spark Capital, a16z, Lux y WndrCo. El cofundador y director ejecutivo, Philippe Wu, afirma que XDOF, que cuenta con una plantilla de unas 60 personas, ya está trabajando con 20 clientes, entre los que se incluyen varios laboratorios punteros de IA, aunque no puede revelar sus nombres.
«Todos los laboratorios punteros están intentando avanzar en robótica», afirmó Wu. «Ya hemos visto algunas de las desventajas de quedarnos ligeramente rezagados en la carrera por los modelos de lenguaje… No quieres acabar en una situación en la que te lances a por esta tecnología demasiado tarde, y todo el mundo se encuentre en la misma situación, en la que la IA física es la próxima frontera».
Wu se topó con este problema de primera mano cuando era estudiante de doctorado en la Universidad de California en Berkeley. Su objetivo era conseguir que los robots aprendieran habilidades a partir de conjuntos de datos a gran escala. Solo había un problema.
«No disponíamos de datos a gran escala con los que trabajar», explicó a TechCrunch. «Se trataba de un problema del huevo y la gallina: primero teníamos que recopilar datos antes incluso de poder plantearnos cómo entrenar un modelo base para la robótica».
Wu y su futuro cofundador y director técnico de XDOF, Fred Shentu, trabajaron en un proyecto llamado GELLO, un sistema de teleoperación de bajo coste que permite a un operador humano controlar un brazo robótico para generar datos de entrenamiento. «Acabó convirtiéndose en un artículo muy influyente en el ámbito de la robótica, porque mucha gente tenía necesidades y obstáculos similares, y muchos empezaron a aprovechar este tipo de dispositivos para la recopilación de datos», explicó Wu.
Al detectar la oportunidad, Wu, Shentu y el tercer cofundador y director de operaciones, Nemo Jin, lanzaron XDOF en octubre de 2024 con el objetivo de proporcionar un ecosistema de datos a las empresas que desarrollan modelos robóticos. Conscientes de que el mero suministro de datos puede ser un negocio sin futuro, la empresa también se centra en la limpieza de datos, las herramientas y la anotación, creando así un bucle de retroalimentación que se refuerza a sí mismo para los entrenadores de robots.
Como punto de partida, la empresa se ha asociado con el laboratorio de investigación en IA de la Universidad de California en Berkeley para publicar lo que considera la mayor colección de datos de entrenamiento de robots de alta calidad jamás recopilada, denominada ABC. Incluye 130 000 trayectorias de datos de manipulación robótica, 300 horas de simulación y 100 horas de evaluaciones. Nunca antes se había puesto a disposición del mundo académico un conjunto de datos de preentrenamiento a tan gran escala.
«Hemos visto en el ámbito del lenguaje, la generación de imágenes y otros campos que, cuando se publican modelos y datos, la comunidad logra cosas que no necesariamente se habrían esperado», explicó a TechCrunch David McAllister, un estudiante de doctorado de Berkeley que ayudó a organizar la publicación.
El equipo ya ha utilizado los datos para entrenar a robots en tareas de referencia como doblar camisetas y aplanar cajas, o colocar AirPods en sus estuches.
Grados de libertad ilimitados
La empresa tiene previsto trabajar en tres niveles de una pirámide de datos. El nivel más valioso es el de los datos de teleoperación recopilados en el propio robot que se está utilizando; a continuación, están los robots teleoperados que recopilan datos más generales, como en el caso de GELLO; y, por último, los datos «egocéntricos» recopilados por personas que realizan tareas cotidianas, para lo cual XDOF tiene previsto desarrollar sus propios sensores portátiles.
«La elección de la cámara va a afectar a la calidad de los datos, lo que a su vez influirá en el rendimiento del algoritmo de seguimiento de manos», explicó Wu. «Si no se diseña bien el hardware desde el principio, los datos recopilados podrían presentar problemas muy específicos que no se habían previsto».
La empresa tiene previsto contratar y formar a un gran número de teleoperadores y operadores de datos egocéntricos en todo el mundo —un modelo que requiere mucha mano de obra y que plantea una pregunta obvia: ¿por qué los principales laboratorios no realizan ellos mismos esta labor de producción de datos?
«Se necesita un almacén de cientos de miles de pies cuadrados con cientos de robots», explicó Wu. «Hay que mantener estos robots, calibrar sus parámetros físicos y formar adecuadamente a los operadores».
Se trata de una inversión que requiere dedicación, capital y una escala operativa que la mayoría de los laboratorios de IA preferirían externalizar —que es precisamente el mercado por el que apuesta XDOF—.
El nombre XDOF es un juego de palabras con el término robótico «grados de libertad», que describe el número de movimientos independientes que puede realizar un robot. Tu brazo, desde el hombro hasta la muñeca, tiene siete grados de libertad. El último robot de la empresa de robótica humanoide Figure.AI tiene 30. La «X» del nombre de la empresa refleja su ambición: «Grados de libertad arbitrarios, grados de libertad ilimitados», afirma Wu.








 Suno añade marcas de agua a las canciones en medio de batallas legales
Suno, la plataforma que permite a los usuarios generar música creada por inteligencia artificial, ha presentado nuevas funciones para etiquetar las pistas producidas en la plataforma, restringir las descargas y actualizar las normas de la comunidad c
 Musk admite que Grok filtró código de usuarios, promete borrar todos los datos históricos
Elon Musk abordó directamente la controversia por privacidad relacionada con Grok Build, comenzando con un simple "Verdadero" para confirmar la validez del incidente. Se comprometió a que todos los datos de usuario cargados previamente en SpaceXAI se
 Las acciones de EE. UU. alcanzan un hito histórico mientras gigantes de la IA y la aeroespacial se preparan para su debut de un billón de dólares
Elon Musk, Sam Altman y Dario Amodei, tres titanes del sector tecnológico, están avanzando hacia ofertas públicas iniciales para sus respectivas empresas. Con SpaceX, OpenAI y Anthropic, tres gigantes de la industria que se acercan a valoraciones de

Las mejores herramientas de análisis de SERP con IA mejor valoradas de 2026 para la estrategia de búsqueda han sido seleccionadas por XIX.AI tras rigurosas pruebas en condiciones reales y clasificaciones que se actualizan semanalmente. Estas potentes herramientas te ayudan a descubrir oportunidades de optimización ocultas, a mejorar el rendimiento de tu contenido y a obtener una ventaja competitiva en los motores de búsqueda. Descubre hoy mismo la herramienta perfecta para mejorar tu estrategia de búsqueda. ¡Explora ahora!
13 herramientas
xix.ai

¡Las mejores herramientas de detección de anomalías con IA de 2026, más valoradas y destacadas para el monitoreo de KPI en equipos de SaaS y comercio electrónico! XIX.AI ha recopilado una poderosa colección transformadora basada en rigurosas pruebas del mundo real y clasificaciones actualizadas semanalmente. Encontrarás comparaciones detalladas entre versiones gratuitas y de pago que te ayudarán a identificar la solución imprescindible para aumentar la productividad y desbloquear tu ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai

Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai

¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai

¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai

¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai












