


 Heim
KI-Labore bezahlen XDOF für die Erfassung unstrukturierter Trainingsdaten für Roboter
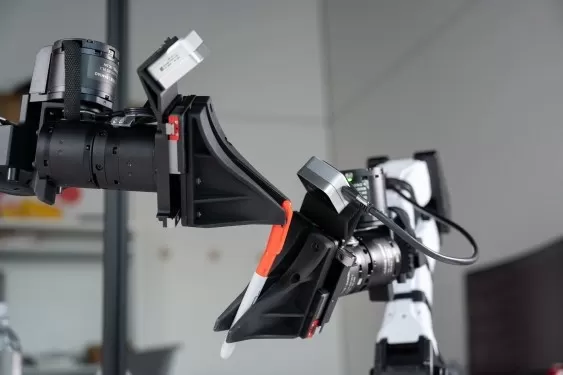
Vor zwei Wochen kündigte OpenAI an, sein 2021 eingestelltes Robotikprogramm wieder aufzunehmen – ein weiteres Zeichen dafür, dass große KI-Forschungslabore darum wetteifern, Maschinen beizubringen, wie sie sich in der physischen Welt bewegen können. Doch der Bau leistungsfähiger Roboter erfordert etwas, das der KI-Branche noch fehlt: Trainingsdaten, die denen entsprechen, die Sprachmodelle verwenden.
Diese Lücke beflügelt eine neue Art von Infrastrukturunternehmen. Im Gegensatz zu LLMs, die mit riesigen Mengen öffentlich zugänglicher Texte trainiert wurden, benötigen Roboter Daten, die physische Interaktionen erfassen – und diese Art von Daten gibt es kaum. YouTube-Videos und Aufnahmen von Gig-Workern sind von geringer Qualität und lassen sich nur schwer mit der physischen Welt in Einklang bringen.
XDOF (ausgesprochen „ecks-doff“), das heute aus der Geheimhaltung hervorkommt, ist der Ansicht, dass der nächste große Engpass in der KI nicht bei Modellen oder Chips liegen wird, sondern bei der Daten-Feedbackschleife, die erforderlich ist, um Robotern beizubringen, wie sie mit der physischen Welt interagieren sollen.
Das Start-up hat sich zum Ziel gesetzt, die Datenpipelines, Erfassungstools und Annotationssysteme aufzubauen, die Pionierlabore und Robotikunternehmen nicht ohne Weiteres selbst entwickeln können – und hat dafür 70 Millionen US-Dollar von Thrive Capital, Spark Capital, a16z, Lux und WndrCo eingesammelt. Mitbegründer und CEO Philippe Wu sagt, dass XDOF, das etwa 60 Mitarbeiter beschäftigt, bereits mit 20 Kunden zusammenarbeitet, darunter mehrere wegweisende KI-Forschungslabore, deren Namen er jedoch nicht nennen darf.
„Alle führenden Labore versuchen, sich in der Robotik zu engagieren“, so Wu. „Wir haben bereits einige der Nachteile gesehen, die entstehen, wenn man im Wettlauf um Sprachmodelle leicht ins Hintertreffen gerät … man möchte nicht in eine Situation geraten, in der man diese Technologie zu spät verfolgt und alle im selben Boot sitzen, während die physische KI die nächste Grenze darstellt.“
Wu stieß als Doktorand an der UC Berkeley aus erster Hand auf dieses Problem. Sein Schwerpunkt lag darauf, Robotern das Erlernen von Fähigkeiten anhand groß angelegter Datensätze zu ermöglichen. Es gab nur ein Problem.
„Wir hatten keine umfangreichen Datensätze, mit denen wir arbeiten konnten“, erklärte er gegenüber TechCrunch. „Es gab dieses Henne-Ei-Problem – wir mussten erst einmal tatsächlich Daten sammeln, bevor wir überhaupt die Frage stellen konnten, wie man ein Basismodell für die Robotik trainiert.“
Wu und sein späterer XDOF-Mitbegründer und CTO, Fred Shentu, arbeiteten an einem Projekt namens GELLO, einem kostengünstigen Fernsteuerungssystem, mit dem ein menschlicher Bediener einen Roboterarm steuern kann, um Trainingsdaten zu generieren. „Es wurde schließlich zu einer sehr einflussreichen Veröffentlichung in der Robotik, da viele Menschen ähnliche Bedürfnisse und Engpässe hatten und zahlreiche damit begannen, diese Art von Gerät zur Datenerfassung zu nutzen“, sagte Wu.
Wu, Shentu und der dritte Mitbegründer sowie Chief Operating Officer Nemo Jin erkannten diese Chance und gründeten im Oktober 2024 XDOF, um ein Daten-Ökosystem für Unternehmen bereitzustellen, die Robotikmodelle entwickeln. Da sich das Unternehmen bewusst ist, dass die reine Bereitstellung von Daten allein ein Sackgassen-Geschäft sein kann, konzentriert es sich auch auf Datenbereinigung, Tooling und Annotation – und schafft so einen sich selbst verstärkenden Feedback-Kreislauf für Robotertrainer.
Als ersten Schritt arbeitet das Unternehmen mit dem AI Research Lab der UC Berkeley zusammen, um die nach eigener Einschätzung größte Sammlung hochwertiger Robotertrainingsdaten zu veröffentlichen, die jemals zusammengestellt wurde: ABC. Sie umfasst 130.000 Bewegungsbahnen mit Daten zur Robotermanipulation, 300 Stunden Simulation und 100 Stunden Auswertungen. Derartige umfangreiche Vortrainingsdaten standen der Wissenschaft bisher noch nie zur Verfügung.
„Wir haben in den Bereichen Sprache, Bildgenerierung und anderen Feldern gesehen, dass die Community, wenn Modelle und Daten veröffentlicht werden, Dinge erreicht, die man nicht unbedingt erwartet hätte“, erklärte David McAllister, ein Doktorand an der Berkeley, der bei der Organisation der Veröffentlichung mitgewirkt hat, gegenüber TechCrunch.
Das Team hat die Daten bereits genutzt, um Roboter für Benchmark-Aufgaben wie das Falten von T-Shirts, das Flachdrücken von Kartons oder das Einlegen von AirPods in ihre Hüllen zu trainieren.
Unbegrenzte Freiheitsgrade
Das Unternehmen plant, auf drei Ebenen einer Datenpyramide zu arbeiten. Die wertvollste Ebene bilden Teleoperationsdaten, die am tatsächlich eingesetzten Roboter erfasst werden; als Nächstes folgen teleoperierte Roboter, die allgemeinere Daten sammeln, wie bei GELLO; und schließlich „egozentrische“ Daten, die von Menschen bei der Ausführung alltäglicher Aufgaben erfasst werden, wofür XDOF plant, eigene tragbare Sensoren zu entwickeln.
„Die Wahl Ihrer Kamera wird die Qualität Ihrer Daten beeinflussen – was sich wiederum auf die Leistung Ihres Hand-Tracking-Algorithmus auswirkt“, sagte Wu. „Wenn Sie die Hardware nicht von Anfang an gut konzipieren, könnten die von Ihnen gesammelten Daten ganz spezifische Probleme aufweisen, mit denen Sie nicht gerechnet haben.“
Das Unternehmen plant, weltweit eine ganze Armee von Teleoperatoren und Operatoren für egozentrische Daten einzustellen und auszubilden – ein arbeitsintensives Modell, das eine naheliegende Frage aufwirft: Warum übernehmen die großen Forschungslabore diese Datenerfassung nicht selbst?
„Man braucht eine Lagerhalle von Hunderttausenden Quadratfuß mit Hunderten von Robotern“, sagte Wu. „Man muss diese Roboter warten, ihre physikalischen Parameter kalibrieren und die Bediener ordnungsgemäß schulen.“
Es handelt sich um einen Ausbau, der Konzentration, Kapital und eine operative Größenordnung erfordert, die die meisten KI-Labore lieber auslagern würden – und genau auf diesen Markt setzt XDOF.
Der Name XDOF ist ein Wortspiel mit dem Begriff „Freiheitsgrade“ aus der Robotik, der die Anzahl der unabhängigen Bewegungen beschreibt, die ein Roboter ausführen kann. Ihr Arm verfügt von der Schulter bis zum Handgelenk über sieben Freiheitsgrade. Der neueste Roboter des humanoiden Robotikunternehmens Figure.AI verfügt über 30. Das „X“ im Firmennamen steht für das Ziel des Unternehmens: „Beliebige Freiheitsgrade, unbegrenzte Freiheitsgrade“, sagt Wu.
Verwandter Artikel
 U.S.-Aktien erreichen historischen Meilenstein, während KI- und Luft- und Raumfahrtriesen auf ihr Debüt als Billionen-Dollar-Unternehmen vorbereiten
Elon Musk, Sam Altman und Dario Amodei, drei Giganten des Technologiesektors, schreiten den Börsengängen ihrer jeweiligen Unternehmen voran. Mit SpaceX, OpenAI und Anthropic – drei Branchenriesen, die einer Bewertung von einer Billion US-Dollar nahek
Schwedisches KI-Startup Lovable Eyes: Bewertung von 13,2 Milliarden US-Dollar nach großer Finanzierungsrunde
Während KI-gestützte Coding-Tools an Popularität gewinnen, hat das schwedische Startup Lovable eine bedeutende Finanzierungsrunde abgeschlossen. Das Unternehmen strebt danach, 3 Milliarden US-Dollar einzusammeln, was seine Bewertung potenziell auf 13
Google testet den Remy AI Agent für Gemini, da der Fokus auf die Benutzerkontrolle verlagert wird
Laut Business Insider testet Google Remy, einen neuen KI-Personalagenten für Gemini. Dieses Tool soll Aufgaben im Auftrag von Nutzern ausführen und sowohl professionelle Arbeitsabläufe als auch tägliche Routinen optimieren.Derzeit wird Remy in einer
Empfehlungen zu verwandten Spezialthemen
Datenanalyse
 Die besten KI-Tools zur Erkennung von Anomalien für das KPI-Monitoring in SaaS- und E-Commerce-Teams
2026 Neueste Besten Top-bewertete KI-Anomalienerkennungstools für KPI-Monitoring in SaaS- und E-Commerce-Teams! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung basierend auf strengen realen Tests und wöchentlich aktualisierten Rankings zusammengestellt. Sie finden detaillierte kostenlose vs. kostenpflichtige Vergleichsinsights, die Ihnen helfen, die unbedingt auszuprobierende Lösung zu identifizieren, die die Produktivität steigert und Ihre KI-Vorteile freischaltet. Jetzt erkunden!
 10 Tools
 xix.ai
Schreiben
Die besten KI-Generatoren für Gliederungen von langen SEO-Artikeln
Die besten und am besten bewerteten KI-Outline-Generatoren für lange SEO-Artikel im Jahr 2026, sorgfältig zusammengestellt von XIX.AI. Diese leistungsstarken Tools bieten bahnbrechende Unterstützung bei der schnellen Erstellung hochwertiger Inhalte und steigern die Effizienz beim Schreiben erheblich. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, damit Sie die für Sie passende Option finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai
Bildung und Lernen
KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung
Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai
Musikkomposition
KI-Stimm-Demo-Tools für Songwriter, Hooks, Toplines und mehrsprachige Entwurfs-Sessions
2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai
Geschäft
Die besten KI-Tools zur Wettbewerbsanalyse für kleine Unternehmen
Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai
Bildbearbeitung
Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonstanz
2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai

 Kommentare (0)
Vor zwei Wochen kündigte OpenAI an, sein 2021 eingestelltes Robotikprogramm wieder aufzunehmen – ein weiteres Zeichen dafür, dass große KI-Forschungslabore darum wetteifern, Maschinen beizubringen, wie sie sich in der physischen Welt bewegen können. Doch der Bau leistungsfähiger Roboter erfordert etwas, das der KI-Branche noch fehlt: Trainingsdaten, die denen entsprechen, die Sprachmodelle verwenden.
Diese Lücke beflügelt eine neue Art von Infrastrukturunternehmen. Im Gegensatz zu LLMs, die mit riesigen Mengen öffentlich zugänglicher Texte trainiert wurden, benötigen Roboter Daten, die physische Interaktionen erfassen – und diese Art von Daten gibt es kaum. YouTube-Videos und Aufnahmen von Gig-Workern sind von geringer Qualität und lassen sich nur schwer mit der physischen Welt in Einklang bringen.
XDOF (ausgesprochen „ecks-doff“), das heute aus der Geheimhaltung hervorkommt, ist der Ansicht, dass der nächste große Engpass in der KI nicht bei Modellen oder Chips liegen wird, sondern bei der Daten-Feedbackschleife, die erforderlich ist, um Robotern beizubringen, wie sie mit der physischen Welt interagieren sollen.
Das Start-up hat sich zum Ziel gesetzt, die Datenpipelines, Erfassungstools und Annotationssysteme aufzubauen, die Pionierlabore und Robotikunternehmen nicht ohne Weiteres selbst entwickeln können – und hat dafür 70 Millionen US-Dollar von Thrive Capital, Spark Capital, a16z, Lux und WndrCo eingesammelt. Mitbegründer und CEO Philippe Wu sagt, dass XDOF, das etwa 60 Mitarbeiter beschäftigt, bereits mit 20 Kunden zusammenarbeitet, darunter mehrere wegweisende KI-Forschungslabore, deren Namen er jedoch nicht nennen darf.
„Alle führenden Labore versuchen, sich in der Robotik zu engagieren“, so Wu. „Wir haben bereits einige der Nachteile gesehen, die entstehen, wenn man im Wettlauf um Sprachmodelle leicht ins Hintertreffen gerät … man möchte nicht in eine Situation geraten, in der man diese Technologie zu spät verfolgt und alle im selben Boot sitzen, während die physische KI die nächste Grenze darstellt.“
Wu stieß als Doktorand an der UC Berkeley aus erster Hand auf dieses Problem. Sein Schwerpunkt lag darauf, Robotern das Erlernen von Fähigkeiten anhand groß angelegter Datensätze zu ermöglichen. Es gab nur ein Problem.
„Wir hatten keine umfangreichen Datensätze, mit denen wir arbeiten konnten“, erklärte er gegenüber TechCrunch. „Es gab dieses Henne-Ei-Problem – wir mussten erst einmal tatsächlich Daten sammeln, bevor wir überhaupt die Frage stellen konnten, wie man ein Basismodell für die Robotik trainiert.“
Wu und sein späterer XDOF-Mitbegründer und CTO, Fred Shentu, arbeiteten an einem Projekt namens GELLO, einem kostengünstigen Fernsteuerungssystem, mit dem ein menschlicher Bediener einen Roboterarm steuern kann, um Trainingsdaten zu generieren. „Es wurde schließlich zu einer sehr einflussreichen Veröffentlichung in der Robotik, da viele Menschen ähnliche Bedürfnisse und Engpässe hatten und zahlreiche damit begannen, diese Art von Gerät zur Datenerfassung zu nutzen“, sagte Wu.
Wu, Shentu und der dritte Mitbegründer sowie Chief Operating Officer Nemo Jin erkannten diese Chance und gründeten im Oktober 2024 XDOF, um ein Daten-Ökosystem für Unternehmen bereitzustellen, die Robotikmodelle entwickeln. Da sich das Unternehmen bewusst ist, dass die reine Bereitstellung von Daten allein ein Sackgassen-Geschäft sein kann, konzentriert es sich auch auf Datenbereinigung, Tooling und Annotation – und schafft so einen sich selbst verstärkenden Feedback-Kreislauf für Robotertrainer.
Als ersten Schritt arbeitet das Unternehmen mit dem AI Research Lab der UC Berkeley zusammen, um die nach eigener Einschätzung größte Sammlung hochwertiger Robotertrainingsdaten zu veröffentlichen, die jemals zusammengestellt wurde: ABC. Sie umfasst 130.000 Bewegungsbahnen mit Daten zur Robotermanipulation, 300 Stunden Simulation und 100 Stunden Auswertungen. Derartige umfangreiche Vortrainingsdaten standen der Wissenschaft bisher noch nie zur Verfügung.
„Wir haben in den Bereichen Sprache, Bildgenerierung und anderen Feldern gesehen, dass die Community, wenn Modelle und Daten veröffentlicht werden, Dinge erreicht, die man nicht unbedingt erwartet hätte“, erklärte David McAllister, ein Doktorand an der Berkeley, der bei der Organisation der Veröffentlichung mitgewirkt hat, gegenüber TechCrunch.
Das Team hat die Daten bereits genutzt, um Roboter für Benchmark-Aufgaben wie das Falten von T-Shirts, das Flachdrücken von Kartons oder das Einlegen von AirPods in ihre Hüllen zu trainieren.
Unbegrenzte Freiheitsgrade
Das Unternehmen plant, auf drei Ebenen einer Datenpyramide zu arbeiten. Die wertvollste Ebene bilden Teleoperationsdaten, die am tatsächlich eingesetzten Roboter erfasst werden; als Nächstes folgen teleoperierte Roboter, die allgemeinere Daten sammeln, wie bei GELLO; und schließlich „egozentrische“ Daten, die von Menschen bei der Ausführung alltäglicher Aufgaben erfasst werden, wofür XDOF plant, eigene tragbare Sensoren zu entwickeln.
„Die Wahl Ihrer Kamera wird die Qualität Ihrer Daten beeinflussen – was sich wiederum auf die Leistung Ihres Hand-Tracking-Algorithmus auswirkt“, sagte Wu. „Wenn Sie die Hardware nicht von Anfang an gut konzipieren, könnten die von Ihnen gesammelten Daten ganz spezifische Probleme aufweisen, mit denen Sie nicht gerechnet haben.“
Das Unternehmen plant, weltweit eine ganze Armee von Teleoperatoren und Operatoren für egozentrische Daten einzustellen und auszubilden – ein arbeitsintensives Modell, das eine naheliegende Frage aufwirft: Warum übernehmen die großen Forschungslabore diese Datenerfassung nicht selbst?
„Man braucht eine Lagerhalle von Hunderttausenden Quadratfuß mit Hunderten von Robotern“, sagte Wu. „Man muss diese Roboter warten, ihre physikalischen Parameter kalibrieren und die Bediener ordnungsgemäß schulen.“
Es handelt sich um einen Ausbau, der Konzentration, Kapital und eine operative Größenordnung erfordert, die die meisten KI-Labore lieber auslagern würden – und genau auf diesen Markt setzt XDOF.
Der Name XDOF ist ein Wortspiel mit dem Begriff „Freiheitsgrade“ aus der Robotik, der die Anzahl der unabhängigen Bewegungen beschreibt, die ein Roboter ausführen kann. Ihr Arm verfügt von der Schulter bis zum Handgelenk über sieben Freiheitsgrade. Der neueste Roboter des humanoiden Robotikunternehmens Figure.AI verfügt über 30. Das „X“ im Firmennamen steht für das Ziel des Unternehmens: „Beliebige Freiheitsgrade, unbegrenzte Freiheitsgrade“, sagt Wu.








 U.S.-Aktien erreichen historischen Meilenstein, während KI- und Luft- und Raumfahrtriesen auf ihr Debüt als Billionen-Dollar-Unternehmen vorbereiten
Elon Musk, Sam Altman und Dario Amodei, drei Giganten des Technologiesektors, schreiten den Börsengängen ihrer jeweiligen Unternehmen voran. Mit SpaceX, OpenAI und Anthropic – drei Branchenriesen, die einer Bewertung von einer Billion US-Dollar nahek
 Schwedisches KI-Startup Lovable Eyes: Bewertung von 13,2 Milliarden US-Dollar nach großer Finanzierungsrunde
Während KI-gestützte Coding-Tools an Popularität gewinnen, hat das schwedische Startup Lovable eine bedeutende Finanzierungsrunde abgeschlossen. Das Unternehmen strebt danach, 3 Milliarden US-Dollar einzusammeln, was seine Bewertung potenziell auf 13
Google testet den Remy AI Agent für Gemini, da der Fokus auf die Benutzerkontrolle verlagert wird
Laut Business Insider testet Google Remy, einen neuen KI-Personalagenten für Gemini. Dieses Tool soll Aufgaben im Auftrag von Nutzern ausführen und sowohl professionelle Arbeitsabläufe als auch tägliche Routinen optimieren.Derzeit wird Remy in einer

2026 Neueste Besten Top-bewertete KI-Anomalienerkennungstools für KPI-Monitoring in SaaS- und E-Commerce-Teams! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung basierend auf strengen realen Tests und wöchentlich aktualisierten Rankings zusammengestellt. Sie finden detaillierte kostenlose vs. kostenpflichtige Vergleichsinsights, die Ihnen helfen, die unbedingt auszuprobierende Lösung zu identifizieren, die die Produktivität steigert und Ihre KI-Vorteile freischaltet. Jetzt erkunden!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Outline-Generatoren für lange SEO-Artikel im Jahr 2026, sorgfältig zusammengestellt von XIX.AI. Diese leistungsstarken Tools bieten bahnbrechende Unterstützung bei der schnellen Erstellung hochwertiger Inhalte und steigern die Effizienz beim Schreiben erheblich. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, damit Sie die für Sie passende Option finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai

Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai

2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai

2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai












