


 Дом
Лаборатории искусственного интеллекта платят XDOF за сбор неструктурированных данных для обучения роботов
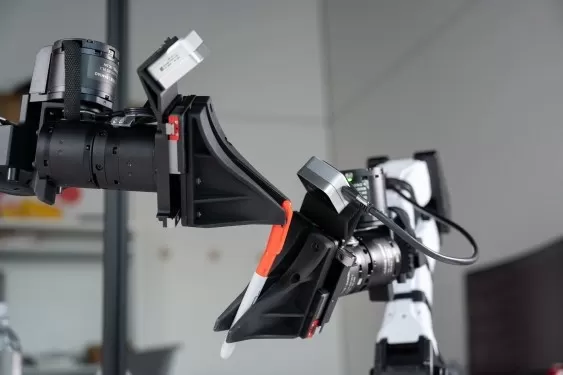
Две недели назад компания OpenAI объявила о возобновлении программы по робототехнике, которую она закрыла в 2021 году — это очередной признак того, что крупные лаборатории в сфере ИИ соревнуются между собой, стремясь научить машины взаимодействовать с физическим миром. Однако для создания функциональных роботов требуется то, чего в индустрии ИИ пока не хватает: обучающие данные, сопоставимые с теми, что используются в языковых моделях.
Этот пробел стимулирует развитие нового вида инфраструктурного бизнеса. В отличие от больших языковых моделей (LLM), которые обучались на огромных объемах общедоступного текста, роботам нужны данные, отражающие физические взаимодействия — а таких данных практически не существует. Видео на YouTube и записи, сделанные фрилансерами, имеют низкое качество и их сложно соотнести с реальным миром.
Компания XDOF (произносится как «экс-доф»), сегодня вышедшая из режима секретности, считает, что следующим серьезным препятствием в развитии ИИ станут не модели или чипы, а цикл обратной связи с данными, необходимый для обучения роботов взаимодействию с физическим миром.
Стартап ставит перед собой цель создать конвейеры данных, инструменты сбора и системы аннотирования, которые передовые лаборатории и компании-робототехники не могут легко разработать самостоятельно — и для этого привлек 70 миллионов долларов от Thrive Capital, Spark Capital, a16z, Lux и WndrCo. Соучредитель и генеральный директор Филипп Ву (Philippe Wu) говорит, что XDOF, в которой работает около 60 человек, уже сотрудничает с 20 клиентами, включая несколько передовых лабораторий в области ИИ, хотя он не может назвать их.
«Все ведущие лаборатории пытаются заняться робототехникой, — сказал Ву. — Мы уже увидели некоторые минусы того, что немного отстали в гонке по созданию языковых моделей… Не хочется оказаться в ситуации, когда ты начинаешь осваивать эту технологию слишком поздно, а все остальные уже находятся в одной лодке, где физический ИИ становится следующей границей».
Ву столкнулся с этой проблемой на собственном опыте, будучи аспирантом в Калифорнийском университете в Беркли. Его работа была сосредоточена на том, чтобы дать роботам возможность осваивать навыки на основе крупномасштабных наборов данных. Но была одна проблема.
«У нас не было крупномасштабных наборов данных, с которыми можно было бы работать», — рассказал он TechCrunch. «Возникла проблема „курицы и яйца“: сначала нам нужно было фактически собрать данные, прежде чем мы могли бы даже задаться вопросом, как обучить базовую модель для робототехники».
Ву и его будущий соучредитель и технический директор XDOF Фред Шенту работали над проектом под названием GELLO — недорогой системой дистанционного управления, позволяющей оператору-человеку управлять роботизированной рукой для генерации обучающих данных. «В итоге эта работа стала очень влиятельной публикацией в области робототехники, поскольку у многих людей были схожие потребности и препятствия, и многие начали использовать устройства такого типа для сбора данных», — сказал Ву.
Увидев эту возможность, Ву, Шенту и третий соучредитель и главный операционный директор Немо Цзинь в октябре 2024 года запустили компанию XDOF, чтобы создать экосистему данных для компаний, занимающихся разработкой робототехнических моделей. Понимая, что предоставление одних только данных может оказаться тупиковым направлением бизнеса, компания также уделяет внимание очистке данных, разработке инструментов и аннотированию — создавая самоусиливающийся цикл обратной связи для разработчиков роботов.
В качестве отправной точки компания сотрудничает с лабораторией исследований в области искусственного интеллекта Калифорнийского университета в Беркли, чтобы выпустить, по её мнению, крупнейший сборник высококачественных данных для обучения роботов, когда-либо собранный, получивший название ABC. Он включает 130 000 траекторий данных о манипуляциях роботов, 300 часов симуляций и 100 часов оценок. Такого рода масштабные данные для предварительного обучения ранее никогда не были доступны научному сообществу.
«Мы видели в области обработки языка, генерации изображений и других областях, что когда модели и данные становятся общедоступными, сообщество достигает результатов, которых не всегда можно было ожидать», — рассказал TechCrunch Дэвид МакАллистер, аспирант из Беркли, который помогал организовать этот релиз.
Команда уже использовала эти данные для обучения роботов выполнению эталонных задач, таких как складывание футболок и расправление коробок, а также укладка AirPods в чехлы.
Неограниченные степени свободы
Компания планирует работать на трех уровнях «пирамиды данных». Наиболее ценным уровнем являются данные телеоперации, собираемые на реальном роботе, находящемся в эксплуатации; далее идут телеуправляемые роботы, собирающие более общие данные, как в случае с GELLO; и, наконец, «эгоцентрические» данные, собираемые людьми при выполнении повседневных задач, для чего XDOF планирует создать собственные носимые датчики.
«Ваш выбор камеры повлияет на качество данных, а это, в свою очередь, повлияет на эффективность работы алгоритма отслеживания движений рук», — сказал Ву. «Если с самого начала не правильно спроектировать аппаратное обеспечение, в собранных данных могут возникнуть очень специфические проблемы, которых вы не предвидели».
Компания планирует нанять и обучить по всему миру целые армии телеоператоров и операторов эгоцентрических данных — это трудоемкая модель, которая вызывает очевидный вопрос: почему крупные лаборатории не занимаются этой работой по сбору данных самостоятельно?
«Для этого потребуется склад площадью в сотни тысяч квадратных футов с сотнями роботов», — сказал Ву. «Необходимо обеспечивать техническое обслуживание этих роботов, калибровать их физические параметры и должным образом обучать операторов».
Это масштабное строительство, требующее сосредоточенности, капитала и операционных масштабов, которые большинство лабораторий ИИ предпочли бы передать на аутсорсинг — и именно на этот рынок делает ставку XDOF.
Название XDOF — это игра слов, основанная на термине из робототехники «степени свободы», который описывает количество независимых движений, которые может выполнять робот. Ваша рука, от плеча до запястья, имеет семь степеней свободы. Последний робот компании Figure.AI, занимающейся гуманоидной робототехникой, имеет 30 степеней свободы. Буква X в названии компании отражает её амбиции: «Произвольные степени свободы, неограниченные степени свободы», — говорит Ву.
Связанная статья
 Шведский стартап в области искусственного интеллекта Lovable Eyes достиг оценки в 13,2 миллиарда долларов после крупного раунда финансирования
По мере того как инструменты для программирования на основе искусственного интеллекта набирают популярность, шведский стартап Lovable привлек крупный раунд финансирования. Компания нацелена на привлечение $3 млрд, что потенциально может увеличить её
Google тестирует агента Remy AI для Gemini по мере смещения фокуса на управление пользователями
Согласно Business Insider, Google тестирует Remy, нового ИИ-персонального агента для Gemini. Этот инструмент предназначен для выполнения задач от имени пользователей, упрощая как профессиональные рабочие процессы, так и повседневные рутины.В настоящ
Как исправить Core Web Vitals для улучшения позиций в поисковой выдаче
Оптимизация написания комментариев в отчетных карточках с помощью ИИ-инструментовВведениеИИ-инструменты для генерации комментариев в отчетных карточкахMagic SchoolAlmanac AIChat GPTИспользование Magic School для генерации комментариев в отчетны
Рекомендации по связанным специальным темам
письмо
 Лучшие генераторы конспектов на базе ИИ для длинных статей, оптимизированных для SEO
2026 год: лучшие и самые высокооцененные генераторы конспектов на базе ИИ для длинных SEO-статей, тщательно отобранные XIX.AI. Эти мощные инструменты обеспечивают революционную помощь в быстром создании высококачественного контента, значительно повышая эффективность написания текстов. Ознакомьтесь со сравнением бесплатных и платных версий, а также с результатами реальных тестов и подробными рейтингами, которые помогут вам найти вариант, который обязательно стоит попробовать и который соответствует вашим потребностям. Изучите их прямо сейчас, чтобы раскрыть весь потенциал ИИ.
 8 инструментов
 xix.ai
Образование и обучение
Инструменты на базе искусственного интеллекта для выполнения домашних заданий и подготовки к экзаменам
2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai
Музыкальная композиция
Инструменты для создания вокальных демо на основе ИИ для авторов песен, создания хуков, написания тоpline-мелодий и проведения многоязычных черновых сессий
2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai
Бизнес
Лучшие инструменты для анализа конкурентов на основе искусственного интеллекта для малого бизнеса
2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai
Редактирование изображений
Инструменты ИИ-ретуши в Photoshop для электронной коммерции, одежды, очистки кожи и обеспечения цветового единообразия
2026 Latest Best Photoshop AI retouch tools for ecommerce apparel, skin cleanup, and color consistency! This top-rated curated list features powerful game-changing solutions that help you boost writing efficiency, streamline content creation, and achieve perfect visual results effortlessly. Each tool has undergone real-world tests through weekly updated rankings, complete with free vs paid comparison details. Backed by XIX.AI, it’s the must-try guide for anyone aiming to unlock your AI edge. Explore now!
10 инструментов
xix.ai
Быстрый
Лучшие библиотеки подсказок для ИИ в рабочих процессах ChatGPT
2026: новейшие и лучшие библиотеки подсказок для ИИ с высоким рейтингом, предназначенные для оптимизации всех типов рабочих процессов ChatGPT. XIX.AI подготовила мощную, революционную подборку, прошедшую тщательные тесты в реальных условиях для обеспечения максимальной производительности. Вы найдёте подробные сравнения бесплатных и платных вариантов, а также рейтинги экспертов, которые помогут вам выбрать инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и раскрыть весь потенциал ИИ. Откройте для себя их прямо сейчас!
11 инструментов
xix.ai

 Комментарии (0)
Две недели назад компания OpenAI объявила о возобновлении программы по робототехнике, которую она закрыла в 2021 году — это очередной признак того, что крупные лаборатории в сфере ИИ соревнуются между собой, стремясь научить машины взаимодействовать с физическим миром. Однако для создания функциональных роботов требуется то, чего в индустрии ИИ пока не хватает: обучающие данные, сопоставимые с теми, что используются в языковых моделях.
Этот пробел стимулирует развитие нового вида инфраструктурного бизнеса. В отличие от больших языковых моделей (LLM), которые обучались на огромных объемах общедоступного текста, роботам нужны данные, отражающие физические взаимодействия — а таких данных практически не существует. Видео на YouTube и записи, сделанные фрилансерами, имеют низкое качество и их сложно соотнести с реальным миром.
Компания XDOF (произносится как «экс-доф»), сегодня вышедшая из режима секретности, считает, что следующим серьезным препятствием в развитии ИИ станут не модели или чипы, а цикл обратной связи с данными, необходимый для обучения роботов взаимодействию с физическим миром.
Стартап ставит перед собой цель создать конвейеры данных, инструменты сбора и системы аннотирования, которые передовые лаборатории и компании-робототехники не могут легко разработать самостоятельно — и для этого привлек 70 миллионов долларов от Thrive Capital, Spark Capital, a16z, Lux и WndrCo. Соучредитель и генеральный директор Филипп Ву (Philippe Wu) говорит, что XDOF, в которой работает около 60 человек, уже сотрудничает с 20 клиентами, включая несколько передовых лабораторий в области ИИ, хотя он не может назвать их.
«Все ведущие лаборатории пытаются заняться робототехникой, — сказал Ву. — Мы уже увидели некоторые минусы того, что немного отстали в гонке по созданию языковых моделей… Не хочется оказаться в ситуации, когда ты начинаешь осваивать эту технологию слишком поздно, а все остальные уже находятся в одной лодке, где физический ИИ становится следующей границей».
Ву столкнулся с этой проблемой на собственном опыте, будучи аспирантом в Калифорнийском университете в Беркли. Его работа была сосредоточена на том, чтобы дать роботам возможность осваивать навыки на основе крупномасштабных наборов данных. Но была одна проблема.
«У нас не было крупномасштабных наборов данных, с которыми можно было бы работать», — рассказал он TechCrunch. «Возникла проблема „курицы и яйца“: сначала нам нужно было фактически собрать данные, прежде чем мы могли бы даже задаться вопросом, как обучить базовую модель для робототехники».
Ву и его будущий соучредитель и технический директор XDOF Фред Шенту работали над проектом под названием GELLO — недорогой системой дистанционного управления, позволяющей оператору-человеку управлять роботизированной рукой для генерации обучающих данных. «В итоге эта работа стала очень влиятельной публикацией в области робототехники, поскольку у многих людей были схожие потребности и препятствия, и многие начали использовать устройства такого типа для сбора данных», — сказал Ву.
Увидев эту возможность, Ву, Шенту и третий соучредитель и главный операционный директор Немо Цзинь в октябре 2024 года запустили компанию XDOF, чтобы создать экосистему данных для компаний, занимающихся разработкой робототехнических моделей. Понимая, что предоставление одних только данных может оказаться тупиковым направлением бизнеса, компания также уделяет внимание очистке данных, разработке инструментов и аннотированию — создавая самоусиливающийся цикл обратной связи для разработчиков роботов.
В качестве отправной точки компания сотрудничает с лабораторией исследований в области искусственного интеллекта Калифорнийского университета в Беркли, чтобы выпустить, по её мнению, крупнейший сборник высококачественных данных для обучения роботов, когда-либо собранный, получивший название ABC. Он включает 130 000 траекторий данных о манипуляциях роботов, 300 часов симуляций и 100 часов оценок. Такого рода масштабные данные для предварительного обучения ранее никогда не были доступны научному сообществу.
«Мы видели в области обработки языка, генерации изображений и других областях, что когда модели и данные становятся общедоступными, сообщество достигает результатов, которых не всегда можно было ожидать», — рассказал TechCrunch Дэвид МакАллистер, аспирант из Беркли, который помогал организовать этот релиз.
Команда уже использовала эти данные для обучения роботов выполнению эталонных задач, таких как складывание футболок и расправление коробок, а также укладка AirPods в чехлы.
Неограниченные степени свободы
Компания планирует работать на трех уровнях «пирамиды данных». Наиболее ценным уровнем являются данные телеоперации, собираемые на реальном роботе, находящемся в эксплуатации; далее идут телеуправляемые роботы, собирающие более общие данные, как в случае с GELLO; и, наконец, «эгоцентрические» данные, собираемые людьми при выполнении повседневных задач, для чего XDOF планирует создать собственные носимые датчики.
«Ваш выбор камеры повлияет на качество данных, а это, в свою очередь, повлияет на эффективность работы алгоритма отслеживания движений рук», — сказал Ву. «Если с самого начала не правильно спроектировать аппаратное обеспечение, в собранных данных могут возникнуть очень специфические проблемы, которых вы не предвидели».
Компания планирует нанять и обучить по всему миру целые армии телеоператоров и операторов эгоцентрических данных — это трудоемкая модель, которая вызывает очевидный вопрос: почему крупные лаборатории не занимаются этой работой по сбору данных самостоятельно?
«Для этого потребуется склад площадью в сотни тысяч квадратных футов с сотнями роботов», — сказал Ву. «Необходимо обеспечивать техническое обслуживание этих роботов, калибровать их физические параметры и должным образом обучать операторов».
Это масштабное строительство, требующее сосредоточенности, капитала и операционных масштабов, которые большинство лабораторий ИИ предпочли бы передать на аутсорсинг — и именно на этот рынок делает ставку XDOF.
Название XDOF — это игра слов, основанная на термине из робототехники «степени свободы», который описывает количество независимых движений, которые может выполнять робот. Ваша рука, от плеча до запястья, имеет семь степеней свободы. Последний робот компании Figure.AI, занимающейся гуманоидной робототехникой, имеет 30 степеней свободы. Буква X в названии компании отражает её амбиции: «Произвольные степени свободы, неограниченные степени свободы», — говорит Ву.








 Шведский стартап в области искусственного интеллекта Lovable Eyes достиг оценки в 13,2 миллиарда долларов после крупного раунда финансирования
По мере того как инструменты для программирования на основе искусственного интеллекта набирают популярность, шведский стартап Lovable привлек крупный раунд финансирования. Компания нацелена на привлечение $3 млрд, что потенциально может увеличить её
Google тестирует агента Remy AI для Gemini по мере смещения фокуса на управление пользователями
Согласно Business Insider, Google тестирует Remy, нового ИИ-персонального агента для Gemini. Этот инструмент предназначен для выполнения задач от имени пользователей, упрощая как профессиональные рабочие процессы, так и повседневные рутины.В настоящ
 Как исправить Core Web Vitals для улучшения позиций в поисковой выдаче
Оптимизация написания комментариев в отчетных карточках с помощью ИИ-инструментовВведениеИИ-инструменты для генерации комментариев в отчетных карточкахMagic SchoolAlmanac AIChat GPTИспользование Magic School для генерации комментариев в отчетны

2026 год: лучшие и самые высокооцененные генераторы конспектов на базе ИИ для длинных SEO-статей, тщательно отобранные XIX.AI. Эти мощные инструменты обеспечивают революционную помощь в быстром создании высококачественного контента, значительно повышая эффективность написания текстов. Ознакомьтесь со сравнением бесплатных и платных версий, а также с результатами реальных тестов и подробными рейтингами, которые помогут вам найти вариант, который обязательно стоит попробовать и который соответствует вашим потребностям. Изучите их прямо сейчас, чтобы раскрыть весь потенциал ИИ.
8 инструментов
xix.ai

2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai

2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai

2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai

2026 Latest Best Photoshop AI retouch tools for ecommerce apparel, skin cleanup, and color consistency! This top-rated curated list features powerful game-changing solutions that help you boost writing efficiency, streamline content creation, and achieve perfect visual results effortlessly. Each tool has undergone real-world tests through weekly updated rankings, complete with free vs paid comparison details. Backed by XIX.AI, it’s the must-try guide for anyone aiming to unlock your AI edge. Explore now!
10 инструментов
xix.ai

2026: новейшие и лучшие библиотеки подсказок для ИИ с высоким рейтингом, предназначенные для оптимизации всех типов рабочих процессов ChatGPT. XIX.AI подготовила мощную, революционную подборку, прошедшую тщательные тесты в реальных условиях для обеспечения максимальной производительности. Вы найдёте подробные сравнения бесплатных и платных вариантов, а также рейтинги экспертов, которые помогут вам выбрать инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и раскрыть весь потенциал ИИ. Откройте для себя их прямо сейчас!
11 инструментов
xix.ai












