


 首页
程序记忆降低人工智能代理成本和复杂性
浙江大学和阿里巴巴集团开发的一项新技术为大型语言模型(LLM)代理配备了动态内存,从而提高了它们处理复杂任务的效率和效果。这种方法被命名为 "Memp",它为代理提供了一种 "程序记忆",这种记忆会随着代理经验的积累而不断更新,与人类通过反复练习进行学习的方式如出一辙。
Memp 建立了一个终身学习系统,在这个系统中,特工不再需要为每项新任务从零开始。当它们面对真实世界环境中的新场景时,它们会稳步提高并变得更加高效,这对于可靠的企业自动化来说是至关重要的。
程序记忆在人工智能代理中的重要性
LLM 代理在自动化复杂的多步骤业务操作方面展现出巨大潜力。然而,在实践中,这些扩展任务很容易失败。研究人员强调,意外问题(如网络中断、用户界面更新或数据格式变化)可能会扰乱整个工作流程。目前,这往往迫使代理每次都要从头开始,从而导致延误和更高的成本。
与此同时,许多复杂的任务虽然表面上看似不同,但其潜在的结构却有相似之处。正如研究人员所强调的那样,与其每次都重新学习这些模式,代理应该能够从过去的经验--包括成功和失败的经验--中汲取养分并重复使用。这就需要一种专门的 "程序性记忆",类似于人类对打字或骑自行车等技能的长期记忆,通过反复练习,这些技能就会成为第二天性。
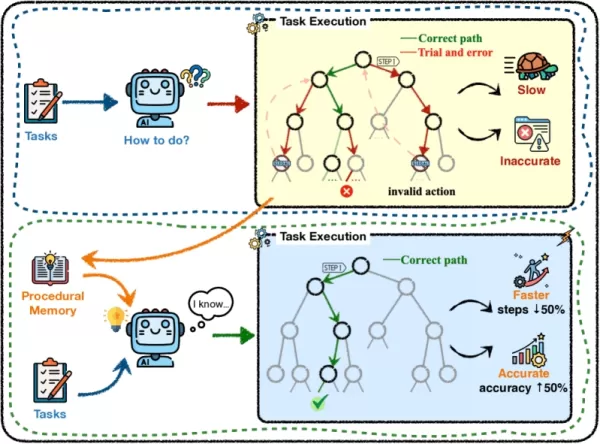
从零开始(上)与使用程序记忆(下)(来源:ArXiv) 目前大多数代理系统都缺乏这种功能。它们的程序知识通常由开发人员手动编程,存储在不灵活的提示模板中,或者嵌入在模型参数中,修改起来成本高、速度慢。即使是现有的记忆增强框架也只提供了广泛的抽象概念,未能正确解决在整个代理生命周期中应如何开发、索引、完善和管理技能的问题。
正如研究人员在论文中所说,"目前还没有一种原则性的方法来量化一个代理如何高效地发展其程序库,也无法保证新的经验会提高而不是削弱代理的性能"。
Memp 如何工作
Memp 是一个与任务无关的框架,它将程序记忆视为一个基本的、可优化的组成部分。它通过三个核心阶段运行,形成一个连续的循环:构建、检索和更新记忆。
记忆由代理的过往经验或 "轨迹 "构建而成。研究小组研究了以两种形式存储这些记忆:一种是精确的分步行动,另一种是将这些行动总结为更高层次的脚本式抽象。在检索方面,当遇到新任务时,机器人会在记忆中搜索最相关的先前经验。研究人员测试了各种方法,包括矢量搜索,将新任务的描述与过去的查询进行比对,或提取关键词以找到最接近的匹配。
更新机制是最重要的因素。Memp 采用了多种策略来确保代理的记忆不断发展。当代理完成更多任务时,它的记忆可以通过添加新经验、只过滤成功结果,或者--最有效的--通过分析失败来修正和改进原始记忆来更新。
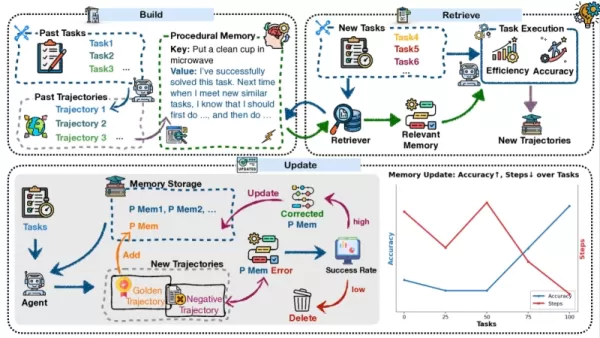
Memp 框架(来源:ArXiv) 对动态、适应性记忆的强调使 Memp 成为一个不断发展的研究领域,该领域的重点是提高人工智能代理执行长期任务的可靠性。该项目与其他项目不谋而合,例如 Mem0,它能从冗长的对话中提取重要信息,并将其整理成结构化的事实和知识图谱,以保持一致性。同样,A-MEM允许代理自主生成并连接互动中的 "记忆笔记",随着时间的推移建立一个复杂的知识网络。
然而,合著者方润南指出了Memp与类似框架的关键区别。
"Mem0和A-MEM都是优秀的作品......但它们侧重于记忆单个轨迹或对话中的突出内容,"方润南向VentureBeat解释道。从本质上讲,它们帮助代理回忆 "发生了什么"。"相比之下,Memp 的目标是跨轨迹程序记忆。它专注于可应用于类似任务的 "如何做 "的知识,使代理无需重复从头开始。
"通过将过去成功的工作流程提炼为可重复使用的程序先验,Memp 提高了成功率并缩短了步骤。"至关重要的是,我们还引入了一种更新机制,使这种程序记忆不断改进--毕竟,实践出真知,对代理来说也是如此。
克服冷启动挑战
虽然从过去的经验中学习是一个强大的概念,但它也提出了一个实际的挑战:当没有完美无缺的例子可用时,代理如何开发其初始记忆?研究团队用一个实用的解决方案解决了这个 "冷启动 "问题。
Fang 介绍了开发人员如何从定义一个稳健的评估指标开始,而不是从一开始就需要一个完美的 "黄金 "轨迹。这个指标可能是基于规则的,也可能是由另一个 LLM 驱动的,用于评价代理的性能质量。"一旦有了这个指标,我们就可以让最先进的模型在代理工作流中进行探索,并保留获得最高分的轨迹,"方说。这种方法能快速收集有价值的初始记忆,使新代理无需大量手动编码就能熟练掌握。
运行中的 Memp
为了评估该框架,研究小组将 Memp 与 GPT-4o、Claude 3.5 Sonnet 和 Qwen2.5 等领先的 LLM 集成在一起,对它们进行了苛刻任务的测试,如 ALFWorld 基准中的家务劳动和 TravelPlanner 中的信息收集。测试结果表明,通过建立和访问程序记忆,代理可以有效地总结和重复使用以前的经验。
在测试中,使用 Memp 的代理不仅成功率更高,而且运行效率也高得多。它们摒弃了无益的探索和猜测,大大减少了完成任务所需的步骤和令牌使用量。
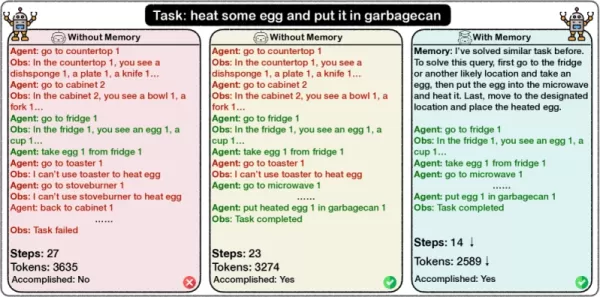
使用程序性记忆(右图)能让代理以更少的步骤完成任务,并减少令牌的使用(来源:arXiv) 一个特别值得注意的商业发现是,程序性记忆可以转移。在一次测试中,由强大的 GPT-4o 创建的程序记忆被提供给了一个小得多的模型 Qwen2.5-14B。较小模型的性能明显提高,成功率增加,完成任务所需的步骤也减少了。
方认为,之所以会出现这种情况,是因为较小的模型通常能胜任简单的单步操作,但在长期规划和推理方面却很吃力。来自大型模型的程序性记忆则有效地弥补了这一差距。这意味着可以通过顶级模型收集知识,然后将其应用到更小、更经济的模型中,而不会牺牲所学经验的优势。
向完全自主的代理推进
通过集成记忆更新功能,Memp 框架能让代理在实时环境中工作时不断发展和完善其程序知识。研究人员观察到,这使代理 "持续、近乎线性地掌握任务"。
不过,实现完全自主还面临着另一个障碍:现实世界中的许多任务,如生成研究报告,并没有明确的成功指标。为了不断改进,代理必须知道自己的表现是否令人满意。方认为,解决之道就在于采用 LLM 作为评估者。
"如今,我们经常将强大的模型与手工创建的规则结合起来计算完成度分数,"他说。"这很有效,但手写规则缺乏灵活性,难以推广。
充当裁判的 LLM 可以提供详细的监督反馈,使代理能够对复杂、主观的任务进行自我纠正。这将使整个学习过程更具可扩展性和弹性,是朝着创建高级企业自动化所必需的持久、灵活和真正自主的人工智能工作者迈出的重要一步。
相关文章
 Base44 推出专有 AI 模型,以增强其 Vibe Coding 平台的安全性
Base44,这个一年前仅成立六个月、团队规模仅为八人的初创公司,被Wix以8000万美元收购,如今已开始部署其专有AI模型,帮助用户使用自然语言构建应用程序。这一进展正值AI社区争论前沿模型是否适用于所有用例,以及依赖外部模型的企业能否保持长期竞争优势之时。总部位于湾区的Base44的最新战略旨在解决这两方面的担忧。尽管其定制大语言模型(LLM)刚刚推出,Base44的目标是最终超越前沿模型。创始人Maor Shlomo指出,“作为我们整个技术栈的一部分来训练并拥有该模型,使我们能够在延迟
拜耳利用Iambic AI加速药物研发
尤尔根·埃克哈特(Juergen Eckhardt)医学博士现任拜耳制药业务发展与授权部负责人。拜耳正借助Iambic Therapeutics将前沿人工智能模型应用于药物研发,同时在其西班牙工厂推进一项重大的脱碳项目。拜耳已与科技公司Iambic Therapeutics建立战略采购合作伙伴关系,以加速小分子药物发现和新药研发。这家老牌企业正与合作伙伴携手,利用其人工智能驱动的平台,针对传统上难
Multiverse Computing推出免费压缩生成式AI模型
大型语言模型面临着一个重大挑战:其庞大的体量。西班牙初创公司Multiverse Computing正通过创建压缩模型来解决这一问题,旨在弥合尖端人工智能能力与企业实际可负担实施能力之间的差距。其核心创新在于CompactifAI压缩技术——这项受量子计算原理启发的技术已被这家巴斯克公司用于优化OpenAI的模型。从今天起,开发者可在Hugging Face平台免费获取Multiverse增强版H
相关专题推荐
音乐创作
 面向词曲创作者、旋律片段、主旋律及多语言草稿创作的AI人声演示工具
2026 年最新最佳 AI 人声演示工具,专为词曲创作者、旋律创作者和多语言内容团队打造!XIX.AI 精心整理了一份经过严格真实世界测试的高评分、变革性工具列表。您将找到详细的免费与付费对比数据、全面排名以及必试选项,帮助您提升创作效率并释放创意潜力。立即探索,发现满足您所有内容需求的完美工具!
 9 个工具
 xix.ai
商业
适合中小企业的最佳AI竞品分析工具
2026年最新最佳、评价最高的中小企业AI竞争研究工具!XIX.AI精心精选了一系列功能强大、颠覆行业格局的工具,每周都会根据严格的实际测试和详细排名进行更新。您可以查看全面的免费版与付费版对比,从而找到那些能提升工作效率、助您赢得竞争优势的必试工具。 立即探索,发现最适合您的工具!
9 个工具
xix.ai
图像编辑
用于电商服装、皮肤清洁和色彩一致性的 Photoshop AI 修图工具
2026 年最新最佳 Photoshop AI 修图工具,适用于电商服装、皮肤清洁和色彩一致性!这份顶级精选列表包含强大的变革性解决方案,可帮助您提升写作效率、简化内容创作并轻松实现完美的视觉效果。每个工具都经过实际测试,并通过每周更新的排名进行验证,同时提供免费与付费版本的详细对比。由 XIX.AI 支持,这是任何希望发挥 AI 优势的人必试指南。立即探索!
10 个工具
xix.ai
提示词
适用于 ChatGPT 工作流的最佳 AI 提示词库
2026年最新、最受好评的AI提示词库,可优化各类ChatGPT工作流程。XIX.AI精心整理了一套功能强大、具有颠覆性的提示词库,均经过严格的实际测试,以确保最佳性能。 您可以查看详细的免费版与付费版对比分析以及专家排名,这些内容将帮助您挑选出必试的工具,从而提升工作效率并释放您的AI优势。立即探索!
11 个工具
xix.ai
教育与学习
面向教师、辅导老师和基于群体的学习项目的 AI 测验构建平台
2026年最新最佳AI测验构建平台,适用于教师、辅导老师和基于群体的学习项目!XIX.AI精心整理了一份顶级评分列表,包含经过现实世界测试的强力变革性工具,以提供准确的排名。这些必试平台有助于提高写作效率、简化内容创作,并简化各种学习场景中的测验设计。立即探索,发现您解锁教学AI优势的理想工具!
13 个工具
xix.ai
代码
适用于处理重构、漏洞和安全漏洞的 GitHub 团队的 AI 代码提交审查工具
2026年GitHub团队最新最佳AI拉取请求审查工具已登陆XIX.AI!这份精心筛选的高评分清单汇集了功能强大的、具有颠覆性的解决方案,可优化整个团队工作流中的重构、错误修复和安全漏洞检测流程。 通过免费版与付费版的对比分析、实际测试以及详细排名,助您找到能显著提升工作效率的理想工具。立即探索,释放您的AI优势!
12 个工具
xix.ai

 评论 (2)
0/500
![DonaldLee]()
Interesting approach! Giving LLMs a memory system could be a game-changer for automating complex workflows. I wonder how the cost savings compare to other optimization methods out there. The collaboration between academia and industry on this is promising. 🧠
![HarperJones]()
이 기술이 LLM 에이전트의 처리 효율을 높여줘서 정말 흥미롭네요! 하지만 실제 서비스에서 이렇게 동적 메모리가 잘 작동할까요? 복잡한 작업에서 성능이 안정적으로 유지되는지 궁금해요. 🤔 AI 비용 절감이 중요한 만큼 더 많은 연구가 필요해 보입니다.
浙江大学和阿里巴巴集团开发的一项新技术为大型语言模型(LLM)代理配备了动态内存,从而提高了它们处理复杂任务的效率和效果。这种方法被命名为 "Memp",它为代理提供了一种 "程序记忆",这种记忆会随着代理经验的积累而不断更新,与人类通过反复练习进行学习的方式如出一辙。
Memp 建立了一个终身学习系统,在这个系统中,特工不再需要为每项新任务从零开始。当它们面对真实世界环境中的新场景时,它们会稳步提高并变得更加高效,这对于可靠的企业自动化来说是至关重要的。
程序记忆在人工智能代理中的重要性
LLM 代理在自动化复杂的多步骤业务操作方面展现出巨大潜力。然而,在实践中,这些扩展任务很容易失败。研究人员强调,意外问题(如网络中断、用户界面更新或数据格式变化)可能会扰乱整个工作流程。目前,这往往迫使代理每次都要从头开始,从而导致延误和更高的成本。
与此同时,许多复杂的任务虽然表面上看似不同,但其潜在的结构却有相似之处。正如研究人员所强调的那样,与其每次都重新学习这些模式,代理应该能够从过去的经验--包括成功和失败的经验--中汲取养分并重复使用。这就需要一种专门的 "程序性记忆",类似于人类对打字或骑自行车等技能的长期记忆,通过反复练习,这些技能就会成为第二天性。
目前大多数代理系统都缺乏这种功能。它们的程序知识通常由开发人员手动编程,存储在不灵活的提示模板中,或者嵌入在模型参数中,修改起来成本高、速度慢。即使是现有的记忆增强框架也只提供了广泛的抽象概念,未能正确解决在整个代理生命周期中应如何开发、索引、完善和管理技能的问题。
正如研究人员在论文中所说,"目前还没有一种原则性的方法来量化一个代理如何高效地发展其程序库,也无法保证新的经验会提高而不是削弱代理的性能"。
Memp 如何工作
Memp 是一个与任务无关的框架,它将程序记忆视为一个基本的、可优化的组成部分。它通过三个核心阶段运行,形成一个连续的循环:构建、检索和更新记忆。
记忆由代理的过往经验或 "轨迹 "构建而成。研究小组研究了以两种形式存储这些记忆:一种是精确的分步行动,另一种是将这些行动总结为更高层次的脚本式抽象。在检索方面,当遇到新任务时,机器人会在记忆中搜索最相关的先前经验。研究人员测试了各种方法,包括矢量搜索,将新任务的描述与过去的查询进行比对,或提取关键词以找到最接近的匹配。
更新机制是最重要的因素。Memp 采用了多种策略来确保代理的记忆不断发展。当代理完成更多任务时,它的记忆可以通过添加新经验、只过滤成功结果,或者--最有效的--通过分析失败来修正和改进原始记忆来更新。
对动态、适应性记忆的强调使 Memp 成为一个不断发展的研究领域,该领域的重点是提高人工智能代理执行长期任务的可靠性。该项目与其他项目不谋而合,例如 Mem0,它能从冗长的对话中提取重要信息,并将其整理成结构化的事实和知识图谱,以保持一致性。同样,A-MEM允许代理自主生成并连接互动中的 "记忆笔记",随着时间的推移建立一个复杂的知识网络。
然而,合著者方润南指出了Memp与类似框架的关键区别。
"Mem0和A-MEM都是优秀的作品......但它们侧重于记忆单个轨迹或对话中的突出内容,"方润南向VentureBeat解释道。从本质上讲,它们帮助代理回忆 "发生了什么"。"相比之下,Memp 的目标是跨轨迹程序记忆。它专注于可应用于类似任务的 "如何做 "的知识,使代理无需重复从头开始。
"通过将过去成功的工作流程提炼为可重复使用的程序先验,Memp 提高了成功率并缩短了步骤。"至关重要的是,我们还引入了一种更新机制,使这种程序记忆不断改进--毕竟,实践出真知,对代理来说也是如此。
克服冷启动挑战
虽然从过去的经验中学习是一个强大的概念,但它也提出了一个实际的挑战:当没有完美无缺的例子可用时,代理如何开发其初始记忆?研究团队用一个实用的解决方案解决了这个 "冷启动 "问题。
Fang 介绍了开发人员如何从定义一个稳健的评估指标开始,而不是从一开始就需要一个完美的 "黄金 "轨迹。这个指标可能是基于规则的,也可能是由另一个 LLM 驱动的,用于评价代理的性能质量。"一旦有了这个指标,我们就可以让最先进的模型在代理工作流中进行探索,并保留获得最高分的轨迹,"方说。这种方法能快速收集有价值的初始记忆,使新代理无需大量手动编码就能熟练掌握。
运行中的 Memp
为了评估该框架,研究小组将 Memp 与 GPT-4o、Claude 3.5 Sonnet 和 Qwen2.5 等领先的 LLM 集成在一起,对它们进行了苛刻任务的测试,如 ALFWorld 基准中的家务劳动和 TravelPlanner 中的信息收集。测试结果表明,通过建立和访问程序记忆,代理可以有效地总结和重复使用以前的经验。
在测试中,使用 Memp 的代理不仅成功率更高,而且运行效率也高得多。它们摒弃了无益的探索和猜测,大大减少了完成任务所需的步骤和令牌使用量。
一个特别值得注意的商业发现是,程序性记忆可以转移。在一次测试中,由强大的 GPT-4o 创建的程序记忆被提供给了一个小得多的模型 Qwen2.5-14B。较小模型的性能明显提高,成功率增加,完成任务所需的步骤也减少了。
方认为,之所以会出现这种情况,是因为较小的模型通常能胜任简单的单步操作,但在长期规划和推理方面却很吃力。来自大型模型的程序性记忆则有效地弥补了这一差距。这意味着可以通过顶级模型收集知识,然后将其应用到更小、更经济的模型中,而不会牺牲所学经验的优势。
向完全自主的代理推进
通过集成记忆更新功能,Memp 框架能让代理在实时环境中工作时不断发展和完善其程序知识。研究人员观察到,这使代理 "持续、近乎线性地掌握任务"。
不过,实现完全自主还面临着另一个障碍:现实世界中的许多任务,如生成研究报告,并没有明确的成功指标。为了不断改进,代理必须知道自己的表现是否令人满意。方认为,解决之道就在于采用 LLM 作为评估者。
"如今,我们经常将强大的模型与手工创建的规则结合起来计算完成度分数,"他说。"这很有效,但手写规则缺乏灵活性,难以推广。
充当裁判的 LLM 可以提供详细的监督反馈,使代理能够对复杂、主观的任务进行自我纠正。这将使整个学习过程更具可扩展性和弹性,是朝着创建高级企业自动化所必需的持久、灵活和真正自主的人工智能工作者迈出的重要一步。








 Base44 推出专有 AI 模型,以增强其 Vibe Coding 平台的安全性
Base44,这个一年前仅成立六个月、团队规模仅为八人的初创公司,被Wix以8000万美元收购,如今已开始部署其专有AI模型,帮助用户使用自然语言构建应用程序。这一进展正值AI社区争论前沿模型是否适用于所有用例,以及依赖外部模型的企业能否保持长期竞争优势之时。总部位于湾区的Base44的最新战略旨在解决这两方面的担忧。尽管其定制大语言模型(LLM)刚刚推出,Base44的目标是最终超越前沿模型。创始人Maor Shlomo指出,“作为我们整个技术栈的一部分来训练并拥有该模型,使我们能够在延迟
 拜耳利用Iambic AI加速药物研发
尤尔根·埃克哈特(Juergen Eckhardt)医学博士现任拜耳制药业务发展与授权部负责人。拜耳正借助Iambic Therapeutics将前沿人工智能模型应用于药物研发,同时在其西班牙工厂推进一项重大的脱碳项目。拜耳已与科技公司Iambic Therapeutics建立战略采购合作伙伴关系,以加速小分子药物发现和新药研发。这家老牌企业正与合作伙伴携手,利用其人工智能驱动的平台,针对传统上难
 Multiverse Computing推出免费压缩生成式AI模型
大型语言模型面临着一个重大挑战:其庞大的体量。西班牙初创公司Multiverse Computing正通过创建压缩模型来解决这一问题,旨在弥合尖端人工智能能力与企业实际可负担实施能力之间的差距。其核心创新在于CompactifAI压缩技术——这项受量子计算原理启发的技术已被这家巴斯克公司用于优化OpenAI的模型。从今天起,开发者可在Hugging Face平台免费获取Multiverse增强版H

2026 年最新最佳 AI 人声演示工具,专为词曲创作者、旋律创作者和多语言内容团队打造!XIX.AI 精心整理了一份经过严格真实世界测试的高评分、变革性工具列表。您将找到详细的免费与付费对比数据、全面排名以及必试选项,帮助您提升创作效率并释放创意潜力。立即探索,发现满足您所有内容需求的完美工具!
9 个工具
xix.ai

2026年最新最佳、评价最高的中小企业AI竞争研究工具!XIX.AI精心精选了一系列功能强大、颠覆行业格局的工具,每周都会根据严格的实际测试和详细排名进行更新。您可以查看全面的免费版与付费版对比,从而找到那些能提升工作效率、助您赢得竞争优势的必试工具。 立即探索,发现最适合您的工具!
9 个工具
xix.ai

2026 年最新最佳 Photoshop AI 修图工具,适用于电商服装、皮肤清洁和色彩一致性!这份顶级精选列表包含强大的变革性解决方案,可帮助您提升写作效率、简化内容创作并轻松实现完美的视觉效果。每个工具都经过实际测试,并通过每周更新的排名进行验证,同时提供免费与付费版本的详细对比。由 XIX.AI 支持,这是任何希望发挥 AI 优势的人必试指南。立即探索!
10 个工具
xix.ai

2026年最新、最受好评的AI提示词库,可优化各类ChatGPT工作流程。XIX.AI精心整理了一套功能强大、具有颠覆性的提示词库,均经过严格的实际测试,以确保最佳性能。 您可以查看详细的免费版与付费版对比分析以及专家排名,这些内容将帮助您挑选出必试的工具,从而提升工作效率并释放您的AI优势。立即探索!
11 个工具
xix.ai
2026年最新最佳AI测验构建平台,适用于教师、辅导老师和基于群体的学习项目!XIX.AI精心整理了一份顶级评分列表,包含经过现实世界测试的强力变革性工具,以提供准确的排名。这些必试平台有助于提高写作效率、简化内容创作,并简化各种学习场景中的测验设计。立即探索,发现您解锁教学AI优势的理想工具!
13 个工具
xix.ai
2026年GitHub团队最新最佳AI拉取请求审查工具已登陆XIX.AI!这份精心筛选的高评分清单汇集了功能强大的、具有颠覆性的解决方案,可优化整个团队工作流中的重构、错误修复和安全漏洞检测流程。 通过免费版与付费版的对比分析、实际测试以及详细排名,助您找到能显著提升工作效率的理想工具。立即探索,释放您的AI优势!
12 个工具
xix.ai

Interesting approach! Giving LLMs a memory system could be a game-changer for automating complex workflows. I wonder how the cost savings compare to other optimization methods out there. The collaboration between academia and industry on this is promising. 🧠
이 기술이 LLM 에이전트의 처리 효율을 높여줘서 정말 흥미롭네요! 하지만 실제 서비스에서 이렇게 동적 메모리가 잘 작동할까요? 복잡한 작업에서 성능이 안정적으로 유지되는지 궁금해요. 🤔 AI 비용 절감이 중요한 만큼 더 많은 연구가 필요해 보입니다.












