


 首页
MiniMax大模型误读姓名——稀宇科技:特定Token后训练不足
MiniMax 最近发布了一份技术报告,详细解释了其 M2 系列模型为何难以准确生成“马嘉祺”等特定名称。这一看似错误的现象凸显了当前大语言模型训练中存在的系统性缺陷。
Token 偏移:被挤压的向量空间
根本原因在于分词器(tokenizer),即文本处理的基本单位。例如,名称“马嘉祺”被拆分为两个 Token:“Ma”和“Jiaqi”。虽然模型在预训练阶段学习了这些 Token,但在随后的指令微调阶段出现了问题。
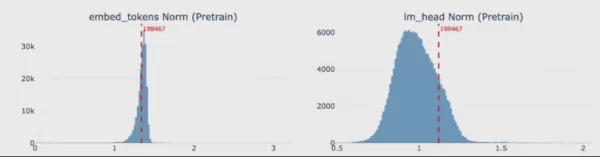
在微调期间,Token “Jiaqi”在对话数据中出现的频率极低,因此几乎未接受任何训练。与此同时,代码符号和工具调用等高频率 Token 得到了大量强化,这实际上“挤压”了低频 Token 的表示空间。结果,这些 Token 偏离了其正确的概率分布,导致模型在引用特定名人时,会用发音相似的“嘉祺”或“琪琪”等词进行替换。
超越中文:日俄混合的连锁反应
MiniMax 的分析显示,这种“Token 退化”现象十分普遍。在对完整词汇表中的约 20 万个 Token 进行扫描后,他们发现约 4.9% 的 Token 出现了显著的性能下降。值得注意的是,日语 Token 的退化率高达 29.7%,这解释了为何模型偶尔会在日语对话中混入俄语或韩语字符。
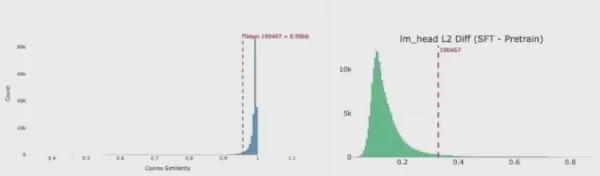
除了名称和外语外,受影响的 Token 还包括 LaTeX 标记、维基百科源代码符号,甚至某些 SEO 垃圾关键词。这表明数据稀疏性具有全局影响:当后训练数据未能均匀覆盖各种语言和特定词汇时,模型的生成逻辑就会产生偏差。
系统性修复:为 20 万个 Token 建立“最低保障”
为了修复这一结构性问题,研发团队实施了一项精确的修复策略。他们生成了覆盖整个词汇表的合成数据,并强制模型执行“重复”任务,从而为每个 Token 的生成频率建立“最低保障”。
修复后的数据显示,模型全词汇表输出的稳定性有了明显改善。日语回复中混入外语字符的比例从 47% 降至仅 1%。团队仍在探索更深入的优化措施,例如将预训练材料整合到微调阶段,或直接移除词汇表中不再使用的冗余标记。
此次事件引发了行业的深刻反思:虽然大模型的分词器通常基于广泛的网络语料库构建,但下游应用场景却千差万别。从基础统计角度出发,确保 Token 层面有足够的数据覆盖,同时保持语义多样性,仍是提高大模型可靠性的关键挑战。
相关文章
 由马克·贝尼奥夫支持的初创公司旨在解决人工智能部署挑战
大型企业在部署可靠的人工智能工具时面临如此严峻的挑战,以至于整个前沿部署工程师团队——这些嵌入在客户公司内部以将人工智能系统投入运营的专业人员——正在涌现,以弥合这一差距。“矛盾的是,人工智能推高了专业服务的需求,”前 Salesforce 高管、新成立的 June 公司创始人 Efrat Rapoport 周一宣布该公司结束秘密运营状态时指出。“行业解决人工智能集成问题的方法只是雇佣越来越多的人。”Rapoport 与她的三位联合创始人——Ohad Hen、Barak Goldstein
阿里视频发布万3.0,实现超长视频生成与多维度一致性
8月24日,阿里巴巴发布了万3.0,这是其最新的视频生成大模型。此次发布标志着阿里巴巴视频技术的重大飞跃,在时长、通用创作、参考处理以及真实世界模拟方面实现了显著提升。万3.0将单视频生成的时长扩展至30秒,在单个镜头内提供了更为丰富的叙事可能性。它还引入了对多种主流文件格式的支持——包括doc、xls、ppt、pdf和md——使得文本、表格和幻灯片能够直接转换为动态视觉内容。为了解决视觉不一致和风格漂移等常见挑战,万3.0在微观层面确保了高度的稳定性。它在角色外观、道具细节、音频设置、空间关系
英伟达H200中国交易在特朗普与习近平峰会后得以保留,但结果与预期不符
特朗普总统前往北京,黄仁勋在最后一刻加入了代表团,两天后离京时仅就芯片出口的潜在进展发表了含糊其辞的言论。双方未达成任何协议。自特朗普于2025年12月首次批准销售以来,尚未有一颗英伟达H200芯片进入中国。 美国贸易代表杰米森·格里尔向彭博社证实,半导体限制措施甚至未被列入双边议程。在峰会的盛况之下,隐藏着更重大的转变。H200芯片的供应受阻并非源于华盛顿的拒绝;美国实际上已经批准了出口。 包括
相关专题推荐
设计与艺术
 顶级AI插画工具:更快地创作编辑类场景和封面插图
2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
 10 个工具
 xix.ai
教育与学习
备考首选的顶尖AI辅导老师:练习数学、科学和英语
2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai
金融
用于个人财务管理的 AI 预算规划工具
2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai
健康养生
AI睡眠追踪助手:通过养成更好的睡前习惯来促进身体恢复
2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai
数据分析
用于产品和收入分析的 AI SQL 辅助工具
2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai
教育与学习
最佳的、兼具教学功能的AI作业助手:学习概念,而不仅仅是答案
2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai

 评论 (0)
0/500
MiniMax 最近发布了一份技术报告,详细解释了其 M2 系列模型为何难以准确生成“马嘉祺”等特定名称。这一看似错误的现象凸显了当前大语言模型训练中存在的系统性缺陷。
Token 偏移:被挤压的向量空间
根本原因在于分词器(tokenizer),即文本处理的基本单位。例如,名称“马嘉祺”被拆分为两个 Token:“Ma”和“Jiaqi”。虽然模型在预训练阶段学习了这些 Token,但在随后的指令微调阶段出现了问题。
在微调期间,Token “Jiaqi”在对话数据中出现的频率极低,因此几乎未接受任何训练。与此同时,代码符号和工具调用等高频率 Token 得到了大量强化,这实际上“挤压”了低频 Token 的表示空间。结果,这些 Token 偏离了其正确的概率分布,导致模型在引用特定名人时,会用发音相似的“嘉祺”或“琪琪”等词进行替换。
超越中文:日俄混合的连锁反应
MiniMax 的分析显示,这种“Token 退化”现象十分普遍。在对完整词汇表中的约 20 万个 Token 进行扫描后,他们发现约 4.9% 的 Token 出现了显著的性能下降。值得注意的是,日语 Token 的退化率高达 29.7%,这解释了为何模型偶尔会在日语对话中混入俄语或韩语字符。
除了名称和外语外,受影响的 Token 还包括 LaTeX 标记、维基百科源代码符号,甚至某些 SEO 垃圾关键词。这表明数据稀疏性具有全局影响:当后训练数据未能均匀覆盖各种语言和特定词汇时,模型的生成逻辑就会产生偏差。
系统性修复:为 20 万个 Token 建立“最低保障”
为了修复这一结构性问题,研发团队实施了一项精确的修复策略。他们生成了覆盖整个词汇表的合成数据,并强制模型执行“重复”任务,从而为每个 Token 的生成频率建立“最低保障”。
修复后的数据显示,模型全词汇表输出的稳定性有了明显改善。日语回复中混入外语字符的比例从 47% 降至仅 1%。团队仍在探索更深入的优化措施,例如将预训练材料整合到微调阶段,或直接移除词汇表中不再使用的冗余标记。
此次事件引发了行业的深刻反思:虽然大模型的分词器通常基于广泛的网络语料库构建,但下游应用场景却千差万别。从基础统计角度出发,确保 Token 层面有足够的数据覆盖,同时保持语义多样性,仍是提高大模型可靠性的关键挑战。








 由马克·贝尼奥夫支持的初创公司旨在解决人工智能部署挑战
大型企业在部署可靠的人工智能工具时面临如此严峻的挑战,以至于整个前沿部署工程师团队——这些嵌入在客户公司内部以将人工智能系统投入运营的专业人员——正在涌现,以弥合这一差距。“矛盾的是,人工智能推高了专业服务的需求,”前 Salesforce 高管、新成立的 June 公司创始人 Efrat Rapoport 周一宣布该公司结束秘密运营状态时指出。“行业解决人工智能集成问题的方法只是雇佣越来越多的人。”Rapoport 与她的三位联合创始人——Ohad Hen、Barak Goldstein
 阿里视频发布万3.0,实现超长视频生成与多维度一致性
8月24日,阿里巴巴发布了万3.0,这是其最新的视频生成大模型。此次发布标志着阿里巴巴视频技术的重大飞跃,在时长、通用创作、参考处理以及真实世界模拟方面实现了显著提升。万3.0将单视频生成的时长扩展至30秒,在单个镜头内提供了更为丰富的叙事可能性。它还引入了对多种主流文件格式的支持——包括doc、xls、ppt、pdf和md——使得文本、表格和幻灯片能够直接转换为动态视觉内容。为了解决视觉不一致和风格漂移等常见挑战,万3.0在微观层面确保了高度的稳定性。它在角色外观、道具细节、音频设置、空间关系
 英伟达H200中国交易在特朗普与习近平峰会后得以保留,但结果与预期不符
特朗普总统前往北京,黄仁勋在最后一刻加入了代表团,两天后离京时仅就芯片出口的潜在进展发表了含糊其辞的言论。双方未达成任何协议。自特朗普于2025年12月首次批准销售以来,尚未有一颗英伟达H200芯片进入中国。 美国贸易代表杰米森·格里尔向彭博社证实,半导体限制措施甚至未被列入双边议程。在峰会的盛况之下,隐藏着更重大的转变。H200芯片的供应受阻并非源于华盛顿的拒绝;美国实际上已经批准了出口。 包括
2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
10 个工具
xix.ai
2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai
2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai
2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai
2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai
2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai












