


 Дом
MiniMax Large Model Mispronounces Names - Xiyu Technology: Insufficient Training After Specific Tokens
Недавно компания MiniMax опубликовала технический отчет, в котором подробно объясняется, почему её модели серии M2 испытывали трудности с точной генерацией конкретных имён, таких как «Ма Цзяци». Эта очевидная ошибка выявляет системный недостаток в текущих методах обучения больших языковых моделей.
Смещение токенов: сжатое векторное пространство
Корень проблемы кроется в токенизаторе — фундаментальной единице обработки текста. Например, имя «Ма Цзяци» разбивается на два токена: «Ма» и «Цзяци». Хотя модель изучила эти токены в ходе предварительного обучения, проблемы возникли на последующем этапе тонкой настройки на инструкциях.
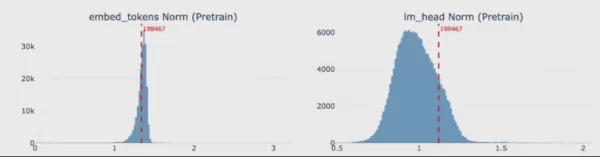
Во время тонкой настройки токен «Цзяци» появлялся в диалоговых данных настолько редко, что практически не получал обучения. В то же время высокочастотные токены, такие как символы кода и вызовы инструментов, получали усиленное закрепление, что эффективно «сжимало» пространство представлений для низкочастотных токенов. В результате эти токены отклонялись от своих корректных вероятностных распределений, что приводило к тому, что модель заменяла их на фонетически похожие варианты, такие как «Цзяци» или «Ццици», при упоминании конкретных знаменитостей.
Выход за пределы китайского языка: цепная реакция смешения японского и русского
Анализ MiniMax показал, что эта «деградация токенов» носит массовый характер. Просканировав около 200 000 токенов полного словаря, они обнаружили, что примерно 4,9% из них показали значительное снижение производительности. Примечательно, что токены японского языка подверглись деградации со скоростью до 29,7%, что объясняет, почему модель иногда смешивает русские или корейские символы в японских разговорах.
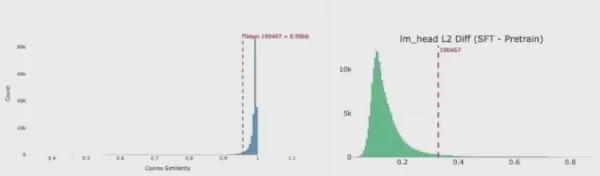
Помимо имён и иностранных языков, затронутыми токенами оказались маркеры LaTeX, символы исходного кода Wikipedia и даже определенные ключевые слова SEO-спама. Это демонстрирует, что разреженность данных имеет глобальные последствия: когда данные постобучения не покрывают равномерно разнообразные языки и специфические словари, логика генерации модели становится смещенной.
Системное исправление: установление «минимальной гарантии» для 200 000 токенов
Чтобы исправить эту структурную проблему, команда исследований и разработок реализовала точную стратегию ремонта. Они сгенерировали синтетические данные, охватывающие весь словарь, и заставили модель выполнять задачи «повторения», тем самым установив «минимальную гарантию» частоты генерации каждого токена.
Данные после ремонта показывают заметное улучшение стабильности вывода полного словаря модели. Частота смешения иностранных символов в японских ответах снизилась с 47% до всего 1%. Команда продолжает исследовать более глубокие оптимизации, такие как интеграция материалов предварительного обучения на этапе тонкой настройки или прямое удаление избыточных маркеров, больше не используемых в словаре.
Этот инцидент вызвал значительную рефлексию в отрасли: хотя токенизаторы больших моделей часто строятся на обширных веб-корпусах, области применения конечных продуктов сильно различаются. Обеспечение адекватного покрытия данных на уровне токенов с фундаментальной статистической точки зрения при сохранении семантического разнообразия остается критической задачей для повышения надежности больших моделей.
Связанная статья
 Стартап при поддержке Марка Бениоффа стремится решить проблемы внедрения ИИ
Крупные предприятия сталкиваются с такими масштабными вызовами при развертывании надежных инструментов искусственного интеллекта, что появляются целые команды инженеров, внедряемых непосредственно в клиентские компании (forward-deployed engineers) —
AliVideo представляет Wan3.0, обеспечивающий генерацию сверхдлинных видео и многомерную согласованность
24 августа Alibaba представила Wan3.0, свою новейшую большую модель для генерации видео. Этот выпуск представляет собой значительный скачок в развитии видеотехнологий Alibaba, обеспечивая существенные улучшения в продолжительности, универсальном созд
Сделка Nvidia по поставкам H200 в Китай пережила саммит Трампа и Си, но не так, как ожидалось
Президент Трамп отправился в Пекин, причем Дженсен Хуанг присоединился к делегации в последний момент, а через два дня они улетели, оставив лишь расплывчатые заявления о возможных изменениях в сфере э
Рекомендации по связанным специальным темам
Дизайн и искусство
 Лучшие инструменты для создания иллюстраций с помощью ИИ: быстрее создавайте редакционные сцены и обложки
2026: Новейшие и самые популярные инструменты для создания иллюстраций с помощью ИИ: в нашем тщательно подобранном списке представлены лучшие инструменты с мощными функциональными возможностями, позволяющие быстро создавать потрясающие редакционные сцены и привлекательные обложки. Каждый вариант прошел тщательные практические испытания; мы предлагаем сравнение бесплатных и платных версий, чтобы помочь вам найти идеальный вариант для вашего рабочего процесса. Попробуйте эти незаменимые решения уже сегодня, чтобы раскрыть потенциал искусственного интеллекта и повысить свою творческую продуктивность. Узнайте больше на сайте XIX.AI.
 10 инструментов
 xix.ai
Образование и обучение
Лучшие репетиторы по искусственному интеллекту для подготовки к экзаменам: практикуйтесь по математике, естественным наукам и английскому языку
2026 года: лучшие и самые популярные ИИ-репетиторы для подготовки к экзаменам представлены на XIX.AI! В нашем тщательно подобранном списке представлены мощные инструменты, которые кардинально изменят ваш подход к обучению: здесь вы найдете сравнение бесплатных и платных версий, тесты на практике и еженедельно обновляемые рейтинги. Они помогут повысить эффективность вашего письма, упростить изучение сложных тем и раскрыть ваш академический потенциал. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент для подготовки к экзаменам, и начните творить уже сегодня, чтобы раскрыть свои преимущества благодаря ИИ!
10 инструментов
xix.ai
Финансы
Инструменты планирования бюджета на основе ИИ для управления личными финансами
В 2026 году на XIX.AI представлены новейшие, лучшие и наиболее рейтинговые инструменты ИИ для бюджетного планирования по личным финансам! Эта тщательно отобранная коллекция включает мощные, революционные решения, которые помогают проводить реальные тесты, понимать привычки расходов и создавать персонализированные планы для повышения продуктивности. Наслаждайтесь бесплатным сравнением с платными версиями вместе с подробными рейтингами. Инструменты, которые обязательно стоит попробовать, разработаны для упрощения управления деньгами и раскрытия вашего преимущества ИИ. Исследуйте сейчас!
11 инструментов
xix.ai
Здоровье и благополучие
Помощники для отслеживания сна с ИИ: улучшите восстановление за счёт более правильных привычек перед сном
2026 год: лучшие и наиболее высоко оценённые помощники для отслеживания сна на основе ИИ, отобранные для максимального восстановления организма. В этом полностью обновлённом еженедельном руководстве представлены мощные инструменты с результатами реальных тестов, сравнением бесплатных и платных версий, а также подробными рейтингами, которые помогут вам найти оптимальное решение для улучшения качества сна и формирования лучших привычек перед сном. Ознакомьтесь с ним прямо сейчас на сайте XIX.AI, чтобы раскрыть потенциал ИИ в вашей жизни.
10 инструментов
xix.ai
Анализ данных
AI-копилоты SQL для аналитики продуктов и выручки
2026: лучшие и самые популярные ИИ-помощники для работы с SQL в сфере аналитики продуктов и доходов! XIX.AI подготовила мощную, революционную подборку инструментов, которые обязательно стоит попробовать. Они проходят проверку в реальных условиях и включаются в еженедельно обновляемый рейтинг. Эти инструменты помогают пользователям значительно повысить продуктивность за счет ускорения анализа данных, оптимизации сложных запросов и получения точных аналитических выводов, которые позволяют принимать более обоснованные бизнес-решения. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент, который поможет вам раскрыть весь потенциал искусственного интеллекта!
14 инструментов
xix.ai
Образование и обучение
Лучшие помощники по домашним заданиям с ИИ, которые учат: изучайте концепции, а не просто ответы
2026: лучшие и самые популярные помощники по домашним заданиям с ИИ, которые обучают основным концепциям, а не просто дают готовые ответы. Мощные инструменты для студентов. Обязательный к пробованию тщательно отобранный список. Еженедельное обновление. Сравнение бесплатных и платных версий. Тестирование в реальных условиях. Точные рейтинги, которые помогут вам раскрыть весь свой учебный потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для более эффективного обучения.
10 инструментов
xix.ai

 Комментарии (0)
Недавно компания MiniMax опубликовала технический отчет, в котором подробно объясняется, почему её модели серии M2 испытывали трудности с точной генерацией конкретных имён, таких как «Ма Цзяци». Эта очевидная ошибка выявляет системный недостаток в текущих методах обучения больших языковых моделей.
Смещение токенов: сжатое векторное пространство
Корень проблемы кроется в токенизаторе — фундаментальной единице обработки текста. Например, имя «Ма Цзяци» разбивается на два токена: «Ма» и «Цзяци». Хотя модель изучила эти токены в ходе предварительного обучения, проблемы возникли на последующем этапе тонкой настройки на инструкциях.
Во время тонкой настройки токен «Цзяци» появлялся в диалоговых данных настолько редко, что практически не получал обучения. В то же время высокочастотные токены, такие как символы кода и вызовы инструментов, получали усиленное закрепление, что эффективно «сжимало» пространство представлений для низкочастотных токенов. В результате эти токены отклонялись от своих корректных вероятностных распределений, что приводило к тому, что модель заменяла их на фонетически похожие варианты, такие как «Цзяци» или «Ццици», при упоминании конкретных знаменитостей.
Выход за пределы китайского языка: цепная реакция смешения японского и русского
Анализ MiniMax показал, что эта «деградация токенов» носит массовый характер. Просканировав около 200 000 токенов полного словаря, они обнаружили, что примерно 4,9% из них показали значительное снижение производительности. Примечательно, что токены японского языка подверглись деградации со скоростью до 29,7%, что объясняет, почему модель иногда смешивает русские или корейские символы в японских разговорах.
Помимо имён и иностранных языков, затронутыми токенами оказались маркеры LaTeX, символы исходного кода Wikipedia и даже определенные ключевые слова SEO-спама. Это демонстрирует, что разреженность данных имеет глобальные последствия: когда данные постобучения не покрывают равномерно разнообразные языки и специфические словари, логика генерации модели становится смещенной.
Системное исправление: установление «минимальной гарантии» для 200 000 токенов
Чтобы исправить эту структурную проблему, команда исследований и разработок реализовала точную стратегию ремонта. Они сгенерировали синтетические данные, охватывающие весь словарь, и заставили модель выполнять задачи «повторения», тем самым установив «минимальную гарантию» частоты генерации каждого токена.
Данные после ремонта показывают заметное улучшение стабильности вывода полного словаря модели. Частота смешения иностранных символов в японских ответах снизилась с 47% до всего 1%. Команда продолжает исследовать более глубокие оптимизации, такие как интеграция материалов предварительного обучения на этапе тонкой настройки или прямое удаление избыточных маркеров, больше не используемых в словаре.
Этот инцидент вызвал значительную рефлексию в отрасли: хотя токенизаторы больших моделей часто строятся на обширных веб-корпусах, области применения конечных продуктов сильно различаются. Обеспечение адекватного покрытия данных на уровне токенов с фундаментальной статистической точки зрения при сохранении семантического разнообразия остается критической задачей для повышения надежности больших моделей.








 Стартап при поддержке Марка Бениоффа стремится решить проблемы внедрения ИИ
Крупные предприятия сталкиваются с такими масштабными вызовами при развертывании надежных инструментов искусственного интеллекта, что появляются целые команды инженеров, внедряемых непосредственно в клиентские компании (forward-deployed engineers) —
 AliVideo представляет Wan3.0, обеспечивающий генерацию сверхдлинных видео и многомерную согласованность
24 августа Alibaba представила Wan3.0, свою новейшую большую модель для генерации видео. Этот выпуск представляет собой значительный скачок в развитии видеотехнологий Alibaba, обеспечивая существенные улучшения в продолжительности, универсальном созд
 Сделка Nvidia по поставкам H200 в Китай пережила саммит Трампа и Си, но не так, как ожидалось
Президент Трамп отправился в Пекин, причем Дженсен Хуанг присоединился к делегации в последний момент, а через два дня они улетели, оставив лишь расплывчатые заявления о возможных изменениях в сфере э

2026: Новейшие и самые популярные инструменты для создания иллюстраций с помощью ИИ: в нашем тщательно подобранном списке представлены лучшие инструменты с мощными функциональными возможностями, позволяющие быстро создавать потрясающие редакционные сцены и привлекательные обложки. Каждый вариант прошел тщательные практические испытания; мы предлагаем сравнение бесплатных и платных версий, чтобы помочь вам найти идеальный вариант для вашего рабочего процесса. Попробуйте эти незаменимые решения уже сегодня, чтобы раскрыть потенциал искусственного интеллекта и повысить свою творческую продуктивность. Узнайте больше на сайте XIX.AI.
10 инструментов
xix.ai

2026 года: лучшие и самые популярные ИИ-репетиторы для подготовки к экзаменам представлены на XIX.AI! В нашем тщательно подобранном списке представлены мощные инструменты, которые кардинально изменят ваш подход к обучению: здесь вы найдете сравнение бесплатных и платных версий, тесты на практике и еженедельно обновляемые рейтинги. Они помогут повысить эффективность вашего письма, упростить изучение сложных тем и раскрыть ваш академический потенциал. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент для подготовки к экзаменам, и начните творить уже сегодня, чтобы раскрыть свои преимущества благодаря ИИ!
10 инструментов
xix.ai

В 2026 году на XIX.AI представлены новейшие, лучшие и наиболее рейтинговые инструменты ИИ для бюджетного планирования по личным финансам! Эта тщательно отобранная коллекция включает мощные, революционные решения, которые помогают проводить реальные тесты, понимать привычки расходов и создавать персонализированные планы для повышения продуктивности. Наслаждайтесь бесплатным сравнением с платными версиями вместе с подробными рейтингами. Инструменты, которые обязательно стоит попробовать, разработаны для упрощения управления деньгами и раскрытия вашего преимущества ИИ. Исследуйте сейчас!
11 инструментов
xix.ai

2026 год: лучшие и наиболее высоко оценённые помощники для отслеживания сна на основе ИИ, отобранные для максимального восстановления организма. В этом полностью обновлённом еженедельном руководстве представлены мощные инструменты с результатами реальных тестов, сравнением бесплатных и платных версий, а также подробными рейтингами, которые помогут вам найти оптимальное решение для улучшения качества сна и формирования лучших привычек перед сном. Ознакомьтесь с ним прямо сейчас на сайте XIX.AI, чтобы раскрыть потенциал ИИ в вашей жизни.
10 инструментов
xix.ai

2026: лучшие и самые популярные ИИ-помощники для работы с SQL в сфере аналитики продуктов и доходов! XIX.AI подготовила мощную, революционную подборку инструментов, которые обязательно стоит попробовать. Они проходят проверку в реальных условиях и включаются в еженедельно обновляемый рейтинг. Эти инструменты помогают пользователям значительно повысить продуктивность за счет ускорения анализа данных, оптимизации сложных запросов и получения точных аналитических выводов, которые позволяют принимать более обоснованные бизнес-решения. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент, который поможет вам раскрыть весь потенциал искусственного интеллекта!
14 инструментов
xix.ai

2026: лучшие и самые популярные помощники по домашним заданиям с ИИ, которые обучают основным концепциям, а не просто дают готовые ответы. Мощные инструменты для студентов. Обязательный к пробованию тщательно отобранный список. Еженедельное обновление. Сравнение бесплатных и платных версий. Тестирование в реальных условиях. Точные рейтинги, которые помогут вам раскрыть весь свой учебный потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для более эффективного обучения.
10 инструментов
xix.ai












