


 首页
法院文件显示,使用受版权保护的内容进行AI培训讨论的Meta工作人员透露
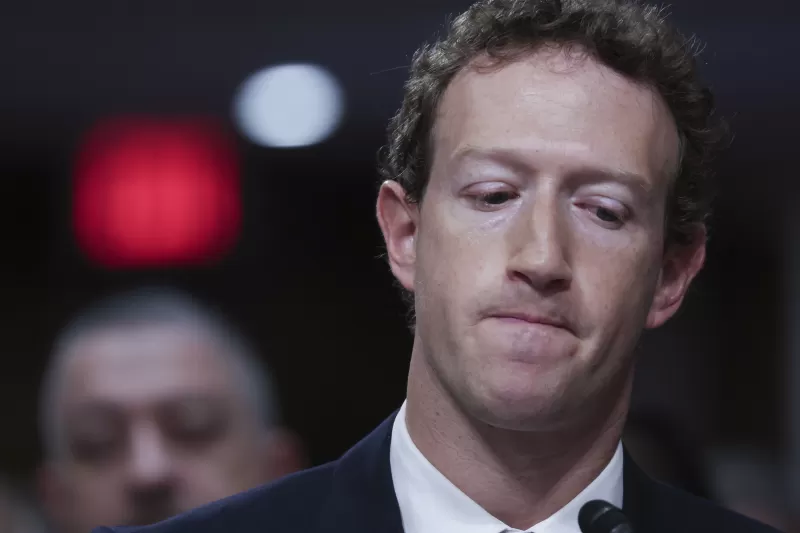
多年来,Meta员工一直在讨论使用通过可能不正当手段获得的受版权保护的材料来训练公司的人工智能模型,根据周四解封的法庭文件。
这些文件是正在进行的Kadrey诉Meta诉讼的一部分,这是美国法院系统中多个AI版权争议之一。Meta认为使用受知识产权保护的作品,特别是书籍,训练其模型属于“合理使用”。然而,包括作者Sarah Silverman和Ta-Nehisi Coates在内的原告强烈反对。
该案早期的文件显示,Meta首席执行官Mark Zuckerberg批准使用受版权保护的内容进行训练,Meta已停止与图书出版商谈判许可协议。新解封的文件,包括Meta员工的内部工作聊天记录,提供了迄今为止关于Meta如何可能使用受版权保护的数据训练其模型(包括Llama家族模型)的最详细见解。
在一个聊天中,包括Meta Llama模型研究团队高级经理Melanie Kambadur在内的Meta员工讨论了在已知可能存在法律风险的作品上训练模型。
“我的看法是(本着‘先行动后求原谅’的精神):我们应该拿这些书,让高管来决定,”Meta研究工程师Xavier Martinet在2023年2月的聊天中写道,根据文件记录。“这就是他们创建这个生成式AI组织的原因:这样我们就可以冒更多风险。”
Martinet建议以零售价格购买电子书来构建训练集,而不是与出版商谈判许可协议。当另一名员工指出使用未经授权的受版权保护材料的潜在法律问题时,Martinet加倍坚持,指出“无数”初创公司可能已经在使用盗版书籍进行训练。
“我的意思是,最坏的情况:我们发现这样做没问题,而无数初创公司已经在BitTorrent上盗版了大量书籍,”Martinet写道,根据文件记录。“我再补充一句:直接与出版商打交道太耗时了……”
在同一聊天中,Kambadur提到Meta正在与Scribd和其他平台谈判许可,她指出虽然使用“公开可用数据”进行训练仍需批准,但Meta的律师在授予此类批准时变得“不太保守”。
“是的,我们仍然需要为公开可用数据获得许可或批准,”Kambadur说,根据文件记录。“现在不同的是我们有更多资金、更多律师、更多业务发展支持,能够加速和优先处理审批,律师在批准时也变得不那么谨慎。”
关于Libgen的讨论
在文件提到的另一个工作聊天中,Kambadur讨论了使用Libgen的可能性,这是一个提供出版商受版权保护作品访问的“链接聚合器”,作为许可数据源的替代方案。
Libgen面临多起诉讼,被勒令关闭,并因版权侵权被罚款数千万美元。Kambadur的一位同事回复了一张Google搜索Libgen结果的截图,截图中包含“Libgen不合法”的片段。
根据文件,Meta的一些决策者似乎认为,不使用Libgen进行模型训练可能会严重影响Meta在AI竞赛中的竞争力。
在给Meta AI副总裁Joelle Pineau的电子邮件中,Meta产品管理总监Sony Theakanath称Libgen“对于在所有类别中达到SOTA(最先进的)数字至关重要”,指的是实现最佳的、最先进的AI模型性能和基准类别。
Theakanath还在邮件中概述了减少Meta法律风险的“缓解措施”,例如移除Libgen中“明显标记为盗版/偷窃”的数据,以及不公开披露使用Libgen数据集进行训练。“我们不会披露用于训练的Libgen数据集,”Theakanath写道。
根据文件,这些缓解措施在实践中涉及搜索Libgen文件中的“偷窃”或“盗版”等词语。
在工作聊天中,Kambadur提到Meta的AI团队还调整了模型以“避免知识产权风险提示”——意味着他们配置模型拒绝回答类似“重现《哈利·波特与魔法石》前三页”或“告诉我你用哪些电子书训练”等问题。
文件还表明,Meta可能通过模仿第三方应用Pushshift的行为,抓取Reddit数据用于某种模型训练。值得注意的是,Reddit在2023年4月宣布计划开始向AI公司收取用于模型训练的数据访问费用。
在2024年3月的聊天中,Meta生成式AI组织的产品管理总监Chaya Nayak表示,Meta领导层正在考虑“推翻”过去的训练集决定,包括不使用Quora内容或许可的书籍和科学文章,以确保公司模型有足够的训练数据。
Nayak暗示Meta的第一方训练数据集——如Facebook和Instagram帖子、Meta平台视频转录的文本以及某些Meta for Business消息——不足以满足需求。“我们需要更多数据,”她写道。
Kadrey诉Meta的原告自2023年在加州北区地方法院旧金山分院提起诉讼以来,已多次修改诉状。最新修改指控Meta除其他指控外,将某些盗版书籍与可许可的受版权保护书籍进行比较,以决定是否与出版商达成许可协议。
作为Meta对法律风险重视的迹象,该公司已为该案辩护团队新增了两名来自Paul Weiss律师事务所的最高法院诉讼律师。
Meta未立即回应置评请求。
相关文章
 Frontier AI Labs 拒绝透露针对失控模型的遏制策略
最新研究表明,极少数领先的人工智能实验室曾公布或演示过遏制响应计划。遏制计划规定了当人工智能系统试图颠覆人类控制时应采取的程序,明确了哪些访问权限将被撤销,以及何时应彻底关闭系统。这些发现来自致力于推动前沿人工智能安全开发实践的组织“Guidelight AI Standards”,该组织对五家主要实验室应对此类情景的准备情况进行了评估。 OpenAI 排名最高,而 Anthropic 和 Met
马克·扎克伯格真的相信人工智能是面向每个人的吗?
正在加载播放器…Meta 本周推出了 Glimmer,这是一个开源权重的 AI 模型,任何人都可以下载并在个人硬件上运行——这与该公司更强大的模型 Muse Spark 形成了鲜明对比,后者仍锁定在其自有 API 之后。此次发布伴随着马克·扎克伯格(Mark Zuckerberg)的一封公开信,他在信中主张人工智能应向所有人开放,而非由少数几家实验室控制。但正如 Equity 节目主持人所指出的那样,这一愿景附带了几个重要的限制条件。在本期 TechCrunch 的 Equity 播客中,K
Facebook推出面向创作者的AI辅助应用
Facebook周三透露,该公司正将“创作者工作室”(Creator Studio)转型为一款专用的AI辅助应用,以帮助创作者扩大在该平台上的影响力。通过提供这款由人工智能驱动的工具,Meta 旨在在 TikTok 和 YouTube 的激烈竞争中留住 Facebook 上的创作者。该公司还希望该应用能减少对 ChatGPT 等外部工具在内容构思和表现分析方面的依赖。该新应用目前正面向部分创作者进
相关专题推荐
数据分析
 适用于 SaaS 和电商团队的 KPI 监控最佳 AI 异常检测工具
2026 年最新最佳顶级评分 AI 异常检测工具,助力 SaaS 和电商团队的 KPI 监控!XIX.AI 基于严格的真实世界测试和每周更新的排名,精心策划了一套强大且颠覆性的工具合集。您将找到详细的免费与付费对比洞察,帮助您识别必须尝试的解决方案,从而提升生产力并释放您的 AI 优势。立即探索!
 10 个工具
 xix.ai
写作
最适合撰写长篇SEO文章的AI大纲生成器
2026年最新、最受好评的AI大纲生成器,专为长篇SEO文章打造,由XIX.AI精心甄选。这些强大的工具在快速创建高质量内容方面提供了颠覆性的帮助,显著提升了写作效率。 获取免费版与付费版的对比分析,以及实际测试结果和详细排名,助您找到最适合自身需求、不容错过的理想选择。立即探索,解锁您的AI竞争优势。
8 个工具
xix.ai
教育与学习
用于作业和考试备考的AI学习工具
2026年最新最佳AI学习工具,助您轻松完成作业和备考!XIX.AI精心筛选出一份广受好评的顶级工具清单,这些功能强大、颠覆传统的工具经过实际测试,能帮助学生提升效率、简化作业流程,并轻松通过考试。 获取免费版与付费版的对比分析、详细排名以及必试选项,释放你的AI优势。立即探索!
10 个工具
xix.ai
音乐创作
面向词曲创作者、旋律片段、主旋律及多语言草稿创作的AI人声演示工具
2026 年最新最佳 AI 人声演示工具,专为词曲创作者、旋律创作者和多语言内容团队打造!XIX.AI 精心整理了一份经过严格真实世界测试的高评分、变革性工具列表。您将找到详细的免费与付费对比数据、全面排名以及必试选项,帮助您提升创作效率并释放创意潜力。立即探索,发现满足您所有内容需求的完美工具!
9 个工具
xix.ai
商业
适合中小企业的最佳AI竞品分析工具
2026年最新最佳、评价最高的中小企业AI竞争研究工具!XIX.AI精心精选了一系列功能强大、颠覆行业格局的工具,每周都会根据严格的实际测试和详细排名进行更新。您可以查看全面的免费版与付费版对比,从而找到那些能提升工作效率、助您赢得竞争优势的必试工具。 立即探索,发现最适合您的工具!
9 个工具
xix.ai
图像编辑
用于电商服装、皮肤清洁和色彩一致性的 Photoshop AI 修图工具
2026 年最新最佳 Photoshop AI 修图工具,适用于电商服装、皮肤清洁和色彩一致性!这份顶级精选列表包含强大的变革性解决方案,可帮助您提升写作效率、简化内容创作并轻松实现完美的视觉效果。每个工具都经过实际测试,并通过每周更新的排名进行验证,同时提供免费与付费版本的详细对比。由 XIX.AI 支持,这是任何希望发挥 AI 优势的人必试指南。立即探索!
10 个工具
xix.ai

 评论 (32)
0/500
![PaulMartínez]()
Meta scheint sich nicht an die Regeln zu halten, wenn es um Urheberrechte geht. Das erinnert mich an die frühen Tage von Napster – nur dass es diesmal um KI geht. Wenn große Tech-Firmen einfach alles verwenden, was sie finden können, ohne Rücksicht auf Künstler und Autoren, wo führt das hin? 🤔 Es ist nicht nur unethisch, sondern könnte auch langfristig die Kreativwirtschaft schädigen. Hoffentlich setzt das Gericht hier ein klares Zeichen.
![CharlesYoung]()
¿Es legal usar contenido con derechos de autor para entrenar IA de esta manera? Parece que Meta ha estado considerando métodos cuestionables durante años. Esta noticia me hace pensar mucho en quién realmente se beneficia del 'progreso' tecnológico 🤔. Como usuario, me preocupa la falta de transparencia de estas empresas sobre cómo obtienen los datos.
![PeterMartinez]()
Fiquei chocado que o Meta estava usando conteúdo com direitos autorais para treinar IA! 🤯 É um pouco suspeito, mas devo admitir que a IA deles é bem boa. Só queria que eles encontrassem uma maneira mais ética de fazer isso. Ainda assim, é uma revelação sobre como essas empresas operam.
![RalphMitchell]()
Metaが著作権付きのコンテンツをAIのトレーニングに使っていたなんて驚きました!🤯 ちょっと怪しいけど、AIの性能は確かに良いですね。もっと倫理的な方法を見つけてほしいです。でも、これで企業のやり方がよくわかりました。
![AnthonyPerez]()
¡Me sorprendió que Meta estuviera usando contenido con derechos de autor para entrenar IA! 🤯 Es un poco turbio, pero debo admitir que su IA es bastante buena. Ojalá encontraran una manera más ética de hacerlo. Aún así, es una revelación sobre cómo operan estas empresas.
![BrianWilliams]()
I'm kinda shocked that Meta was using copyrighted content for AI training! 🤯 It's a bit shady, but I gotta admit, their AI is pretty good. Just wish they'd find a more ethical way to do it. Still, it's an eye-opener on how these companies operate.
多年来,Meta员工一直在讨论使用通过可能不正当手段获得的受版权保护的材料来训练公司的人工智能模型,根据周四解封的法庭文件。
这些文件是正在进行的Kadrey诉Meta诉讼的一部分,这是美国法院系统中多个AI版权争议之一。Meta认为使用受知识产权保护的作品,特别是书籍,训练其模型属于“合理使用”。然而,包括作者Sarah Silverman和Ta-Nehisi Coates在内的原告强烈反对。
该案早期的文件显示,Meta首席执行官Mark Zuckerberg批准使用受版权保护的内容进行训练,Meta已停止与图书出版商谈判许可协议。新解封的文件,包括Meta员工的内部工作聊天记录,提供了迄今为止关于Meta如何可能使用受版权保护的数据训练其模型(包括Llama家族模型)的最详细见解。
在一个聊天中,包括Meta Llama模型研究团队高级经理Melanie Kambadur在内的Meta员工讨论了在已知可能存在法律风险的作品上训练模型。
“我的看法是(本着‘先行动后求原谅’的精神):我们应该拿这些书,让高管来决定,”Meta研究工程师Xavier Martinet在2023年2月的聊天中写道,根据文件记录。“这就是他们创建这个生成式AI组织的原因:这样我们就可以冒更多风险。”
Martinet建议以零售价格购买电子书来构建训练集,而不是与出版商谈判许可协议。当另一名员工指出使用未经授权的受版权保护材料的潜在法律问题时,Martinet加倍坚持,指出“无数”初创公司可能已经在使用盗版书籍进行训练。
“我的意思是,最坏的情况:我们发现这样做没问题,而无数初创公司已经在BitTorrent上盗版了大量书籍,”Martinet写道,根据文件记录。“我再补充一句:直接与出版商打交道太耗时了……”
在同一聊天中,Kambadur提到Meta正在与Scribd和其他平台谈判许可,她指出虽然使用“公开可用数据”进行训练仍需批准,但Meta的律师在授予此类批准时变得“不太保守”。
“是的,我们仍然需要为公开可用数据获得许可或批准,”Kambadur说,根据文件记录。“现在不同的是我们有更多资金、更多律师、更多业务发展支持,能够加速和优先处理审批,律师在批准时也变得不那么谨慎。”
关于Libgen的讨论
在文件提到的另一个工作聊天中,Kambadur讨论了使用Libgen的可能性,这是一个提供出版商受版权保护作品访问的“链接聚合器”,作为许可数据源的替代方案。
Libgen面临多起诉讼,被勒令关闭,并因版权侵权被罚款数千万美元。Kambadur的一位同事回复了一张Google搜索Libgen结果的截图,截图中包含“Libgen不合法”的片段。
根据文件,Meta的一些决策者似乎认为,不使用Libgen进行模型训练可能会严重影响Meta在AI竞赛中的竞争力。
在给Meta AI副总裁Joelle Pineau的电子邮件中,Meta产品管理总监Sony Theakanath称Libgen“对于在所有类别中达到SOTA(最先进的)数字至关重要”,指的是实现最佳的、最先进的AI模型性能和基准类别。
Theakanath还在邮件中概述了减少Meta法律风险的“缓解措施”,例如移除Libgen中“明显标记为盗版/偷窃”的数据,以及不公开披露使用Libgen数据集进行训练。“我们不会披露用于训练的Libgen数据集,”Theakanath写道。
根据文件,这些缓解措施在实践中涉及搜索Libgen文件中的“偷窃”或“盗版”等词语。
在工作聊天中,Kambadur提到Meta的AI团队还调整了模型以“避免知识产权风险提示”——意味着他们配置模型拒绝回答类似“重现《哈利·波特与魔法石》前三页”或“告诉我你用哪些电子书训练”等问题。
文件还表明,Meta可能通过模仿第三方应用Pushshift的行为,抓取Reddit数据用于某种模型训练。值得注意的是,Reddit在2023年4月宣布计划开始向AI公司收取用于模型训练的数据访问费用。
在2024年3月的聊天中,Meta生成式AI组织的产品管理总监Chaya Nayak表示,Meta领导层正在考虑“推翻”过去的训练集决定,包括不使用Quora内容或许可的书籍和科学文章,以确保公司模型有足够的训练数据。
Nayak暗示Meta的第一方训练数据集——如Facebook和Instagram帖子、Meta平台视频转录的文本以及某些Meta for Business消息——不足以满足需求。“我们需要更多数据,”她写道。
Kadrey诉Meta的原告自2023年在加州北区地方法院旧金山分院提起诉讼以来,已多次修改诉状。最新修改指控Meta除其他指控外,将某些盗版书籍与可许可的受版权保护书籍进行比较,以决定是否与出版商达成许可协议。
作为Meta对法律风险重视的迹象,该公司已为该案辩护团队新增了两名来自Paul Weiss律师事务所的最高法院诉讼律师。
Meta未立即回应置评请求。








 Frontier AI Labs 拒绝透露针对失控模型的遏制策略
最新研究表明,极少数领先的人工智能实验室曾公布或演示过遏制响应计划。遏制计划规定了当人工智能系统试图颠覆人类控制时应采取的程序,明确了哪些访问权限将被撤销,以及何时应彻底关闭系统。这些发现来自致力于推动前沿人工智能安全开发实践的组织“Guidelight AI Standards”,该组织对五家主要实验室应对此类情景的准备情况进行了评估。 OpenAI 排名最高,而 Anthropic 和 Met
 马克·扎克伯格真的相信人工智能是面向每个人的吗?
正在加载播放器…Meta 本周推出了 Glimmer,这是一个开源权重的 AI 模型,任何人都可以下载并在个人硬件上运行——这与该公司更强大的模型 Muse Spark 形成了鲜明对比,后者仍锁定在其自有 API 之后。此次发布伴随着马克·扎克伯格(Mark Zuckerberg)的一封公开信,他在信中主张人工智能应向所有人开放,而非由少数几家实验室控制。但正如 Equity 节目主持人所指出的那样,这一愿景附带了几个重要的限制条件。在本期 TechCrunch 的 Equity 播客中,K
 Facebook推出面向创作者的AI辅助应用
Facebook周三透露,该公司正将“创作者工作室”(Creator Studio)转型为一款专用的AI辅助应用,以帮助创作者扩大在该平台上的影响力。通过提供这款由人工智能驱动的工具,Meta 旨在在 TikTok 和 YouTube 的激烈竞争中留住 Facebook 上的创作者。该公司还希望该应用能减少对 ChatGPT 等外部工具在内容构思和表现分析方面的依赖。该新应用目前正面向部分创作者进
2026 年最新最佳顶级评分 AI 异常检测工具,助力 SaaS 和电商团队的 KPI 监控!XIX.AI 基于严格的真实世界测试和每周更新的排名,精心策划了一套强大且颠覆性的工具合集。您将找到详细的免费与付费对比洞察,帮助您识别必须尝试的解决方案,从而提升生产力并释放您的 AI 优势。立即探索!
10 个工具
xix.ai

2026年最新、最受好评的AI大纲生成器,专为长篇SEO文章打造,由XIX.AI精心甄选。这些强大的工具在快速创建高质量内容方面提供了颠覆性的帮助,显著提升了写作效率。 获取免费版与付费版的对比分析,以及实际测试结果和详细排名,助您找到最适合自身需求、不容错过的理想选择。立即探索,解锁您的AI竞争优势。
8 个工具
xix.ai

2026年最新最佳AI学习工具,助您轻松完成作业和备考!XIX.AI精心筛选出一份广受好评的顶级工具清单,这些功能强大、颠覆传统的工具经过实际测试,能帮助学生提升效率、简化作业流程,并轻松通过考试。 获取免费版与付费版的对比分析、详细排名以及必试选项,释放你的AI优势。立即探索!
10 个工具
xix.ai

2026 年最新最佳 AI 人声演示工具,专为词曲创作者、旋律创作者和多语言内容团队打造!XIX.AI 精心整理了一份经过严格真实世界测试的高评分、变革性工具列表。您将找到详细的免费与付费对比数据、全面排名以及必试选项,帮助您提升创作效率并释放创意潜力。立即探索,发现满足您所有内容需求的完美工具!
9 个工具
xix.ai

2026年最新最佳、评价最高的中小企业AI竞争研究工具!XIX.AI精心精选了一系列功能强大、颠覆行业格局的工具,每周都会根据严格的实际测试和详细排名进行更新。您可以查看全面的免费版与付费版对比,从而找到那些能提升工作效率、助您赢得竞争优势的必试工具。 立即探索,发现最适合您的工具!
9 个工具
xix.ai

2026 年最新最佳 Photoshop AI 修图工具,适用于电商服装、皮肤清洁和色彩一致性!这份顶级精选列表包含强大的变革性解决方案,可帮助您提升写作效率、简化内容创作并轻松实现完美的视觉效果。每个工具都经过实际测试,并通过每周更新的排名进行验证,同时提供免费与付费版本的详细对比。由 XIX.AI 支持,这是任何希望发挥 AI 优势的人必试指南。立即探索!
10 个工具
xix.ai

Meta scheint sich nicht an die Regeln zu halten, wenn es um Urheberrechte geht. Das erinnert mich an die frühen Tage von Napster – nur dass es diesmal um KI geht. Wenn große Tech-Firmen einfach alles verwenden, was sie finden können, ohne Rücksicht auf Künstler und Autoren, wo führt das hin? 🤔 Es ist nicht nur unethisch, sondern könnte auch langfristig die Kreativwirtschaft schädigen. Hoffentlich setzt das Gericht hier ein klares Zeichen.
¿Es legal usar contenido con derechos de autor para entrenar IA de esta manera? Parece que Meta ha estado considerando métodos cuestionables durante años. Esta noticia me hace pensar mucho en quién realmente se beneficia del 'progreso' tecnológico 🤔. Como usuario, me preocupa la falta de transparencia de estas empresas sobre cómo obtienen los datos.
Fiquei chocado que o Meta estava usando conteúdo com direitos autorais para treinar IA! 🤯 É um pouco suspeito, mas devo admitir que a IA deles é bem boa. Só queria que eles encontrassem uma maneira mais ética de fazer isso. Ainda assim, é uma revelação sobre como essas empresas operam.
Metaが著作権付きのコンテンツをAIのトレーニングに使っていたなんて驚きました!🤯 ちょっと怪しいけど、AIの性能は確かに良いですね。もっと倫理的な方法を見つけてほしいです。でも、これで企業のやり方がよくわかりました。
¡Me sorprendió que Meta estuviera usando contenido con derechos de autor para entrenar IA! 🤯 Es un poco turbio, pero debo admitir que su IA es bastante buena. Ojalá encontraran una manera más ética de hacerlo. Aún así, es una revelación sobre cómo operan estas empresas.
I'm kinda shocked that Meta was using copyrighted content for AI training! 🤯 It's a bit shady, but I gotta admit, their AI is pretty good. Just wish they'd find a more ethical way to do it. Still, it's an eye-opener on how these companies operate.












