


 首页
法院文件显示,元数据停止了AI培训的书籍许可
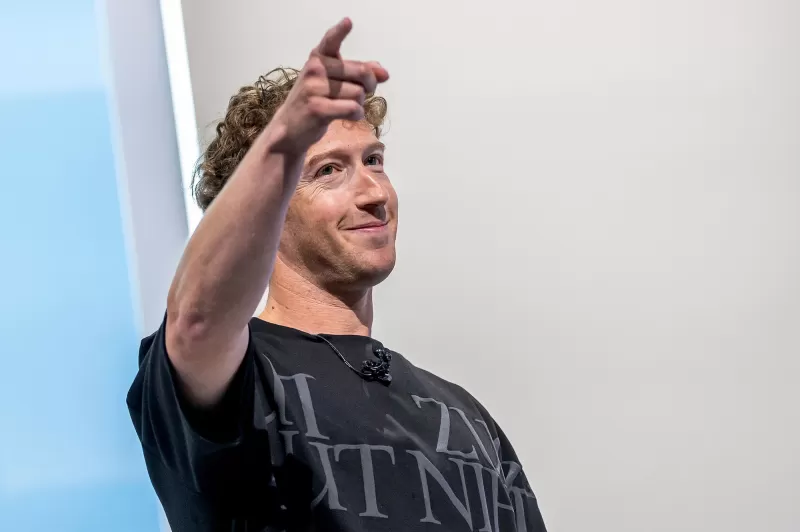
在正在进行的AI针对META的版权诉讼中的最新发展中,新的法院文件浮出水面,这些文件浮出水面,以使有关该公司在与书籍出版商的会谈中暂停宣传。这些讨论旨在确保培训数据的许可,以促进Meta的某些生成AI模型。有问题的案件,Kadreyv。Meta平台只是导航美国司法系统的几项类似法律斗争之一,AI公司发现自己与作者和其他版权所有者矛盾。通常,AI公司作为被告,认为使用受版权保护的材料进行培训属于“公平利用”,这是原告人激烈争论的立场,这些立场是版权所有者。周五提交给法院的最新文件包含了原告法律团队的元雇员证词的摘录。这些文件暗示,元人士认为,对培训AI进行培训的书籍数据进行谈判可能不是可行的长期战略。在他的证词期间,负责Meta AI合作伙伴关系计划的Sy Choudhury提到,他们与各种出版商建立联系的尝试与热烈欢迎的接待处相遇。乔杜里说:“我不记得整个列表,但我记得我们最初搜寻了顶级出版商等的列表。” “而且我们没有得到联系和反馈 - 我们的许多冷电宣传活动都试图建立联系。”他补充说,只有少数出版商实际上与他们互动。法院的成绩单显示,梅塔(Meta)在2023年4月初与AI相关的某些书籍许可工作搁置,理由是与时机和其他后勤障碍有关。乔杜里(Choudhury)解释说,一些出版商,尤其是那些从事小说的出版商,实际上并没有拥有元数据对许可感兴趣的内容的权利。他说:“我想指出的是,在小说类别中,我们很快从业务发展团队中获悉,我们正在与之交谈的大多数出版商,他们本身都代表了他们实际上没有将数据许可给我们的权利。” “因此,与所有作者互动将需要很长时间。”乔杜里(Choudhury)在沉积期间还透露,梅塔(Meta)此前暂停了其他与AI相关的许可工作。他列举了一个实例,他们试图从游戏引擎和游戏制造商的AI研究团队中许可3D世界,但兴趣不大。他解释说:“就像我在这里为小说和教科书数据所描述的方式一样,我们几乎没有参与到进行对话[...]我们决定 - 在这种情况下,我们决定构建自己的解决方案。”自从在美国加利福尼亚州北部地区的美国北部地区,旧金山分部启动诉讼以来出版商。此外,投诉称,元元素利用“影子图书馆”充满了盗版的电子书来培训其几种AI模型,包括著名的Llama系列“ Open”模型。这表明Meta可能通过Torrenting访问了这些库,这是一种文件共享方法,其中涉及上传或“播种”,一个人正在下载的文件,原告声称的文件构成了版权侵权。
相关文章
 Frontier AI Labs 拒绝透露针对失控模型的遏制策略
最新研究表明,极少数领先的人工智能实验室曾公布或演示过遏制响应计划。遏制计划规定了当人工智能系统试图颠覆人类控制时应采取的程序,明确了哪些访问权限将被撤销,以及何时应彻底关闭系统。这些发现来自致力于推动前沿人工智能安全开发实践的组织“Guidelight AI Standards”,该组织对五家主要实验室应对此类情景的准备情况进行了评估。 OpenAI 排名最高,而 Anthropic 和 Met
马克·扎克伯格真的相信人工智能是面向每个人的吗?
正在加载播放器…Meta 本周推出了 Glimmer,这是一个开源权重的 AI 模型,任何人都可以下载并在个人硬件上运行——这与该公司更强大的模型 Muse Spark 形成了鲜明对比,后者仍锁定在其自有 API 之后。此次发布伴随着马克·扎克伯格(Mark Zuckerberg)的一封公开信,他在信中主张人工智能应向所有人开放,而非由少数几家实验室控制。但正如 Equity 节目主持人所指出的那样,这一愿景附带了几个重要的限制条件。在本期 TechCrunch 的 Equity 播客中,K
Facebook推出面向创作者的AI辅助应用
Facebook周三透露,该公司正将“创作者工作室”(Creator Studio)转型为一款专用的AI辅助应用,以帮助创作者扩大在该平台上的影响力。通过提供这款由人工智能驱动的工具,Meta 旨在在 TikTok 和 YouTube 的激烈竞争中留住 Facebook 上的创作者。该公司还希望该应用能减少对 ChatGPT 等外部工具在内容构思和表现分析方面的依赖。该新应用目前正面向部分创作者进
相关专题推荐
设计与艺术
 适用于角色设定表、灵感板和项目提案演示文稿的 AI 视觉风格参考工具
2026年最新最佳AI视觉风格参考工具(适用于角色设定图、灵感板和项目提案)现已登陆XIX.AI!这份精心筛选的高评分清单汇集了经过严格实战测试、功能强大且能彻底改变游戏规则的工具。 您将在此找到免费版与付费版的对比分析、详细排名以及不容错过的精选工具,助您激发创意并优化工作流程。立即探索,发现能有效提升工作效率的理想工具!
 11 个工具
 xix.ai
搜索引擎优化
最适合制定搜索策略的AI搜索结果页面(SERP)分析工具
2026年最新、最受欢迎且评价最高的人工智能搜索结果页面(SERP)分析工具,均由XIX.AI通过严格的实际测试精心筛选,并每周更新排名。这些强大的工具可助您发掘隐藏的优化机会、提升内容表现,并在搜索领域获得竞争优势。立即寻找最适合您的工具,提升您的搜索策略。现在就来探索吧!
13 个工具
xix.ai
数据分析
适用于 SaaS 和电商团队的 KPI 监控最佳 AI 异常检测工具
2026 年最新最佳顶级评分 AI 异常检测工具,助力 SaaS 和电商团队的 KPI 监控!XIX.AI 基于严格的真实世界测试和每周更新的排名,精心策划了一套强大且颠覆性的工具合集。您将找到详细的免费与付费对比洞察,帮助您识别必须尝试的解决方案,从而提升生产力并释放您的 AI 优势。立即探索!
10 个工具
xix.ai
写作
最适合撰写长篇SEO文章的AI大纲生成器
2026年最新、最受好评的AI大纲生成器,专为长篇SEO文章打造,由XIX.AI精心甄选。这些强大的工具在快速创建高质量内容方面提供了颠覆性的帮助,显著提升了写作效率。 获取免费版与付费版的对比分析,以及实际测试结果和详细排名,助您找到最适合自身需求、不容错过的理想选择。立即探索,解锁您的AI竞争优势。
8 个工具
xix.ai
教育与学习
用于作业和考试备考的AI学习工具
2026年最新最佳AI学习工具,助您轻松完成作业和备考!XIX.AI精心筛选出一份广受好评的顶级工具清单,这些功能强大、颠覆传统的工具经过实际测试,能帮助学生提升效率、简化作业流程,并轻松通过考试。 获取免费版与付费版的对比分析、详细排名以及必试选项,释放你的AI优势。立即探索!
10 个工具
xix.ai
音乐创作
面向词曲创作者、旋律片段、主旋律及多语言草稿创作的AI人声演示工具
2026 年最新最佳 AI 人声演示工具,专为词曲创作者、旋律创作者和多语言内容团队打造!XIX.AI 精心整理了一份经过严格真实世界测试的高评分、变革性工具列表。您将找到详细的免费与付费对比数据、全面排名以及必试选项,帮助您提升创作效率并释放创意潜力。立即探索,发现满足您所有内容需求的完美工具!
9 个工具
xix.ai

 评论 (35)
0/500
![BillyYoung]()
Интересно, сколько вообще больших книг Meta успела закупить до этих судебных процессов? 🧐 Это похоже на попытку заткнуть дыру в лодке, когда она уже почти набрала воды. Их модель Llama уже обучена на части этого контента, разве нет? Остановка переговоров выглядит скорее как PR-ход из-за иска, а не реальная смена этических принципов в ИИ. Ждём следующий ход от Google и OpenAI.
![VictoriaBaker]()
Pas étonnant que Meta fasse marche arrière... Les questions de droits d'auteur dans l'IA deviennent vraiment épineuses. Est-ce qu'on va vers un futur où seuls les géants tech pourront se permettre d'entraîner des modèles ? 😬 Cette course aux données commence à ressembler à une partie d'échecs légale.
![CarlMartin]()
Intéressant, mais Meta aurait dû anticiper ces problèmes de droits d'auteur depuis longtemps... C'est un peu naïf de penser qu'on peut utiliser des livres sans permission, non ? 😅 Les grandes entreprises tech devraient vraiment réfléchir aux conséquences avant d'agir.
![KeithLopez]()
Wow, Meta pausing book licensing talks for AI training is a big shift! Makes me wonder if they're rethinking their whole AI strategy or just dodging legal heat. 📚⚖️
![RaymondGarcia]()
Wow, Meta's hitting the brakes on book licensing for AI? Kinda wild to think how much copyrighted stuff gets scooped up for these models. Makes me wonder what's next for AI ethics.
![CharlesRoberts]()
Nossa, a decisão da Meta de interromper a licença de livros para treinamento de IA é algo grande! Parece que eles estão freando seus projetos de IA. Fico me perguntando o que vem a seguir para eles. Espero que encontrem uma maneira de avançar sem pisar em muitos calos! 🤔








 Frontier AI Labs 拒绝透露针对失控模型的遏制策略
最新研究表明,极少数领先的人工智能实验室曾公布或演示过遏制响应计划。遏制计划规定了当人工智能系统试图颠覆人类控制时应采取的程序,明确了哪些访问权限将被撤销,以及何时应彻底关闭系统。这些发现来自致力于推动前沿人工智能安全开发实践的组织“Guidelight AI Standards”,该组织对五家主要实验室应对此类情景的准备情况进行了评估。 OpenAI 排名最高,而 Anthropic 和 Met
 马克·扎克伯格真的相信人工智能是面向每个人的吗?
正在加载播放器…Meta 本周推出了 Glimmer,这是一个开源权重的 AI 模型,任何人都可以下载并在个人硬件上运行——这与该公司更强大的模型 Muse Spark 形成了鲜明对比,后者仍锁定在其自有 API 之后。此次发布伴随着马克·扎克伯格(Mark Zuckerberg)的一封公开信,他在信中主张人工智能应向所有人开放,而非由少数几家实验室控制。但正如 Equity 节目主持人所指出的那样,这一愿景附带了几个重要的限制条件。在本期 TechCrunch 的 Equity 播客中,K
 Facebook推出面向创作者的AI辅助应用
Facebook周三透露,该公司正将“创作者工作室”(Creator Studio)转型为一款专用的AI辅助应用,以帮助创作者扩大在该平台上的影响力。通过提供这款由人工智能驱动的工具,Meta 旨在在 TikTok 和 YouTube 的激烈竞争中留住 Facebook 上的创作者。该公司还希望该应用能减少对 ChatGPT 等外部工具在内容构思和表现分析方面的依赖。该新应用目前正面向部分创作者进
2026年最新最佳AI视觉风格参考工具(适用于角色设定图、灵感板和项目提案)现已登陆XIX.AI!这份精心筛选的高评分清单汇集了经过严格实战测试、功能强大且能彻底改变游戏规则的工具。 您将在此找到免费版与付费版的对比分析、详细排名以及不容错过的精选工具,助您激发创意并优化工作流程。立即探索,发现能有效提升工作效率的理想工具!
11 个工具
xix.ai
2026年最新、最受欢迎且评价最高的人工智能搜索结果页面(SERP)分析工具,均由XIX.AI通过严格的实际测试精心筛选,并每周更新排名。这些强大的工具可助您发掘隐藏的优化机会、提升内容表现,并在搜索领域获得竞争优势。立即寻找最适合您的工具,提升您的搜索策略。现在就来探索吧!
13 个工具
xix.ai
2026 年最新最佳顶级评分 AI 异常检测工具,助力 SaaS 和电商团队的 KPI 监控!XIX.AI 基于严格的真实世界测试和每周更新的排名,精心策划了一套强大且颠覆性的工具合集。您将找到详细的免费与付费对比洞察,帮助您识别必须尝试的解决方案,从而提升生产力并释放您的 AI 优势。立即探索!
10 个工具
xix.ai

2026年最新、最受好评的AI大纲生成器,专为长篇SEO文章打造,由XIX.AI精心甄选。这些强大的工具在快速创建高质量内容方面提供了颠覆性的帮助,显著提升了写作效率。 获取免费版与付费版的对比分析,以及实际测试结果和详细排名,助您找到最适合自身需求、不容错过的理想选择。立即探索,解锁您的AI竞争优势。
8 个工具
xix.ai

2026年最新最佳AI学习工具,助您轻松完成作业和备考!XIX.AI精心筛选出一份广受好评的顶级工具清单,这些功能强大、颠覆传统的工具经过实际测试,能帮助学生提升效率、简化作业流程,并轻松通过考试。 获取免费版与付费版的对比分析、详细排名以及必试选项,释放你的AI优势。立即探索!
10 个工具
xix.ai

2026 年最新最佳 AI 人声演示工具,专为词曲创作者、旋律创作者和多语言内容团队打造!XIX.AI 精心整理了一份经过严格真实世界测试的高评分、变革性工具列表。您将找到详细的免费与付费对比数据、全面排名以及必试选项,帮助您提升创作效率并释放创意潜力。立即探索,发现满足您所有内容需求的完美工具!
9 个工具
xix.ai

Интересно, сколько вообще больших книг Meta успела закупить до этих судебных процессов? 🧐 Это похоже на попытку заткнуть дыру в лодке, когда она уже почти набрала воды. Их модель Llama уже обучена на части этого контента, разве нет? Остановка переговоров выглядит скорее как PR-ход из-за иска, а не реальная смена этических принципов в ИИ. Ждём следующий ход от Google и OpenAI.
Pas étonnant que Meta fasse marche arrière... Les questions de droits d'auteur dans l'IA deviennent vraiment épineuses. Est-ce qu'on va vers un futur où seuls les géants tech pourront se permettre d'entraîner des modèles ? 😬 Cette course aux données commence à ressembler à une partie d'échecs légale.
Intéressant, mais Meta aurait dû anticiper ces problèmes de droits d'auteur depuis longtemps... C'est un peu naïf de penser qu'on peut utiliser des livres sans permission, non ? 😅 Les grandes entreprises tech devraient vraiment réfléchir aux conséquences avant d'agir.
Wow, Meta pausing book licensing talks for AI training is a big shift! Makes me wonder if they're rethinking their whole AI strategy or just dodging legal heat. 📚⚖️
Wow, Meta's hitting the brakes on book licensing for AI? Kinda wild to think how much copyrighted stuff gets scooped up for these models. Makes me wonder what's next for AI ethics.
Nossa, a decisão da Meta de interromper a licença de livros para treinamento de IA é algo grande! Parece que eles estão freando seus projetos de IA. Fico me perguntando o que vem a seguir para eles. Espero que encontrem uma maneira de avançar sem pisar em muitos calos! 🤔












