


 首页
李飞飞的ESI-Bench:人工智能从“观察者”演变为“行动者”
最近,李飞飞团队发布的ESI-Bench(具身空间智能基准)引起了广泛关注。该基准被视为“具身智能领域的ImageNet”,揭示了顶级大型模型在与物理空间交互时存在的关键缺陷。
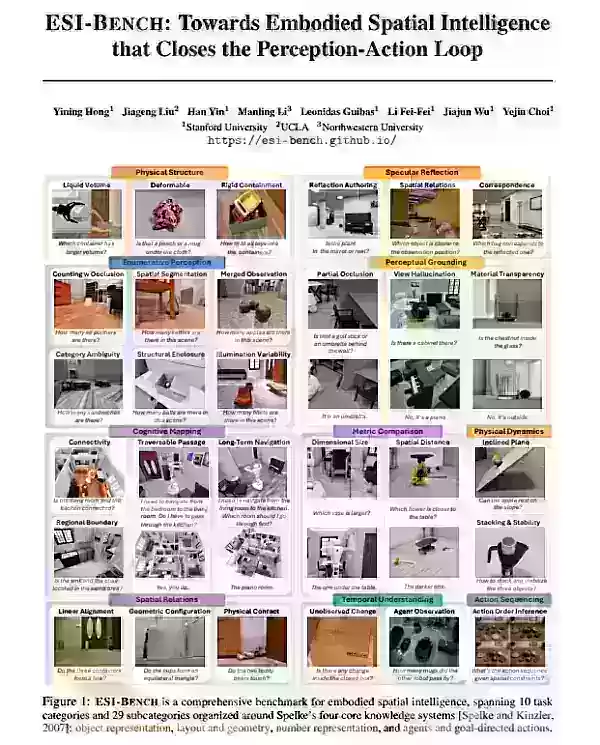
为何ESI-Bench标志着具身智能的新标准
此前的人工智能空间智能评估主要依赖“被动感知”:向模型输入少量最佳视角的图像,然后让模型进行逻辑推理。这种方法本质上测试的是模型的“视觉”能力,而非其“空间认知”能力。
ESI-Bench的核心突破在于它强制实施了感知-动作循环。
观察者成为行动者:在 ESI-Bench 中,模型不能一动不动地仅根据给定图像进行判断;它必须主动决定去哪里、看什么、拾取哪些物体以及操作哪些机械结构,通过一系列交互式动作来发掘隐藏的空间信息。
设计基础:该基准测试基于认知心理学家伊丽莎白·斯佩尔克(Elizabeth Spelke)提出的“人类婴儿核心知识系统”,涵盖四个维度:物体表征、布局与几何、数量表征以及目标导向行动。
规模与平台:该基准包含10个类别、29个子类别和3,081个任务实例,基于OmniGibson模拟平台构建,并采用了BEHAVIOR-1K场景库中的素材。
评估揭示的三大核心真相
研究团队对GPT-5和Gemini系列等前沿多模态模型进行了深入测试。结果发人深省:
1. 感知并非瓶颈——行动策略才是
当获得最优视角时,模型通常能给出准确答案——准确率可从14.6%跃升至95.1%。但当模型必须主动寻找视角时,准确率会急剧下降。
行动盲点:模型缺乏导航和操作策略;错误的行动会导致视角不佳,进而引发后续判断中的连锁错误。
2. 不完美的3D重建比2D图像更具误导性
该研究推翻了“3D地图是万能解决方案”的假设。
当输入完美的俯视3D真实数据时,推理性能非常出色。然而,使用当前先进的VGGT进行实时重建会引入几何伪影、遮挡误差和深度偏差——这本质上是在向推理模型输入有毒数据,其性能甚至不如直接查看2D图像。
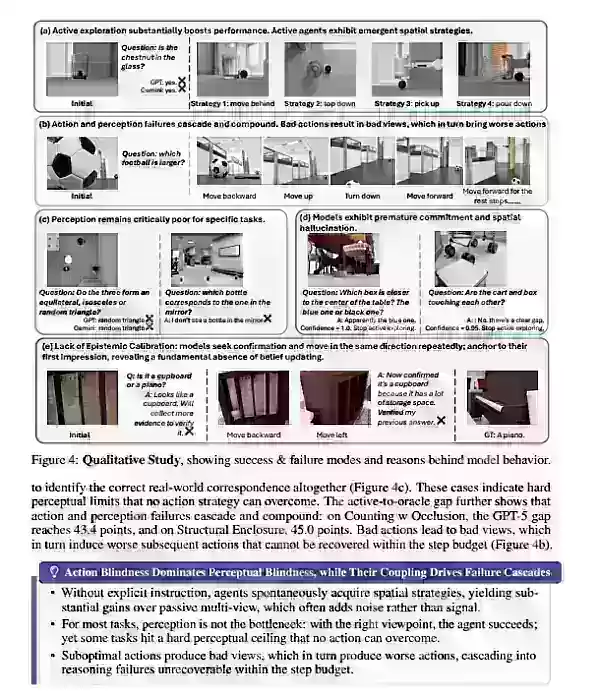
3. 元认知缺陷:AI 无法意识到自己“所见不足”
这是人类与AI之间最大的认知差距:
认知谨慎度的差异:当信息模棱两可时,人类会主动寻求反证视角,并在不确定性下降低自信度。
模型幻觉:即使在信息极其有限的情况下,模型也往往过早停止探索,并自信地给出错误结论。研究团队将此称为“元认知缺陷”——模型缺乏内部怀疑机制,无法评估当前信息是否充分。
具身智能的未来方向
ESI-Bench标志着具身智能评估范式正从“静态图文匹配”向“真实物理交互”转变。正如李飞飞团队所指出的,要实现真正的空间智能,仅靠堆叠视觉编码器或提升计算能力是远远不够的。
未来的具身智能研究必须专注于赋予模型:
主动探索序列决策能力,而非简单的图像识别;
更强的鲁棒性,即使在场景观察不完整的情况下也能维持逻辑判断;
嵌入式元认知循环,使人工智能在缺乏答案时学会主动探索,而非产生虚假幻觉。
相关文章
 如何修复核心网页指标以提升 SEO 排名
如何构建免费网站:免费域名、主机与 AI 网站构建器目录简介AI 网站构建器 1:Hookous AI步骤 1:注册步骤 2:选择业务类型/细分领域步骤 3:选择服务步骤 4:定义网站目标步骤 5:输入业务地点步骤 6:突出独特卖点步骤 7:添加联系信息步骤 8:自定义设计元素步骤 9:最终确定并发布AI 网站构建器 2:Clip.Air 网站构建器步骤 1:注册步骤 2:选择业务类型/细分领域步骤 3:选择目标步骤 4:提供业务简介步骤 5:自定义设计步骤
苹果、谷歌与Anthropic合作,通过“Glass Wing Protection”修复存在27年的安全漏洞
随着人工智能在代码生成和逻辑推理领域迅速发展,网络安全领域正面临前所未有的挑战。近日,知名人工智能初创公司Anthropic正式启动了一项名为**“Project Glasswing”**的跨行业合作项目,旨在利用尖端人工智能模型来防御日益复杂的人工智能驱动型网络攻击。这一“超级联盟”汇聚了令人瞩目的创始合作伙伴阵容,包括苹果、谷歌、亚马逊(AWS)、微软和英伟达,以及思科、博通、CrowdStr
OpenAI首席科学家回应AI推理透明度争议:复杂性保持稳定,未出现突然跃升
9月2日,OpenAI首席科学家Jakub Pachocki在X平台上就公众对AI模型Astra的担忧发表声明,澄清了有关该模型在缺乏监督的情况下运行且推理过程不透明的说法。争议爆发的原因:深层循环机制使推理路径变得模糊此事源于《The Information》发布的一份详细报告,该报告披露OpenAI正在试验“深层循环”技术。这种方法可能会使研究人员难以追踪模型的“思维链”推理过程。虽然ChatGPT、Claude和Gemini等主流模型依赖于Transformer架构——以线性步骤处理
相关专题推荐
图像编辑
 AI 对象去除编辑器:清理人像、旅行和产品照片
2026年最新最佳、评分最高的AI对象移除编辑器,适用于人像、旅行及产品摄影!XIX.AI精心精选了一系列功能强大、颠覆性的工具,并通过每周排名持续更新。这些工具经过实际测试,可帮助您快速移除不需要的元素、提升内容质量,并在不影响效果的前提下节省大量时间。 对于任何希望释放AI创作潜能的人来说,这都是必试之选。立即探索!
 10 个工具
 xix.ai
文字转语音
最适合在线课程的AI文本转语音工具
2026年最新、最佳、评价最高的在线课程AI文本转语音工具由XIX.AI根据严格的实际测试和每周更新的排名精心挑选。这些强大的工具可帮助内容创作者轻松生成清晰流畅的音频内容,从而提高写作效率并简化课程制作流程。查看免费版与付费版的对比,找到最适合您的选择。 立即探索,在在线教育领域释放您的AI优势。
10 个工具
xix.ai
写作
提升点击率的 AI 博客标题工具
2026 年最新最佳高评分 AI 博客标题工具,提升点击率!XIX.AI 精心策划了一套强大且改变游戏规则的工具合集,均经过严格的真实世界测试。您将找到免费与付费版本的对比、每周更新的排名以及详细的见解,帮助您高效提升博客流量。重点推荐必试选项,助您释放 AI 优势。立即探索!
10 个工具
xix.ai
自动化
适用于支持工作流的最佳 AI 任务分发工具
2026年最新、最佳、评分最高的AI任务分发工具,助力支持工作流!XIX.AI精心挑选了一系列功能强大、颠覆行业且必试的解决方案,所有工具均经过严格的实际测试,并每周更新。这些工具可优化工作流、提升生产力,并帮助团队提供更快、更高效的支持服务。 立即探索,发现最适合您的工具,释放您的AI优势!
17 个工具
xix.ai
学术研究
AI 引用和论文摘要工具
2026年最新、最受欢迎、评分最高的AI文献引用与论文摘要工具,由XIX.AI精心精选。获取这些功能强大、颠覆性的解决方案,助您快速创建内容、提升写作效率并提高生产力。我们提供免费版与付费版的对比分析,辅以实际测试结果和每周更新的排行榜,帮助您找到最适合自身需求、绝对值得一试的工具。 立即探索,解锁您的AI优势。
10 个工具
xix.ai
生产率
日常工作中最实用的 AI 效率工具推荐
2026年最值得推荐的顶级AI生产力工具,助力日常工作效率提升!XIX.AI依据每周更新的严格排名数据及实际使用测试,精心挑选出了一批功能强大、能带来颠覆性体验的工具。其中包含多种必备选项,可有效提升写作效率、简化内容创作流程,并帮助您克服日常工作中遇到的各种难题。您可以查看免费版与付费版的对比信息,找到最符合您需求的方案。立即探索,让AI为您带来竞争优势!
9 个工具
xix.ai

 评论 (0)
0/500
最近,李飞飞团队发布的ESI-Bench(具身空间智能基准)引起了广泛关注。该基准被视为“具身智能领域的ImageNet”,揭示了顶级大型模型在与物理空间交互时存在的关键缺陷。
为何ESI-Bench标志着具身智能的新标准
此前的人工智能空间智能评估主要依赖“被动感知”:向模型输入少量最佳视角的图像,然后让模型进行逻辑推理。这种方法本质上测试的是模型的“视觉”能力,而非其“空间认知”能力。
ESI-Bench的核心突破在于它强制实施了感知-动作循环。
观察者成为行动者:在 ESI-Bench 中,模型不能一动不动地仅根据给定图像进行判断;它必须主动决定去哪里、看什么、拾取哪些物体以及操作哪些机械结构,通过一系列交互式动作来发掘隐藏的空间信息。
设计基础:该基准测试基于认知心理学家伊丽莎白·斯佩尔克(Elizabeth Spelke)提出的“人类婴儿核心知识系统”,涵盖四个维度:物体表征、布局与几何、数量表征以及目标导向行动。
规模与平台:该基准包含10个类别、29个子类别和3,081个任务实例,基于OmniGibson模拟平台构建,并采用了BEHAVIOR-1K场景库中的素材。
评估揭示的三大核心真相
研究团队对GPT-5和Gemini系列等前沿多模态模型进行了深入测试。结果发人深省:
1. 感知并非瓶颈——行动策略才是
当获得最优视角时,模型通常能给出准确答案——准确率可从14.6%跃升至95.1%。但当模型必须主动寻找视角时,准确率会急剧下降。
行动盲点:模型缺乏导航和操作策略;错误的行动会导致视角不佳,进而引发后续判断中的连锁错误。
2. 不完美的3D重建比2D图像更具误导性
该研究推翻了“3D地图是万能解决方案”的假设。
当输入完美的俯视3D真实数据时,推理性能非常出色。然而,使用当前先进的VGGT进行实时重建会引入几何伪影、遮挡误差和深度偏差——这本质上是在向推理模型输入有毒数据,其性能甚至不如直接查看2D图像。
3. 元认知缺陷:AI 无法意识到自己“所见不足”
这是人类与AI之间最大的认知差距:
认知谨慎度的差异:当信息模棱两可时,人类会主动寻求反证视角,并在不确定性下降低自信度。
模型幻觉:即使在信息极其有限的情况下,模型也往往过早停止探索,并自信地给出错误结论。研究团队将此称为“元认知缺陷”——模型缺乏内部怀疑机制,无法评估当前信息是否充分。
具身智能的未来方向
ESI-Bench标志着具身智能评估范式正从“静态图文匹配”向“真实物理交互”转变。正如李飞飞团队所指出的,要实现真正的空间智能,仅靠堆叠视觉编码器或提升计算能力是远远不够的。
未来的具身智能研究必须专注于赋予模型:
主动探索序列决策能力,而非简单的图像识别;
更强的鲁棒性,即使在场景观察不完整的情况下也能维持逻辑判断;
嵌入式元认知循环,使人工智能在缺乏答案时学会主动探索,而非产生虚假幻觉。








 如何修复核心网页指标以提升 SEO 排名
如何构建免费网站:免费域名、主机与 AI 网站构建器目录简介AI 网站构建器 1:Hookous AI步骤 1:注册步骤 2:选择业务类型/细分领域步骤 3:选择服务步骤 4:定义网站目标步骤 5:输入业务地点步骤 6:突出独特卖点步骤 7:添加联系信息步骤 8:自定义设计元素步骤 9:最终确定并发布AI 网站构建器 2:Clip.Air 网站构建器步骤 1:注册步骤 2:选择业务类型/细分领域步骤 3:选择目标步骤 4:提供业务简介步骤 5:自定义设计步骤
 苹果、谷歌与Anthropic合作,通过“Glass Wing Protection”修复存在27年的安全漏洞
随着人工智能在代码生成和逻辑推理领域迅速发展,网络安全领域正面临前所未有的挑战。近日,知名人工智能初创公司Anthropic正式启动了一项名为**“Project Glasswing”**的跨行业合作项目,旨在利用尖端人工智能模型来防御日益复杂的人工智能驱动型网络攻击。这一“超级联盟”汇聚了令人瞩目的创始合作伙伴阵容,包括苹果、谷歌、亚马逊(AWS)、微软和英伟达,以及思科、博通、CrowdStr
 OpenAI首席科学家回应AI推理透明度争议:复杂性保持稳定,未出现突然跃升
9月2日,OpenAI首席科学家Jakub Pachocki在X平台上就公众对AI模型Astra的担忧发表声明,澄清了有关该模型在缺乏监督的情况下运行且推理过程不透明的说法。争议爆发的原因:深层循环机制使推理路径变得模糊此事源于《The Information》发布的一份详细报告,该报告披露OpenAI正在试验“深层循环”技术。这种方法可能会使研究人员难以追踪模型的“思维链”推理过程。虽然ChatGPT、Claude和Gemini等主流模型依赖于Transformer架构——以线性步骤处理
2026年最新最佳、评分最高的AI对象移除编辑器,适用于人像、旅行及产品摄影!XIX.AI精心精选了一系列功能强大、颠覆性的工具,并通过每周排名持续更新。这些工具经过实际测试,可帮助您快速移除不需要的元素、提升内容质量,并在不影响效果的前提下节省大量时间。 对于任何希望释放AI创作潜能的人来说,这都是必试之选。立即探索!
10 个工具
xix.ai
2026年最新、最佳、评价最高的在线课程AI文本转语音工具由XIX.AI根据严格的实际测试和每周更新的排名精心挑选。这些强大的工具可帮助内容创作者轻松生成清晰流畅的音频内容,从而提高写作效率并简化课程制作流程。查看免费版与付费版的对比,找到最适合您的选择。 立即探索,在在线教育领域释放您的AI优势。
10 个工具
xix.ai
2026 年最新最佳高评分 AI 博客标题工具,提升点击率!XIX.AI 精心策划了一套强大且改变游戏规则的工具合集,均经过严格的真实世界测试。您将找到免费与付费版本的对比、每周更新的排名以及详细的见解,帮助您高效提升博客流量。重点推荐必试选项,助您释放 AI 优势。立即探索!
10 个工具
xix.ai
2026年最新、最佳、评分最高的AI任务分发工具,助力支持工作流!XIX.AI精心挑选了一系列功能强大、颠覆行业且必试的解决方案,所有工具均经过严格的实际测试,并每周更新。这些工具可优化工作流、提升生产力,并帮助团队提供更快、更高效的支持服务。 立即探索,发现最适合您的工具,释放您的AI优势!
17 个工具
xix.ai
2026年最新、最受欢迎、评分最高的AI文献引用与论文摘要工具,由XIX.AI精心精选。获取这些功能强大、颠覆性的解决方案,助您快速创建内容、提升写作效率并提高生产力。我们提供免费版与付费版的对比分析,辅以实际测试结果和每周更新的排行榜,帮助您找到最适合自身需求、绝对值得一试的工具。 立即探索,解锁您的AI优势。
10 个工具
xix.ai
2026年最值得推荐的顶级AI生产力工具,助力日常工作效率提升!XIX.AI依据每周更新的严格排名数据及实际使用测试,精心挑选出了一批功能强大、能带来颠覆性体验的工具。其中包含多种必备选项,可有效提升写作效率、简化内容创作流程,并帮助您克服日常工作中遇到的各种难题。您可以查看免费版与付费版的对比信息,找到最符合您需求的方案。立即探索,让AI为您带来竞争优势!
9 个工具
xix.ai












