

 首页
法官批准在Anthropic书籍抄袭案中达成重大和解,裁定赔偿金额逾15亿美元
一起一直困扰着整个人工智能行业的版权纠纷终于有了定论。据总部位于旧金山的美联社报道,一名联邦法官已批准为 Anthropic 签署一笔 15 亿美元的和解协议。这家人工智能公司需向数千名作品被未经许可用于训练其 Claude 聊天机器人的作者支付每本书约 3,000 美元的赔偿金。
在周一发布的裁决中,地方法院法官阿拉塞莉·马丁内斯-奥尔吉因表示,这项集体诉讼和解为受影响的作者和出版商带来了实质性的救济。目前的款项分配流程已经十分明确——在该裁决覆盖的 482,000 多本书籍中,约有 91% 已经被各自的作者或出版商领取,他们现在有资格获得补偿。
代表原告的首席律师贾斯汀·纳尔逊在一份声明中表示,这是迄今为止记录在案的最大规模的版权追偿案件。他还对款项能够尽快发放给所有受影响方表示乐观。这一诉讼的重要性在于,它凸显了人工智能训练数据侵权案件所涉及的赔偿规模,并使这类案件成为版权法研究领域的焦点。
回顾导致这一裁决的整个过程,就能看出该和解方案背后的法律原则。去年 9 月,旧金山的美国地方法院法官威廉·阿尔苏普在卸任前给予了初步批准。同年夏季早些时候,阿尔苏普曾作出过一个模棱两可的裁决:他认定使用受版权保护的书籍来训练人工智能聊天机器人并不违法,但同时也指出 Anthropic 通过非法渠道获得了数百万本书籍,他认为这种行为是不可接受的。合法训练方式与非法数据获取之间的区别,成为了决定案件走向的关键因素。
针对这一裁决,Anthropic 强调其训练方法的合法性。该公司的副总法律顾问阿帕尔纳·斯里达尔表示,这一判决是一个重要的里程碑,它证实了根据版权法,使用书籍来训练人工智能属于合理使用范畴。对于 Anthropic 以及更广泛的大模型行业而言,这一认可的价值远超过 15 亿美元的和解金额本身——它表明司法机构已经认可了此前已经开展的那些训练活动。
虽然 15 亿美元的和解方案已获得法官批准,每本书 3,000 美元的赔偿金也即将发放,但这场诉讼真正的持久影响并不在于金钱赔偿,而在于它确立的两项明确原则:通过盗版手段获取数据会带来严重后果且毫无合理性可言;而使用合法方法训练模型则越来越被法院视为合理使用。未来的每家人工智能公司都必须谨慎地在这两项原则划定的范围内开展业务。
相关文章
 Claude Opus 5.2 夜灰色版发布,响应速度更快,解决懒惰问题
Opus 5.2 今晨悄然上线,促使许多开发者注意到,更新后的模型 Claude Opus 5.2 已在 Claude Code 内部开始有限范围的推送。昨晚,X 平台用户观察到,在 Claude Code 中调用 Opus 5 时,其性能远超标准网页版,宛如“降维打击”。这种路由策略在顶级 AI 公司中十分常见。数据包分析显示,尽管前端标签未变,但底层模型标识符已切换为 Opus 5.2,这表明 Anthropic 可能完全跳过了 5.1 版本。速度、精度与自动“高强度循环”下的持续执行
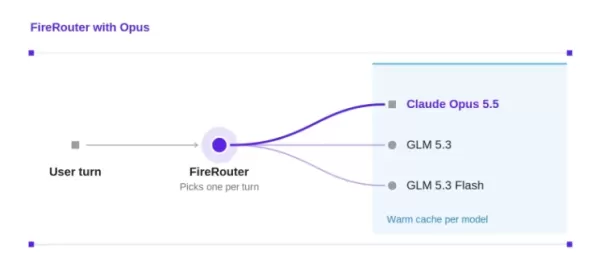
Fireworks AI 发布搭载 Opus 的 FireRouter:编码成本降低 57%,精度损失极小
Fireworks AI 推出了搭载 Opus 的 FireRouter,这是业界首个专为 Claude Opus 系列定制的缓存感知路由系统。目前,该独立路由模型已通过无服务器端点开放使用。经过超过一个月的内部 A/B 测试,FireRouter 在编码任务中实现了 98.1% 的准确率,同时与单独使用 Opus 相比,成本降低了 57%。FireRouter 的工作原理是在每次用户交互时评估每个模型对当前任务的适用性。它计算处理成本(包括提示词缓存),并判断切换模型所节省的成本是否足以抵消缓
NVIDIA 发布 Nemotron-Labs-Audex-30B-A3B 统一音频智能模型
随着多模态大模型的快速发展,音频处理能力往往受到妥协——许多模型在提升音频理解能力的同时,却牺牲了文本逻辑。为解决这一问题,NVIDIA 研究人员推出了 Nemotron-Labs-Audex-30B-A3B(Audex),这是一款统一的音频-文本大语言模型,旨在弥合这一差距。Audex 采用精简高效的设计,基于强大的纯文本混合专家(MoE)架构构建。通过利用单个 Transformer 解码器,它同时处理文本和量化音频令牌。该方法将音频输入投影到文本嵌入空间,确保与现有用于多模态任务的大语言
相关专题推荐
聊天机器人
 适用于电商排队、VIP买家和退货请求的AI实时聊天路由工具
2026年最新最佳、评分最高的AI实时聊天路由工具,适用于电商排队、VIP买家及退货请求。这份精心筛选的清单汇集了经过实际测试、能显著提升工作效率的强大且具有颠覆性的解决方案。其中包含免费版与付费版的对比分析以及详细排名,助您找到最适合的工具。 XIX.AI 是该领域备受信赖的供应商之一。立即探索,释放您的 AI 优势!
 9 个工具
 xix.ai
写作
适合非母语英语写作者的最佳AI编辑工具:提升语气、语法和行文流畅度
2026年最新、最受好评的面向ESL写作者的AI编辑工具已登陆XIX.AI!这份精心筛选的清单收录了功能强大、能彻底改变写作体验的工具,所有工具均经过实际测试,以确保准确性。 您可以在这里找到免费版与付费版的对比分析以及详细的排名榜单,助您挑选出必试的解决方案,完美提升您的写作语气、语法和行文流畅度。立即探索,解锁您的AI优势!
9 个工具
xix.ai
软件开发
面向工程团队的最佳 AI 缺陷分级工具
2026年最新最佳、评价最高的工程团队AI缺陷分级工具!XIX.AI精心精选了一系列功能强大、具有颠覆性的必试工具,这些工具均经过严格的实际环境测试,可提供精准的问题分析和高效的解决方案。 获取免费版与付费版的对比分析以及详细排名,助您找到能显著提升团队生产力的完美解决方案。立即探索,释放您的 AI 优势!
9 个工具
xix.ai
图像编辑
最佳 AI 人像优化工具:改善光线、肤色和清晰度
2026年最新、最佳、评分最高的AI人像优化工具精选,助您获得极致图像质量。这些强大的工具能轻松提升光线、肤色和清晰度,带来颠覆性的效果,非常适合需要快速优化照片的内容创作者。XIX.AI 提供了免费版与付费版的对比分析,以及实际测试结果和每周更新的排行榜。 立即发现最适合您的工具,释放您的AI优势。现在就来探索吧!
7 个工具
xix.ai
写作
用于编写 API 指南、版本说明和入门文档的 AI 技术文档工具
2026年最新最佳高评分AI技术文档工具,适用于API指南、版本说明和入门文档。这份精心筛选的清单汇集了功能强大的、具有变革性的解决方案,可在所有项目阶段简化内容创建、提升写作效率并节省时间。XIX.AI提供每周更新的排名,以及基于实际测试得出的免费版与付费版对比结果。 立即探索,发现最适合您的工具,释放您的AI优势。
10 个工具
xix.ai
设计
面向 B2B 产品团队的 AI 仪表盘原型设计工具
2026年最新最佳B2B产品团队AI仪表盘原型设计工具!XIX.AI精心整理了一份备受好评的工具清单,这些功能强大、具有颠覆性的工具均经过严格的实际测试,能够带来卓越的效果。 您将看到详细的免费版与付费版对比分析,以及每周更新的排名,这些信息将帮助您了解哪些选项能最大程度地优化产品设计工作流程并提升整体生产力。必试选项已清晰标注,助您释放人工智能的竞争优势。立即探索!
11 个工具
xix.ai

 评论 (0)
0/500
一起一直困扰着整个人工智能行业的版权纠纷终于有了定论。据总部位于旧金山的美联社报道,一名联邦法官已批准为 Anthropic 签署一笔 15 亿美元的和解协议。这家人工智能公司需向数千名作品被未经许可用于训练其 Claude 聊天机器人的作者支付每本书约 3,000 美元的赔偿金。
在周一发布的裁决中,地方法院法官阿拉塞莉·马丁内斯-奥尔吉因表示,这项集体诉讼和解为受影响的作者和出版商带来了实质性的救济。目前的款项分配流程已经十分明确——在该裁决覆盖的 482,000 多本书籍中,约有 91% 已经被各自的作者或出版商领取,他们现在有资格获得补偿。
代表原告的首席律师贾斯汀·纳尔逊在一份声明中表示,这是迄今为止记录在案的最大规模的版权追偿案件。他还对款项能够尽快发放给所有受影响方表示乐观。这一诉讼的重要性在于,它凸显了人工智能训练数据侵权案件所涉及的赔偿规模,并使这类案件成为版权法研究领域的焦点。
回顾导致这一裁决的整个过程,就能看出该和解方案背后的法律原则。去年 9 月,旧金山的美国地方法院法官威廉·阿尔苏普在卸任前给予了初步批准。同年夏季早些时候,阿尔苏普曾作出过一个模棱两可的裁决:他认定使用受版权保护的书籍来训练人工智能聊天机器人并不违法,但同时也指出 Anthropic 通过非法渠道获得了数百万本书籍,他认为这种行为是不可接受的。合法训练方式与非法数据获取之间的区别,成为了决定案件走向的关键因素。
针对这一裁决,Anthropic 强调其训练方法的合法性。该公司的副总法律顾问阿帕尔纳·斯里达尔表示,这一判决是一个重要的里程碑,它证实了根据版权法,使用书籍来训练人工智能属于合理使用范畴。对于 Anthropic 以及更广泛的大模型行业而言,这一认可的价值远超过 15 亿美元的和解金额本身——它表明司法机构已经认可了此前已经开展的那些训练活动。
虽然 15 亿美元的和解方案已获得法官批准,每本书 3,000 美元的赔偿金也即将发放,但这场诉讼真正的持久影响并不在于金钱赔偿,而在于它确立的两项明确原则:通过盗版手段获取数据会带来严重后果且毫无合理性可言;而使用合法方法训练模型则越来越被法院视为合理使用。未来的每家人工智能公司都必须谨慎地在这两项原则划定的范围内开展业务。


 Claude Opus 5.2 夜灰色版发布,响应速度更快,解决懒惰问题
Opus 5.2 今晨悄然上线,促使许多开发者注意到,更新后的模型 Claude Opus 5.2 已在 Claude Code 内部开始有限范围的推送。昨晚,X 平台用户观察到,在 Claude Code 中调用 Opus 5 时,其性能远超标准网页版,宛如“降维打击”。这种路由策略在顶级 AI 公司中十分常见。数据包分析显示,尽管前端标签未变,但底层模型标识符已切换为 Opus 5.2,这表明 Anthropic 可能完全跳过了 5.1 版本。速度、精度与自动“高强度循环”下的持续执行
 Fireworks AI 发布搭载 Opus 的 FireRouter:编码成本降低 57%,精度损失极小
Fireworks AI 推出了搭载 Opus 的 FireRouter,这是业界首个专为 Claude Opus 系列定制的缓存感知路由系统。目前,该独立路由模型已通过无服务器端点开放使用。经过超过一个月的内部 A/B 测试,FireRouter 在编码任务中实现了 98.1% 的准确率,同时与单独使用 Opus 相比,成本降低了 57%。FireRouter 的工作原理是在每次用户交互时评估每个模型对当前任务的适用性。它计算处理成本(包括提示词缓存),并判断切换模型所节省的成本是否足以抵消缓
 NVIDIA 发布 Nemotron-Labs-Audex-30B-A3B 统一音频智能模型
随着多模态大模型的快速发展,音频处理能力往往受到妥协——许多模型在提升音频理解能力的同时,却牺牲了文本逻辑。为解决这一问题,NVIDIA 研究人员推出了 Nemotron-Labs-Audex-30B-A3B(Audex),这是一款统一的音频-文本大语言模型,旨在弥合这一差距。Audex 采用精简高效的设计,基于强大的纯文本混合专家(MoE)架构构建。通过利用单个 Transformer 解码器,它同时处理文本和量化音频令牌。该方法将音频输入投影到文本嵌入空间,确保与现有用于多模态任务的大语言
2026年最新最佳、评分最高的AI实时聊天路由工具,适用于电商排队、VIP买家及退货请求。这份精心筛选的清单汇集了经过实际测试、能显著提升工作效率的强大且具有颠覆性的解决方案。其中包含免费版与付费版的对比分析以及详细排名,助您找到最适合的工具。 XIX.AI 是该领域备受信赖的供应商之一。立即探索,释放您的 AI 优势!
9 个工具
xix.ai
2026年最新、最受好评的面向ESL写作者的AI编辑工具已登陆XIX.AI!这份精心筛选的清单收录了功能强大、能彻底改变写作体验的工具,所有工具均经过实际测试,以确保准确性。 您可以在这里找到免费版与付费版的对比分析以及详细的排名榜单,助您挑选出必试的解决方案,完美提升您的写作语气、语法和行文流畅度。立即探索,解锁您的AI优势!
9 个工具
xix.ai
2026年最新最佳、评价最高的工程团队AI缺陷分级工具!XIX.AI精心精选了一系列功能强大、具有颠覆性的必试工具,这些工具均经过严格的实际环境测试,可提供精准的问题分析和高效的解决方案。 获取免费版与付费版的对比分析以及详细排名,助您找到能显著提升团队生产力的完美解决方案。立即探索,释放您的 AI 优势!
9 个工具
xix.ai
2026年最新、最佳、评分最高的AI人像优化工具精选,助您获得极致图像质量。这些强大的工具能轻松提升光线、肤色和清晰度,带来颠覆性的效果,非常适合需要快速优化照片的内容创作者。XIX.AI 提供了免费版与付费版的对比分析,以及实际测试结果和每周更新的排行榜。 立即发现最适合您的工具,释放您的AI优势。现在就来探索吧!
7 个工具
xix.ai
2026年最新最佳高评分AI技术文档工具,适用于API指南、版本说明和入门文档。这份精心筛选的清单汇集了功能强大的、具有变革性的解决方案,可在所有项目阶段简化内容创建、提升写作效率并节省时间。XIX.AI提供每周更新的排名,以及基于实际测试得出的免费版与付费版对比结果。 立即探索,发现最适合您的工具,释放您的AI优势。
10 个工具
xix.ai
2026年最新最佳B2B产品团队AI仪表盘原型设计工具!XIX.AI精心整理了一份备受好评的工具清单,这些功能强大、具有颠覆性的工具均经过严格的实际测试,能够带来卓越的效果。 您将看到详细的免费版与付费版对比分析,以及每周更新的排名,这些信息将帮助您了解哪些选项能最大程度地优化产品设计工作流程并提升整体生产力。必试选项已清晰标注,助您释放人工智能的竞争优势。立即探索!
11 个工具
xix.ai












