

 首页
AI工具将文本转化为创意项目的免费音效
制作音效曾经需要昂贵的设备和专业音效设计师。现在,AI驱动的工具通过简单的文本描述生成音效,正在重塑音频创作。本文介绍了两个出色的AI平台,提供免费的文本到音效生成,为您的创意项目开启无限可能。
主要亮点
通过输入描述性文本,使用ElevenLabs创建音效。
探索Hugging Face AudioLDM 2,这是一个开源工具,用于制作逼真的音频样本。
两个平台均提供免费层级,允许无成本创建多样化的音效。
将音效应用于增强视频、游戏、播客等。
调整提示和设置,精确调整音频输出以满足您的需求。
用AI音效释放创造力
文本到音效的AI革命
音频制作正在经历人工智能驱动的变革浪潮。传统的音效设计通常劳动密集且昂贵,现在被AI工具补充甚至超越,这些工具能从文本输入生成音效。这一突破使独立艺术家、小型企业和没有专业资源的爱好者也能轻松进行音频创作。
这些AI工具使用先进的机器学习来解读文本提示并生成相应的音频。通过输入类似“摩托车呼啸而过”或“海浪拍打海岸”的短语,用户可以创造出提升项目的生动音景。这项技术对视频制作、游戏开发、播客制作甚至治疗用途都非常宝贵,因为特定声音能唤起目标情感。
随着AI不断发展,其在声音生成方面的精度将进一步提高。未来的进步将捕捉细微的细节,区分小雨和雷暴,或木门与铁门的声音。这为沉浸式故事讲述和真实模拟打开了新大门,丰富了跨媒体的用户体验。
从文本生成音效降低了成本,简化了工作流程,并激发了创造力。创作者可以自由实验,测试传统方法下难以实现的多种音频选项。这种灵活性带来精致的、高影响力的项目,提升了跨平台的音频质量标准。
为什么选择AI进行音效创作?
AI驱动的音效生成不仅仅是趋势,它是解决长期音频制作挑战的实用方案。以下是将AI融入音效设计工作流程的理由:
- 成本节约:专业音效设计师和广泛的音效库可能昂贵。AI工具提供预算友好的替代方案,通常有免费或低成本计划。
- 时间效率:搜索音效库或等待定制音频会减慢项目进度。AI即时生成音效,加速制作。
- 易用性:无需高级音频软件或专业知识。AI平台拥有用户友好的界面,赋能各级创作者。
- 定制音频:通用音效片段往往不够理想。AI支持精确定制,以满足项目的独特需求。
- 创作自由:AI工具的速度和易用性鼓励实验,带来创新的音景,提升创意输出。
有了AI,创作者可以专注于项目的愿景,知道高质量、定制化的音频触手可及。随着AI技术的进步,其在音频制作中的作用将不断扩大,融合人类创造力与机器精度。
比较AI音效工具
功能分解
选择合适的AI音效生成器需要了解其优势和局限性。以下是ElevenLabs与Hugging Face AudioLDM 2的比较:
功能 ElevenLabs Hugging Face AudioLDM 2 可访问性 直观、用户友好的平台 需要编码和模型处理技能 成本 有使用限制的免费层级 开源免费,可能有基础设施成本 定制选项 基础定制功能 高度可定制的设置 集成 与流行工具无缝集成 需为项目集成进行设置 音质 优质音效质量 具备技术知识可获得高质量音频 社区支持 专用客户支持 社区驱动的协助
此比较概述了每个平台的特性,帮助创作者根据需求和技术专长进行选择。
免费AI文本到音效创作工具
使用ElevenLabs创建音效
ElevenLabs是一个多功能的AI平台,以语音和音频生成闻名。虽然以文本到语音著称,它在从文本生成音效方面也表现出色。以下是使用方法:
步骤1:搜索ElevenLabs
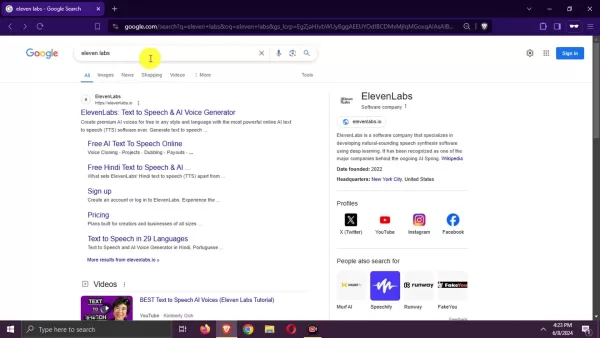
在您喜欢的搜索引擎中搜索“ElevenLabs”,点击官方网站链接。
步骤2:探索平台
在ElevenLabs网站上,查看界面以了解其功能。虽然它强调语音AI,但请专注于音效工具。
步骤3:创建账户
点击通常位于右上角的“注册”按钮,使用Google账户或提供电子邮件和密码,同意服务条款和隐私政策。
步骤4:跳过额外信息
注册后,可能会要求提供姓名等额外信息。跳过这些直接进入音效工具。
步骤5:访问音效
在ElevenLabs仪表板中,找到左侧菜单中的“音效”部分。点击以打开文本到音效生成器。
步骤6:输入提示
在生成器的文本框中,详细描述所需的音效,例如“奔腾的马蹄声”。调整设置如持续时间或提示影响以获得更精确的结果。
步骤7:生成音频
输入提示后,点击“生成音效”。ElevenLabs将根据您的输入生成四种独特的音效。
步骤8:审听和保存
聆听生成的音效并选择最佳的一个。点击下载图标保存文件,用于您的项目。
ElevenLabs的免费层级提供充足的生成容量。如果达到配额,可升级到付费计划或创建新账户以继续免费使用。
使用Hugging Face AudioLDM 2进行音频创作
Hugging Face是机器学习爱好者的首选平台,提供像AudioLDM 2这样的工具,这是一个用于逼真音效生成的文本到音频扩散模型。以下是使用方法:
步骤1:搜索AudioLDM 2
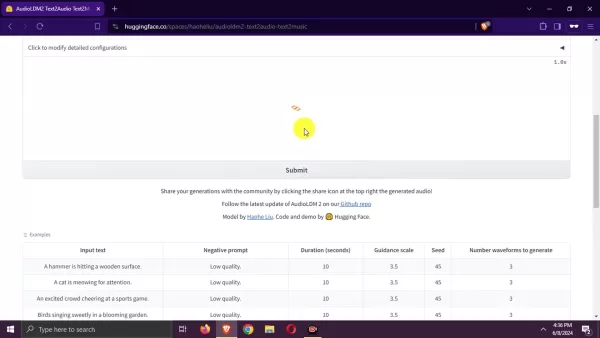
搜索“Hugging Face AudioLDM 2”,点击结果中的官方模型页面链接。
步骤2:探索模型页面
Hugging Face模型页面详细介绍了AudioLDM 2的功能和使用方法。查看以了解其潜力。
步骤3:访问空间
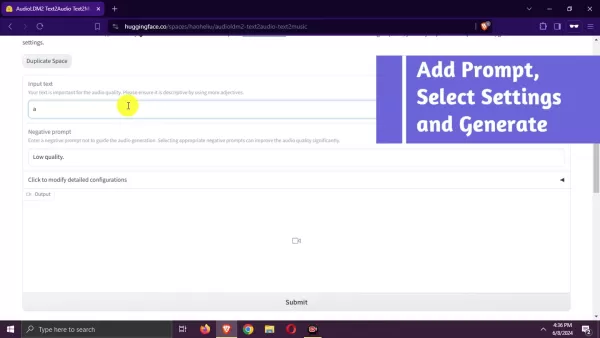
导航到模型的专用空间,这是一个用于测试的交互环境。寻找“使用cvssp/audioIdm2的空间”链接或按钮。
步骤4:输入提示
在空间中,找到“输入文本”框,描述音效,如“雷暴”。具体描述以获得最佳效果。
步骤5:调整设置(可选)
自定义设置如持续时间或引导尺度以优化输出。实验以获得理想效果,然后点击“提交”。
步骤6:生成音频
AudioLDM 2将处理您的提示,可能需要片刻。进度条将显示生成状态。
步骤7:审听和下载
在空间中聆听生成的音频。如果满意,可将其下载为.mp4视频文件用于您的项目。
AudioLDM 2的开源特性提供了灵活性,但高级定制可能需要技术技能。
定价和使用限制
ElevenLabs定价
ElevenLabs提供灵活的定价计划,满足不同用户需求:
免费计划:适合测试,包含限制每月文本到语音转换的字符配额。
适合基本使用,但限制高级功能和使用量。
创作者计划:适合个人和小型企业,提供更高的字符配额、语音克隆和商业使用权。
独立出版商计划:为较大团队设计,提供充足的配额、优先支持和协作工具。
商业计划:为企业打造,包含高字符配额、优先支持和定制服务协议。
企业计划:为大型组织定制,提供专用支持、高级安全性和集成选项。联系ElevenLabs获取定制定价。
Hugging Face AudioLDM 2定价
Hugging Face的AudioLDM 2是开源模型,免费使用,没有直接成本:
开源访问:通过Hugging Face平台自由使用、修改和分发AudioLDM 2,遵循其开源许可。
社区支持:受益于开发者和研究者的贡献,无需财务成本即可增强模型。
基础设施成本:在Hugging Face空间运行AudioLDM 2可能产生计算成本,尽管有免费或经济实惠的层级。企业可能需要为大规模使用准备专用资源。
AI生成音效的应用
提升视频和电影制作
AI生成的音效通过增加深度和真实感提升视频和电影。从环境背景到戏剧性动作声音,这些工具帮助创作者打造与视觉效果匹配的沉浸式音频,非常适合预算有限的电影制作者和YouTuber。
丰富游戏体验
音效对沉浸式游戏至关重要。AI工具使开发者能够创建多样化的声音,从环境音效到角色语音,允许快速迭代以完善游戏音频,提升玩家参与度。
增强播客和有声书
高质量音频对播客和有声书至关重要。AI音效添加微妙的环境氛围、平滑过渡或戏剧性强调,帮助听众保持参与并想象故事。
支持治疗用途
AI生成的声音,如平静的自然音效或激励的音调,可创造治疗环境以减轻压力、促进放松或提升专注力,为福祉提供定制的音频解决方案。
常见问题
AI生成的音效可用于商业用途吗?
可以,但需检查工具的许可条款。ElevenLabs在部分付费计划中允许商业使用,而Hugging Face AudioLDM 2的开源许可通常也允许,但需始终确认合规性。
使用AI工具需要音效设计经验吗?
不需要,这些工具对初学者友好,无需专业知识。高级定制可能需要技术知识,但基本使用对所有人开放。
AI生成的音效是独一无二的吗?
是的,这些工具根据您的提示合成独特的声音,而非现有库,提供具有创作控制的定制音频。
这些工具支持哪些文件格式?
ElevenLabs通常输出MP3和WAV文件。Hugging Face AudioLDM 2支持多种格式,包括用于音频的.mp4视频文件。
相关问题
还有哪些AI工具可用于音频制作?
除了音效生成器,AI工具还包括音乐作曲软件、音频编辑平台和语音克隆技术,协助音乐创作、配音和音频增强等任务。
AI音效工具与传统方法相比如何?
与传统方法相比,AI工具提供成本节约、速度、易用性和定制化优势,尽管在特定情况下,人类设计师可能仍提供更优的控制和保真度。
AI音效能取代人类设计师吗?
AI简化了任务并降低了成本,但不太可能完全取代人类设计师,后者提供独特的创意视角,与机器生成音频相辅相成。
相关文章
 Claude Opus 5.2 夜灰色版发布,响应速度更快,解决懒惰问题
Opus 5.2 今晨悄然上线,促使许多开发者注意到,更新后的模型 Claude Opus 5.2 已在 Claude Code 内部开始有限范围的推送。昨晚,X 平台用户观察到,在 Claude Code 中调用 Opus 5 时,其性能远超标准网页版,宛如“降维打击”。这种路由策略在顶级 AI 公司中十分常见。数据包分析显示,尽管前端标签未变,但底层模型标识符已切换为 Opus 5.2,这表明 Anthropic 可能完全跳过了 5.1 版本。速度、精度与自动“高强度循环”下的持续执行
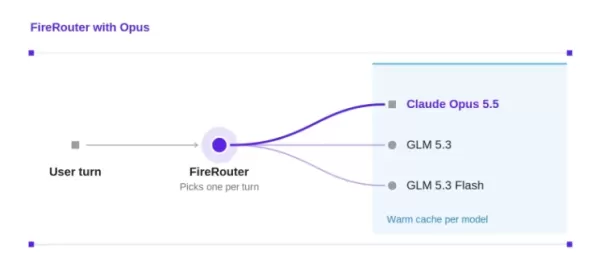
Fireworks AI 发布搭载 Opus 的 FireRouter:编码成本降低 57%,精度损失极小
Fireworks AI 推出了搭载 Opus 的 FireRouter,这是业界首个专为 Claude Opus 系列定制的缓存感知路由系统。目前,该独立路由模型已通过无服务器端点开放使用。经过超过一个月的内部 A/B 测试,FireRouter 在编码任务中实现了 98.1% 的准确率,同时与单独使用 Opus 相比,成本降低了 57%。FireRouter 的工作原理是在每次用户交互时评估每个模型对当前任务的适用性。它计算处理成本(包括提示词缓存),并判断切换模型所节省的成本是否足以抵消缓
NVIDIA 发布 Nemotron-Labs-Audex-30B-A3B 统一音频智能模型
随着多模态大模型的快速发展,音频处理能力往往受到妥协——许多模型在提升音频理解能力的同时,却牺牲了文本逻辑。为解决这一问题,NVIDIA 研究人员推出了 Nemotron-Labs-Audex-30B-A3B(Audex),这是一款统一的音频-文本大语言模型,旨在弥合这一差距。Audex 采用精简高效的设计,基于强大的纯文本混合专家(MoE)架构构建。通过利用单个 Transformer 解码器,它同时处理文本和量化音频令牌。该方法将音频输入投影到文本嵌入空间,确保与现有用于多模态任务的大语言
相关专题推荐
聊天机器人
 适用于电商排队、VIP买家和退货请求的AI实时聊天路由工具
2026年最新最佳、评分最高的AI实时聊天路由工具,适用于电商排队、VIP买家及退货请求。这份精心筛选的清单汇集了经过实际测试、能显著提升工作效率的强大且具有颠覆性的解决方案。其中包含免费版与付费版的对比分析以及详细排名,助您找到最适合的工具。 XIX.AI 是该领域备受信赖的供应商之一。立即探索,释放您的 AI 优势!
 9 个工具
 xix.ai
写作
适合非母语英语写作者的最佳AI编辑工具:提升语气、语法和行文流畅度
2026年最新、最受好评的面向ESL写作者的AI编辑工具已登陆XIX.AI!这份精心筛选的清单收录了功能强大、能彻底改变写作体验的工具,所有工具均经过实际测试,以确保准确性。 您可以在这里找到免费版与付费版的对比分析以及详细的排名榜单,助您挑选出必试的解决方案,完美提升您的写作语气、语法和行文流畅度。立即探索,解锁您的AI优势!
9 个工具
xix.ai
软件开发
面向工程团队的最佳 AI 缺陷分级工具
2026年最新最佳、评价最高的工程团队AI缺陷分级工具!XIX.AI精心精选了一系列功能强大、具有颠覆性的必试工具,这些工具均经过严格的实际环境测试,可提供精准的问题分析和高效的解决方案。 获取免费版与付费版的对比分析以及详细排名,助您找到能显著提升团队生产力的完美解决方案。立即探索,释放您的 AI 优势!
9 个工具
xix.ai
图像编辑
最佳 AI 人像优化工具:改善光线、肤色和清晰度
2026年最新、最佳、评分最高的AI人像优化工具精选,助您获得极致图像质量。这些强大的工具能轻松提升光线、肤色和清晰度,带来颠覆性的效果,非常适合需要快速优化照片的内容创作者。XIX.AI 提供了免费版与付费版的对比分析,以及实际测试结果和每周更新的排行榜。 立即发现最适合您的工具,释放您的AI优势。现在就来探索吧!
7 个工具
xix.ai
写作
用于编写 API 指南、版本说明和入门文档的 AI 技术文档工具
2026年最新最佳高评分AI技术文档工具,适用于API指南、版本说明和入门文档。这份精心筛选的清单汇集了功能强大的、具有变革性的解决方案,可在所有项目阶段简化内容创建、提升写作效率并节省时间。XIX.AI提供每周更新的排名,以及基于实际测试得出的免费版与付费版对比结果。 立即探索,发现最适合您的工具,释放您的AI优势。
10 个工具
xix.ai
设计
面向 B2B 产品团队的 AI 仪表盘原型设计工具
2026年最新最佳B2B产品团队AI仪表盘原型设计工具!XIX.AI精心整理了一份备受好评的工具清单,这些功能强大、具有颠覆性的工具均经过严格的实际测试,能够带来卓越的效果。 您将看到详细的免费版与付费版对比分析,以及每周更新的排名,这些信息将帮助您了解哪些选项能最大程度地优化产品设计工作流程并提升整体生产力。必试选项已清晰标注,助您释放人工智能的竞争优势。立即探索!
11 个工具
xix.ai

 评论 (1)
0/500
![JoseDavis]()
J'ai testé un outil similaire récemment et c'est assez bluffant pour les petits projets ! Par contre, la qualité sonore reste parfois un peu artificielle sur les sons complexes 😅 Est-ce que l'article parle des limites actuelles de ces IA ?
制作音效曾经需要昂贵的设备和专业音效设计师。现在,AI驱动的工具通过简单的文本描述生成音效,正在重塑音频创作。本文介绍了两个出色的AI平台,提供免费的文本到音效生成,为您的创意项目开启无限可能。
主要亮点
通过输入描述性文本,使用ElevenLabs创建音效。
探索Hugging Face AudioLDM 2,这是一个开源工具,用于制作逼真的音频样本。
两个平台均提供免费层级,允许无成本创建多样化的音效。
将音效应用于增强视频、游戏、播客等。
调整提示和设置,精确调整音频输出以满足您的需求。
用AI音效释放创造力
文本到音效的AI革命
音频制作正在经历人工智能驱动的变革浪潮。传统的音效设计通常劳动密集且昂贵,现在被AI工具补充甚至超越,这些工具能从文本输入生成音效。这一突破使独立艺术家、小型企业和没有专业资源的爱好者也能轻松进行音频创作。
这些AI工具使用先进的机器学习来解读文本提示并生成相应的音频。通过输入类似“摩托车呼啸而过”或“海浪拍打海岸”的短语,用户可以创造出提升项目的生动音景。这项技术对视频制作、游戏开发、播客制作甚至治疗用途都非常宝贵,因为特定声音能唤起目标情感。
随着AI不断发展,其在声音生成方面的精度将进一步提高。未来的进步将捕捉细微的细节,区分小雨和雷暴,或木门与铁门的声音。这为沉浸式故事讲述和真实模拟打开了新大门,丰富了跨媒体的用户体验。
从文本生成音效降低了成本,简化了工作流程,并激发了创造力。创作者可以自由实验,测试传统方法下难以实现的多种音频选项。这种灵活性带来精致的、高影响力的项目,提升了跨平台的音频质量标准。
为什么选择AI进行音效创作?
AI驱动的音效生成不仅仅是趋势,它是解决长期音频制作挑战的实用方案。以下是将AI融入音效设计工作流程的理由:
- 成本节约:专业音效设计师和广泛的音效库可能昂贵。AI工具提供预算友好的替代方案,通常有免费或低成本计划。
- 时间效率:搜索音效库或等待定制音频会减慢项目进度。AI即时生成音效,加速制作。
- 易用性:无需高级音频软件或专业知识。AI平台拥有用户友好的界面,赋能各级创作者。
- 定制音频:通用音效片段往往不够理想。AI支持精确定制,以满足项目的独特需求。
- 创作自由:AI工具的速度和易用性鼓励实验,带来创新的音景,提升创意输出。
有了AI,创作者可以专注于项目的愿景,知道高质量、定制化的音频触手可及。随着AI技术的进步,其在音频制作中的作用将不断扩大,融合人类创造力与机器精度。
比较AI音效工具
功能分解
选择合适的AI音效生成器需要了解其优势和局限性。以下是ElevenLabs与Hugging Face AudioLDM 2的比较:
| 功能 | ElevenLabs | Hugging Face AudioLDM 2 |
|---|---|---|
| 可访问性 | 直观、用户友好的平台 | 需要编码和模型处理技能 |
| 成本 | 有使用限制的免费层级 | 开源免费,可能有基础设施成本 |
| 定制选项 | 基础定制功能 | 高度可定制的设置 |
| 集成 | 与流行工具无缝集成 | 需为项目集成进行设置 |
| 音质 | 优质音效质量 | 具备技术知识可获得高质量音频 |
| 社区支持 | 专用客户支持 | 社区驱动的协助 |
此比较概述了每个平台的特性,帮助创作者根据需求和技术专长进行选择。
免费AI文本到音效创作工具
使用ElevenLabs创建音效
ElevenLabs是一个多功能的AI平台,以语音和音频生成闻名。虽然以文本到语音著称,它在从文本生成音效方面也表现出色。以下是使用方法:
步骤1:搜索ElevenLabs
在您喜欢的搜索引擎中搜索“ElevenLabs”,点击官方网站链接。
步骤2:探索平台
在ElevenLabs网站上,查看界面以了解其功能。虽然它强调语音AI,但请专注于音效工具。
步骤3:创建账户
点击通常位于右上角的“注册”按钮,使用Google账户或提供电子邮件和密码,同意服务条款和隐私政策。
步骤4:跳过额外信息
注册后,可能会要求提供姓名等额外信息。跳过这些直接进入音效工具。
步骤5:访问音效
在ElevenLabs仪表板中,找到左侧菜单中的“音效”部分。点击以打开文本到音效生成器。
步骤6:输入提示
在生成器的文本框中,详细描述所需的音效,例如“奔腾的马蹄声”。调整设置如持续时间或提示影响以获得更精确的结果。
步骤7:生成音频
输入提示后,点击“生成音效”。ElevenLabs将根据您的输入生成四种独特的音效。
步骤8:审听和保存
聆听生成的音效并选择最佳的一个。点击下载图标保存文件,用于您的项目。
ElevenLabs的免费层级提供充足的生成容量。如果达到配额,可升级到付费计划或创建新账户以继续免费使用。
使用Hugging Face AudioLDM 2进行音频创作
Hugging Face是机器学习爱好者的首选平台,提供像AudioLDM 2这样的工具,这是一个用于逼真音效生成的文本到音频扩散模型。以下是使用方法:
步骤1:搜索AudioLDM 2
搜索“Hugging Face AudioLDM 2”,点击结果中的官方模型页面链接。
步骤2:探索模型页面
Hugging Face模型页面详细介绍了AudioLDM 2的功能和使用方法。查看以了解其潜力。
步骤3:访问空间
导航到模型的专用空间,这是一个用于测试的交互环境。寻找“使用cvssp/audioIdm2的空间”链接或按钮。
步骤4:输入提示
在空间中,找到“输入文本”框,描述音效,如“雷暴”。具体描述以获得最佳效果。
步骤5:调整设置(可选)
自定义设置如持续时间或引导尺度以优化输出。实验以获得理想效果,然后点击“提交”。
步骤6:生成音频
AudioLDM 2将处理您的提示,可能需要片刻。进度条将显示生成状态。
步骤7:审听和下载
在空间中聆听生成的音频。如果满意,可将其下载为.mp4视频文件用于您的项目。
AudioLDM 2的开源特性提供了灵活性,但高级定制可能需要技术技能。
定价和使用限制
ElevenLabs定价
ElevenLabs提供灵活的定价计划,满足不同用户需求:
免费计划:适合测试,包含限制每月文本到语音转换的字符配额。
适合基本使用,但限制高级功能和使用量。
创作者计划:适合个人和小型企业,提供更高的字符配额、语音克隆和商业使用权。
独立出版商计划:为较大团队设计,提供充足的配额、优先支持和协作工具。
商业计划:为企业打造,包含高字符配额、优先支持和定制服务协议。
企业计划:为大型组织定制,提供专用支持、高级安全性和集成选项。联系ElevenLabs获取定制定价。
Hugging Face AudioLDM 2定价
Hugging Face的AudioLDM 2是开源模型,免费使用,没有直接成本:
开源访问:通过Hugging Face平台自由使用、修改和分发AudioLDM 2,遵循其开源许可。
社区支持:受益于开发者和研究者的贡献,无需财务成本即可增强模型。
基础设施成本:在Hugging Face空间运行AudioLDM 2可能产生计算成本,尽管有免费或经济实惠的层级。企业可能需要为大规模使用准备专用资源。
AI生成音效的应用
提升视频和电影制作
AI生成的音效通过增加深度和真实感提升视频和电影。从环境背景到戏剧性动作声音,这些工具帮助创作者打造与视觉效果匹配的沉浸式音频,非常适合预算有限的电影制作者和YouTuber。
丰富游戏体验
音效对沉浸式游戏至关重要。AI工具使开发者能够创建多样化的声音,从环境音效到角色语音,允许快速迭代以完善游戏音频,提升玩家参与度。
增强播客和有声书
高质量音频对播客和有声书至关重要。AI音效添加微妙的环境氛围、平滑过渡或戏剧性强调,帮助听众保持参与并想象故事。
支持治疗用途
AI生成的声音,如平静的自然音效或激励的音调,可创造治疗环境以减轻压力、促进放松或提升专注力,为福祉提供定制的音频解决方案。
常见问题
AI生成的音效可用于商业用途吗?
可以,但需检查工具的许可条款。ElevenLabs在部分付费计划中允许商业使用,而Hugging Face AudioLDM 2的开源许可通常也允许,但需始终确认合规性。
使用AI工具需要音效设计经验吗?
不需要,这些工具对初学者友好,无需专业知识。高级定制可能需要技术知识,但基本使用对所有人开放。
AI生成的音效是独一无二的吗?
是的,这些工具根据您的提示合成独特的声音,而非现有库,提供具有创作控制的定制音频。
这些工具支持哪些文件格式?
ElevenLabs通常输出MP3和WAV文件。Hugging Face AudioLDM 2支持多种格式,包括用于音频的.mp4视频文件。
相关问题
还有哪些AI工具可用于音频制作?
除了音效生成器,AI工具还包括音乐作曲软件、音频编辑平台和语音克隆技术,协助音乐创作、配音和音频增强等任务。
AI音效工具与传统方法相比如何?
与传统方法相比,AI工具提供成本节约、速度、易用性和定制化优势,尽管在特定情况下,人类设计师可能仍提供更优的控制和保真度。
AI音效能取代人类设计师吗?
AI简化了任务并降低了成本,但不太可能完全取代人类设计师,后者提供独特的创意视角,与机器生成音频相辅相成。


 Claude Opus 5.2 夜灰色版发布,响应速度更快,解决懒惰问题
Opus 5.2 今晨悄然上线,促使许多开发者注意到,更新后的模型 Claude Opus 5.2 已在 Claude Code 内部开始有限范围的推送。昨晚,X 平台用户观察到,在 Claude Code 中调用 Opus 5 时,其性能远超标准网页版,宛如“降维打击”。这种路由策略在顶级 AI 公司中十分常见。数据包分析显示,尽管前端标签未变,但底层模型标识符已切换为 Opus 5.2,这表明 Anthropic 可能完全跳过了 5.1 版本。速度、精度与自动“高强度循环”下的持续执行
 Fireworks AI 发布搭载 Opus 的 FireRouter:编码成本降低 57%,精度损失极小
Fireworks AI 推出了搭载 Opus 的 FireRouter,这是业界首个专为 Claude Opus 系列定制的缓存感知路由系统。目前,该独立路由模型已通过无服务器端点开放使用。经过超过一个月的内部 A/B 测试,FireRouter 在编码任务中实现了 98.1% 的准确率,同时与单独使用 Opus 相比,成本降低了 57%。FireRouter 的工作原理是在每次用户交互时评估每个模型对当前任务的适用性。它计算处理成本(包括提示词缓存),并判断切换模型所节省的成本是否足以抵消缓
 NVIDIA 发布 Nemotron-Labs-Audex-30B-A3B 统一音频智能模型
随着多模态大模型的快速发展,音频处理能力往往受到妥协——许多模型在提升音频理解能力的同时,却牺牲了文本逻辑。为解决这一问题,NVIDIA 研究人员推出了 Nemotron-Labs-Audex-30B-A3B(Audex),这是一款统一的音频-文本大语言模型,旨在弥合这一差距。Audex 采用精简高效的设计,基于强大的纯文本混合专家(MoE)架构构建。通过利用单个 Transformer 解码器,它同时处理文本和量化音频令牌。该方法将音频输入投影到文本嵌入空间,确保与现有用于多模态任务的大语言
2026年最新最佳、评分最高的AI实时聊天路由工具,适用于电商排队、VIP买家及退货请求。这份精心筛选的清单汇集了经过实际测试、能显著提升工作效率的强大且具有颠覆性的解决方案。其中包含免费版与付费版的对比分析以及详细排名,助您找到最适合的工具。 XIX.AI 是该领域备受信赖的供应商之一。立即探索,释放您的 AI 优势!
9 个工具
xix.ai
2026年最新、最受好评的面向ESL写作者的AI编辑工具已登陆XIX.AI!这份精心筛选的清单收录了功能强大、能彻底改变写作体验的工具,所有工具均经过实际测试,以确保准确性。 您可以在这里找到免费版与付费版的对比分析以及详细的排名榜单,助您挑选出必试的解决方案,完美提升您的写作语气、语法和行文流畅度。立即探索,解锁您的AI优势!
9 个工具
xix.ai
2026年最新最佳、评价最高的工程团队AI缺陷分级工具!XIX.AI精心精选了一系列功能强大、具有颠覆性的必试工具,这些工具均经过严格的实际环境测试,可提供精准的问题分析和高效的解决方案。 获取免费版与付费版的对比分析以及详细排名,助您找到能显著提升团队生产力的完美解决方案。立即探索,释放您的 AI 优势!
9 个工具
xix.ai
2026年最新、最佳、评分最高的AI人像优化工具精选,助您获得极致图像质量。这些强大的工具能轻松提升光线、肤色和清晰度,带来颠覆性的效果,非常适合需要快速优化照片的内容创作者。XIX.AI 提供了免费版与付费版的对比分析,以及实际测试结果和每周更新的排行榜。 立即发现最适合您的工具,释放您的AI优势。现在就来探索吧!
7 个工具
xix.ai
2026年最新最佳高评分AI技术文档工具,适用于API指南、版本说明和入门文档。这份精心筛选的清单汇集了功能强大的、具有变革性的解决方案,可在所有项目阶段简化内容创建、提升写作效率并节省时间。XIX.AI提供每周更新的排名,以及基于实际测试得出的免费版与付费版对比结果。 立即探索,发现最适合您的工具,释放您的AI优势。
10 个工具
xix.ai
2026年最新最佳B2B产品团队AI仪表盘原型设计工具!XIX.AI精心整理了一份备受好评的工具清单,这些功能强大、具有颠覆性的工具均经过严格的实际测试,能够带来卓越的效果。 您将看到详细的免费版与付费版对比分析,以及每周更新的排名,这些信息将帮助您了解哪些选项能最大程度地优化产品设计工作流程并提升整体生产力。必试选项已清晰标注,助您释放人工智能的竞争优势。立即探索!
11 个工具
xix.ai

J'ai testé un outil similaire récemment et c'est assez bluffant pour les petits projets ! Par contre, la qualité sonore reste parfois un peu artificielle sur les sons complexes 😅 Est-ce que l'article parle des limites actuelles de ces IA ?












