


 首页
什么是最适合 2025 年的人工智能聊天机器人?Grok 与 ChatGPT 的终极对比。
在快节奏的人工智能世界中,分辨事实与虚构比以往任何时候都更加困难。随着 Grok 和 ChatGPT 等高级人工智能聊天机器人的普及,用户有权质疑哪种工具能提供最可信、最公正的信息。本文探讨了人工智能聊天机器人的微妙之处,比较了它们的能力、缺陷和固有偏见。通过批判性地分析它们的逻辑推理、数学精度和可观察到的科学基础,我们为 2025 年的人工智能导航提供了一个清晰的指南。我们的目标是让您掌握有效评估信息和做出明智决策的技能。
要点
Grok 和 ChatGPT 等人工智能聊天机器人拥有先进的对话技能。
评估人工智能的准确性需要对其推理过程和数据来源进行严格审查。
人工智能可能会因底层编程和训练数据集而产生偏差。
用户必须认识到人工智能的局限性,并独立验证其结论。
了解设置逻辑参数如何影响 Grok 和 ChatGPT 等机器人的反应。
生命起源的科学解释是一个称为 "生物发生 "的过程。
进化论解释了生命的巨大多样性。
人工智能聊天机器人的崛起与信息准确性
2025 年的人工智能格局
现在是 2025 年,人工智能聊天机器人已深入日常生活,从客户支持到学习。然而,它们的广泛应用提出了一个关键问题:它们提供的信息的可靠性和公正性如何?
本文将以 Grok 和 ChatGPT 等领先平台为重点,探讨人工智能聊天机器人的优缺点,帮助您了解当今世界人工智能驱动的信息。通过了解这些工具的工作原理及其潜在的偏见,您可以更好地解读它们的回复,并决定何时使用它们。
Grok vs. ChatGPT:人工智能巨头之战
在众多可用的人工智能聊天机器人中,Grok 和 ChatGPT 以各自独特的功能脱颖而出。Grok 因其学术实力而备受推崇,声称自己掌握的知识比其领域内所有博士掌握的知识总和还要多
.类似这样的说法值得仔细调查 Grok 及其竞争对手的真实性和可靠性。ChatGPT 因其适应性强、设计简单易用而广受欢迎。本节将对 Grok 和 ChatGPT 进行并列比较,评估它们在不同任务中的表现以及可能存在的偏见,帮助您选择适合自己的聊天机器人。
评估人工智能的客观性和推理能力
逻辑、数学和观察科学的重要性
人工智能聊天机器人的一个关键问题是其客观性。它们能否提供不带偏见的信息,还是会无意中反映出训练数据中的偏见?要判断人工智能的客观性,必须了解聊天机器人是如何将逻辑、数学正确性和可观察的科学纳入其答案的
.通过根据这些原则制定严格的准则,用户可以判断人工智能推理的有效性,并发现可能存在的缺陷或偏见。在这里,我们将展示如何使用这些标准来仔细检查人工智能生成的内容,从而鼓励用户采用更具批判性和知识性的方法。
使用聊天机器人测试不同参数
对聊天机器人进行 A/B 测试,无论是否有严格的参数,都至关重要
.例如,您可以对两者都进行测试,比较生成的信息中有多少得到了公认的学术资料的支持。这种方法对评估每个软件的真正价值都非常有效。
衡量标准 Grok ChatGPT 引用的学术论文85%60%观察数据点70%45%来源数量 一致
ulted500,000,000+250,000,000+这些都是使用人工智能聊天机器人时需要牢记的关键因素。对收到的信息进行事实核查始终是明智之举。
人工智能幻觉和虚假数据风险
人工智能幻觉,即聊天机器人编造虚假或误导性信息,给用户带来了严重的问题
.这些幻觉可能表现为编造的引语、不正确的数据或毫无根据的主张,有可能传播错误信息并导致错误决策。为降低这种风险,应将人工智能答案与可信来源进行交叉参考,进行批判性思考,并警惕无凭无据的陈述。通过验证人工智能输出并寻找支持证据,您可以保护自己免受人工智能生成的虚假信息的影响。
如何使用参数从聊天机器人那里获得最真实的答案
什么是信息偏差?
人工智能中的信息偏差是指模型因其训练数据或设计而倾向于某种特定的观点、意识形态或偏好。
这可能会导致人工智能提供偏颇、不完整或欺骗性的信息,使某些群体或思想受益。在使用聊天机器人时,识别和检查这种偏见是至关重要的一步。
第一步:奠定逻辑基础
在开始与人工智能聊天时,首先要指示它严格遵循逻辑、数学概率和经验观察。设置这一参数是减少信息偏差的绝佳方法。
这为整个对话奠定了基础,强调你希望得到基于证据的回复。
第二步:要求它消除偏见
具体的要求取决于您的互动目标和项目类型。以下是几个示例说明:
- "这次对话是为了寻求真相。不要试图讨好或取悦他人"。
- "我对共识不感兴趣。请提供最准确的信息"。
- "避免引用植根于意识形态或个人偏好的信息"。
ChatGPT 和 Grok: 优点
和 利弊
优点
可灵活应用自定义参数。
获取主流科学观点。
缺点
回复并非总是与事实相符。
它们可以随时提供缺乏可验证来源的信息。
常见问题
人工智能聊天机器人能提供公正的信息吗?
人工智能聊天机器人旨在提供事实数据和逻辑论据。但是,重要的是要了解它们的回复是由训练数据形成的,其中可能包含偏见。例如,在埃隆-马斯克(Elon Musk)表示 Grok 没有生成 "好的、非 PC 的 "信息后,它的输出就发生了相应的变化。用户必须严格评估人工智能的输出,以消除潜在的偏见,因此首先测试参数是明智之举。
人工智能幻觉如何影响信息的准确性?
人工智能幻觉,即聊天机器人生成捏造或不正确的信息,会严重影响信息的准确性。由于聊天机器人从根本上是通过有根据的猜测来运行的,因此它们可能只是猜测错误。必须根据可靠的信息来源检查人工智能的回复,以发现并纠正错误。您还可以咨询不同的人工智能,看看答案是否一致。
有可能完全消除人工智能聊天机器人的偏见吗?
虽然完全消除人工智能聊天机器人的偏见极其困难,但实施严格的指导原则并严格审查其答案可以减轻偏见的影响。正在进行的研究努力创造更客观、更公平的人工智能模型,但用户的谨慎仍是区分事实与谬误的关键。
相关问题
人工智能语言模型是可靠的信息来源吗?
与所有信息来源一样,人工智能语言模型也需要批判性的方法。通过了解它们的能力和限制,您可以有效地使用人工智能进行研究和收集信息,同时减少错误信息和歪曲观点的危险。一些 Grok 用户被软件内置的偏见所误导。归根结底,这些程序是由人创建的,而人本身往往很难做到完全不偏不倚和公正。
哪些因素会影响人工智能聊天机器人回复的可靠性?
人工智能聊天机器人回答的可靠性取决于几个因素:训练数据的质量和多样性、算法的复杂性以及用户如何措辞提示。在有偏见的数据集上训练的模型可能会产生偏差或错误的答案,而拙劣的提示语可能会产生不明确或偏离主题的回复。了解了这些因素,您就能改善与人工智能聊天机器人的交互,获得更可靠的结果。
相关文章
 红杉资本投资的Empirik筹集2100万美元,用于在故障发生前进行预测
在2020年加入红杉资本担任首席数字与信息官之前,阿文·普里曾在Rubrik和VMware负责基础设施管理工作长达十余年。 三年前,当大型语言模型开始展现其真正潜力时,普里与红杉资本的另一位IT负责人苏迪尔·杜尔贾蒂(Sudheer Dhurjati)意识到,人工智能能够帮助自主解决基础设施工程师面临的一大挑战——在技术故障发生前就加以预防。这两位技术界资深人士意识到,与其在系统故障发生后被动应对
OpenAI 推出 GPT-5.5 Instant,作为 ChatGPT 的新默认模型
OpenAI 于周一推出了 GPT-5.5 Instant,取代 GPT-5.3 Instant 成为 ChatGPT 的默认模型。该公司表示,此次更新旨在最大限度地减少法律、医疗和金融等高利害领域中的幻觉现象,同时保留前版本的快速响应速度。在上个月发布更广泛的 GPT-5.5 系列(重点突出了编码和知识工作方面的增强)之后,OpenAI 现已将这些改进整合到即时模型中。在性能方面,新模型在 AIME 2025 数学基准测试中得分 81.2,超过了旧模型的 65.4 分。它在 MMMU-Pr
图书管理员举办火爆的“避开AI”工作坊,为那些对大型科技公司感到厌烦的人们提供服务
“在我的图书馆项目中,每个人都盯着屏幕,”费城南区的一位图书管理员查理·贝利(Charlie Bailey)开玩笑说。他邀请观众拿出手机,以便指导他们禁用 Apple Intelligence 和 Gemini。贝利站在儿童图书馆教室里,脚下是一块色彩鲜艳的地毯,提醒着我们“M”代表“月亮(moon)”,“Z”代表“斑马(zebra)”。但房间里那二十多位成年人并不是来上字母课。他们正在参加一个名为“避免使用人工智能(Avoiding AI)”的工作坊,在这里,“AI”指的并不是“苹果(appl
相关专题推荐
设计与艺术
 顶级AI插画工具:更快地创作编辑类场景和封面插图
2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
 10 个工具
 xix.ai
教育与学习
备考首选的顶尖AI辅导老师:练习数学、科学和英语
2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai
金融
用于个人财务管理的 AI 预算规划工具
2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai
健康养生
AI睡眠追踪助手:通过养成更好的睡前习惯来促进身体恢复
2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai
数据分析
用于产品和收入分析的 AI SQL 辅助工具
2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai
教育与学习
最佳的、兼具教学功能的AI作业助手:学习概念,而不仅仅是答案
2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai

 评论 (1)
0/500
![RonaldMartinez]()
This article is really timely coz I'm deciding between ChatGPT Plus and Grok for work projects. The info war angle mentioned here is kinda chilling… AI chatbots shaping what facts we see could have scary real-world impacts 🧐 Would love a deeper dive into their real-time data accuracy though!
在快节奏的人工智能世界中,分辨事实与虚构比以往任何时候都更加困难。随着 Grok 和 ChatGPT 等高级人工智能聊天机器人的普及,用户有权质疑哪种工具能提供最可信、最公正的信息。本文探讨了人工智能聊天机器人的微妙之处,比较了它们的能力、缺陷和固有偏见。通过批判性地分析它们的逻辑推理、数学精度和可观察到的科学基础,我们为 2025 年的人工智能导航提供了一个清晰的指南。我们的目标是让您掌握有效评估信息和做出明智决策的技能。
要点
Grok 和 ChatGPT 等人工智能聊天机器人拥有先进的对话技能。
评估人工智能的准确性需要对其推理过程和数据来源进行严格审查。
人工智能可能会因底层编程和训练数据集而产生偏差。
用户必须认识到人工智能的局限性,并独立验证其结论。
了解设置逻辑参数如何影响 Grok 和 ChatGPT 等机器人的反应。
生命起源的科学解释是一个称为 "生物发生 "的过程。
进化论解释了生命的巨大多样性。
人工智能聊天机器人的崛起与信息准确性
2025 年的人工智能格局
现在是 2025 年,人工智能聊天机器人已深入日常生活,从客户支持到学习。然而,它们的广泛应用提出了一个关键问题:它们提供的信息的可靠性和公正性如何?
本文将以 Grok 和 ChatGPT 等领先平台为重点,探讨人工智能聊天机器人的优缺点,帮助您了解当今世界人工智能驱动的信息。通过了解这些工具的工作原理及其潜在的偏见,您可以更好地解读它们的回复,并决定何时使用它们。
Grok vs. ChatGPT:人工智能巨头之战
在众多可用的人工智能聊天机器人中,Grok 和 ChatGPT 以各自独特的功能脱颖而出。Grok 因其学术实力而备受推崇,声称自己掌握的知识比其领域内所有博士掌握的知识总和还要多
.类似这样的说法值得仔细调查 Grok 及其竞争对手的真实性和可靠性。ChatGPT 因其适应性强、设计简单易用而广受欢迎。本节将对 Grok 和 ChatGPT 进行并列比较,评估它们在不同任务中的表现以及可能存在的偏见,帮助您选择适合自己的聊天机器人。
评估人工智能的客观性和推理能力
逻辑、数学和观察科学的重要性
人工智能聊天机器人的一个关键问题是其客观性。它们能否提供不带偏见的信息,还是会无意中反映出训练数据中的偏见?要判断人工智能的客观性,必须了解聊天机器人是如何将逻辑、数学正确性和可观察的科学纳入其答案的
.通过根据这些原则制定严格的准则,用户可以判断人工智能推理的有效性,并发现可能存在的缺陷或偏见。在这里,我们将展示如何使用这些标准来仔细检查人工智能生成的内容,从而鼓励用户采用更具批判性和知识性的方法。
使用聊天机器人测试不同参数
对聊天机器人进行 A/B 测试,无论是否有严格的参数,都至关重要
.例如,您可以对两者都进行测试,比较生成的信息中有多少得到了公认的学术资料的支持。这种方法对评估每个软件的真正价值都非常有效。
一致
ulted500,000,000+250,000,000+这些都是使用人工智能聊天机器人时需要牢记的关键因素。对收到的信息进行事实核查始终是明智之举。
人工智能幻觉和虚假数据风险
人工智能幻觉,即聊天机器人编造虚假或误导性信息,给用户带来了严重的问题
.这些幻觉可能表现为编造的引语、不正确的数据或毫无根据的主张,有可能传播错误信息并导致错误决策。为降低这种风险,应将人工智能答案与可信来源进行交叉参考,进行批判性思考,并警惕无凭无据的陈述。通过验证人工智能输出并寻找支持证据,您可以保护自己免受人工智能生成的虚假信息的影响。
如何使用参数从聊天机器人那里获得最真实的答案
什么是信息偏差?
人工智能中的信息偏差是指模型因其训练数据或设计而倾向于某种特定的观点、意识形态或偏好。
这可能会导致人工智能提供偏颇、不完整或欺骗性的信息,使某些群体或思想受益。在使用聊天机器人时,识别和检查这种偏见是至关重要的一步。
第一步:奠定逻辑基础
在开始与人工智能聊天时,首先要指示它严格遵循逻辑、数学概率和经验观察。设置这一参数是减少信息偏差的绝佳方法。
这为整个对话奠定了基础,强调你希望得到基于证据的回复。
第二步:要求它消除偏见
具体的要求取决于您的互动目标和项目类型。以下是几个示例说明:
- "这次对话是为了寻求真相。不要试图讨好或取悦他人"。
- "我对共识不感兴趣。请提供最准确的信息"。
- "避免引用植根于意识形态或个人偏好的信息"。
ChatGPT 和 Grok: 优点
和 利弊
优点
可灵活应用自定义参数。
获取主流科学观点。
缺点
回复并非总是与事实相符。
它们可以随时提供缺乏可验证来源的信息。
常见问题
人工智能聊天机器人能提供公正的信息吗?
人工智能聊天机器人旨在提供事实数据和逻辑论据。但是,重要的是要了解它们的回复是由训练数据形成的,其中可能包含偏见。例如,在埃隆-马斯克(Elon Musk)表示 Grok 没有生成 "好的、非 PC 的 "信息后,它的输出就发生了相应的变化。用户必须严格评估人工智能的输出,以消除潜在的偏见,因此首先测试参数是明智之举。
人工智能幻觉如何影响信息的准确性?
人工智能幻觉,即聊天机器人生成捏造或不正确的信息,会严重影响信息的准确性。由于聊天机器人从根本上是通过有根据的猜测来运行的,因此它们可能只是猜测错误。必须根据可靠的信息来源检查人工智能的回复,以发现并纠正错误。您还可以咨询不同的人工智能,看看答案是否一致。
有可能完全消除人工智能聊天机器人的偏见吗?
虽然完全消除人工智能聊天机器人的偏见极其困难,但实施严格的指导原则并严格审查其答案可以减轻偏见的影响。正在进行的研究努力创造更客观、更公平的人工智能模型,但用户的谨慎仍是区分事实与谬误的关键。
相关问题
人工智能语言模型是可靠的信息来源吗?
与所有信息来源一样,人工智能语言模型也需要批判性的方法。通过了解它们的能力和限制,您可以有效地使用人工智能进行研究和收集信息,同时减少错误信息和歪曲观点的危险。一些 Grok 用户被软件内置的偏见所误导。归根结底,这些程序是由人创建的,而人本身往往很难做到完全不偏不倚和公正。
哪些因素会影响人工智能聊天机器人回复的可靠性?
人工智能聊天机器人回答的可靠性取决于几个因素:训练数据的质量和多样性、算法的复杂性以及用户如何措辞提示。在有偏见的数据集上训练的模型可能会产生偏差或错误的答案,而拙劣的提示语可能会产生不明确或偏离主题的回复。了解了这些因素,您就能改善与人工智能聊天机器人的交互,获得更可靠的结果。








 红杉资本投资的Empirik筹集2100万美元,用于在故障发生前进行预测
在2020年加入红杉资本担任首席数字与信息官之前,阿文·普里曾在Rubrik和VMware负责基础设施管理工作长达十余年。 三年前,当大型语言模型开始展现其真正潜力时,普里与红杉资本的另一位IT负责人苏迪尔·杜尔贾蒂(Sudheer Dhurjati)意识到,人工智能能够帮助自主解决基础设施工程师面临的一大挑战——在技术故障发生前就加以预防。这两位技术界资深人士意识到,与其在系统故障发生后被动应对
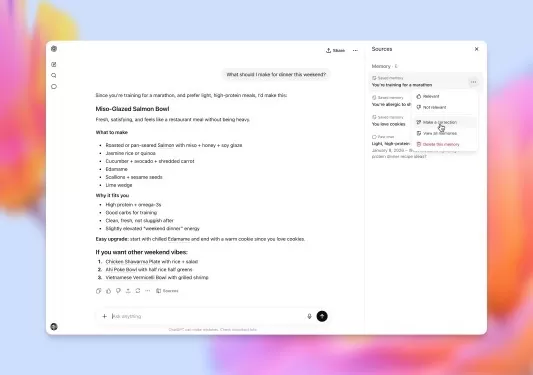 OpenAI 推出 GPT-5.5 Instant,作为 ChatGPT 的新默认模型
OpenAI 于周一推出了 GPT-5.5 Instant,取代 GPT-5.3 Instant 成为 ChatGPT 的默认模型。该公司表示,此次更新旨在最大限度地减少法律、医疗和金融等高利害领域中的幻觉现象,同时保留前版本的快速响应速度。在上个月发布更广泛的 GPT-5.5 系列(重点突出了编码和知识工作方面的增强)之后,OpenAI 现已将这些改进整合到即时模型中。在性能方面,新模型在 AIME 2025 数学基准测试中得分 81.2,超过了旧模型的 65.4 分。它在 MMMU-Pr
 图书管理员举办火爆的“避开AI”工作坊,为那些对大型科技公司感到厌烦的人们提供服务
“在我的图书馆项目中,每个人都盯着屏幕,”费城南区的一位图书管理员查理·贝利(Charlie Bailey)开玩笑说。他邀请观众拿出手机,以便指导他们禁用 Apple Intelligence 和 Gemini。贝利站在儿童图书馆教室里,脚下是一块色彩鲜艳的地毯,提醒着我们“M”代表“月亮(moon)”,“Z”代表“斑马(zebra)”。但房间里那二十多位成年人并不是来上字母课。他们正在参加一个名为“避免使用人工智能(Avoiding AI)”的工作坊,在这里,“AI”指的并不是“苹果(appl
2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
10 个工具
xix.ai
2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai
2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai
2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai
2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai
2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai

This article is really timely coz I'm deciding between ChatGPT Plus and Grok for work projects. The info war angle mentioned here is kinda chilling… AI chatbots shaping what facts we see could have scary real-world impacts 🧐 Would love a deeper dive into their real-time data accuracy though!












