


 首頁
AI 內容版權規則:如何保護您的「無塵室
隨著人工智慧的普及,版權與資料隱私的法律複雜性也愈來愈高。保障訓練資料和 AI 輸出的完整性,是負責任開發的根本。本文將探討差異化隱私權方法以及版權保護的「無塵室」策略,詳細說明這些架構如何協助保護 AI 模型及其使用者的安全。
重點
瞭解差異隱私權如何應用於生成式 AI。
檢視著作權保護的「淨室」方法。
解決將傳統版權法應用於 AI 產生材料的難題。
部署策略以阻止 AI 模型記憶和重複使用受版權保護的內容。
討論 AI 訓練中資料脈絡的法律與道德後果。
檢視人工智慧輸出的水印技術,以建立版權所有權。
評估不同隱私權與著作權保障如何影響大型語言模型 (Large Language Models, LLM) 的建立與實施。
差異隱私權與著作權的交集
差異隱私權:在生成式人工智能中保護資料
差異隱私權是一個能在保護個人資訊的同時進行資料分析的架構。它的工作原理是將統計雜訊引入資料集,有助於隱藏任何單一項目。對於生成式人工智能 (Generative AI) 而言,這可防止模型記住並重製受保護的內容。包括訓練方法在內的多重因素會影響差異隱私權的有效性。
為什麼差異化隱私對於生成式人工智能來說是不可或缺的?
它的好處包括
- 防止意外複製受版權保護的作品。
- 維護訓練中使用的使用者資料的機密性。
- 促進創造道德上健全的 AI 系統。
差異化隱私權是生成式人工智能中資料安全和道德操作的基礎。實施下列技術對於建立成功的差異隱私模型至關重要:
技術 說明 添加雜訊 為資料點引入統計變化,以掩蓋個別記錄。這使得 AI 難以記住特定細節,形成差異隱私的基礎。 縮小梯度 在模型訓練期間限制梯度更新的大小。此步驟能確保沒有單一資料點過度塑造模型,降低記憶或過度擬合的風險。 參數淨化 移除與版權資料相關的模型參數。模型會學習辨識並排除這些元素,進而產生更乾淨的最終版本。
應用這些方法對於道德人工智慧的進步尤其重要。
無塵室方法:AI 開發的安全環境
無塵室」的概念借用自軟體工程,提供一個受保護的隔離空間,以保障 AI 專案中的智慧財產權。
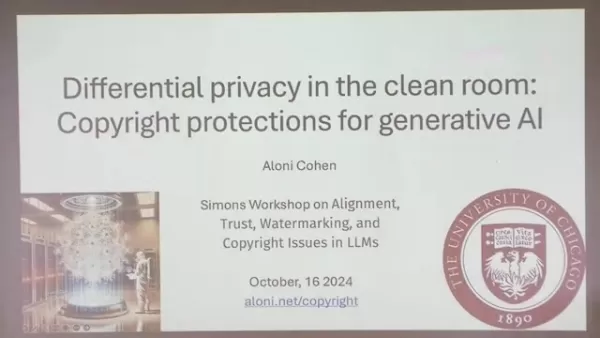
此設定可讓開發人員處理敏感或受版權保護的資訊,同時將未經授權使用於 AI 結果的機會降到最低。它通常會結合專門為避免侵犯版權而建立的系統。
建議的無塵室實務:
- 限制進入的專用隔離空間。
- 嚴格的資料匯入與匯出程序。
- 外部驗證 AI 輸出是否符合版權規定。
- 持續評估 AI 行為,以找出資料保留或複製的跡象。
在零信任架構中訓練模型。
無塵室設定可提供強大的保證,讓智慧財產權與安全性成為 AI 開發流程的核心。
版權為何如此重要
平衡版權保障與水印與 AI 訓練的需求至關重要。適當校準的模型有助於降低風險並提升社會效益。
包括《紐約時報》在內的多個組織已針對 OpenAI 提出版權訴訟。
紐約時報案的主要指控:
- GPT-4 可以逐字複製《紐約時報》的文章。
- 訓練資料先前包含來自 Hoan Ton-That 的內容。
水印如何幫助著作權索賠?
水印有助於內容保護,並建立對 AI 訓練過程的信任。常見的種類包括
- 可見水印
- 隱形水印
- 強大的水印 - 可抵抗壓縮等變更
- 脆弱的水印
值得注意的是,沒有任何水印解決方案是完全萬無一失的。先進的方法有時可以繞過、規避或移除它們。差異隱私提供了更直接的方法來保護使用者資料。
歸根結柢,這些方法都是為了保護 AI 系統與著作權人的權利。
主要挑戰
倫理雷區
我們該如何驗證資料品質,並追蹤其來源至可接受的層級?何謂公平且實用的版權保護?鑑於線上有大量可免費取得的版權資料,應以何種標準來指導其納入或排除?這些都是複雜的法律與道德問題,需要小心謹慎的處理。
差異化隱私權實施
優點
在整個 AI 訓練週期中保護使用者資料。
降低人工智能模型保留受版權保護資訊的可能性。
鼓勵創造符合倫理的 AI 系統。
可能降低著作權訴訟的風險。
缺點
可能會因為引入雜訊而降低 AI 輸出的精確度與品質。
部署可能需要相當大的運算能力。
需要專業的技術知識進行設定與維護。
常見問題
什麼是人工智慧的差異隱私?
人工智慧中的差異隱私權是指在資料集中加入經過仔細校準的雜訊,允許模型學習一般模式,而不會存取或記住特定的敏感細節。這樣既能維持統計的實用性,又能確保個人隱私。
無塵室」方法如何保護產生式人工智能的版權?
無塵室方法建立了一個安全、隔離的開發空間,並有嚴格的資料控制。它可以防止直接接觸版權來源,確保 AI 輸出是原始且符合法律規定的。
將現有的著作權架構適應於創作型人工智慧時,會遇到哪些挑戰?
關鍵問題包括定義 AI 生成作品的作者身份、釐清模型訓練的合理使用例外情況,以及在 AI 系統可能複製受保護內容時執行版權。許多法律與經濟方面的問題仍未解決。
相關問題
人工智能產生的圖像是否具有版權?
目前並沒有通用的標準。大多數司法管轄區的立法都在快速演進。預期在不久的將來會出現全面的法律與道德結構。
水印如何保護 AI 產生內容的版權?
水印是嵌入在 AI 產生的資料中以標示擁有權的數位標記。它們可以是可見的或隱藏的,而且強大的版本可以在壓縮等編輯過程中持續存在。脆弱的水印會在被篡改時破壞,表示可能會被濫用。
什麼是大型語言模型 (LLM)?
LLM 是在大量資料集上訓練的人工智能系統,通常用於產生文字和圖像。它們對資料的大量需求,是版權與資料隱私權成為迫切問題的主要原因。
相關文章
 Google 測試 Remy AI 代理,以 Gemini 為重點轉向使用者控制
根據《商業內幕》的報道,谷歌正在測試 Remy,這是 Gemini 的一款全新 AI 個人代理工具。該工具旨在代表使用者執行任務,從而簡化專業工作流程和日常事務。目前,Remy 正在 Gemini 應用的內部員工專屬版本中進行測試。該報告引用了一份內部檔案以及對兩位熟悉該專案的個人的採訪。內部資料將 Remy 描述為“全天候個人代理”,將 Gemini 定位為能夠代表使用者行事的主動助手。接近該專案的訊息人士證實,谷歌員工正在積極測試 Remy。谷歌發言人拒絕提供進一步評論。該報告未提及公開發布
如何修復核心網頁指標以獲得更好的 SEO 排名
利用 AI 工具簡化成績單評語撰寫引言用於生成成績單評語的 AI 工具Magic SchoolAlmanac AIChat GPT使用 Magic School 生成成績單評語登入 Magic School選擇成績單評語工具為學生定製評語使用 Almanac AI 生成成績單評語設定課程與評分方案配置評語長度與學生資訊使用 Almanac AI 生成評語比較 Magic School 與 Almanac AI設定的便捷性可定製性與課程內容的整合速度與效率使用
Slackbot 成為 AI 智慧體
Slackbot,嵌入在Salesforce企業訊息平臺Slack中的自動化助手,正在演變為一個AI智慧體。Salesforce技術長Parker Harris設想它將達到與OpenAI的ChatGPT相媲美的病毒式傳播地位。這家雲軟體巨頭於週二推出了更新版的Slackbot。該新版AI驅動版本面向Business+和Enterprise+客戶,可直接在Slack內查詢資訊、起草電子郵件和安排會議。在獲得適當許可權的情況下,它還能與Microsoft Teams和Google Drive等企
相關專題推薦
寫作
 最適合撰寫長篇 SEO 文章的 AI 大綱生成工具
2026 年最新最佳、評價最高的 AI 大綱生成器,專為長篇 SEO 文章打造,由 XIX.AI 精心精選。這些強大的工具能為快速創作高品質內容提供革命性的協助,大幅提升寫作效率。 透過免費版與付費版的比較、實際測試結果及詳細排名,協助您找出最符合需求且不容錯過的選項。立即探索,釋放您的 AI 優勢。
 8 個工具
 xix.ai
教育與學習
適用於作業與考試準備的人工智慧學習工具
2026 年最新最佳 AI 學習工具,助您完成作業與備考!XIX.AI 精心整理了一份備受好評的清單,收錄了這些強大且具革命性、經實測驗證的工具,能幫助學生提升效率、簡化作業流程,並在考試中取得優異成績。 獲取免費版與付費版的比較、詳細排名,以及必試選項,以釋放您的 AI 優勢。立即探索!
10 個工具
xix.ai
音樂創作
面向詞曲創作者、旋律片段、主旋律及多語言草稿創作的AI人聲演示工具
2026 年最新最佳 AI 人聲演示工具,專為詞曲創作者、旋律創作者和多語言內容團隊打造!XIX.AI 精心整理了一份經過嚴格真實世界測試的高評分、變革性工具列表。您將找到詳細的免費與付費對比資料、全面排名以及必試選項,幫助您提升創作效率並釋放創意潛力。立即探索,發現滿足您所有內容需求的完美工具!
9 個工具
xix.ai
商業
最適合小型企業的頂尖 AI 競爭情勢分析工具
2026 年最新、最佳且評價最高的中小企業 AI 競爭研究工具!XIX.AI 精心精選了一系列極具威力且能改變遊戲規則的工具,並透過嚴謹的實測與詳細排名,每週更新內容。您可在此找到詳盡的免費版與付費版比較,協助您找出必試的工具,以提升工作效率並獲得競爭優勢。 立即探索,找出最適合您的工具!
9 個工具
xix.ai
圖像編輯
用於電商服裝、皮膚清潔和色彩一致性的 Photoshop AI 修圖工具
2026 年最新最佳 Photoshop AI 修圖工具,適用於電商服裝、皮膚清潔和色彩一致性!這份頂級精選列表包含強大的變革性解決方案,可幫助您提升寫作效率、簡化內容創作並輕鬆實現完美的視覺效果。每個工具都經過實際測試,並透過每週更新的排名進行驗證,同時提供免費與付費版本的詳細對比。由 XIX.AI 支援,這是任何希望發揮 AI 優勢的人必試指南。立即探索!
10 個工具
xix.ai
迅速的
適用於 ChatGPT 工作流程的最佳 AI 提示詞庫
2026 年最新、最受好評的 AI 提示詞庫,可優化各類 ChatGPT 工作流程。XIX.AI 精心蒐羅了一套強大且具革命性的精選集合,並經過嚴格的實際測試,以確保其表現卓越。 您可查閱詳盡的免費版與付費版比較分析,以及專家評比,助您挑選必試工具,從而提升工作效率並釋放您的 AI 優勢。立即探索!
11 個工具
xix.ai

 評論 (2)
0/500
![DavidLewis]()
Is the 'clean room' approach actually viable when models are trained on billions of scraped datasets? It feels like trying to keep a pool clean while dumping sewage upstream. 🌊 The article's point about differential privacy is crucial, but enforcement remains a nightmare for developers. We need clearer legal frameworks, not just technical workarounds, before this becomes a legal minefield for startups. 🚫⚖️
![SebastianAnderson]()
¿Has pensado en cómo el copyright cambia la industria ahora con la IA? En cierto modo, esto me recuerda a cuando se popularizó la fotografía y la gente debatía si violaba derechos de autor 🔍. En mi opinión, es clave que las empresas sean transparentes con los datos de entrenamiento. Esto no solo evita demandas, sino que construye confianza. Personalmente, trato de usar solo herramientas que especifiquen el origen de sus datos… aunque a veces no es fácil encontrarlas 🧐.
隨著人工智慧的普及,版權與資料隱私的法律複雜性也愈來愈高。保障訓練資料和 AI 輸出的完整性,是負責任開發的根本。本文將探討差異化隱私權方法以及版權保護的「無塵室」策略,詳細說明這些架構如何協助保護 AI 模型及其使用者的安全。
重點
瞭解差異隱私權如何應用於生成式 AI。
檢視著作權保護的「淨室」方法。
解決將傳統版權法應用於 AI 產生材料的難題。
部署策略以阻止 AI 模型記憶和重複使用受版權保護的內容。
討論 AI 訓練中資料脈絡的法律與道德後果。
檢視人工智慧輸出的水印技術,以建立版權所有權。
評估不同隱私權與著作權保障如何影響大型語言模型 (Large Language Models, LLM) 的建立與實施。
差異隱私權與著作權的交集
差異隱私權:在生成式人工智能中保護資料
差異隱私權是一個能在保護個人資訊的同時進行資料分析的架構。它的工作原理是將統計雜訊引入資料集,有助於隱藏任何單一項目。對於生成式人工智能 (Generative AI) 而言,這可防止模型記住並重製受保護的內容。包括訓練方法在內的多重因素會影響差異隱私權的有效性。
為什麼差異化隱私對於生成式人工智能來說是不可或缺的?
它的好處包括
- 防止意外複製受版權保護的作品。
- 維護訓練中使用的使用者資料的機密性。
- 促進創造道德上健全的 AI 系統。
差異化隱私權是生成式人工智能中資料安全和道德操作的基礎。實施下列技術對於建立成功的差異隱私模型至關重要:
| 技術 | 說明 |
|---|---|
| 添加雜訊 | 為資料點引入統計變化,以掩蓋個別記錄。這使得 AI 難以記住特定細節,形成差異隱私的基礎。 |
| 縮小梯度 | 在模型訓練期間限制梯度更新的大小。此步驟能確保沒有單一資料點過度塑造模型,降低記憶或過度擬合的風險。 |
| 參數淨化 | 移除與版權資料相關的模型參數。模型會學習辨識並排除這些元素,進而產生更乾淨的最終版本。 |
應用這些方法對於道德人工智慧的進步尤其重要。
無塵室方法:AI 開發的安全環境
無塵室」的概念借用自軟體工程,提供一個受保護的隔離空間,以保障 AI 專案中的智慧財產權。
此設定可讓開發人員處理敏感或受版權保護的資訊,同時將未經授權使用於 AI 結果的機會降到最低。它通常會結合專門為避免侵犯版權而建立的系統。
建議的無塵室實務:
- 限制進入的專用隔離空間。
- 嚴格的資料匯入與匯出程序。
- 外部驗證 AI 輸出是否符合版權規定。
- 持續評估 AI 行為,以找出資料保留或複製的跡象。
在零信任架構中訓練模型。
無塵室設定可提供強大的保證,讓智慧財產權與安全性成為 AI 開發流程的核心。
版權為何如此重要
平衡版權保障與水印與 AI 訓練的需求至關重要。適當校準的模型有助於降低風險並提升社會效益。
包括《紐約時報》在內的多個組織已針對 OpenAI 提出版權訴訟。
紐約時報案的主要指控:
- GPT-4 可以逐字複製《紐約時報》的文章。
- 訓練資料先前包含來自 Hoan Ton-That 的內容。
水印如何幫助著作權索賠?
水印有助於內容保護,並建立對 AI 訓練過程的信任。常見的種類包括
- 可見水印
- 隱形水印
- 強大的水印 - 可抵抗壓縮等變更
- 脆弱的水印
值得注意的是,沒有任何水印解決方案是完全萬無一失的。先進的方法有時可以繞過、規避或移除它們。差異隱私提供了更直接的方法來保護使用者資料。
歸根結柢,這些方法都是為了保護 AI 系統與著作權人的權利。
主要挑戰
倫理雷區
我們該如何驗證資料品質,並追蹤其來源至可接受的層級?何謂公平且實用的版權保護?鑑於線上有大量可免費取得的版權資料,應以何種標準來指導其納入或排除?這些都是複雜的法律與道德問題,需要小心謹慎的處理。
差異化隱私權實施
優點
在整個 AI 訓練週期中保護使用者資料。
降低人工智能模型保留受版權保護資訊的可能性。
鼓勵創造符合倫理的 AI 系統。
可能降低著作權訴訟的風險。
缺點
可能會因為引入雜訊而降低 AI 輸出的精確度與品質。
部署可能需要相當大的運算能力。
需要專業的技術知識進行設定與維護。
常見問題
什麼是人工智慧的差異隱私?
人工智慧中的差異隱私權是指在資料集中加入經過仔細校準的雜訊,允許模型學習一般模式,而不會存取或記住特定的敏感細節。這樣既能維持統計的實用性,又能確保個人隱私。
無塵室」方法如何保護產生式人工智能的版權?
無塵室方法建立了一個安全、隔離的開發空間,並有嚴格的資料控制。它可以防止直接接觸版權來源,確保 AI 輸出是原始且符合法律規定的。
將現有的著作權架構適應於創作型人工智慧時,會遇到哪些挑戰?
關鍵問題包括定義 AI 生成作品的作者身份、釐清模型訓練的合理使用例外情況,以及在 AI 系統可能複製受保護內容時執行版權。許多法律與經濟方面的問題仍未解決。
相關問題
人工智能產生的圖像是否具有版權?
目前並沒有通用的標準。大多數司法管轄區的立法都在快速演進。預期在不久的將來會出現全面的法律與道德結構。
水印如何保護 AI 產生內容的版權?
水印是嵌入在 AI 產生的資料中以標示擁有權的數位標記。它們可以是可見的或隱藏的,而且強大的版本可以在壓縮等編輯過程中持續存在。脆弱的水印會在被篡改時破壞,表示可能會被濫用。
什麼是大型語言模型 (LLM)?
LLM 是在大量資料集上訓練的人工智能系統,通常用於產生文字和圖像。它們對資料的大量需求,是版權與資料隱私權成為迫切問題的主要原因。







 Google 測試 Remy AI 代理,以 Gemini 為重點轉向使用者控制
根據《商業內幕》的報道,谷歌正在測試 Remy,這是 Gemini 的一款全新 AI 個人代理工具。該工具旨在代表使用者執行任務,從而簡化專業工作流程和日常事務。目前,Remy 正在 Gemini 應用的內部員工專屬版本中進行測試。該報告引用了一份內部檔案以及對兩位熟悉該專案的個人的採訪。內部資料將 Remy 描述為“全天候個人代理”,將 Gemini 定位為能夠代表使用者行事的主動助手。接近該專案的訊息人士證實,谷歌員工正在積極測試 Remy。谷歌發言人拒絕提供進一步評論。該報告未提及公開發布
 如何修復核心網頁指標以獲得更好的 SEO 排名
利用 AI 工具簡化成績單評語撰寫引言用於生成成績單評語的 AI 工具Magic SchoolAlmanac AIChat GPT使用 Magic School 生成成績單評語登入 Magic School選擇成績單評語工具為學生定製評語使用 Almanac AI 生成成績單評語設定課程與評分方案配置評語長度與學生資訊使用 Almanac AI 生成評語比較 Magic School 與 Almanac AI設定的便捷性可定製性與課程內容的整合速度與效率使用
 Slackbot 成為 AI 智慧體
Slackbot,嵌入在Salesforce企業訊息平臺Slack中的自動化助手,正在演變為一個AI智慧體。Salesforce技術長Parker Harris設想它將達到與OpenAI的ChatGPT相媲美的病毒式傳播地位。這家雲軟體巨頭於週二推出了更新版的Slackbot。該新版AI驅動版本面向Business+和Enterprise+客戶,可直接在Slack內查詢資訊、起草電子郵件和安排會議。在獲得適當許可權的情況下,它還能與Microsoft Teams和Google Drive等企

2026 年最新最佳、評價最高的 AI 大綱生成器,專為長篇 SEO 文章打造,由 XIX.AI 精心精選。這些強大的工具能為快速創作高品質內容提供革命性的協助,大幅提升寫作效率。 透過免費版與付費版的比較、實際測試結果及詳細排名,協助您找出最符合需求且不容錯過的選項。立即探索,釋放您的 AI 優勢。
8 個工具
xix.ai

2026 年最新最佳 AI 學習工具,助您完成作業與備考!XIX.AI 精心整理了一份備受好評的清單,收錄了這些強大且具革命性、經實測驗證的工具,能幫助學生提升效率、簡化作業流程,並在考試中取得優異成績。 獲取免費版與付費版的比較、詳細排名,以及必試選項,以釋放您的 AI 優勢。立即探索!
10 個工具
xix.ai

2026 年最新最佳 AI 人聲演示工具,專為詞曲創作者、旋律創作者和多語言內容團隊打造!XIX.AI 精心整理了一份經過嚴格真實世界測試的高評分、變革性工具列表。您將找到詳細的免費與付費對比資料、全面排名以及必試選項,幫助您提升創作效率並釋放創意潛力。立即探索,發現滿足您所有內容需求的完美工具!
9 個工具
xix.ai

2026 年最新、最佳且評價最高的中小企業 AI 競爭研究工具!XIX.AI 精心精選了一系列極具威力且能改變遊戲規則的工具,並透過嚴謹的實測與詳細排名,每週更新內容。您可在此找到詳盡的免費版與付費版比較,協助您找出必試的工具,以提升工作效率並獲得競爭優勢。 立即探索,找出最適合您的工具!
9 個工具
xix.ai

2026 年最新最佳 Photoshop AI 修圖工具,適用於電商服裝、皮膚清潔和色彩一致性!這份頂級精選列表包含強大的變革性解決方案,可幫助您提升寫作效率、簡化內容創作並輕鬆實現完美的視覺效果。每個工具都經過實際測試,並透過每週更新的排名進行驗證,同時提供免費與付費版本的詳細對比。由 XIX.AI 支援,這是任何希望發揮 AI 優勢的人必試指南。立即探索!
10 個工具
xix.ai

2026 年最新、最受好評的 AI 提示詞庫,可優化各類 ChatGPT 工作流程。XIX.AI 精心蒐羅了一套強大且具革命性的精選集合,並經過嚴格的實際測試,以確保其表現卓越。 您可查閱詳盡的免費版與付費版比較分析,以及專家評比,助您挑選必試工具,從而提升工作效率並釋放您的 AI 優勢。立即探索!
11 個工具
xix.ai

Is the 'clean room' approach actually viable when models are trained on billions of scraped datasets? It feels like trying to keep a pool clean while dumping sewage upstream. 🌊 The article's point about differential privacy is crucial, but enforcement remains a nightmare for developers. We need clearer legal frameworks, not just technical workarounds, before this becomes a legal minefield for startups. 🚫⚖️
¿Has pensado en cómo el copyright cambia la industria ahora con la IA? En cierto modo, esto me recuerda a cuando se popularizó la fotografía y la gente debatía si violaba derechos de autor 🔍. En mi opinión, es clave que las empresas sean transparentes con los datos de entrenamiento. Esto no solo evita demandas, sino que construye confianza. Personalmente, trato de usar solo herramientas que especifiquen el origen de sus datos… aunque a veces no es fácil encontrarlas 🧐.












