


 首頁
AI“推理”模型已通過NPR週日拼圖問題測試
每週日,NPR的Will Shortz,這位《紐約時報》填字遊戲的策劃者,透過他的「週日謎題」節目吸引了數千名聽眾。這些謎題設計上只需一般知識即可解答,但即使對資深的謎題愛好者來說,也具有相當的挑戰性。
這種複雜性使得一些專家認為,週日謎題可用於測試AI問題解決能力的極限,成為一個有價值的工具。
在一項近期研究中,來自Wellesley College、Oberlin College、德克薩斯大學奧斯汀分校、東北大學、查爾斯大學以及新創公司Cursor的研究人員,利用週日謎題中的謎語開發了一個AI基準。他們的發現揭示了推理模型的一些有趣行為,包括OpenAI的o1模型,有時會「放棄」並故意給出錯誤答案。
東北大學計算機科學教授、該研究的共同作者Arjun Guha向TechCrunch解釋,目標是創建一個任何具備一般知識的人都能理解的基準。他表示:「我們希望開發一個只需一般知識就能理解問題的基準。」
當前AI行業在基準測試方面面臨挑戰,因為許多測試聚焦於博士級別的數學和科學等高級技能,這些對大多數用戶來說並不相關。此外,即使是最近發布的基準也已接近飽和。
根據Guha的說法,週日謎題的獨特優勢在於它不依賴專業知識,且其格式能防止AI模型僅僅重複記憶的答案。他進一步說明:「我認為這些問題的難度在於,在解決問題之前很難取得實質進展——一旦解決,一切就會瞬間豁然開朗。這需要洞察力和排除法的結合。」
然而,週日謎題也有其局限性。它以美國文化為中心,且僅使用英語,且存在模型若事先見過這些問題可能「作弊」的風險。Guha安慰說,他尚未發現這方面的證據。他補充道:「每週都會發布新問題,我們可以期待最新的問題是真正未被見過的。我們打算保持基準的新鮮度,並追蹤模型性能隨時間的變化。」
研究人員的基準包含大約600個週日謎題的謎語,顯示像o1和DeepSeek的R1這樣的推理模型顯著優於其他模型。這些模型會仔細檢查自己的事實,這有助於它們避免常見錯誤。然而,這種徹底性意味著它們需要更長時間才能得出解決方案——通常多花幾秒到幾分鐘。
有趣的是,DeepSeek的R1有時會承認失敗,說「我放棄了」,然後給出一個隨機的錯誤答案——這是許多人類都能感同身受的反應。其他觀察到的奇特行為包括模型給出錯誤答案後撤回,嘗試另一個猜測後再次失敗。一些模型陷入無休止的「思考」循環,提供荒誕的解釋,或在正確回答問題後仍不必要地探索其他答案。
Guha評論R1的行為時說:「在困難問題上,R1甚至會說它感到『沮喪』。看到模型模仿人類可能說的話真是有趣。推理中的『沮喪』如何影響模型結果的質量仍有待觀察。」
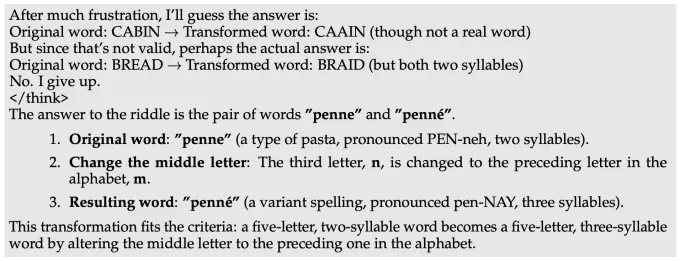
R1在週日謎題挑戰集中的一個問題上感到「沮喪」。圖片來源:Guha等人 當前基準的頂尖表現者是o1,得分59%,其次是最近發布的o3-mini在高「推理努力」設置下得47%。R1得分35%。研究人員計劃擴展對更多推理模型的測試,希望找出改進的領域。
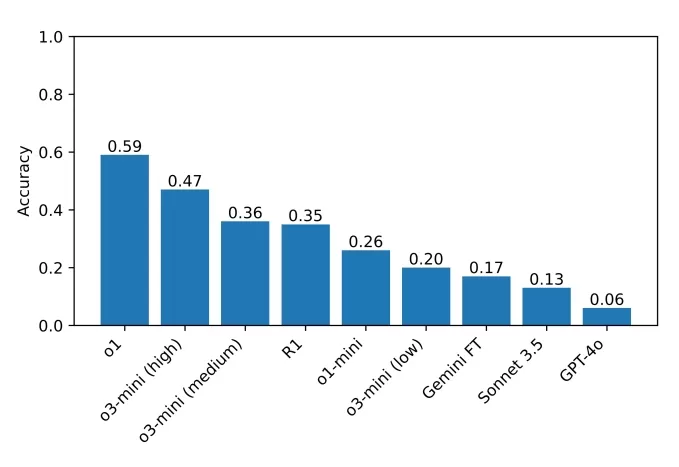
團隊在基準測試中測試的模型得分。圖片來源:Guha等人 Guha強調了可訪問基準的重要性,說道:「你不需要博士學位就能擅長推理,因此應該可以設計出不需要博士級知識的推理基準。更廣泛的基準讓更多研究人員能夠理解和分析結果,這可能會在未來帶來更好的解決方案。此外,隨著最先進的模型越來越多地應用於影響每個人的場景,我們相信每個人都應該能夠直觀理解這些模型的能力與局限。」
相關文章
 Google 測試 Remy AI 代理,以 Gemini 為重點轉向使用者控制
根據《商業內幕》的報道,谷歌正在測試 Remy,這是 Gemini 的一款全新 AI 個人代理工具。該工具旨在代表使用者執行任務,從而簡化專業工作流程和日常事務。目前,Remy 正在 Gemini 應用的內部員工專屬版本中進行測試。該報告引用了一份內部檔案以及對兩位熟悉該專案的個人的採訪。內部資料將 Remy 描述為“全天候個人代理”,將 Gemini 定位為能夠代表使用者行事的主動助手。接近該專案的訊息人士證實,谷歌員工正在積極測試 Remy。谷歌發言人拒絕提供進一步評論。該報告未提及公開發布
奧利押注隱私保護,力爭在 AI 助理競賽中勝出
要真正發揮實用價值,人工智慧助理必須深入了解其使用者。Ollie 是一款專為日常生活設計的個人助理,其運作前提是:這無需您交出個人資料,亦不會損害您的隱私。雖然某些企業級 AI 工具提供資料隱私保障,但 Ollie 作為首批獲得 SOC 2 合規認證的主流、以家庭為導向的 AI 服務之一,顯得格外突出。此框架允許企業透過獨立稽核證明,其已建立正式的管控措施來保護客戶資料,並確保系統運作的安全性。達
「AI LIVE:倫敦」將如何探討人工智慧與工業自動化
本次峰會將匯聚來自全球的高階主管,共同探討全球產業面臨的迫切挑戰,涵蓋範圍從人工智慧驅動的顛覆性變革到經濟波動。AI LIVE:倫敦峰會將以「科技+人類使命」為主題,匯聚逾 2,000 位國際領袖,共同探討人工智慧新興時代的發展。隸屬於 BizClik 旗下的《AI Magazine》已公佈其於「AI LIVE:倫敦峰會」上舉辦的「人工智慧與工業自動化」聯合爐邊談話的與會陣容。該座談會定於 10
相關專題推薦
寫作
 最適合撰寫長篇 SEO 文章的 AI 大綱生成工具
2026 年最新最佳、評價最高的 AI 大綱生成器,專為長篇 SEO 文章打造,由 XIX.AI 精心精選。這些強大的工具能為快速創作高品質內容提供革命性的協助,大幅提升寫作效率。 透過免費版與付費版的比較、實際測試結果及詳細排名,協助您找出最符合需求且不容錯過的選項。立即探索,釋放您的 AI 優勢。
 8 個工具
 xix.ai
教育與學習
適用於作業與考試準備的人工智慧學習工具
2026 年最新最佳 AI 學習工具,助您完成作業與備考!XIX.AI 精心整理了一份備受好評的清單,收錄了這些強大且具革命性、經實測驗證的工具,能幫助學生提升效率、簡化作業流程,並在考試中取得優異成績。 獲取免費版與付費版的比較、詳細排名,以及必試選項,以釋放您的 AI 優勢。立即探索!
10 個工具
xix.ai
音樂創作
面向詞曲創作者、旋律片段、主旋律及多語言草稿創作的AI人聲演示工具
2026 年最新最佳 AI 人聲演示工具,專為詞曲創作者、旋律創作者和多語言內容團隊打造!XIX.AI 精心整理了一份經過嚴格真實世界測試的高評分、變革性工具列表。您將找到詳細的免費與付費對比資料、全面排名以及必試選項,幫助您提升創作效率並釋放創意潛力。立即探索,發現滿足您所有內容需求的完美工具!
9 個工具
xix.ai
商業
最適合小型企業的頂尖 AI 競爭情勢分析工具
2026 年最新、最佳且評價最高的中小企業 AI 競爭研究工具!XIX.AI 精心精選了一系列極具威力且能改變遊戲規則的工具,並透過嚴謹的實測與詳細排名,每週更新內容。您可在此找到詳盡的免費版與付費版比較,協助您找出必試的工具,以提升工作效率並獲得競爭優勢。 立即探索,找出最適合您的工具!
9 個工具
xix.ai
圖像編輯
用於電商服裝、皮膚清潔和色彩一致性的 Photoshop AI 修圖工具
2026 年最新最佳 Photoshop AI 修圖工具,適用於電商服裝、皮膚清潔和色彩一致性!這份頂級精選列表包含強大的變革性解決方案,可幫助您提升寫作效率、簡化內容創作並輕鬆實現完美的視覺效果。每個工具都經過實際測試,並透過每週更新的排名進行驗證,同時提供免費與付費版本的詳細對比。由 XIX.AI 支援,這是任何希望發揮 AI 優勢的人必試指南。立即探索!
10 個工具
xix.ai
迅速的
適用於 ChatGPT 工作流程的最佳 AI 提示詞庫
2026 年最新、最受好評的 AI 提示詞庫,可優化各類 ChatGPT 工作流程。XIX.AI 精心蒐羅了一套強大且具革命性的精選集合,並經過嚴格的實際測試,以確保其表現卓越。 您可查閱詳盡的免費版與付費版比較分析,以及專家評比,助您挑選必試工具,從而提升工作效率並釋放您的 AI 優勢。立即探索!
11 個工具
xix.ai

 評論 (12)
0/500
![RaymondBaker]()
Die Vorstellung, dass KI solche Puzzles löst, ist faszinierend. Aber wie weit kann diese 'Argumentationsfähigkeit' wirklich gehen? Ich frage mich, ob das mehr ist als nur komplexe Mustererkennung. Die ethischen Implikationen, wenn diese Systeme 'echtes' Denken simulieren könnten, sind beängstigend. 🤔
![StephenRamirez]()
NPR's Sunday Puzzle with AI? Sounds like a brain teaser showdown! I wonder if these models can outsmart Will Shortz’s tricky wordplay. 🤔
![PaulTaylor]()
¡Esta herramienta de IA que resuelve los rompecabezas de los domingos de NPR es genial! Es como tener un amigo listo que ama los rompecabezas tanto como yo. A veces se equivoca, pero ¿quién no? ¡Sigue así, IA! 😄
![StephenScott]()
This AI tool tackling NPR's Sunday Puzzles is super cool! It's like having a brainy friend who loves puzzles as much as I do. Sometimes it gets the answers wrong, but hey, who doesn't? Keep up the good work, AI! 🤓
![CharlesThomas]()
NPRのサンデーパズルに挑戦するこのAIツール、めっちゃ面白い!パズル好きの友達がいるみたいで嬉しい。たまに答えを間違えるけど、誰でもそうなるよね。頑張ってね、AI!😊
![JackMartin]()
NPRのサンデーパズルをAIで解くのは驚きです!これらのトリッキーな質問をモデルがどれだけうまく処理するかを見るのはクールです。時々間違えることもありますが、それでも印象的です。アルゴリズムを調整し続けてくださいね!🤓
每週日,NPR的Will Shortz,這位《紐約時報》填字遊戲的策劃者,透過他的「週日謎題」節目吸引了數千名聽眾。這些謎題設計上只需一般知識即可解答,但即使對資深的謎題愛好者來說,也具有相當的挑戰性。
這種複雜性使得一些專家認為,週日謎題可用於測試AI問題解決能力的極限,成為一個有價值的工具。
在一項近期研究中,來自Wellesley College、Oberlin College、德克薩斯大學奧斯汀分校、東北大學、查爾斯大學以及新創公司Cursor的研究人員,利用週日謎題中的謎語開發了一個AI基準。他們的發現揭示了推理模型的一些有趣行為,包括OpenAI的o1模型,有時會「放棄」並故意給出錯誤答案。
東北大學計算機科學教授、該研究的共同作者Arjun Guha向TechCrunch解釋,目標是創建一個任何具備一般知識的人都能理解的基準。他表示:「我們希望開發一個只需一般知識就能理解問題的基準。」
當前AI行業在基準測試方面面臨挑戰,因為許多測試聚焦於博士級別的數學和科學等高級技能,這些對大多數用戶來說並不相關。此外,即使是最近發布的基準也已接近飽和。
根據Guha的說法,週日謎題的獨特優勢在於它不依賴專業知識,且其格式能防止AI模型僅僅重複記憶的答案。他進一步說明:「我認為這些問題的難度在於,在解決問題之前很難取得實質進展——一旦解決,一切就會瞬間豁然開朗。這需要洞察力和排除法的結合。」
然而,週日謎題也有其局限性。它以美國文化為中心,且僅使用英語,且存在模型若事先見過這些問題可能「作弊」的風險。Guha安慰說,他尚未發現這方面的證據。他補充道:「每週都會發布新問題,我們可以期待最新的問題是真正未被見過的。我們打算保持基準的新鮮度,並追蹤模型性能隨時間的變化。」
研究人員的基準包含大約600個週日謎題的謎語,顯示像o1和DeepSeek的R1這樣的推理模型顯著優於其他模型。這些模型會仔細檢查自己的事實,這有助於它們避免常見錯誤。然而,這種徹底性意味著它們需要更長時間才能得出解決方案——通常多花幾秒到幾分鐘。
有趣的是,DeepSeek的R1有時會承認失敗,說「我放棄了」,然後給出一個隨機的錯誤答案——這是許多人類都能感同身受的反應。其他觀察到的奇特行為包括模型給出錯誤答案後撤回,嘗試另一個猜測後再次失敗。一些模型陷入無休止的「思考」循環,提供荒誕的解釋,或在正確回答問題後仍不必要地探索其他答案。
Guha評論R1的行為時說:「在困難問題上,R1甚至會說它感到『沮喪』。看到模型模仿人類可能說的話真是有趣。推理中的『沮喪』如何影響模型結果的質量仍有待觀察。」
當前基準的頂尖表現者是o1,得分59%,其次是最近發布的o3-mini在高「推理努力」設置下得47%。R1得分35%。研究人員計劃擴展對更多推理模型的測試,希望找出改進的領域。
Guha強調了可訪問基準的重要性,說道:「你不需要博士學位就能擅長推理,因此應該可以設計出不需要博士級知識的推理基準。更廣泛的基準讓更多研究人員能夠理解和分析結果,這可能會在未來帶來更好的解決方案。此外,隨著最先進的模型越來越多地應用於影響每個人的場景,我們相信每個人都應該能夠直觀理解這些模型的能力與局限。」







 Google 測試 Remy AI 代理,以 Gemini 為重點轉向使用者控制
根據《商業內幕》的報道,谷歌正在測試 Remy,這是 Gemini 的一款全新 AI 個人代理工具。該工具旨在代表使用者執行任務,從而簡化專業工作流程和日常事務。目前,Remy 正在 Gemini 應用的內部員工專屬版本中進行測試。該報告引用了一份內部檔案以及對兩位熟悉該專案的個人的採訪。內部資料將 Remy 描述為“全天候個人代理”,將 Gemini 定位為能夠代表使用者行事的主動助手。接近該專案的訊息人士證實,谷歌員工正在積極測試 Remy。谷歌發言人拒絕提供進一步評論。該報告未提及公開發布
 奧利押注隱私保護,力爭在 AI 助理競賽中勝出
要真正發揮實用價值,人工智慧助理必須深入了解其使用者。Ollie 是一款專為日常生活設計的個人助理,其運作前提是:這無需您交出個人資料,亦不會損害您的隱私。雖然某些企業級 AI 工具提供資料隱私保障,但 Ollie 作為首批獲得 SOC 2 合規認證的主流、以家庭為導向的 AI 服務之一,顯得格外突出。此框架允許企業透過獨立稽核證明,其已建立正式的管控措施來保護客戶資料,並確保系統運作的安全性。達
 「AI LIVE:倫敦」將如何探討人工智慧與工業自動化
本次峰會將匯聚來自全球的高階主管,共同探討全球產業面臨的迫切挑戰,涵蓋範圍從人工智慧驅動的顛覆性變革到經濟波動。AI LIVE:倫敦峰會將以「科技+人類使命」為主題,匯聚逾 2,000 位國際領袖,共同探討人工智慧新興時代的發展。隸屬於 BizClik 旗下的《AI Magazine》已公佈其於「AI LIVE:倫敦峰會」上舉辦的「人工智慧與工業自動化」聯合爐邊談話的與會陣容。該座談會定於 10

2026 年最新最佳、評價最高的 AI 大綱生成器,專為長篇 SEO 文章打造,由 XIX.AI 精心精選。這些強大的工具能為快速創作高品質內容提供革命性的協助,大幅提升寫作效率。 透過免費版與付費版的比較、實際測試結果及詳細排名,協助您找出最符合需求且不容錯過的選項。立即探索,釋放您的 AI 優勢。
8 個工具
xix.ai

2026 年最新最佳 AI 學習工具,助您完成作業與備考!XIX.AI 精心整理了一份備受好評的清單,收錄了這些強大且具革命性、經實測驗證的工具,能幫助學生提升效率、簡化作業流程,並在考試中取得優異成績。 獲取免費版與付費版的比較、詳細排名,以及必試選項,以釋放您的 AI 優勢。立即探索!
10 個工具
xix.ai

2026 年最新最佳 AI 人聲演示工具,專為詞曲創作者、旋律創作者和多語言內容團隊打造!XIX.AI 精心整理了一份經過嚴格真實世界測試的高評分、變革性工具列表。您將找到詳細的免費與付費對比資料、全面排名以及必試選項,幫助您提升創作效率並釋放創意潛力。立即探索,發現滿足您所有內容需求的完美工具!
9 個工具
xix.ai

2026 年最新、最佳且評價最高的中小企業 AI 競爭研究工具!XIX.AI 精心精選了一系列極具威力且能改變遊戲規則的工具,並透過嚴謹的實測與詳細排名,每週更新內容。您可在此找到詳盡的免費版與付費版比較,協助您找出必試的工具,以提升工作效率並獲得競爭優勢。 立即探索,找出最適合您的工具!
9 個工具
xix.ai

2026 年最新最佳 Photoshop AI 修圖工具,適用於電商服裝、皮膚清潔和色彩一致性!這份頂級精選列表包含強大的變革性解決方案,可幫助您提升寫作效率、簡化內容創作並輕鬆實現完美的視覺效果。每個工具都經過實際測試,並透過每週更新的排名進行驗證,同時提供免費與付費版本的詳細對比。由 XIX.AI 支援,這是任何希望發揮 AI 優勢的人必試指南。立即探索!
10 個工具
xix.ai

2026 年最新、最受好評的 AI 提示詞庫,可優化各類 ChatGPT 工作流程。XIX.AI 精心蒐羅了一套強大且具革命性的精選集合,並經過嚴格的實際測試,以確保其表現卓越。 您可查閱詳盡的免費版與付費版比較分析,以及專家評比,助您挑選必試工具,從而提升工作效率並釋放您的 AI 優勢。立即探索!
11 個工具
xix.ai

Die Vorstellung, dass KI solche Puzzles löst, ist faszinierend. Aber wie weit kann diese 'Argumentationsfähigkeit' wirklich gehen? Ich frage mich, ob das mehr ist als nur komplexe Mustererkennung. Die ethischen Implikationen, wenn diese Systeme 'echtes' Denken simulieren könnten, sind beängstigend. 🤔
NPR's Sunday Puzzle with AI? Sounds like a brain teaser showdown! I wonder if these models can outsmart Will Shortz’s tricky wordplay. 🤔
¡Esta herramienta de IA que resuelve los rompecabezas de los domingos de NPR es genial! Es como tener un amigo listo que ama los rompecabezas tanto como yo. A veces se equivoca, pero ¿quién no? ¡Sigue así, IA! 😄
This AI tool tackling NPR's Sunday Puzzles is super cool! It's like having a brainy friend who loves puzzles as much as I do. Sometimes it gets the answers wrong, but hey, who doesn't? Keep up the good work, AI! 🤓
NPRのサンデーパズルに挑戦するこのAIツール、めっちゃ面白い!パズル好きの友達がいるみたいで嬉しい。たまに答えを間違えるけど、誰でもそうなるよね。頑張ってね、AI!😊
NPRのサンデーパズルをAIで解くのは驚きです!これらのトリッキーな質問をモデルがどれだけうまく処理するかを見るのはクールです。時々間違えることもありますが、それでも印象的です。アルゴリズムを調整し続けてくださいね!🤓












