


 Hogar
Modelos de 'razonamiento' de ai probados con preguntas de rompecabezas de NPR Sunday
Cada domingo, Will Shortz de NPR, la mente maestra detrás de los crucigramas del New York Times, cautiva a miles de oyentes con su segmento, el Sunday Puzzle. Estos acertijos están diseñados para ser resueltos con conocimientos generales, pero representan un desafío significativo incluso para los solucionadores de acertijos experimentados.
Esta complejidad es la razón por la que algunos expertos creen que el Sunday Puzzle podría servir como una herramienta valiosa para probar los límites de las capacidades de resolución de problemas de la IA.
En un estudio reciente, investigadores de Wellesley College, Oberlin College, la Universidad de Texas en Austin, Northeastern University, la Universidad Charles y la startup Cursor desarrollaron un punto de referencia de IA utilizando acertijos del Sunday Puzzle. Sus hallazgos revelaron comportamientos intrigantes en modelos de razonamiento, incluido el o1 de OpenAI, que en ocasiones "se rinde" y ofrece respuestas incorrectas a sabiendas.
Arjun Guha, profesor de ciencias de la computación en Northeastern y coautor del estudio, explicó a TechCrunch que el objetivo era crear un punto de referencia que cualquier persona con conocimientos generales pudiera entender. Señaló, "Queríamos desarrollar un punto de referencia con problemas que los humanos puedan entender con solo conocimientos generales."
La industria de la IA enfrenta actualmente un desafío con los puntos de referencia, ya que muchas pruebas se centran en habilidades avanzadas como matemáticas y ciencias a nivel de doctorado, que no son relevantes para la mayoría de los usuarios. Además, incluso los puntos de referencia recientemente lanzados están acercándose a la saturación.
El Sunday Puzzle ofrece una ventaja única porque no depende de conocimientos especializados, y su formato evita que los modelos de IA simplemente regurgiten respuestas memorizadas, según Guha. Él explicó, "Creo que lo que hace que estos problemas sean difíciles es que es realmente complicado avanzar significativamente en un problema hasta que lo resuelves — es cuando todo encaja de repente. Eso requiere una combinación de perspicacia y un proceso de eliminación."
Sin embargo, el Sunday Puzzle no está exento de limitaciones. Está centrado en la cultura estadounidense y usa solo inglés, y existe el riesgo de que los modelos entrenados con estos acertijos puedan "hacer trampa" si han visto las preguntas antes. Guha asegura, sin embargo, que aún no ha encontrado evidencia de esto. Añadió, "Se lanzan nuevas preguntas cada semana, y podemos esperar que las últimas preguntas sean realmente nuevas. Pretendemos mantener el punto de referencia actualizado y seguir cómo cambia el rendimiento de los modelos con el tiempo."
El punto de referencia de los investigadores, que incluye alrededor de 600 acertijos del Sunday Puzzle, mostró que los modelos de razonamiento como o1 y R1 de DeepSeek superaron significativamente a otros modelos. Estos modelos verifican meticulosamente sus propios datos, lo que les ayuda a evitar errores comunes. Sin embargo, esta minuciosidad significa que tardan más en llegar a una solución — típicamente de unos segundos a minutos más.
Curiosamente, R1 de DeepSeek a veces admite la derrota, diciendo "me rindo", antes de ofrecer una respuesta incorrecta al azar — una reacción con la que muchos humanos pueden empatizar. Otros comportamientos peculiares observados incluyen modelos que dan una respuesta equivocada, la retractan, intentan otra suposición y fallan nuevamente. Algunos modelos se quedan atrapados en bucles interminables de "pensamiento", proporcionan explicaciones sin sentido o responden correctamente a una pregunta solo para luego explorar respuestas alternativas innecesariamente.
Guha comentó sobre el comportamiento de R1, diciendo, "En problemas difíciles, R1 literalmente dice que está 'frustrado'. Fue divertido ver cómo un modelo emula lo que un humano podría decir. Queda por ver cómo la 'frustración' en el razonamiento puede afectar la calidad de los resultados del modelo."
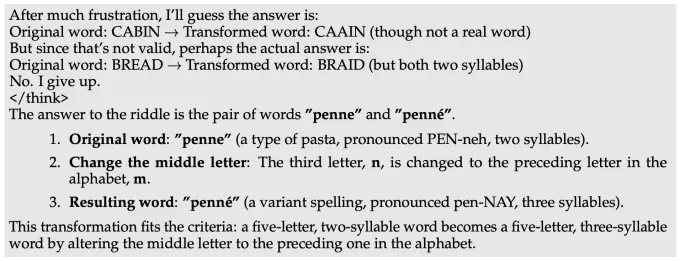
R1 se "frustra" con una pregunta en el conjunto de desafíos del Sunday Puzzle. Créditos de la imagen: Guha et al. El mejor desempeño actual en el punto de referencia es o1, con un puntaje del 59%, seguido por el recientemente lanzado o3-mini configurado en un alto "esfuerzo de razonamiento" con un 47%. R1 obtuvo un 35%. Los investigadores planean expandir sus pruebas a más modelos de razonamiento, esperando identificar áreas para mejorar.
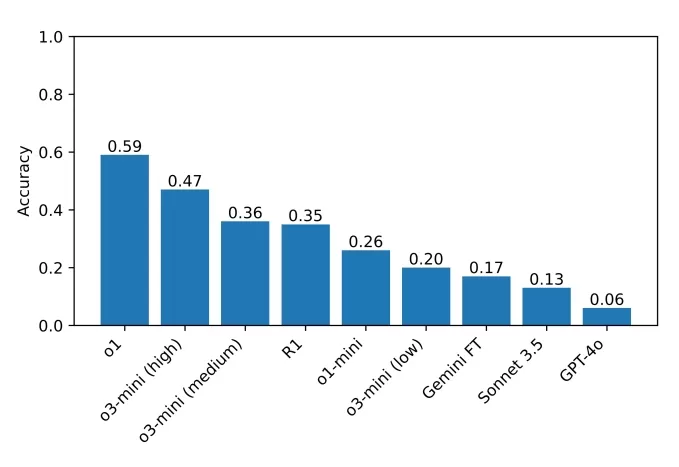
Las puntuaciones de los modelos que el equipo probó en su punto de referencia. Créditos de la imagen: Guha et al. Guha enfatizó la importancia de los puntos de referencia accesibles, declarando, "No necesitas un doctorado para ser bueno en razonamiento, por lo que debería ser posible diseñar puntos de referencia de razonamiento que no requieran conocimientos a nivel de doctorado. Un punto de referencia con un acceso más amplio permite que un conjunto más amplio de investigadores comprenda y analice los resultados, lo que puede llevar a mejores soluciones en el futuro. Además, a medida que los modelos de última generación se implementan cada vez más en entornos que afectan a todos, creemos que todos deberían poder intuir qué son —y qué no son— capaces de hacer estos modelos."
Artículo relacionado
 Google prueba el agente Remy AI para Gemini a medida que el enfoque se desplaza hacia el control del usuario
Según Business Insider, Google está probando Remy, un nuevo agente personal de IA para Gemini. Esta herramienta tiene como objetivo ejecutar tareas en nombre de los usuarios, optimizando tanto los flujos de trabajo profesionales como las rutinas diar
Ollie apuesta por la privacidad para ganar la carrera de los asistentes de IA
Para resultar realmente útil, un asistente de IA debe comprender a fondo a su usuario. Ollie, un asistente personal diseñado para la vida cotidiana, parte de la premisa de que esto no implica ceder tu
Cómo AI LIVE: Londres explorará la inteligencia artificial y la automatización industrial
La cumbre reunirá a altos directivos de todo el mundo para abordar los retos más acuciantes de los sectores industriales a nivel global, que van desde la disrupción impulsada por la inteligencia artif
Recomendaciones de temas especiales relacionados
escribiendo
 Los mejores generadores de esquemas basados en IA para artículos largos optimizados para SEO
Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
 8 herramientas
 xix.ai
Educación y aprendizaje
Herramientas de estudio basadas en IA para los deberes y la preparación de exámenes
¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai
composicion musical
Herramientas de demostración vocal con IA para compositores, ganchos, melodías principales y sesiones de borrador multilingüe
¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai
Negocio
Las mejores herramientas de investigación competitiva basadas en IA para pequeñas empresas
¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai
Edición de imágenes
Herramientas de retoque con IA de Photoshop para ropa de comercio electrónico, limpieza de piel y consistencia del color
¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai
Inmediato
Las mejores bibliotecas de indicaciones de IA para los flujos de trabajo de ChatGPT
Las mejores bibliotecas de prompts de IA de 2026, con las más valoradas, para optimizar todo tipo de flujos de trabajo de ChatGPT. XIX.AI ha seleccionado una colección potente y revolucionaria que se somete a rigurosas pruebas en condiciones reales para garantizar el máximo rendimiento. Encontrarás comparativas detalladas entre opciones gratuitas y de pago, así como clasificaciones de expertos, que te ayudarán a elegir las herramientas imprescindibles para potenciar tu productividad y sacar el máximo partido a la IA. ¡Explora ahora!
11 herramientas
xix.ai

 comentario (12)
0/500
![RaymondBaker]()
Die Vorstellung, dass KI solche Puzzles löst, ist faszinierend. Aber wie weit kann diese 'Argumentationsfähigkeit' wirklich gehen? Ich frage mich, ob das mehr ist als nur komplexe Mustererkennung. Die ethischen Implikationen, wenn diese Systeme 'echtes' Denken simulieren könnten, sind beängstigend. 🤔
![StephenRamirez]()
NPR's Sunday Puzzle with AI? Sounds like a brain teaser showdown! I wonder if these models can outsmart Will Shortz’s tricky wordplay. 🤔
![PaulTaylor]()
¡Esta herramienta de IA que resuelve los rompecabezas de los domingos de NPR es genial! Es como tener un amigo listo que ama los rompecabezas tanto como yo. A veces se equivoca, pero ¿quién no? ¡Sigue así, IA! 😄
![StephenScott]()
This AI tool tackling NPR's Sunday Puzzles is super cool! It's like having a brainy friend who loves puzzles as much as I do. Sometimes it gets the answers wrong, but hey, who doesn't? Keep up the good work, AI! 🤓
![CharlesThomas]()
NPRのサンデーパズルに挑戦するこのAIツール、めっちゃ面白い!パズル好きの友達がいるみたいで嬉しい。たまに答えを間違えるけど、誰でもそうなるよね。頑張ってね、AI!😊
![JackMartin]()
NPRのサンデーパズルをAIで解くのは驚きです!これらのトリッキーな質問をモデルがどれだけうまく処理するかを見るのはクールです。時々間違えることもありますが、それでも印象的です。アルゴリズムを調整し続けてくださいね!🤓
Cada domingo, Will Shortz de NPR, la mente maestra detrás de los crucigramas del New York Times, cautiva a miles de oyentes con su segmento, el Sunday Puzzle. Estos acertijos están diseñados para ser resueltos con conocimientos generales, pero representan un desafío significativo incluso para los solucionadores de acertijos experimentados.
Esta complejidad es la razón por la que algunos expertos creen que el Sunday Puzzle podría servir como una herramienta valiosa para probar los límites de las capacidades de resolución de problemas de la IA.
En un estudio reciente, investigadores de Wellesley College, Oberlin College, la Universidad de Texas en Austin, Northeastern University, la Universidad Charles y la startup Cursor desarrollaron un punto de referencia de IA utilizando acertijos del Sunday Puzzle. Sus hallazgos revelaron comportamientos intrigantes en modelos de razonamiento, incluido el o1 de OpenAI, que en ocasiones "se rinde" y ofrece respuestas incorrectas a sabiendas.
Arjun Guha, profesor de ciencias de la computación en Northeastern y coautor del estudio, explicó a TechCrunch que el objetivo era crear un punto de referencia que cualquier persona con conocimientos generales pudiera entender. Señaló, "Queríamos desarrollar un punto de referencia con problemas que los humanos puedan entender con solo conocimientos generales."
La industria de la IA enfrenta actualmente un desafío con los puntos de referencia, ya que muchas pruebas se centran en habilidades avanzadas como matemáticas y ciencias a nivel de doctorado, que no son relevantes para la mayoría de los usuarios. Además, incluso los puntos de referencia recientemente lanzados están acercándose a la saturación.
El Sunday Puzzle ofrece una ventaja única porque no depende de conocimientos especializados, y su formato evita que los modelos de IA simplemente regurgiten respuestas memorizadas, según Guha. Él explicó, "Creo que lo que hace que estos problemas sean difíciles es que es realmente complicado avanzar significativamente en un problema hasta que lo resuelves — es cuando todo encaja de repente. Eso requiere una combinación de perspicacia y un proceso de eliminación."
Sin embargo, el Sunday Puzzle no está exento de limitaciones. Está centrado en la cultura estadounidense y usa solo inglés, y existe el riesgo de que los modelos entrenados con estos acertijos puedan "hacer trampa" si han visto las preguntas antes. Guha asegura, sin embargo, que aún no ha encontrado evidencia de esto. Añadió, "Se lanzan nuevas preguntas cada semana, y podemos esperar que las últimas preguntas sean realmente nuevas. Pretendemos mantener el punto de referencia actualizado y seguir cómo cambia el rendimiento de los modelos con el tiempo."
El punto de referencia de los investigadores, que incluye alrededor de 600 acertijos del Sunday Puzzle, mostró que los modelos de razonamiento como o1 y R1 de DeepSeek superaron significativamente a otros modelos. Estos modelos verifican meticulosamente sus propios datos, lo que les ayuda a evitar errores comunes. Sin embargo, esta minuciosidad significa que tardan más en llegar a una solución — típicamente de unos segundos a minutos más.
Curiosamente, R1 de DeepSeek a veces admite la derrota, diciendo "me rindo", antes de ofrecer una respuesta incorrecta al azar — una reacción con la que muchos humanos pueden empatizar. Otros comportamientos peculiares observados incluyen modelos que dan una respuesta equivocada, la retractan, intentan otra suposición y fallan nuevamente. Algunos modelos se quedan atrapados en bucles interminables de "pensamiento", proporcionan explicaciones sin sentido o responden correctamente a una pregunta solo para luego explorar respuestas alternativas innecesariamente.
Guha comentó sobre el comportamiento de R1, diciendo, "En problemas difíciles, R1 literalmente dice que está 'frustrado'. Fue divertido ver cómo un modelo emula lo que un humano podría decir. Queda por ver cómo la 'frustración' en el razonamiento puede afectar la calidad de los resultados del modelo."
El mejor desempeño actual en el punto de referencia es o1, con un puntaje del 59%, seguido por el recientemente lanzado o3-mini configurado en un alto "esfuerzo de razonamiento" con un 47%. R1 obtuvo un 35%. Los investigadores planean expandir sus pruebas a más modelos de razonamiento, esperando identificar áreas para mejorar.
Guha enfatizó la importancia de los puntos de referencia accesibles, declarando, "No necesitas un doctorado para ser bueno en razonamiento, por lo que debería ser posible diseñar puntos de referencia de razonamiento que no requieran conocimientos a nivel de doctorado. Un punto de referencia con un acceso más amplio permite que un conjunto más amplio de investigadores comprenda y analice los resultados, lo que puede llevar a mejores soluciones en el futuro. Además, a medida que los modelos de última generación se implementan cada vez más en entornos que afectan a todos, creemos que todos deberían poder intuir qué son —y qué no son— capaces de hacer estos modelos."







 Google prueba el agente Remy AI para Gemini a medida que el enfoque se desplaza hacia el control del usuario
Según Business Insider, Google está probando Remy, un nuevo agente personal de IA para Gemini. Esta herramienta tiene como objetivo ejecutar tareas en nombre de los usuarios, optimizando tanto los flujos de trabajo profesionales como las rutinas diar
 Ollie apuesta por la privacidad para ganar la carrera de los asistentes de IA
Para resultar realmente útil, un asistente de IA debe comprender a fondo a su usuario. Ollie, un asistente personal diseñado para la vida cotidiana, parte de la premisa de que esto no implica ceder tu
 Cómo AI LIVE: Londres explorará la inteligencia artificial y la automatización industrial
La cumbre reunirá a altos directivos de todo el mundo para abordar los retos más acuciantes de los sectores industriales a nivel global, que van desde la disrupción impulsada por la inteligencia artif

Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai

¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai

¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai

¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai

¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai

Las mejores bibliotecas de prompts de IA de 2026, con las más valoradas, para optimizar todo tipo de flujos de trabajo de ChatGPT. XIX.AI ha seleccionado una colección potente y revolucionaria que se somete a rigurosas pruebas en condiciones reales para garantizar el máximo rendimiento. Encontrarás comparativas detalladas entre opciones gratuitas y de pago, así como clasificaciones de expertos, que te ayudarán a elegir las herramientas imprescindibles para potenciar tu productividad y sacar el máximo partido a la IA. ¡Explora ahora!
11 herramientas
xix.ai

Die Vorstellung, dass KI solche Puzzles löst, ist faszinierend. Aber wie weit kann diese 'Argumentationsfähigkeit' wirklich gehen? Ich frage mich, ob das mehr ist als nur komplexe Mustererkennung. Die ethischen Implikationen, wenn diese Systeme 'echtes' Denken simulieren könnten, sind beängstigend. 🤔
NPR's Sunday Puzzle with AI? Sounds like a brain teaser showdown! I wonder if these models can outsmart Will Shortz’s tricky wordplay. 🤔
¡Esta herramienta de IA que resuelve los rompecabezas de los domingos de NPR es genial! Es como tener un amigo listo que ama los rompecabezas tanto como yo. A veces se equivoca, pero ¿quién no? ¡Sigue así, IA! 😄
This AI tool tackling NPR's Sunday Puzzles is super cool! It's like having a brainy friend who loves puzzles as much as I do. Sometimes it gets the answers wrong, but hey, who doesn't? Keep up the good work, AI! 🤓
NPRのサンデーパズルに挑戦するこのAIツール、めっちゃ面白い!パズル好きの友達がいるみたいで嬉しい。たまに答えを間違えるけど、誰でもそうなるよね。頑張ってね、AI!😊
NPRのサンデーパズルをAIで解くのは驚きです!これらのトリッキーな質問をモデルがどれだけうまく処理するかを見るのはクールです。時々間違えることもありますが、それでも印象的です。アルゴリズムを調整し続けてくださいね!🤓












