


 Дом
Плагин vLLM-ATOM от AMD повышает эффективность инференса для локальных крупномасштабных моделей искусственного интеллекта
Компания AMD официально представила плагин vLLM-ATOM, специально разработанный для развертывания крупных языковых моделей. Этот плагин призван значительно повысить производительность инференса популярных отечественных крупных моделей, таких как DeepSeek-R1 и Kimi-K2, на аппаратном обеспечении AMD, при этом не нарушая существующие рабочие процессы.
Как открытая среда инференса, созданная для сценариев с высокой степенью параллелизма, vLLM славится высокой эффективностью использования памяти. Новый плагин от AMD предоставляет более адаптированное решение по оптимизации для графических процессоров серии Instinct, позволяя разработчикам осуществлять техническую миграцию с минимальными затратами на освоение.
Беспроблемное повышение производительности
Основным преимуществом плагина vLLM-ATOM является его «бесплатное» развертывание. Пользователям не требуется модифицировать существующие API или сквозные рабочие процессы. Плагин автоматически управляет и оптимизирует планирование запросов и настройку ядра в фоновом режиме, позволяя текущим сервисам плавно переходить на аппаратную платформу AMD.
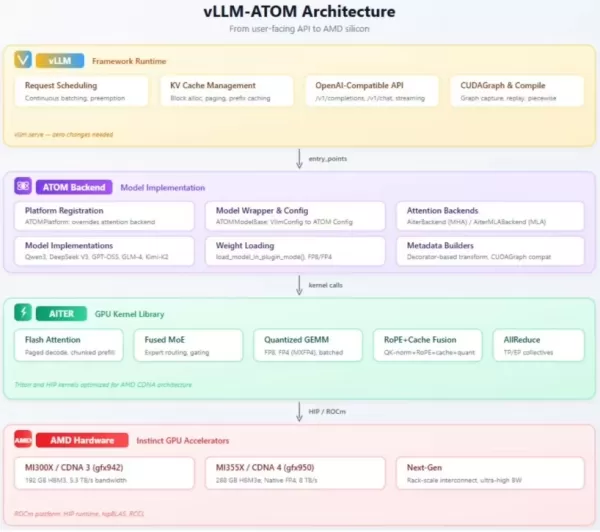
С архитектурной точки зрения плагин состоит из трех уровней: верхний уровень обеспечивает совместимость с интерфейсом OpenAI, средний уровень обрабатывает выполнение и маршрутизацию моделей, а нижний уровень предоставляет основные ядра графического процессора. Такая конструкция эффективно объединяет технологии смеси экспертов (MoE) и квантования, гарантируя надежную поддержку крупномасштабных развертываний.
Широкая совместимость с различными вычислительными экосистемами
Плагин предназначен для высокопроизводительных графических процессоров AMD серий Instinct MI350 и MI400. Он поддерживает не только ведущие китайские большие языковые модели, такие как Qwen3 и GLM, но и всесторонне охватывает разнообразные сценарии применения, включая плотные модели, модели смеси экспертов и модели «зрение-язык» (VLM).
Связанная статья
 Акции США достигли исторической отметки, поскольку гиганты искусственного интеллекта и аэрокосмической отрасли готовятся к дебюту с оценкой в триллион долларов
Илон Маск, Сэм Алтман и Дарио Амодэй, три титана технологического сектора, продвигаются к первичным публичным предложениям акций своих respective компаний. Благодаря SpaceX, OpenAI и Anthropic — трем отраслевым гигантам, чья оценка приближается к три
Шведский стартап в области искусственного интеллекта Lovable Eyes достиг оценки в 13,2 миллиарда долларов после крупного раунда финансирования
По мере того как инструменты для программирования на основе искусственного интеллекта набирают популярность, шведский стартап Lovable привлек крупный раунд финансирования. Компания нацелена на привлечение $3 млрд, что потенциально может увеличить её
Google тестирует агента Remy AI для Gemini по мере смещения фокуса на управление пользователями
Согласно Business Insider, Google тестирует Remy, нового ИИ-персонального агента для Gemini. Этот инструмент предназначен для выполнения задач от имени пользователей, упрощая как профессиональные рабочие процессы, так и повседневные рутины.В настоящ
Рекомендации по связанным специальным темам
Анализ данных
 Лучшие инструменты ИИ для обнаружения аномалий при мониторинге KPI в командах SaaS и электронной коммерции
2026 г. Лучшие новейшие высокооцененные инструменты ИИ для обнаружения аномалий в мониторинге KPI для команд SaaS и электронной коммерции! XIX.AI подготовила мощную, меняющую правила игры коллекцию на основе строгих реальных тестов и еженедельно обновляемых рейтингов. Вы найдете подробные сравнительные данные по бесплатным и платным решениям, которые помогут вам определить обязательное к использованию решение, повышающее производительность и раскрывающее ваш потенциал в области ИИ. Исследуйте сейчас!
 10 инструментов
 xix.ai
письмо
Лучшие генераторы конспектов на базе ИИ для длинных статей, оптимизированных для SEO
2026 год: лучшие и самые высокооцененные генераторы конспектов на базе ИИ для длинных SEO-статей, тщательно отобранные XIX.AI. Эти мощные инструменты обеспечивают революционную помощь в быстром создании высококачественного контента, значительно повышая эффективность написания текстов. Ознакомьтесь со сравнением бесплатных и платных версий, а также с результатами реальных тестов и подробными рейтингами, которые помогут вам найти вариант, который обязательно стоит попробовать и который соответствует вашим потребностям. Изучите их прямо сейчас, чтобы раскрыть весь потенциал ИИ.
8 инструментов
xix.ai
Образование и обучение
Инструменты на базе искусственного интеллекта для выполнения домашних заданий и подготовки к экзаменам
2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai
Музыкальная композиция
Инструменты для создания вокальных демо на основе ИИ для авторов песен, создания хуков, написания тоpline-мелодий и проведения многоязычных черновых сессий
2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai
Бизнес
Лучшие инструменты для анализа конкурентов на основе искусственного интеллекта для малого бизнеса
2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai
Редактирование изображений
Инструменты ИИ-ретуши в Photoshop для электронной коммерции, одежды, очистки кожи и обеспечения цветового единообразия
2026 Latest Best Photoshop AI retouch tools for ecommerce apparel, skin cleanup, and color consistency! This top-rated curated list features powerful game-changing solutions that help you boost writing efficiency, streamline content creation, and achieve perfect visual results effortlessly. Each tool has undergone real-world tests through weekly updated rankings, complete with free vs paid comparison details. Backed by XIX.AI, it’s the must-try guide for anyone aiming to unlock your AI edge. Explore now!
10 инструментов
xix.ai

 Комментарии (0)
Компания AMD официально представила плагин vLLM-ATOM, специально разработанный для развертывания крупных языковых моделей. Этот плагин призван значительно повысить производительность инференса популярных отечественных крупных моделей, таких как DeepSeek-R1 и Kimi-K2, на аппаратном обеспечении AMD, при этом не нарушая существующие рабочие процессы.
Как открытая среда инференса, созданная для сценариев с высокой степенью параллелизма, vLLM славится высокой эффективностью использования памяти. Новый плагин от AMD предоставляет более адаптированное решение по оптимизации для графических процессоров серии Instinct, позволяя разработчикам осуществлять техническую миграцию с минимальными затратами на освоение.
Беспроблемное повышение производительности
Основным преимуществом плагина vLLM-ATOM является его «бесплатное» развертывание. Пользователям не требуется модифицировать существующие API или сквозные рабочие процессы. Плагин автоматически управляет и оптимизирует планирование запросов и настройку ядра в фоновом режиме, позволяя текущим сервисам плавно переходить на аппаратную платформу AMD.
С архитектурной точки зрения плагин состоит из трех уровней: верхний уровень обеспечивает совместимость с интерфейсом OpenAI, средний уровень обрабатывает выполнение и маршрутизацию моделей, а нижний уровень предоставляет основные ядра графического процессора. Такая конструкция эффективно объединяет технологии смеси экспертов (MoE) и квантования, гарантируя надежную поддержку крупномасштабных развертываний.
Широкая совместимость с различными вычислительными экосистемами
Плагин предназначен для высокопроизводительных графических процессоров AMD серий Instinct MI350 и MI400. Он поддерживает не только ведущие китайские большие языковые модели, такие как Qwen3 и GLM, но и всесторонне охватывает разнообразные сценарии применения, включая плотные модели, модели смеси экспертов и модели «зрение-язык» (VLM).








 Акции США достигли исторической отметки, поскольку гиганты искусственного интеллекта и аэрокосмической отрасли готовятся к дебюту с оценкой в триллион долларов
Илон Маск, Сэм Алтман и Дарио Амодэй, три титана технологического сектора, продвигаются к первичным публичным предложениям акций своих respective компаний. Благодаря SpaceX, OpenAI и Anthropic — трем отраслевым гигантам, чья оценка приближается к три
 Шведский стартап в области искусственного интеллекта Lovable Eyes достиг оценки в 13,2 миллиарда долларов после крупного раунда финансирования
По мере того как инструменты для программирования на основе искусственного интеллекта набирают популярность, шведский стартап Lovable привлек крупный раунд финансирования. Компания нацелена на привлечение $3 млрд, что потенциально может увеличить её
Google тестирует агента Remy AI для Gemini по мере смещения фокуса на управление пользователями
Согласно Business Insider, Google тестирует Remy, нового ИИ-персонального агента для Gemini. Этот инструмент предназначен для выполнения задач от имени пользователей, упрощая как профессиональные рабочие процессы, так и повседневные рутины.В настоящ

2026 г. Лучшие новейшие высокооцененные инструменты ИИ для обнаружения аномалий в мониторинге KPI для команд SaaS и электронной коммерции! XIX.AI подготовила мощную, меняющую правила игры коллекцию на основе строгих реальных тестов и еженедельно обновляемых рейтингов. Вы найдете подробные сравнительные данные по бесплатным и платным решениям, которые помогут вам определить обязательное к использованию решение, повышающее производительность и раскрывающее ваш потенциал в области ИИ. Исследуйте сейчас!
10 инструментов
xix.ai

2026 год: лучшие и самые высокооцененные генераторы конспектов на базе ИИ для длинных SEO-статей, тщательно отобранные XIX.AI. Эти мощные инструменты обеспечивают революционную помощь в быстром создании высококачественного контента, значительно повышая эффективность написания текстов. Ознакомьтесь со сравнением бесплатных и платных версий, а также с результатами реальных тестов и подробными рейтингами, которые помогут вам найти вариант, который обязательно стоит попробовать и который соответствует вашим потребностям. Изучите их прямо сейчас, чтобы раскрыть весь потенциал ИИ.
8 инструментов
xix.ai

2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai

2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai

2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai

2026 Latest Best Photoshop AI retouch tools for ecommerce apparel, skin cleanup, and color consistency! This top-rated curated list features powerful game-changing solutions that help you boost writing efficiency, streamline content creation, and achieve perfect visual results effortlessly. Each tool has undergone real-world tests through weekly updated rankings, complete with free vs paid comparison details. Backed by XIX.AI, it’s the must-try guide for anyone aiming to unlock your AI edge. Explore now!
10 инструментов
xix.ai












