


 Heim
Das vLLM-ATOM-Plugin von AMD verbessert die Inferenzleistung bei großen KI-Modellen für den Heimgebrauch
AMD hat das vLLM-ATOM-Plugin offiziell vorgestellt, das speziell für den Einsatz großer Sprachmodelle entwickelt wurde. Dieses Plugin zielt darauf ab, die Inferenzleistung gängiger inländischer Großmodelle wie DeepSeek-R1 und Kimi-K2 auf AMD-Hardware deutlich zu verbessern, ohne dabei bestehende Arbeitsabläufe zu beeinträchtigen.
Als Open-Source-Inferenz-Framework, das für Szenarien mit hoher Parallelität entwickelt wurde, ist vLLM für seine hohe Speichereffizienz bekannt. Das neue Plugin von AMD bietet eine maßgeschneiderte Optimierungslösung für die GPUs der Instinct-Serie und ermöglicht Entwicklern eine technische Migration mit minimalem Lernaufwand.
Nahtlose Leistungssteigerung
Der zentrale Vorteil des vLLM-ATOM-Plugins ist seine „kostenlose“ Bereitstellung. Nutzer müssen ihre bestehenden APIs oder End-to-End-Workflows nicht ändern. Das Plugin verwaltet und optimiert die Anforderungsplanung und die Kernel-Einstellung automatisch im Hintergrund, sodass aktuelle Dienste reibungslos auf das AMD-Hardware-Backend umgestellt werden können.
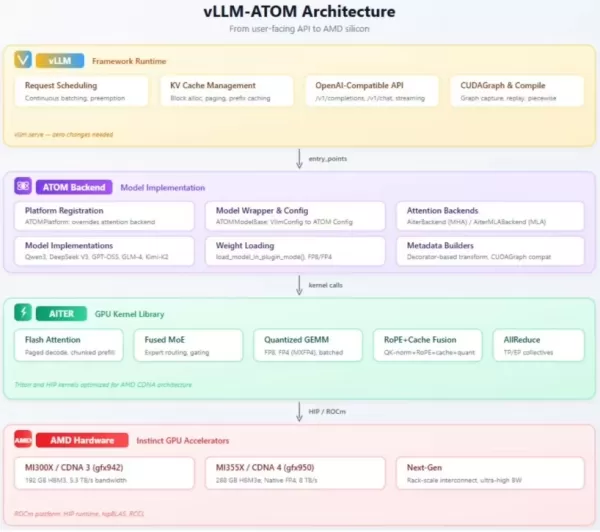
Architektonisch ist das Plugin in drei Schichten gegliedert: Die oberste Schicht gewährleistet die Kompatibilität mit der OpenAI-Schnittstelle, die mittlere Schicht übernimmt die Modellausführung und das Routing, und die unterste Schicht stellt die zentralen GPU-Kernel bereit. Dieses Design integriert auf effektive Weise „Mixture-of-Experts“- (MoE) und Quantisierungstechnologien und garantiert so eine robuste Unterstützung für groß angelegte Bereitstellungen.
Breite Kompatibilität über Rechenökosysteme hinweg
Das Plugin ist auf die Hochleistungs-GPUs der AMD Instinct MI350- und MI400-Serie ausgerichtet. Es unterstützt nicht nur führende chinesische große Sprachmodelle wie Qwen3 und GLM, sondern deckt auch umfassend verschiedene Anwendungsszenarien ab, darunter dichte Modelle, „Mixture-of-Experts“-Modelle und Vision-Language-Modelle (VLMs).
Verwandter Artikel
 So beheben Sie Core Web Vitals für bessere SEO-Rankings
Berichtskartenkommentare mit KI-Tools optimierenEinführungKI-Tools zur Generierung von BerichtskartenkommentarenMagic SchoolAlmanac AIChat GPTNutzung von Magic School zur Generierung von BerichtskartenkommentarenAnmeldung bei Magic SchoolAuswahl des
Slackbot wird zu einem KI-Agenten
Slackbot, der automatisierte Assistent, der in Salesforce’s Unternehmens-Messaging-Plattform Slack integriert ist, entwickelt sich zu einem KI-Agenten. Salesforce-CTO Parker Harris sieht das Potenzial für eine virale Verbreitung, die mit OpenAIs Chat
ByteDance erhöht die Kern-KI-Anreize, während Doubao um 14,6 % steigt
ByteDance hat kürzlich ein Equity-Briefing für DouBao abgehalten, um neue Anreizrichtlinien für Mitarbeiter der DouBao-Sparte vorzustellen. Der Ausübungspreis für DouBao-Anteile wurde von 14,85 US-Dollar im Juni 2026 auf 17,02 US-Dollar angehoben, wa
Empfehlungen zu verwandten Spezialthemen
Bildung und Lernen
 KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung
Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
 10 Tools
 xix.ai
Musikkomposition
KI-Stimm-Demo-Tools für Songwriter, Hooks, Toplines und mehrsprachige Entwurfs-Sessions
2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai
Geschäft
Die besten KI-Tools zur Wettbewerbsanalyse für kleine Unternehmen
Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai
Bildbearbeitung
Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonstanz
2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai
Prompt
Die besten KI-Prompt-Bibliotheken für ChatGPT-Workflows
Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai
Bildung und Lernen
AI Quiz Builder Plattformen für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme
2026 Neueste und beste KI-Quiz-Erstellungstools für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die realen Tests unterzogen wurden, um genaue Rankings zu liefern. Diese unbedingt auszuprobierenden Plattformen helfen dabei, die Schreibeffizienz zu steigern, die Inhaltserstellung zu optimieren und das Quiz-Design in allen Lernszenarien zu vereinfachen. Entdecken Sie jetzt Ihr perfektes Tool, um Ihren KI-Vorteil im Unterricht voll auszuschöpfen!
13 Tools
xix.ai

 Kommentare (0)
AMD hat das vLLM-ATOM-Plugin offiziell vorgestellt, das speziell für den Einsatz großer Sprachmodelle entwickelt wurde. Dieses Plugin zielt darauf ab, die Inferenzleistung gängiger inländischer Großmodelle wie DeepSeek-R1 und Kimi-K2 auf AMD-Hardware deutlich zu verbessern, ohne dabei bestehende Arbeitsabläufe zu beeinträchtigen.
Als Open-Source-Inferenz-Framework, das für Szenarien mit hoher Parallelität entwickelt wurde, ist vLLM für seine hohe Speichereffizienz bekannt. Das neue Plugin von AMD bietet eine maßgeschneiderte Optimierungslösung für die GPUs der Instinct-Serie und ermöglicht Entwicklern eine technische Migration mit minimalem Lernaufwand.
Nahtlose Leistungssteigerung
Der zentrale Vorteil des vLLM-ATOM-Plugins ist seine „kostenlose“ Bereitstellung. Nutzer müssen ihre bestehenden APIs oder End-to-End-Workflows nicht ändern. Das Plugin verwaltet und optimiert die Anforderungsplanung und die Kernel-Einstellung automatisch im Hintergrund, sodass aktuelle Dienste reibungslos auf das AMD-Hardware-Backend umgestellt werden können.
Architektonisch ist das Plugin in drei Schichten gegliedert: Die oberste Schicht gewährleistet die Kompatibilität mit der OpenAI-Schnittstelle, die mittlere Schicht übernimmt die Modellausführung und das Routing, und die unterste Schicht stellt die zentralen GPU-Kernel bereit. Dieses Design integriert auf effektive Weise „Mixture-of-Experts“- (MoE) und Quantisierungstechnologien und garantiert so eine robuste Unterstützung für groß angelegte Bereitstellungen.
Breite Kompatibilität über Rechenökosysteme hinweg
Das Plugin ist auf die Hochleistungs-GPUs der AMD Instinct MI350- und MI400-Serie ausgerichtet. Es unterstützt nicht nur führende chinesische große Sprachmodelle wie Qwen3 und GLM, sondern deckt auch umfassend verschiedene Anwendungsszenarien ab, darunter dichte Modelle, „Mixture-of-Experts“-Modelle und Vision-Language-Modelle (VLMs).








 So beheben Sie Core Web Vitals für bessere SEO-Rankings
Berichtskartenkommentare mit KI-Tools optimierenEinführungKI-Tools zur Generierung von BerichtskartenkommentarenMagic SchoolAlmanac AIChat GPTNutzung von Magic School zur Generierung von BerichtskartenkommentarenAnmeldung bei Magic SchoolAuswahl des
 Slackbot wird zu einem KI-Agenten
Slackbot, der automatisierte Assistent, der in Salesforce’s Unternehmens-Messaging-Plattform Slack integriert ist, entwickelt sich zu einem KI-Agenten. Salesforce-CTO Parker Harris sieht das Potenzial für eine virale Verbreitung, die mit OpenAIs Chat
 ByteDance erhöht die Kern-KI-Anreize, während Doubao um 14,6 % steigt
ByteDance hat kürzlich ein Equity-Briefing für DouBao abgehalten, um neue Anreizrichtlinien für Mitarbeiter der DouBao-Sparte vorzustellen. Der Ausübungspreis für DouBao-Anteile wurde von 14,85 US-Dollar im Juni 2026 auf 17,02 US-Dollar angehoben, wa

Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai

2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai

2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai

2026 Neueste und beste KI-Quiz-Erstellungstools für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die realen Tests unterzogen wurden, um genaue Rankings zu liefern. Diese unbedingt auszuprobierenden Plattformen helfen dabei, die Schreibeffizienz zu steigern, die Inhaltserstellung zu optimieren und das Quiz-Design in allen Lernszenarien zu vereinfachen. Entdecken Sie jetzt Ihr perfektes Tool, um Ihren KI-Vorteil im Unterricht voll auszuschöpfen!
13 Tools
xix.ai












