


 Lar
Revelando modificações sutis, porém impactantes, no conteúdo de vídeo autêntico
Em 2019, um vídeo enganoso de Nancy Pelosi, então Presidente da Câmara dos Representantes dos EUA, circulou amplamente. O vídeo, editado para fazer parecer que ela estava intoxicada, foi um lembrete claro de como a mídia manipulada pode facilmente enganar o público. Apesar de sua simplicidade, esse incidente destacou o potencial dano de edições audiovisuais até mesmo básicas.
Na época, o cenário dos deepfakes era amplamente dominado por tecnologias de substituição facial baseadas em autoencoders, que existiam desde o final de 2017. Esses sistemas iniciais tinham dificuldade em realizar as mudanças sutis vistas no vídeo de Pelosi, focando, em vez disso, em trocas faciais mais evidentes.
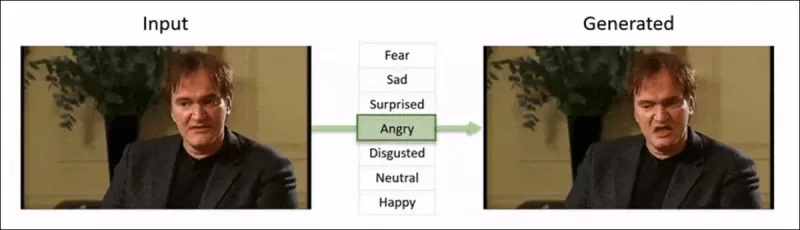 O framework 'Neural Emotion Director' de 2022 altera o humor de um rosto famoso. Fonte: https://www.youtube.com/watch?v=Li6W8pRDMJQ
Avançando para hoje, a indústria de cinema e TV está explorando cada vez mais edições de pós-produção impulsionadas por IA. Essa tendência despertou tanto interesse quanto críticas, pois a IA permite um nível de perfeccionismo anteriormente inatingível. Em resposta, a comunidade de pesquisa desenvolveu vários projetos focados em 'edições locais' de capturas faciais, como Diffusion Video Autoencoders, Stitch it in Time, ChatFace, MagicFace e DISCO.
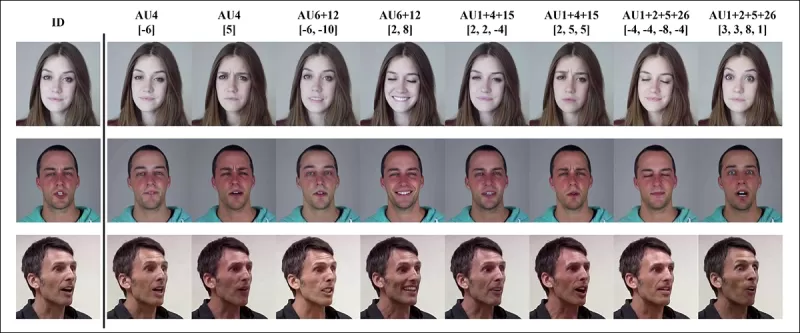 Edição de expressões com o projeto MagicFace de janeiro de 2025. Fonte: https://arxiv.org/pdf/2501.02260
Novos Rostos, Novas Rugas
No entanto, a tecnologia para criar essas edições sutis está avançando muito mais rápido do que nossa capacidade de detectá-las. A maioria dos métodos de detecção de deepfakes está desatualizada, focando em técnicas e conjuntos de dados mais antigos. Isso é, até um recente avanço de pesquisadores na Índia.
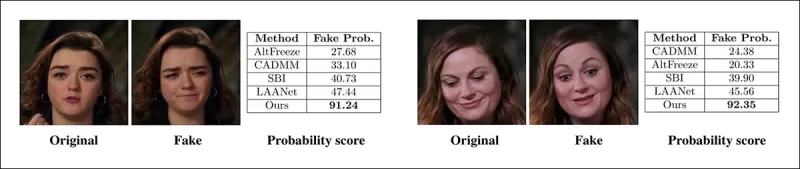 Detecção de Edições Locais Sutis em Deepfakes: Um vídeo real é alterado para produzir falsificações com mudanças sutis, como sobrancelhas levantadas, traços de gênero modificados e mudanças na expressão para desgosto (ilustrado aqui com um único quadro). Fonte: https://arxiv.org/pdf/2503.22121
Esta nova pesquisa visa a detecção de manipulações faciais sutis e localizadas, um tipo de falsificação frequentemente ignorado. Em vez de procurar inconsistências amplas ou incompatibilidades de identidade, o método se concentra em detalhes finos, como mudanças sutis de expressão ou pequenas edições em características faciais específicas. Ele utiliza o Sistema de Codificação de Ação Facial (FACS), que decompõe as expressões faciais em 64 áreas mutáveis.
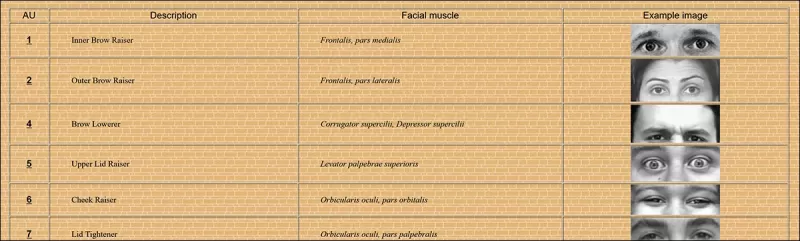 Algumas das 64 partes constituintes das expressões no FACS. Fonte: https://www.cs.cmu.edu/~face/facs.htm
Os pesquisadores testaram sua abordagem contra vários métodos de edição recentes e descobriram que ela superou consistentemente as soluções existentes, mesmo com conjuntos de dados mais antigos e novos vetores de ataque.
‘Ao usar recursos baseados em AU para guiar representações de vídeo aprendidas por meio de Autoencoders Mascarados (MAE), nosso método captura efetivamente mudanças localizadas cruciais para detectar edições faciais sutis.
‘Essa abordagem nos permite construir uma representação latente unificada que codifica tanto edições localizadas quanto alterações mais amplas em vídeos centrados em rostos, fornecendo uma solução abrangente e adaptável para detecção de deepfakes.’
O artigo, intitulado Detectando Manipulações Deepfake Localizadas Usando Representações de Vídeo Guiadas por Unidades de Ação, foi escrito por pesquisadores do Instituto Indiano de Tecnologia em Madras.
Método
O método começa detectando rostos em um vídeo e amostrando quadros espaçados uniformemente centrados nesses rostos. Esses quadros são então divididos em pequenos patches 3D, capturando detalhes espaciais e temporais locais.
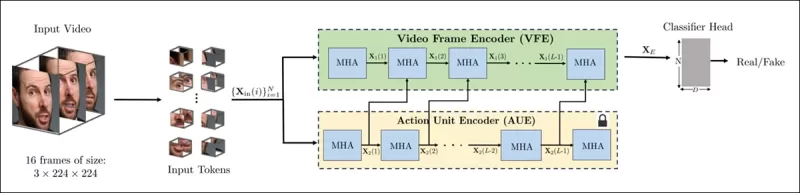 Esquema do novo método. O vídeo de entrada é processado com detecção de rosto para extrair quadros espaçados uniformemente, centrados no rosto, que são então divididos em patches ‘tubulares’ e passados por um codificador que funde representações latentes de duas tarefas de pretexto pré-treinadas. O vetor resultante é então usado por um classificador para determinar se o vídeo é real ou falso.
Cada patch contém uma pequena janela de pixels de alguns quadros sucessivos, permitindo que o modelo aprenda movimentos de curto prazo e mudanças de expressão. Esses patches são incorporados e codificados posicionalmente antes de serem alimentados em um codificador projetado para distinguir vídeos reais de falsos.
O desafio de detectar manipulações sutis é abordado usando um codificador que combina dois tipos de representações aprendidas por meio de um mecanismo de atenção cruzada, visando criar um espaço de características mais sensível e generalizável.
Tarefas de Pretexto
A primeira representação vem de um codificador treinado com uma tarefa de autoencodificação mascarada. Ao ocultar a maior parte dos patches 3D do vídeo, o codificador aprende a reconstruir as partes ausentes, capturando padrões espaço-temporais importantes, como movimentos faciais.
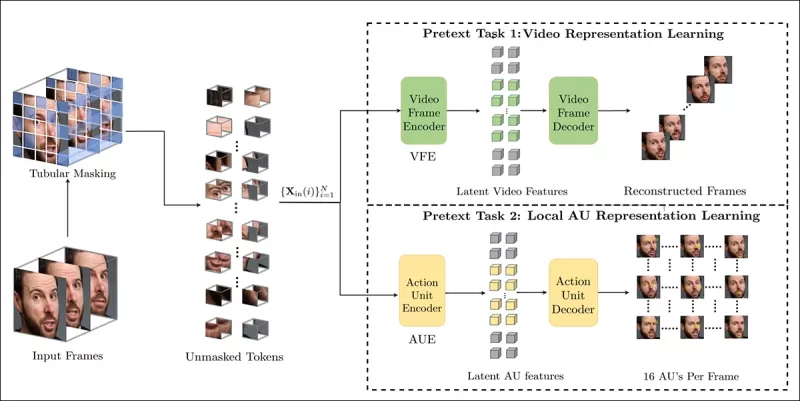 O treinamento de tarefas de pretexto envolve mascarar partes da entrada de vídeo e usar uma configuração de codificador-decodificador para reconstruir os quadros originais ou mapas de unidades de ação por quadro, dependendo da tarefa.
No entanto, isso sozinho não é suficiente para detectar edições detalhadas. Os pesquisadores introduziram um segundo codificador treinado para detectar unidades de ação facial (AUs), incentivando-o a focar na atividade muscular localizada, onde edições sutis de deepfake frequentemente ocorrem.
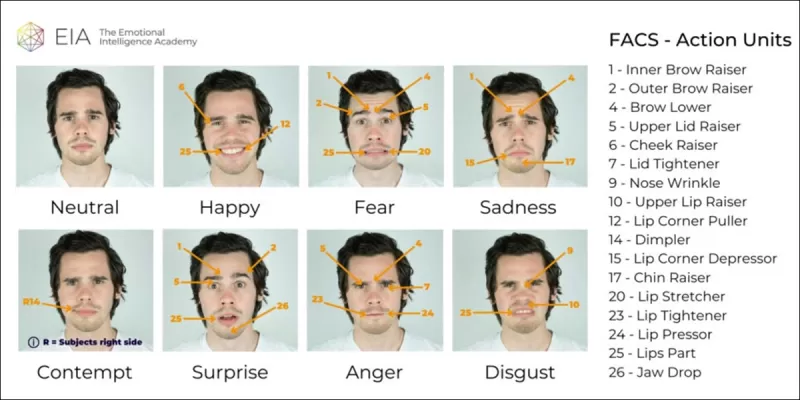 Outros exemplos de Unidades de Ação Facial (FAUs, ou AUs). Fonte: https://www.eiagroup.com/the-facial-action-coding-system/
Após o pré-treinamento, as saídas de ambos os codificadores são combinadas usando atenção cruzada, com os recursos baseados em AU guiando a atenção sobre os recursos espaço-temporais. Isso resulta em uma representação latente fundida que captura tanto o contexto de movimento mais amplo quanto os detalhes de expressão localizados, usada para a tarefa de classificação final.
Dados e Testes
Implementação
O sistema foi implementado usando o framework de detecção de rosto FaceXZoo baseado em PyTorch, extraindo 16 quadros centrados no rosto de cada clipe de vídeo. As tarefas de pretexto foram treinadas no conjunto de dados CelebV-HQ, que inclui 35.000 vídeos faciais de alta qualidade.
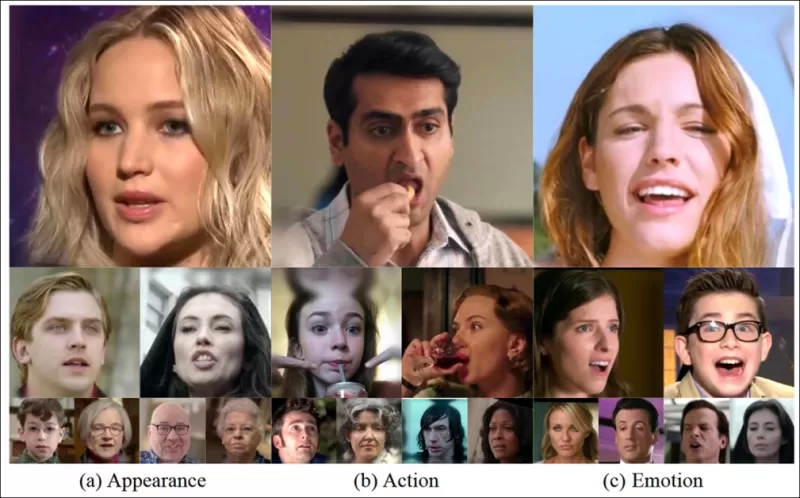 Do artigo original, exemplos do conjunto de dados CelebV-HQ usado no novo projeto. Fonte: https://arxiv.org/pdf/2207.12393
Metade dos dados foi mascarada para evitar overfitting. Para a tarefa de reconstrução de quadros mascarados, o modelo foi treinado para prever regiões ausentes usando perda L1. Para a segunda tarefa, ele foi treinado para gerar mapas para 16 unidades de ação facial, supervisionado por perda L1.
Após o pré-treinamento, os codificadores foram fundidos e ajustados para detecção de deepfakes usando o conjunto de dados FaceForensics++, que inclui vídeos reais e manipulados.
 O conjunto de dados FaceForensics++ tem sido a pedra angular da detecção de deepfakes desde 2017, embora agora esteja consideravelmente desatualizado em relação às mais recentes técnicas de síntese facial. Fonte: https://www.youtube.com/watch?v=x2g48Q2I2ZQ
Para abordar o desequilíbrio de classes, os autores usaram a Perda Focal, enfatizando exemplos mais desafiadores durante o treinamento. Todo o treinamento foi conduzido em uma única GPU RTX 4090 com 24Gb de VRAM, usando pontos de verificação pré-treinados do VideoMAE.
Testes
O método foi avaliado contra várias técnicas de detecção de deepfakes, focando em deepfakes editados localmente. Os testes incluíram uma gama de métodos de edição e conjuntos de dados de deepfakes mais antigos, usando métricas como Área Sob a Curva (AUC), Precisão Média e Pontuação F1 Média.
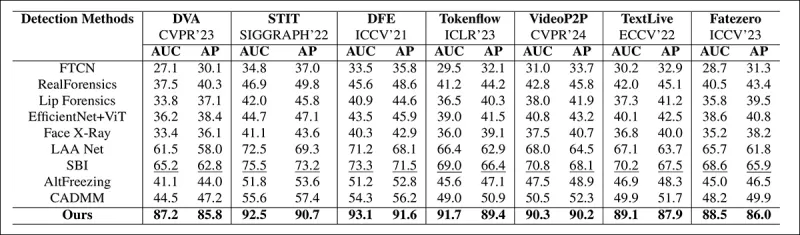 Do artigo: a comparação em deepfakes localizados recentes mostra que o método proposto superou todos os outros, com um ganho de 15 a 20 por cento em AUC e precisão média em relação à próxima melhor abordagem.
Os autores forneceram comparações visuais de vídeos manipulados localmente, mostrando a sensibilidade superior do método a edições sutis.
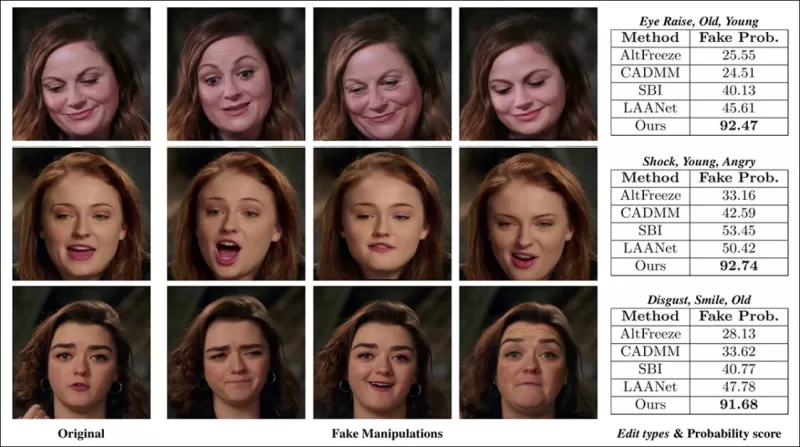 Um vídeo real foi alterado usando três manipulações locais diferentes para produzir falsificações que permaneceram visualmente semelhantes ao original. Mostrados aqui estão quadros representativos junto com as pontuações médias de detecção de falsificações para cada método. Enquanto os detectores existentes tiveram dificuldade com essas edições sutis, o modelo proposto consistentemente atribuiu altas probabilidades de falsificação, indicando maior sensibilidade a mudanças localizadas.
Os pesquisadores observaram que os métodos de detecção de ponta existentes tiveram dificuldade com as mais recentes técnicas de geração de deepfakes, enquanto seu método demonstrou generalização robusta, alcançando altas pontuações de AUC e precisão média.
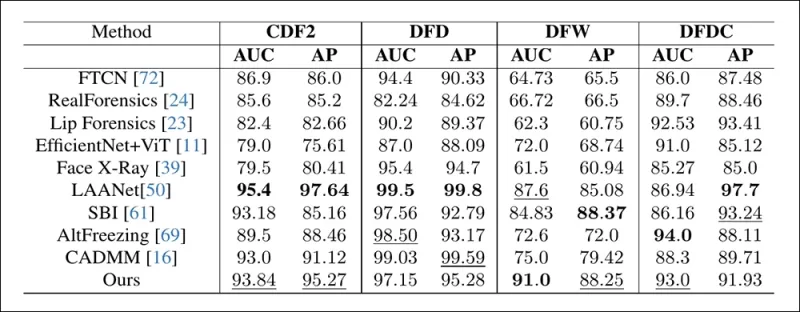 O desempenho em conjuntos de dados de deepfakes tradicionais mostra que o método proposto permaneceu competitivo com as principais abordagens, indicando forte generalização em uma gama de tipos de manipulação.
Os autores também testaram a confiabilidade do modelo sob condições do mundo real, descobrindo que ele é resiliente a distorções de vídeo comuns, como ajustes de saturação, desfoque gaussiano e pixelização.
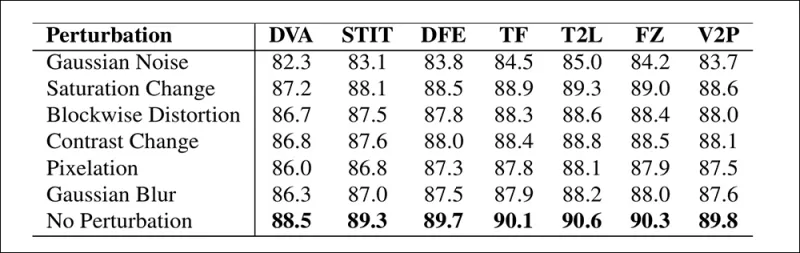 Uma ilustração de como a precisão de detecção muda sob diferentes distorções de vídeo. O novo método permaneceu resiliente na maioria dos casos, com apenas um pequeno declínio em AUC. A queda mais significativa ocorreu quando o ruído gaussiano foi introduzido.
Conclusão
Embora o público frequentemente pense em deepfakes como trocas de identidade, a realidade da manipulação por IA é mais matizada e potencialmente mais insidiosa. O tipo de edição local discutido nesta nova pesquisa pode não capturar a atenção do público até que outro incidente de alto perfil ocorra. No entanto, como o ator Nic Cage apontou, o potencial para edições de pós-produção alterarem desempenhos é uma preocupação que todos devemos estar cientes. Somos naturalmente sensíveis até mesmo às menores mudanças nas expressões faciais, e o contexto pode alterar dramaticamente seu impacto.
Publicado pela primeira vez na quarta-feira, 2 de abril de 2025
Artigo relacionado
 A OpenAI simplifica a verificação de imagens geradas por IA
À medida que os geradores de imagens por IA se tornam cada vez mais difundidos e sofisticados na internet, distinguir imagens reais das falsas nunca foi tão desafiador. Na terça-feira, a OpenAI divulg
O YouTube amplia a detecção de deepfakes por IA para políticos, autoridades governamentais e jornalistas
Na terça-feira, o YouTube anunciou que está expandindo sua tecnologia de detecção de deepfakes para um grupo seleto de autoridades governamentais, candidatos políticos e jornalistas. A ferramenta iden
O YouTube reforça as proteções contra deepfakes baseadas em IA para políticos, autoridades e jornalistas
O YouTube está ampliando o acesso à sua tecnologia de detecção de imagens com semelhança, projetada para identificar deepfakes gerados por IA, para um programa piloto destinado a autoridades govername
Recomendações de tópicos especiais relacionados
escrita
 Os melhores geradores de esboços com IA para artigos longos de SEO
Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
 8 ferramentas
 xix.ai
Educação e Aprendizagem
Ferramentas de IA para os deveres de casa e a preparação para provas
As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai
Composição musical
Ferramentas de Demonstração Vocal com IA para Compositores, Ganchos, Toplines e Sessões de Rascunho Multilíngues
2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai
Negócios
As melhores ferramentas de pesquisa competitiva baseadas em IA para pequenas empresas
As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai
Edição de imagem
Ferramentas de Retoque com IA do Photoshop para Moda E-commerce, Limpeza de Pele e Consistência de Cor
2026 Últimas Melhores Ferramentas de Retoque com IA do Photoshop para roupas de comércio eletrônico, limpeza de pele e consistência de cores! Esta lista curada de alta classificação apresenta soluções poderosas que mudam o jogo, ajudando você a aumentar a eficiência da escrita, simplificar a criação de conteúdo e obter resultados visuais perfeitos sem esforço. Cada ferramenta passou por testes do mundo real através de classificações atualizadas semanalmente, com detalhes completos sobre comparação entre gratuito e pago. Com o apoio da XIX.AI, é o guia essencial para quem deseja desbloquear sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai
Incitar
As melhores bibliotecas de prompts de IA para fluxos de trabalho do ChatGPT
As melhores e mais bem avaliadas bibliotecas de prompts de IA de 2026 para otimizar todos os tipos de fluxos de trabalho do ChatGPT. A XIX.AI selecionou uma coleção poderosa e revolucionária, submetida a rigorosos testes no mundo real para garantir o máximo desempenho. Você encontra comparações detalhadas entre opções gratuitas e pagas, além de classificações de especialistas, para ajudá-lo a escolher as ferramentas indispensáveis que aumentam sua produtividade e potencializam suas vantagens em IA. Explore agora!
11 ferramentas
xix.ai

 Comentários (47)
![CarlPerez]()
Honestly, the Pelosi incident still gives me chills. It's not just deepfakes; even simple speed changes can distort reality. We need better tools to detect these manipulations. 🧐
![RalphMitchell]()
この記事を読んで、AIによる映像改ざんがこんなに簡単にできるなんて怖いですね。ペロシ議長の例は氷山の一角で、もっと巧妙な偽動画がSNSで拡散される可能性があります。一般ユーザーとして、どうやって本物と偽物を見分ければいいのか悩みます。技術の進歩は素晴らしいけど、悪用されないための規制も必要じゃないかな🤔
![JustinHarris]()
Honestly, this Pelosi video case is a perfect example of how 'low-tech' AI manipulation can be the most dangerous. It doesn't need deepfakes; just slowing down footage creates a narrative. Makes you wonder what subtle edits we're already consuming daily without a second thought. The real battle for truth is in these tiny, almost invisible tweaks. 😳
![DavidRodriguez]()
Dieser Artikel erinnert mich daran, wie wichtig Medienkompetenz heute ist. Die Pelosi-Video-Manipulation war ja noch relativ plump, aber mit aktueller KI wird das bestimmt viel subtiler. Macht mir schon etwas Sorgen, vor Wahlen oder so. Wie soll man da noch zwischen echt und fake unterscheiden? 😕
![WilliamCarter]()
That Pelosi video from 2019 is wild! It’s scary how a few tweaks can make someone look totally drunk. AI’s power to mess with videos is both cool and creepy—makes you wonder what’s real anymore. 😬
![JuanMartínez]()
This Pelosi video incident is wild! 🤯 It’s scary how a few tweaks can make someone look totally out of it. Makes me wonder how much of what we see online is real anymore. AI’s cool, but this kind of stuff could mess with trust big time.
Em 2019, um vídeo enganoso de Nancy Pelosi, então Presidente da Câmara dos Representantes dos EUA, circulou amplamente. O vídeo, editado para fazer parecer que ela estava intoxicada, foi um lembrete claro de como a mídia manipulada pode facilmente enganar o público. Apesar de sua simplicidade, esse incidente destacou o potencial dano de edições audiovisuais até mesmo básicas.
Na época, o cenário dos deepfakes era amplamente dominado por tecnologias de substituição facial baseadas em autoencoders, que existiam desde o final de 2017. Esses sistemas iniciais tinham dificuldade em realizar as mudanças sutis vistas no vídeo de Pelosi, focando, em vez disso, em trocas faciais mais evidentes.
O framework 'Neural Emotion Director' de 2022 altera o humor de um rosto famoso. Fonte: https://www.youtube.com/watch?v=Li6W8pRDMJQ
Avançando para hoje, a indústria de cinema e TV está explorando cada vez mais edições de pós-produção impulsionadas por IA. Essa tendência despertou tanto interesse quanto críticas, pois a IA permite um nível de perfeccionismo anteriormente inatingível. Em resposta, a comunidade de pesquisa desenvolveu vários projetos focados em 'edições locais' de capturas faciais, como Diffusion Video Autoencoders, Stitch it in Time, ChatFace, MagicFace e DISCO.
Edição de expressões com o projeto MagicFace de janeiro de 2025. Fonte: https://arxiv.org/pdf/2501.02260
Novos Rostos, Novas Rugas
No entanto, a tecnologia para criar essas edições sutis está avançando muito mais rápido do que nossa capacidade de detectá-las. A maioria dos métodos de detecção de deepfakes está desatualizada, focando em técnicas e conjuntos de dados mais antigos. Isso é, até um recente avanço de pesquisadores na Índia.
Detecção de Edições Locais Sutis em Deepfakes: Um vídeo real é alterado para produzir falsificações com mudanças sutis, como sobrancelhas levantadas, traços de gênero modificados e mudanças na expressão para desgosto (ilustrado aqui com um único quadro). Fonte: https://arxiv.org/pdf/2503.22121
Esta nova pesquisa visa a detecção de manipulações faciais sutis e localizadas, um tipo de falsificação frequentemente ignorado. Em vez de procurar inconsistências amplas ou incompatibilidades de identidade, o método se concentra em detalhes finos, como mudanças sutis de expressão ou pequenas edições em características faciais específicas. Ele utiliza o Sistema de Codificação de Ação Facial (FACS), que decompõe as expressões faciais em 64 áreas mutáveis.
Algumas das 64 partes constituintes das expressões no FACS. Fonte: https://www.cs.cmu.edu/~face/facs.htm
Os pesquisadores testaram sua abordagem contra vários métodos de edição recentes e descobriram que ela superou consistentemente as soluções existentes, mesmo com conjuntos de dados mais antigos e novos vetores de ataque.
‘Ao usar recursos baseados em AU para guiar representações de vídeo aprendidas por meio de Autoencoders Mascarados (MAE), nosso método captura efetivamente mudanças localizadas cruciais para detectar edições faciais sutis.
‘Essa abordagem nos permite construir uma representação latente unificada que codifica tanto edições localizadas quanto alterações mais amplas em vídeos centrados em rostos, fornecendo uma solução abrangente e adaptável para detecção de deepfakes.’
O artigo, intitulado Detectando Manipulações Deepfake Localizadas Usando Representações de Vídeo Guiadas por Unidades de Ação, foi escrito por pesquisadores do Instituto Indiano de Tecnologia em Madras.
Método
O método começa detectando rostos em um vídeo e amostrando quadros espaçados uniformemente centrados nesses rostos. Esses quadros são então divididos em pequenos patches 3D, capturando detalhes espaciais e temporais locais.
Esquema do novo método. O vídeo de entrada é processado com detecção de rosto para extrair quadros espaçados uniformemente, centrados no rosto, que são então divididos em patches ‘tubulares’ e passados por um codificador que funde representações latentes de duas tarefas de pretexto pré-treinadas. O vetor resultante é então usado por um classificador para determinar se o vídeo é real ou falso.
Cada patch contém uma pequena janela de pixels de alguns quadros sucessivos, permitindo que o modelo aprenda movimentos de curto prazo e mudanças de expressão. Esses patches são incorporados e codificados posicionalmente antes de serem alimentados em um codificador projetado para distinguir vídeos reais de falsos.
O desafio de detectar manipulações sutis é abordado usando um codificador que combina dois tipos de representações aprendidas por meio de um mecanismo de atenção cruzada, visando criar um espaço de características mais sensível e generalizável.
Tarefas de Pretexto
A primeira representação vem de um codificador treinado com uma tarefa de autoencodificação mascarada. Ao ocultar a maior parte dos patches 3D do vídeo, o codificador aprende a reconstruir as partes ausentes, capturando padrões espaço-temporais importantes, como movimentos faciais.
O treinamento de tarefas de pretexto envolve mascarar partes da entrada de vídeo e usar uma configuração de codificador-decodificador para reconstruir os quadros originais ou mapas de unidades de ação por quadro, dependendo da tarefa.
No entanto, isso sozinho não é suficiente para detectar edições detalhadas. Os pesquisadores introduziram um segundo codificador treinado para detectar unidades de ação facial (AUs), incentivando-o a focar na atividade muscular localizada, onde edições sutis de deepfake frequentemente ocorrem.
Outros exemplos de Unidades de Ação Facial (FAUs, ou AUs). Fonte: https://www.eiagroup.com/the-facial-action-coding-system/
Após o pré-treinamento, as saídas de ambos os codificadores são combinadas usando atenção cruzada, com os recursos baseados em AU guiando a atenção sobre os recursos espaço-temporais. Isso resulta em uma representação latente fundida que captura tanto o contexto de movimento mais amplo quanto os detalhes de expressão localizados, usada para a tarefa de classificação final.
Dados e Testes
Implementação
O sistema foi implementado usando o framework de detecção de rosto FaceXZoo baseado em PyTorch, extraindo 16 quadros centrados no rosto de cada clipe de vídeo. As tarefas de pretexto foram treinadas no conjunto de dados CelebV-HQ, que inclui 35.000 vídeos faciais de alta qualidade.
Do artigo original, exemplos do conjunto de dados CelebV-HQ usado no novo projeto. Fonte: https://arxiv.org/pdf/2207.12393
Metade dos dados foi mascarada para evitar overfitting. Para a tarefa de reconstrução de quadros mascarados, o modelo foi treinado para prever regiões ausentes usando perda L1. Para a segunda tarefa, ele foi treinado para gerar mapas para 16 unidades de ação facial, supervisionado por perda L1.
Após o pré-treinamento, os codificadores foram fundidos e ajustados para detecção de deepfakes usando o conjunto de dados FaceForensics++, que inclui vídeos reais e manipulados.
O conjunto de dados FaceForensics++ tem sido a pedra angular da detecção de deepfakes desde 2017, embora agora esteja consideravelmente desatualizado em relação às mais recentes técnicas de síntese facial. Fonte: https://www.youtube.com/watch?v=x2g48Q2I2ZQ
Para abordar o desequilíbrio de classes, os autores usaram a Perda Focal, enfatizando exemplos mais desafiadores durante o treinamento. Todo o treinamento foi conduzido em uma única GPU RTX 4090 com 24Gb de VRAM, usando pontos de verificação pré-treinados do VideoMAE.
Testes
O método foi avaliado contra várias técnicas de detecção de deepfakes, focando em deepfakes editados localmente. Os testes incluíram uma gama de métodos de edição e conjuntos de dados de deepfakes mais antigos, usando métricas como Área Sob a Curva (AUC), Precisão Média e Pontuação F1 Média.
Do artigo: a comparação em deepfakes localizados recentes mostra que o método proposto superou todos os outros, com um ganho de 15 a 20 por cento em AUC e precisão média em relação à próxima melhor abordagem.
Os autores forneceram comparações visuais de vídeos manipulados localmente, mostrando a sensibilidade superior do método a edições sutis.
Um vídeo real foi alterado usando três manipulações locais diferentes para produzir falsificações que permaneceram visualmente semelhantes ao original. Mostrados aqui estão quadros representativos junto com as pontuações médias de detecção de falsificações para cada método. Enquanto os detectores existentes tiveram dificuldade com essas edições sutis, o modelo proposto consistentemente atribuiu altas probabilidades de falsificação, indicando maior sensibilidade a mudanças localizadas.
Os pesquisadores observaram que os métodos de detecção de ponta existentes tiveram dificuldade com as mais recentes técnicas de geração de deepfakes, enquanto seu método demonstrou generalização robusta, alcançando altas pontuações de AUC e precisão média.
O desempenho em conjuntos de dados de deepfakes tradicionais mostra que o método proposto permaneceu competitivo com as principais abordagens, indicando forte generalização em uma gama de tipos de manipulação.
Os autores também testaram a confiabilidade do modelo sob condições do mundo real, descobrindo que ele é resiliente a distorções de vídeo comuns, como ajustes de saturação, desfoque gaussiano e pixelização.
Uma ilustração de como a precisão de detecção muda sob diferentes distorções de vídeo. O novo método permaneceu resiliente na maioria dos casos, com apenas um pequeno declínio em AUC. A queda mais significativa ocorreu quando o ruído gaussiano foi introduzido.
Conclusão
Embora o público frequentemente pense em deepfakes como trocas de identidade, a realidade da manipulação por IA é mais matizada e potencialmente mais insidiosa. O tipo de edição local discutido nesta nova pesquisa pode não capturar a atenção do público até que outro incidente de alto perfil ocorra. No entanto, como o ator Nic Cage apontou, o potencial para edições de pós-produção alterarem desempenhos é uma preocupação que todos devemos estar cientes. Somos naturalmente sensíveis até mesmo às menores mudanças nas expressões faciais, e o contexto pode alterar dramaticamente seu impacto.
Publicado pela primeira vez na quarta-feira, 2 de abril de 2025








 A OpenAI simplifica a verificação de imagens geradas por IA
À medida que os geradores de imagens por IA se tornam cada vez mais difundidos e sofisticados na internet, distinguir imagens reais das falsas nunca foi tão desafiador. Na terça-feira, a OpenAI divulg
 O YouTube amplia a detecção de deepfakes por IA para políticos, autoridades governamentais e jornalistas
Na terça-feira, o YouTube anunciou que está expandindo sua tecnologia de detecção de deepfakes para um grupo seleto de autoridades governamentais, candidatos políticos e jornalistas. A ferramenta iden
 O YouTube reforça as proteções contra deepfakes baseadas em IA para políticos, autoridades e jornalistas
O YouTube está ampliando o acesso à sua tecnologia de detecção de imagens com semelhança, projetada para identificar deepfakes gerados por IA, para um programa piloto destinado a autoridades govername

Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai

As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Retoque com IA do Photoshop para roupas de comércio eletrônico, limpeza de pele e consistência de cores! Esta lista curada de alta classificação apresenta soluções poderosas que mudam o jogo, ajudando você a aumentar a eficiência da escrita, simplificar a criação de conteúdo e obter resultados visuais perfeitos sem esforço. Cada ferramenta passou por testes do mundo real através de classificações atualizadas semanalmente, com detalhes completos sobre comparação entre gratuito e pago. Com o apoio da XIX.AI, é o guia essencial para quem deseja desbloquear sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas bibliotecas de prompts de IA de 2026 para otimizar todos os tipos de fluxos de trabalho do ChatGPT. A XIX.AI selecionou uma coleção poderosa e revolucionária, submetida a rigorosos testes no mundo real para garantir o máximo desempenho. Você encontra comparações detalhadas entre opções gratuitas e pagas, além de classificações de especialistas, para ajudá-lo a escolher as ferramentas indispensáveis que aumentam sua produtividade e potencializam suas vantagens em IA. Explore agora!
11 ferramentas
xix.ai

Honestly, the Pelosi incident still gives me chills. It's not just deepfakes; even simple speed changes can distort reality. We need better tools to detect these manipulations. 🧐
この記事を読んで、AIによる映像改ざんがこんなに簡単にできるなんて怖いですね。ペロシ議長の例は氷山の一角で、もっと巧妙な偽動画がSNSで拡散される可能性があります。一般ユーザーとして、どうやって本物と偽物を見分ければいいのか悩みます。技術の進歩は素晴らしいけど、悪用されないための規制も必要じゃないかな🤔
Honestly, this Pelosi video case is a perfect example of how 'low-tech' AI manipulation can be the most dangerous. It doesn't need deepfakes; just slowing down footage creates a narrative. Makes you wonder what subtle edits we're already consuming daily without a second thought. The real battle for truth is in these tiny, almost invisible tweaks. 😳
Dieser Artikel erinnert mich daran, wie wichtig Medienkompetenz heute ist. Die Pelosi-Video-Manipulation war ja noch relativ plump, aber mit aktueller KI wird das bestimmt viel subtiler. Macht mir schon etwas Sorgen, vor Wahlen oder so. Wie soll man da noch zwischen echt und fake unterscheiden? 😕
That Pelosi video from 2019 is wild! It’s scary how a few tweaks can make someone look totally drunk. AI’s power to mess with videos is both cool and creepy—makes you wonder what’s real anymore. 😬
This Pelosi video incident is wild! 🤯 It’s scary how a few tweaks can make someone look totally out of it. Makes me wonder how much of what we see online is real anymore. AI’s cool, but this kind of stuff could mess with trust big time.












