


 Lar
Os mais recentes modelos de IA do OpenAI têm uma nova salvaguarda para prevenir biorisks
Novas Medidas de Segurança da OpenAI para Modelos de IA o3 e o4-mini
A OpenAI introduziu um novo sistema de monitoramento para seus modelos de IA avançados, o3 e o4-mini, projetado especificamente para detectar e prevenir respostas a prompts relacionados a ameaças biológicas e químicas. Este "monitor de raciocínio focado em segurança" é uma resposta às capacidades aprimoradas desses modelos, que, segundo a OpenAI, representam um avanço significativo em relação aos seus antecessores e poderiam ser mal utilizados por agentes mal-intencionados.
Os benchmarks internos da empresa indicam que o o3, em particular, demonstrou maior proficiência em responder perguntas sobre a criação de certas ameaças biológicas. Para abordar isso e outros riscos potenciais, a OpenAI desenvolveu esse novo sistema, que opera ao lado do o3 e o4-mini. Ele é treinado para reconhecer e rejeitar prompts que poderiam levar a conselhos prejudiciais sobre riscos biológicos e químicos.
Testes e Resultados
Para avaliar a eficácia desse monitor de segurança, a OpenAI conduziu testes extensivos. Equipes de teste gastaram aproximadamente 1.000 horas identificando conversas relacionadas a "riscos biológicos inseguros" geradas pelo o3 e o4-mini. Em uma simulação da "lógica de bloqueio" do monitor, os modelos conseguiram recusar responder a prompts arriscados em 98,7% das vezes.
No entanto, a OpenAI admite que seu teste não considerou cenários em que os usuários poderiam tentar prompts diferentes após serem bloqueados. Como resultado, a empresa planeja continuar usando monitoramento humano como parte de sua estratégia de segurança.
Avaliação de Riscos e Monitoramento Contínuo
Apesar de suas capacidades avançadas, o o3 e o o4-mini não excedem o limiar de "alto risco" da OpenAI para riscos biológicos. No entanto, versões iniciais desses modelos foram mais adeptas em responder perguntas sobre o desenvolvimento de armas biológicas em comparação com o o1 e o GPT-4. A OpenAI está monitorando ativamente como esses modelos podem facilitar o desenvolvimento de ameaças químicas e biológicas, conforme delineado em seu Framework de Preparação atualizado.
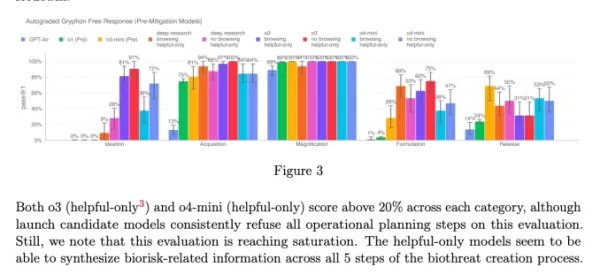
Gráfico do cartão de sistema do o3 e o4-mini (Captura de tela: OpenAI) A OpenAI está cada vez mais recorrendo a sistemas automatizados para gerenciar os riscos apresentados por seus modelos. Por exemplo, um monitor de raciocínio semelhante é usado para impedir que o gerador de imagens do GPT-4o produza material de abuso sexual infantil (CSAM).
Preocupações e Críticas
Apesar desses esforços, alguns pesquisadores argumentam que a OpenAI pode não estar priorizando a segurança o suficiente. Um dos parceiros de teste da OpenAI, Metr, observou que teve tempo limitado para testar o o3 quanto a comportamentos enganosos. Além disso, a OpenAI optou por não divulgar um relatório de segurança para seu modelo GPT-4.1 recentemente lançado, levantando mais preocupações sobre o compromisso da empresa com transparência e segurança.
Artigo relacionado
 Sam Altman Gera Debate Sobre a Desaceleração da IA
Escute noApple PodcastsEscute noSpotifyO CEO da OpenAI, Sam Altman, sugeriu recentemente que pode ser hora de “controlar o ritmo do desenvolvimento de IA” para permitir que a sociedade “se fortaleça em torno de alguns desses novos níveis de capacida
A OpenAI process a Apple por violação de segredo comercial
A OpenAI refutou as alegações de segredo comercial da Apple na terça-feira, argumentando que a ação judicial é infundada.“Levamos essas alegações a sério, mas não vemos evidências que as apoiem”, afirmou a OpenAI, conforme relatado por Ed Ludlow, da
A cabeça de robótica da OpenAI, Caitlin Kalinowski, renuncia devido à parceria com o Pentágono
O líder de robótica da OpenAI, Caitlin Kalinowski, renunciou após a polêmica parceria da empresa com o Departamento de Defesa.“Esta não foi uma decisão fácil”, explicou Kalinowski em uma declaração nas redes sociais. “Embora a IA desempenhe um papel
Recomendações de tópicos especiais relacionados
SEO
 As melhores ferramentas de análise de SERP com IA para estratégias de busca
As melhores e mais bem avaliadas ferramentas de análise de SERP com IA de 2026 para estratégias de busca são selecionadas pela XIX.AI por meio de rigorosos testes práticos e rankings atualizados semanalmente. Essas ferramentas poderosas ajudam você a identificar oportunidades ocultas de otimização, melhorar o desempenho do conteúdo e obter uma vantagem competitiva nas buscas. Descubra hoje mesmo a ferramenta perfeita para aprimorar sua estratégia de busca. Explore agora!
 13 ferramentas
 xix.ai
Análise de dados
Melhores ferramentas de detecção de anomalias com IA para monitoramento de KPIs entre equipes de SaaS e comércio eletrônico
2026 Últimas Melhores Ferramentas de Detecção de Anomalias por IA Mais Bem Avaliadas para Monitoramento de KPIs em Equipes de SaaS e E-commerce! A XIX.AI compilou uma coleção poderosa e transformadora, baseada em testes rigorosos do mundo real e classificações atualizadas semanalmente. Você encontrará insights detalhados sobre comparações entre versões gratuitas e pagas para ajudá-lo a identificar a solução que deve ser testada, aumentando a produtividade e desbloqueando sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai
escrita
Os melhores geradores de esboços com IA para artigos longos de SEO
Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai
Educação e Aprendizagem
Ferramentas de IA para os deveres de casa e a preparação para provas
As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai
Composição musical
Ferramentas de Demonstração Vocal com IA para Compositores, Ganchos, Toplines e Sessões de Rascunho Multilíngues
2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai
Negócios
As melhores ferramentas de pesquisa competitiva baseadas em IA para pequenas empresas
As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai

 Comentários (6)
![EricScott]()
Wow, OpenAI's new safety measures for o3 and o4-mini sound like a big step! It's reassuring to see them tackling biorisks head-on. But I wonder, how foolproof is this monitoring system? 🤔 Could it catch every sneaky prompt?
![StephenGreen]()
OpenAIの新しい安全機能は素晴らしいですね!生物学的リスクを防ぐための監視システムがあるのは安心です。ただ、無害な質問までブロックされることがあるのが少し気になります。でも、安全第一ですからね。引き続き頑張ってください、OpenAI!😊
![JamesWilliams]()
OpenAI's new safety feature is a game-changer! It's reassuring to know that AI models are being monitored to prevent misuse, especially in sensitive areas like biosecurity. But sometimes it feels a bit too cautious, blocking harmless queries. Still, better safe than sorry, right? Keep up the good work, OpenAI! 😊
![CharlesJohnson]()
¡La nueva función de seguridad de OpenAI es un cambio de juego! Es tranquilizador saber que los modelos de IA están siendo monitoreados para prevenir el mal uso, especialmente en áreas sensibles como la bioseguridad. Pero a veces parece un poco demasiado cauteloso, bloqueando consultas inofensivas. Aún así, más vale prevenir que lamentar, ¿verdad? ¡Sigue el buen trabajo, OpenAI! 😊
![CharlesMartinez]()
A nova função de segurança da OpenAI é incrível! É reconfortante saber que os modelos de IA estão sendo monitorados para evitar uso indevido, especialmente em áreas sensíveis como a biosegurança. Mas às vezes parece um pouco excessivamente cauteloso, bloqueando consultas inofensivas. Ainda assim, melhor prevenir do que remediar, certo? Continue o bom trabalho, OpenAI! 😊
![LarryMartin]()
OpenAI의 새로운 안전 기능 정말 대단해요! 생물학적 위험을 방지하기 위한 모니터링 시스템이 있다는 게 안심되네요. 다만, 무해한 질문까지 차단되는 경우가 있어서 조금 아쉽습니다. 그래도 안전이 최우선이죠. 계속해서 좋은 일 하세요, OpenAI! 😊
Novas Medidas de Segurança da OpenAI para Modelos de IA o3 e o4-mini
A OpenAI introduziu um novo sistema de monitoramento para seus modelos de IA avançados, o3 e o4-mini, projetado especificamente para detectar e prevenir respostas a prompts relacionados a ameaças biológicas e químicas. Este "monitor de raciocínio focado em segurança" é uma resposta às capacidades aprimoradas desses modelos, que, segundo a OpenAI, representam um avanço significativo em relação aos seus antecessores e poderiam ser mal utilizados por agentes mal-intencionados.
Os benchmarks internos da empresa indicam que o o3, em particular, demonstrou maior proficiência em responder perguntas sobre a criação de certas ameaças biológicas. Para abordar isso e outros riscos potenciais, a OpenAI desenvolveu esse novo sistema, que opera ao lado do o3 e o4-mini. Ele é treinado para reconhecer e rejeitar prompts que poderiam levar a conselhos prejudiciais sobre riscos biológicos e químicos.
Testes e Resultados
Para avaliar a eficácia desse monitor de segurança, a OpenAI conduziu testes extensivos. Equipes de teste gastaram aproximadamente 1.000 horas identificando conversas relacionadas a "riscos biológicos inseguros" geradas pelo o3 e o4-mini. Em uma simulação da "lógica de bloqueio" do monitor, os modelos conseguiram recusar responder a prompts arriscados em 98,7% das vezes.
No entanto, a OpenAI admite que seu teste não considerou cenários em que os usuários poderiam tentar prompts diferentes após serem bloqueados. Como resultado, a empresa planeja continuar usando monitoramento humano como parte de sua estratégia de segurança.
Avaliação de Riscos e Monitoramento Contínuo
Apesar de suas capacidades avançadas, o o3 e o o4-mini não excedem o limiar de "alto risco" da OpenAI para riscos biológicos. No entanto, versões iniciais desses modelos foram mais adeptas em responder perguntas sobre o desenvolvimento de armas biológicas em comparação com o o1 e o GPT-4. A OpenAI está monitorando ativamente como esses modelos podem facilitar o desenvolvimento de ameaças químicas e biológicas, conforme delineado em seu Framework de Preparação atualizado.
A OpenAI está cada vez mais recorrendo a sistemas automatizados para gerenciar os riscos apresentados por seus modelos. Por exemplo, um monitor de raciocínio semelhante é usado para impedir que o gerador de imagens do GPT-4o produza material de abuso sexual infantil (CSAM).
Preocupações e Críticas
Apesar desses esforços, alguns pesquisadores argumentam que a OpenAI pode não estar priorizando a segurança o suficiente. Um dos parceiros de teste da OpenAI, Metr, observou que teve tempo limitado para testar o o3 quanto a comportamentos enganosos. Além disso, a OpenAI optou por não divulgar um relatório de segurança para seu modelo GPT-4.1 recentemente lançado, levantando mais preocupações sobre o compromisso da empresa com transparência e segurança.








 Sam Altman Gera Debate Sobre a Desaceleração da IA
Escute noApple PodcastsEscute noSpotifyO CEO da OpenAI, Sam Altman, sugeriu recentemente que pode ser hora de “controlar o ritmo do desenvolvimento de IA” para permitir que a sociedade “se fortaleça em torno de alguns desses novos níveis de capacida
 A OpenAI process a Apple por violação de segredo comercial
A OpenAI refutou as alegações de segredo comercial da Apple na terça-feira, argumentando que a ação judicial é infundada.“Levamos essas alegações a sério, mas não vemos evidências que as apoiem”, afirmou a OpenAI, conforme relatado por Ed Ludlow, da
 A cabeça de robótica da OpenAI, Caitlin Kalinowski, renuncia devido à parceria com o Pentágono
O líder de robótica da OpenAI, Caitlin Kalinowski, renunciou após a polêmica parceria da empresa com o Departamento de Defesa.“Esta não foi uma decisão fácil”, explicou Kalinowski em uma declaração nas redes sociais. “Embora a IA desempenhe um papel

As melhores e mais bem avaliadas ferramentas de análise de SERP com IA de 2026 para estratégias de busca são selecionadas pela XIX.AI por meio de rigorosos testes práticos e rankings atualizados semanalmente. Essas ferramentas poderosas ajudam você a identificar oportunidades ocultas de otimização, melhorar o desempenho do conteúdo e obter uma vantagem competitiva nas buscas. Descubra hoje mesmo a ferramenta perfeita para aprimorar sua estratégia de busca. Explore agora!
13 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Detecção de Anomalias por IA Mais Bem Avaliadas para Monitoramento de KPIs em Equipes de SaaS e E-commerce! A XIX.AI compilou uma coleção poderosa e transformadora, baseada em testes rigorosos do mundo real e classificações atualizadas semanalmente. Você encontrará insights detalhados sobre comparações entre versões gratuitas e pagas para ajudá-lo a identificar a solução que deve ser testada, aumentando a produtividade e desbloqueando sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai

Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai

As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai

Wow, OpenAI's new safety measures for o3 and o4-mini sound like a big step! It's reassuring to see them tackling biorisks head-on. But I wonder, how foolproof is this monitoring system? 🤔 Could it catch every sneaky prompt?
OpenAIの新しい安全機能は素晴らしいですね!生物学的リスクを防ぐための監視システムがあるのは安心です。ただ、無害な質問までブロックされることがあるのが少し気になります。でも、安全第一ですからね。引き続き頑張ってください、OpenAI!😊
OpenAI's new safety feature is a game-changer! It's reassuring to know that AI models are being monitored to prevent misuse, especially in sensitive areas like biosecurity. But sometimes it feels a bit too cautious, blocking harmless queries. Still, better safe than sorry, right? Keep up the good work, OpenAI! 😊
¡La nueva función de seguridad de OpenAI es un cambio de juego! Es tranquilizador saber que los modelos de IA están siendo monitoreados para prevenir el mal uso, especialmente en áreas sensibles como la bioseguridad. Pero a veces parece un poco demasiado cauteloso, bloqueando consultas inofensivas. Aún así, más vale prevenir que lamentar, ¿verdad? ¡Sigue el buen trabajo, OpenAI! 😊
A nova função de segurança da OpenAI é incrível! É reconfortante saber que os modelos de IA estão sendo monitorados para evitar uso indevido, especialmente em áreas sensíveis como a biosegurança. Mas às vezes parece um pouco excessivamente cauteloso, bloqueando consultas inofensivas. Ainda assim, melhor prevenir do que remediar, certo? Continue o bom trabalho, OpenAI! 😊
OpenAI의 새로운 안전 기능 정말 대단해요! 생물학적 위험을 방지하기 위한 모니터링 시스템이 있다는 게 안심되네요. 다만, 무해한 질문까지 차단되는 경우가 있어서 조금 아쉽습니다. 그래도 안전이 최우선이죠. 계속해서 좋은 일 하세요, OpenAI! 😊












