


 Lar
O ataque de redução de dimensões do modelo 1.3B do MiniCPM-V 4.6 redefine a tecnologia multimodal de ponta
Em 11 de maio, a Mingshi Intelligence uniu forças com a Universidade de Tsinghua e a comunidade de código aberto OpenBMB para apresentar o novo modelo multimodal de grande porte para a borda, o MiniCPM-V4.6. Apesar de seu tamanho compacto — com apenas 1,3 bilhão de parâmetros —, esse modelo leve ultrapassa os limites dos modelos maiores graças à sua excepcional densidade de inteligência e adaptabilidade entre plataformas, acelerando a implantação da IA na borda no mundo real.
1. Desempenho máximo: 1,3 bilhão de parâmetros proporcionam resultados excepcionais
O MiniCPM-V4.6 está disponível em duas versões — Instruct e Thinking —, ambas demonstrando raciocínio e compreensão impressionantes em vários benchmarks quando comparadas a modelos de tamanho semelhante.
Liderança global: no ranking da Artificial Analysis (AA), o MiniCPM-V4.6 obteve impressionantes 13 pontos, superando de longe rivais de tamanho semelhante (por exemplo, o Qwen3.5-0.8B do Alibaba e o Gemma4-E2B-it do Google), ao mesmo tempo em que quase igualou o desempenho de modelos maiores, como o Qwen3.5-2B. Isso estabelece um novo padrão de referência para modelos com 1 bilhão de parâmetros.
Recursos avançados: Desde a compreensão geral de imagem-texto e o raciocínio matemático complexo em STEM até o exigente reconhecimento óptico de caracteres (OCR) em documentos e a compreensão temporal de vídeos, o modelo demonstra forte inteligência. A versão “Thinking”, em particular, se destaca no raciocínio com múltiplas imagens e na supressão de alucinações.
2. Avanço em eficiência: densidade inteligente extrema na borda
Para lidar com as restrições de memória na implantação na borda, o MiniCPM-V4.6 foi profundamente otimizado para velocidade de inferência e eficiência de recursos.
Baixo consumo de memória: os requisitos de memória caem para apenas 6 GB, permitindo uma operação suave em smartphones comuns, PCs e dispositivos domésticos inteligentes.
Eficiência de inferência: Com tecnologia vLLM, a taxa de processamento de inferência é 1,5 vez maior que a dos concorrentes. Ao processar uma imagem de ultra-alta definição de 3136² na borda, a latência da primeira resposta é de apenas 75,7 ms— 2,2 vezes mais rápida que os modelos concorrentes.
Taxa de processamento: uma única GPU gera texto a uma taxa de 7.013 tokens por segundo e pode processar imagens de 1.344² a uma taxa de 54,79 imagens por segundo, demonstrando eficiência notável.
3. Tecnologia central: LLaVA-UHD v4 minimiza a sobrecarga
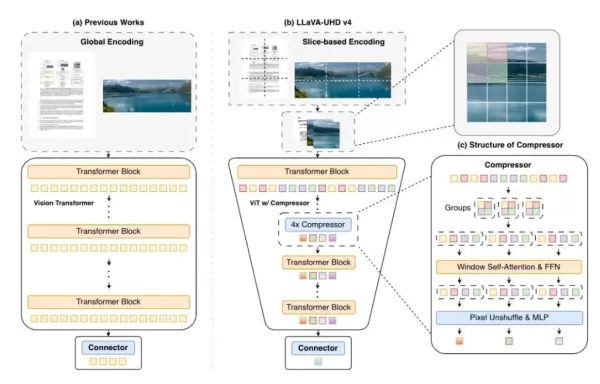
O design leve do modelo é possibilitado pelo LLaVA-UHD v4, desenvolvido em conjunto pela Mingshi Intelligence e pela Universidade de Tsinghua.
Reestruturação da codificação: Por meio de um módulo renovado de codificação de imagem ViT e de compressão superficial, a sobrecarga da codificação de imagem é reduzida em 50% e as operações de ponto flutuante de alta resolução em 55,8%.
Compressão híbrida: introduz uma compressão híbrida de tokens 4×/16× que permite a alternância flexível entre os modos “desempenho em primeiro lugar” e “velocidade em primeiro lugar”. Essa tecnologia foi validada no modelo de recomendação OneRec da Kuaishou, que lida com tráfego massivo.
4. Implantação no ecossistema: do laboratório à indústria
O lançamento do MiniCPM-V4.6 como código aberto marca um marco tanto técnico quanto para o ecossistema.
Fácil desenvolvimento: integra-se perfeitamente a frameworks de ajuste fino, como ms-swift e LLaMA-Factory, permitindo o ajuste fino em escala real em uma única GPU RTX 4090.
Suporte multiplataforma: Compatível com vLLM, Ollama e outras estruturas importantes, oferece versões de teste para iOS, Android e HarmonyOS, levando a IA a uma gama mais ampla de hardware.
Impacto no mundo real: a série de modelos já está implantada nos setores automotivo, de PCs, de casas inteligentes e de inspeção industrial, com parceiros como Lenovo, Geely, SAIC Volkswagen, Xiaomi e OPPO.
Artigo relacionado
 A Seed, da ByteDance, lança campanha global de captação de talentos em campus universitários, oferecendo ações virtuais para conquistar os melhores especialistas em grandes modelos de inteligência artificial
No cenário competitivo dos grandes modelos de linguagem, garantir talentos de alto nível continua sendo o ativo estratégico mais crítico.Em 1º de abril, ByteDance anunciou o lançamento de sua iniciativa global de recrutamento campus Seed, parte de se
Suno para Marcas d'Água em Músicas Durante Batalhas Legais
O Suno, plataforma que permite aos usuários gerar músicas criadas por inteligência artificial, apresentou novas funcionalidades para rotular as faixas produzidas pela plataforma, restringir downloads e atualizar os padrões da comunidade para coibir r
Musk admite que vazamento do código do Grok expôs dados de usuários e promete apagar todas as informações históricas.
Elon Musk abordou diretamente a controvérsia sobre privacidade envolvendo o Grok Build, começando com um simples "Verdadeiro" para confirmar a validade do incidente. Ele prometeu que todos os dados dos usuários carregados anteriormente para a SpaceXA
Recomendações de tópicos especiais relacionados
Design e Arte
 Ferramentas de referência de estilo visual baseadas em IA para fichas de personagens, moodboards e apresentações de projetos
As melhores e mais recentes ferramentas de referência de estilo visual com IA para fichas de personagens, moodboards e apresentações de projetos de 2026 já estão disponíveis no XIX.AI! Esta lista selecionada e com as melhores avaliações apresenta ferramentas poderosas e revolucionárias que passaram por rigorosos testes na prática. Você encontrará uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para ajudar a impulsionar sua criatividade e otimizar seu fluxo de trabalho. Explore agora para descobrir a ferramenta perfeita para aumentar sua produtividade!
 11 ferramentas
 xix.ai
SEO
As melhores ferramentas de análise de SERP com IA para estratégias de busca
As melhores e mais bem avaliadas ferramentas de análise de SERP com IA de 2026 para estratégias de busca são selecionadas pela XIX.AI por meio de rigorosos testes práticos e rankings atualizados semanalmente. Essas ferramentas poderosas ajudam você a identificar oportunidades ocultas de otimização, melhorar o desempenho do conteúdo e obter uma vantagem competitiva nas buscas. Descubra hoje mesmo a ferramenta perfeita para aprimorar sua estratégia de busca. Explore agora!
13 ferramentas
xix.ai
Análise de dados
Melhores ferramentas de detecção de anomalias com IA para monitoramento de KPIs entre equipes de SaaS e comércio eletrônico
2026 Últimas Melhores Ferramentas de Detecção de Anomalias por IA Mais Bem Avaliadas para Monitoramento de KPIs em Equipes de SaaS e E-commerce! A XIX.AI compilou uma coleção poderosa e transformadora, baseada em testes rigorosos do mundo real e classificações atualizadas semanalmente. Você encontrará insights detalhados sobre comparações entre versões gratuitas e pagas para ajudá-lo a identificar a solução que deve ser testada, aumentando a produtividade e desbloqueando sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai
escrita
Os melhores geradores de esboços com IA para artigos longos de SEO
Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai
Educação e Aprendizagem
Ferramentas de IA para os deveres de casa e a preparação para provas
As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai
Composição musical
Ferramentas de Demonstração Vocal com IA para Compositores, Ganchos, Toplines e Sessões de Rascunho Multilíngues
2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai

 Comentários (0)
Em 11 de maio, a Mingshi Intelligence uniu forças com a Universidade de Tsinghua e a comunidade de código aberto OpenBMB para apresentar o novo modelo multimodal de grande porte para a borda, o MiniCPM-V4.6. Apesar de seu tamanho compacto — com apenas 1,3 bilhão de parâmetros —, esse modelo leve ultrapassa os limites dos modelos maiores graças à sua excepcional densidade de inteligência e adaptabilidade entre plataformas, acelerando a implantação da IA na borda no mundo real.
1. Desempenho máximo: 1,3 bilhão de parâmetros proporcionam resultados excepcionais
O MiniCPM-V4.6 está disponível em duas versões — Instruct e Thinking —, ambas demonstrando raciocínio e compreensão impressionantes em vários benchmarks quando comparadas a modelos de tamanho semelhante.
Liderança global: no ranking da Artificial Analysis (AA), o MiniCPM-V4.6 obteve impressionantes 13 pontos, superando de longe rivais de tamanho semelhante (por exemplo, o Qwen3.5-0.8B do Alibaba e o Gemma4-E2B-it do Google), ao mesmo tempo em que quase igualou o desempenho de modelos maiores, como o Qwen3.5-2B. Isso estabelece um novo padrão de referência para modelos com 1 bilhão de parâmetros.
Recursos avançados: Desde a compreensão geral de imagem-texto e o raciocínio matemático complexo em STEM até o exigente reconhecimento óptico de caracteres (OCR) em documentos e a compreensão temporal de vídeos, o modelo demonstra forte inteligência. A versão “Thinking”, em particular, se destaca no raciocínio com múltiplas imagens e na supressão de alucinações.
2. Avanço em eficiência: densidade inteligente extrema na borda
Para lidar com as restrições de memória na implantação na borda, o MiniCPM-V4.6 foi profundamente otimizado para velocidade de inferência e eficiência de recursos.
Baixo consumo de memória: os requisitos de memória caem para apenas 6 GB, permitindo uma operação suave em smartphones comuns, PCs e dispositivos domésticos inteligentes.
Eficiência de inferência: Com tecnologia vLLM, a taxa de processamento de inferência é 1,5 vez maior que a dos concorrentes. Ao processar uma imagem de ultra-alta definição de 3136² na borda, a latência da primeira resposta é de apenas 75,7 ms— 2,2 vezes mais rápida que os modelos concorrentes.
Taxa de processamento: uma única GPU gera texto a uma taxa de 7.013 tokens por segundo e pode processar imagens de 1.344² a uma taxa de 54,79 imagens por segundo, demonstrando eficiência notável.
3. Tecnologia central: LLaVA-UHD v4 minimiza a sobrecarga
O design leve do modelo é possibilitado pelo LLaVA-UHD v4, desenvolvido em conjunto pela Mingshi Intelligence e pela Universidade de Tsinghua.
Reestruturação da codificação: Por meio de um módulo renovado de codificação de imagem ViT e de compressão superficial, a sobrecarga da codificação de imagem é reduzida em 50% e as operações de ponto flutuante de alta resolução em 55,8%.
Compressão híbrida: introduz uma compressão híbrida de tokens 4×/16× que permite a alternância flexível entre os modos “desempenho em primeiro lugar” e “velocidade em primeiro lugar”. Essa tecnologia foi validada no modelo de recomendação OneRec da Kuaishou, que lida com tráfego massivo.
4. Implantação no ecossistema: do laboratório à indústria
O lançamento do MiniCPM-V4.6 como código aberto marca um marco tanto técnico quanto para o ecossistema.
Fácil desenvolvimento: integra-se perfeitamente a frameworks de ajuste fino, como ms-swift e LLaMA-Factory, permitindo o ajuste fino em escala real em uma única GPU RTX 4090.
Suporte multiplataforma: Compatível com vLLM, Ollama e outras estruturas importantes, oferece versões de teste para iOS, Android e HarmonyOS, levando a IA a uma gama mais ampla de hardware.
Impacto no mundo real: a série de modelos já está implantada nos setores automotivo, de PCs, de casas inteligentes e de inspeção industrial, com parceiros como Lenovo, Geely, SAIC Volkswagen, Xiaomi e OPPO.








 A Seed, da ByteDance, lança campanha global de captação de talentos em campus universitários, oferecendo ações virtuais para conquistar os melhores especialistas em grandes modelos de inteligência artificial
No cenário competitivo dos grandes modelos de linguagem, garantir talentos de alto nível continua sendo o ativo estratégico mais crítico.Em 1º de abril, ByteDance anunciou o lançamento de sua iniciativa global de recrutamento campus Seed, parte de se
 Suno para Marcas d'Água em Músicas Durante Batalhas Legais
O Suno, plataforma que permite aos usuários gerar músicas criadas por inteligência artificial, apresentou novas funcionalidades para rotular as faixas produzidas pela plataforma, restringir downloads e atualizar os padrões da comunidade para coibir r
 Musk admite que vazamento do código do Grok expôs dados de usuários e promete apagar todas as informações históricas.
Elon Musk abordou diretamente a controvérsia sobre privacidade envolvendo o Grok Build, começando com um simples "Verdadeiro" para confirmar a validade do incidente. Ele prometeu que todos os dados dos usuários carregados anteriormente para a SpaceXA

As melhores e mais recentes ferramentas de referência de estilo visual com IA para fichas de personagens, moodboards e apresentações de projetos de 2026 já estão disponíveis no XIX.AI! Esta lista selecionada e com as melhores avaliações apresenta ferramentas poderosas e revolucionárias que passaram por rigorosos testes na prática. Você encontrará uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para ajudar a impulsionar sua criatividade e otimizar seu fluxo de trabalho. Explore agora para descobrir a ferramenta perfeita para aumentar sua produtividade!
11 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de análise de SERP com IA de 2026 para estratégias de busca são selecionadas pela XIX.AI por meio de rigorosos testes práticos e rankings atualizados semanalmente. Essas ferramentas poderosas ajudam você a identificar oportunidades ocultas de otimização, melhorar o desempenho do conteúdo e obter uma vantagem competitiva nas buscas. Descubra hoje mesmo a ferramenta perfeita para aprimorar sua estratégia de busca. Explore agora!
13 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Detecção de Anomalias por IA Mais Bem Avaliadas para Monitoramento de KPIs em Equipes de SaaS e E-commerce! A XIX.AI compilou uma coleção poderosa e transformadora, baseada em testes rigorosos do mundo real e classificações atualizadas semanalmente. Você encontrará insights detalhados sobre comparações entre versões gratuitas e pagas para ajudá-lo a identificar a solução que deve ser testada, aumentando a produtividade e desbloqueando sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai

Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai

As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai












