


 Lar
O modelo LPM1.0 gera vídeo de humano digital interativo em tempo real a partir de uma única imagem.
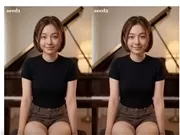
Os pesquisadores apresentaram oficialmente o modelo LPM1.0, um projeto criado para gerar vídeos em tempo real de pessoas falando, ouvindo e cantando a partir de uma única imagem de referência. Sua principal inovação reside no processamento multimodal — sincronizando entradas de texto, áudio e imagem para criar cenas dinâmicas com sincronização labial precisa, expressões faciais detalhadas e transições emocionais naturais. O modelo se integra diretamente a plataformas líderes de IA de voz, como ChatGPT e Doubao, transformando conversas convencionais em experiências interativas em tempo real com feedback visual.
Tecnicamente, o LPM1.0 utiliza o método de “condicionamento de identidade em múltiplas granularidades” para extrair características detalhadas dos materiais de referência a partir de diversos ângulos e expressões, eliminando a necessidade de o modelo gerar independentemente elementos complexos como dentes, rugas ou perfis laterais. Isso melhora significativamente o processamento entre diferentes estilos, permitindo a geração imediata de rostos fotorrealistas, animações ou personagens de jogos 3D sem a necessidade de retreinamento. O modelo também suporta transmissão em streaming, garantindo estabilidade do sistema mesmo ao gerar vídeos com duração de até 45 minutos.
Quanto à lógica de interação, o LPM1.0 detecta com precisão três estados de conversação: enquanto ouve, ele gera expressões que refletem a atenção, como acenos de cabeça ou mudanças no olhar; enquanto fala, ele controla os movimentos do corpo e dos lábios com base no áudio; e quando está inativo, ele produz comportamentos naturais de descanso conforme as instruções fornecidas no texto. A gerente de projeto Zeng Ailing destacou que o LPM1.0 é adequado não apenas para conversas em tempo real, mas também para a geração offline de vídeos baseados em áudio, oferecendo redundância técnica para podcasts e produção cinematográfica.
Apesar de seu grande potencial aplicacional, a equipe de desenvolvimento ressalta que o LPM1.0 ainda é um projeto de pesquisa e não há planos atuais para disponibilizar publicamente o código ou os pesos do modelo. Os pesquisadores reconhecem uma diferença qualitativa entre os vídeos gerados e as imagens reais, além dos riscos inerentes associados aos deepfakes, que não podem ser ignorados. A importância deste estudo está em mapear a evolução futura dos sistemas de IA — passando de interações lógicas simples para interações multidimensionais que incluem respostas emocionais, contato visual e representação visual.
Artigo relacionado
 Ações dos EUA Atingem Marco Histórico Enquanto Gigantes de IA e Aeroespacial se Preparam para Estreia de Trilião de Dólares
Elon Musk, Sam Altman e Dario Amodei, três titãs do setor de tecnologia, estão avançando rumo a ofertas públicas iniciais (IPOs) para suas respectivas empresas. Com a SpaceX, a OpenAI e a Anthropic — três gigantes da indústria que se aproximam de ava
Startup sueca de IA Lovable Eyes tem avaliação de US$ 13,2 bilhões após rodada principal de investimentos
À medida que as ferramentas de codificação impulsionadas por IA ganham tração, a startup sueca Lovable garantiu uma grande rodada de financiamento. A empresa visa captar US$ 3 bilhões, o que poderia elevar sua avaliação para US$ 13,2 bilhões — o dobr
O Google testa o Agente Remy AI para o Gemini, à medida que o foco se desloca para o controle do usuário
De acordo com o Business Insider, o Google está testando o Remy, um novo agente pessoal de IA para o Gemini. Esta ferramenta tem como objetivo executar tarefas em nome dos usuários, simplificando tanto os fluxos de trabalho profissionais quanto as ro
Recomendações de tópicos especiais relacionados
Análise de dados
 Melhores ferramentas de detecção de anomalias com IA para monitoramento de KPIs entre equipes de SaaS e comércio eletrônico
2026 Últimas Melhores Ferramentas de Detecção de Anomalias por IA Mais Bem Avaliadas para Monitoramento de KPIs em Equipes de SaaS e E-commerce! A XIX.AI compilou uma coleção poderosa e transformadora, baseada em testes rigorosos do mundo real e classificações atualizadas semanalmente. Você encontrará insights detalhados sobre comparações entre versões gratuitas e pagas para ajudá-lo a identificar a solução que deve ser testada, aumentando a produtividade e desbloqueando sua vantagem com IA. Explore agora!
 10 ferramentas
 xix.ai
escrita
Os melhores geradores de esboços com IA para artigos longos de SEO
Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai
Educação e Aprendizagem
Ferramentas de IA para os deveres de casa e a preparação para provas
As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai
Composição musical
Ferramentas de Demonstração Vocal com IA para Compositores, Ganchos, Toplines e Sessões de Rascunho Multilíngues
2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai
Negócios
As melhores ferramentas de pesquisa competitiva baseadas em IA para pequenas empresas
As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai
Edição de imagem
Ferramentas de Retoque com IA do Photoshop para Moda E-commerce, Limpeza de Pele e Consistência de Cor
2026 Últimas Melhores Ferramentas de Retoque com IA do Photoshop para roupas de comércio eletrônico, limpeza de pele e consistência de cores! Esta lista curada de alta classificação apresenta soluções poderosas que mudam o jogo, ajudando você a aumentar a eficiência da escrita, simplificar a criação de conteúdo e obter resultados visuais perfeitos sem esforço. Cada ferramenta passou por testes do mundo real através de classificações atualizadas semanalmente, com detalhes completos sobre comparação entre gratuito e pago. Com o apoio da XIX.AI, é o guia essencial para quem deseja desbloquear sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai

 Comentários (0)
Os pesquisadores apresentaram oficialmente o modelo LPM1.0, um projeto criado para gerar vídeos em tempo real de pessoas falando, ouvindo e cantando a partir de uma única imagem de referência. Sua principal inovação reside no processamento multimodal — sincronizando entradas de texto, áudio e imagem para criar cenas dinâmicas com sincronização labial precisa, expressões faciais detalhadas e transições emocionais naturais. O modelo se integra diretamente a plataformas líderes de IA de voz, como ChatGPT e Doubao, transformando conversas convencionais em experiências interativas em tempo real com feedback visual.
Tecnicamente, o LPM1.0 utiliza o método de “condicionamento de identidade em múltiplas granularidades” para extrair características detalhadas dos materiais de referência a partir de diversos ângulos e expressões, eliminando a necessidade de o modelo gerar independentemente elementos complexos como dentes, rugas ou perfis laterais. Isso melhora significativamente o processamento entre diferentes estilos, permitindo a geração imediata de rostos fotorrealistas, animações ou personagens de jogos 3D sem a necessidade de retreinamento. O modelo também suporta transmissão em streaming, garantindo estabilidade do sistema mesmo ao gerar vídeos com duração de até 45 minutos.
Quanto à lógica de interação, o LPM1.0 detecta com precisão três estados de conversação: enquanto ouve, ele gera expressões que refletem a atenção, como acenos de cabeça ou mudanças no olhar; enquanto fala, ele controla os movimentos do corpo e dos lábios com base no áudio; e quando está inativo, ele produz comportamentos naturais de descanso conforme as instruções fornecidas no texto. A gerente de projeto Zeng Ailing destacou que o LPM1.0 é adequado não apenas para conversas em tempo real, mas também para a geração offline de vídeos baseados em áudio, oferecendo redundância técnica para podcasts e produção cinematográfica.
Apesar de seu grande potencial aplicacional, a equipe de desenvolvimento ressalta que o LPM1.0 ainda é um projeto de pesquisa e não há planos atuais para disponibilizar publicamente o código ou os pesos do modelo. Os pesquisadores reconhecem uma diferença qualitativa entre os vídeos gerados e as imagens reais, além dos riscos inerentes associados aos deepfakes, que não podem ser ignorados. A importância deste estudo está em mapear a evolução futura dos sistemas de IA — passando de interações lógicas simples para interações multidimensionais que incluem respostas emocionais, contato visual e representação visual.








 Ações dos EUA Atingem Marco Histórico Enquanto Gigantes de IA e Aeroespacial se Preparam para Estreia de Trilião de Dólares
Elon Musk, Sam Altman e Dario Amodei, três titãs do setor de tecnologia, estão avançando rumo a ofertas públicas iniciais (IPOs) para suas respectivas empresas. Com a SpaceX, a OpenAI e a Anthropic — três gigantes da indústria que se aproximam de ava
 Startup sueca de IA Lovable Eyes tem avaliação de US$ 13,2 bilhões após rodada principal de investimentos
À medida que as ferramentas de codificação impulsionadas por IA ganham tração, a startup sueca Lovable garantiu uma grande rodada de financiamento. A empresa visa captar US$ 3 bilhões, o que poderia elevar sua avaliação para US$ 13,2 bilhões — o dobr
O Google testa o Agente Remy AI para o Gemini, à medida que o foco se desloca para o controle do usuário
De acordo com o Business Insider, o Google está testando o Remy, um novo agente pessoal de IA para o Gemini. Esta ferramenta tem como objetivo executar tarefas em nome dos usuários, simplificando tanto os fluxos de trabalho profissionais quanto as ro

2026 Últimas Melhores Ferramentas de Detecção de Anomalias por IA Mais Bem Avaliadas para Monitoramento de KPIs em Equipes de SaaS e E-commerce! A XIX.AI compilou uma coleção poderosa e transformadora, baseada em testes rigorosos do mundo real e classificações atualizadas semanalmente. Você encontrará insights detalhados sobre comparações entre versões gratuitas e pagas para ajudá-lo a identificar a solução que deve ser testada, aumentando a produtividade e desbloqueando sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai

Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai

As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Retoque com IA do Photoshop para roupas de comércio eletrônico, limpeza de pele e consistência de cores! Esta lista curada de alta classificação apresenta soluções poderosas que mudam o jogo, ajudando você a aumentar a eficiência da escrita, simplificar a criação de conteúdo e obter resultados visuais perfeitos sem esforço. Cada ferramenta passou por testes do mundo real através de classificações atualizadas semanalmente, com detalhes completos sobre comparação entre gratuito e pago. Com o apoio da XIX.AI, é o guia essencial para quem deseja desbloquear sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai












