


 Heim
Das LPM1.0-Modell erzeugt aus einem einzigen Bild ein Echtzeit-interaktives digitales Menschenvideo.
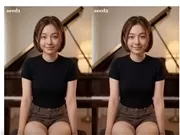
Forscher haben offiziell das LPM1.0-Modell vorgestellt, ein Projekt, das darauf abzielt, aus einem einzigen Referenzbild Echtzeit-Videos von Menschen beim Sprechen, Zuhören und Singen zu erzeugen. Der entscheidende Durchbruch liegt in der multimodalen Verarbeitung – durch die Synchronisierung von Text-, Audio- und Bilddaten entstehen dynamische Szenen mit präziser Lippenbewegungsanpassung, fein abgestimmten Gesichtsausdrücken sowie natürlichen emotionalen Übergängen. Das Modell integriert sich direkt in führende Sprach-KI-Plattformen wie ChatGPT und Doubao und wandelt herkömmliche Sprachgespräche in Echtzeit-interaktive Erlebnisse mit visuellen Rückmeldungen um.
Technisch gesehen nutzt LPM1.0 das Verfahren „multi-granulare Identitätsbedingung“, um aus Referenzmaterialien unter Berücksichtigung verschiedener Perspektiven und Ausdrücke detaillierte Merkmale zu extrahieren. Dadurch entfällt die Notwendigkeit, dass das Modell komplexe Elemente wie Zähne, Falten oder Seitenprofile eigenständig erzeugen muss. Dies steigert erheblich die Fähigkeit zur Verarbeitung unterschiedlicher Stile – es ist somit möglich, ohne Neutraining sofort photorealistische Gesichter, Animationen oder 3D-Spielcharaktere zu erstellen. Zudem unterstützt das Modell den Stream-Transfer, wodurch auch bei der Erstellung von Videos mit einer Länge von bis zu 45 Minuten die Systemstabilität gewährleistet bleibt.
Was die Interaktionslogik betrifft, so erkennt LPM1.0 präzise drei Gesprächsphasen: Während des Zuhörens zeigt es reaktive Ausdrücke wie Nicken oder Blickverlagerungen; beim Sprechen steuert es Körperrhythmen und Lippenbewegungen anhand des Audios; in der Inaktivitätsphase erzeugt es auf Grundlage von Textanweisungen natürliche Ruheverhaltensweisen. Die Projektmanagerin Zeng Ailing betonte, dass LPM1.0 nicht nur für Echtzeit-Gespräche geeignet ist, sondern auch zur Offline-Generierung von videos basierend auf Audio dient und somit technische Redundanz für Podcasts sowie Filmproduktionen bietet.
Trotz seines großen Anwendungspotenzials betont das Entwicklerteam, dass LPM1.0 weiterhin ein Forschungsprojekt bleibt, bei dem derzeit keine Pläne bestehen, Code oder Gewichte öffentlich zugänglich zu machen. Die Forscher erkennen einen qualitativen Unterschied zwischen den erzeugten Videos und echten Aufnahmen sowie die inhärenten Risiken von Deepfakes, die nicht ignoriert werden können. Die Bedeutung dieser Studie liegt darin, die zukünftige Entwicklung von KI-Systemen aufzuzeigen – weg von einer einseitigen logischen Interaktion hin zu mehrdimensionalen Interaktionen, die emotionale Reaktionen, Augenkontakt sowie visuelle Darstellung beinhalten.
Verwandter Artikel
 So beheben Sie Core Web Vitals für bessere SEO-Rankings
Berichtskartenkommentare mit KI-Tools optimierenEinführungKI-Tools zur Generierung von BerichtskartenkommentarenMagic SchoolAlmanac AIChat GPTNutzung von Magic School zur Generierung von BerichtskartenkommentarenAnmeldung bei Magic SchoolAuswahl des
Slackbot wird zu einem KI-Agenten
Slackbot, der automatisierte Assistent, der in Salesforce’s Unternehmens-Messaging-Plattform Slack integriert ist, entwickelt sich zu einem KI-Agenten. Salesforce-CTO Parker Harris sieht das Potenzial für eine virale Verbreitung, die mit OpenAIs Chat
ByteDance erhöht die Kern-KI-Anreize, während Doubao um 14,6 % steigt
ByteDance hat kürzlich ein Equity-Briefing für DouBao abgehalten, um neue Anreizrichtlinien für Mitarbeiter der DouBao-Sparte vorzustellen. Der Ausübungspreis für DouBao-Anteile wurde von 14,85 US-Dollar im Juni 2026 auf 17,02 US-Dollar angehoben, wa
Empfehlungen zu verwandten Spezialthemen
Bildung und Lernen
 KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung
Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
 10 Tools
 xix.ai
Musikkomposition
KI-Stimm-Demo-Tools für Songwriter, Hooks, Toplines und mehrsprachige Entwurfs-Sessions
2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai
Geschäft
Die besten KI-Tools zur Wettbewerbsanalyse für kleine Unternehmen
Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai
Bildbearbeitung
Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonstanz
2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai
Prompt
Die besten KI-Prompt-Bibliotheken für ChatGPT-Workflows
Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai
Bildung und Lernen
AI Quiz Builder Plattformen für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme
2026 Neueste und beste KI-Quiz-Erstellungstools für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die realen Tests unterzogen wurden, um genaue Rankings zu liefern. Diese unbedingt auszuprobierenden Plattformen helfen dabei, die Schreibeffizienz zu steigern, die Inhaltserstellung zu optimieren und das Quiz-Design in allen Lernszenarien zu vereinfachen. Entdecken Sie jetzt Ihr perfektes Tool, um Ihren KI-Vorteil im Unterricht voll auszuschöpfen!
13 Tools
xix.ai

 Kommentare (0)
Forscher haben offiziell das LPM1.0-Modell vorgestellt, ein Projekt, das darauf abzielt, aus einem einzigen Referenzbild Echtzeit-Videos von Menschen beim Sprechen, Zuhören und Singen zu erzeugen. Der entscheidende Durchbruch liegt in der multimodalen Verarbeitung – durch die Synchronisierung von Text-, Audio- und Bilddaten entstehen dynamische Szenen mit präziser Lippenbewegungsanpassung, fein abgestimmten Gesichtsausdrücken sowie natürlichen emotionalen Übergängen. Das Modell integriert sich direkt in führende Sprach-KI-Plattformen wie ChatGPT und Doubao und wandelt herkömmliche Sprachgespräche in Echtzeit-interaktive Erlebnisse mit visuellen Rückmeldungen um.
Technisch gesehen nutzt LPM1.0 das Verfahren „multi-granulare Identitätsbedingung“, um aus Referenzmaterialien unter Berücksichtigung verschiedener Perspektiven und Ausdrücke detaillierte Merkmale zu extrahieren. Dadurch entfällt die Notwendigkeit, dass das Modell komplexe Elemente wie Zähne, Falten oder Seitenprofile eigenständig erzeugen muss. Dies steigert erheblich die Fähigkeit zur Verarbeitung unterschiedlicher Stile – es ist somit möglich, ohne Neutraining sofort photorealistische Gesichter, Animationen oder 3D-Spielcharaktere zu erstellen. Zudem unterstützt das Modell den Stream-Transfer, wodurch auch bei der Erstellung von Videos mit einer Länge von bis zu 45 Minuten die Systemstabilität gewährleistet bleibt.
Was die Interaktionslogik betrifft, so erkennt LPM1.0 präzise drei Gesprächsphasen: Während des Zuhörens zeigt es reaktive Ausdrücke wie Nicken oder Blickverlagerungen; beim Sprechen steuert es Körperrhythmen und Lippenbewegungen anhand des Audios; in der Inaktivitätsphase erzeugt es auf Grundlage von Textanweisungen natürliche Ruheverhaltensweisen. Die Projektmanagerin Zeng Ailing betonte, dass LPM1.0 nicht nur für Echtzeit-Gespräche geeignet ist, sondern auch zur Offline-Generierung von videos basierend auf Audio dient und somit technische Redundanz für Podcasts sowie Filmproduktionen bietet.
Trotz seines großen Anwendungspotenzials betont das Entwicklerteam, dass LPM1.0 weiterhin ein Forschungsprojekt bleibt, bei dem derzeit keine Pläne bestehen, Code oder Gewichte öffentlich zugänglich zu machen. Die Forscher erkennen einen qualitativen Unterschied zwischen den erzeugten Videos und echten Aufnahmen sowie die inhärenten Risiken von Deepfakes, die nicht ignoriert werden können. Die Bedeutung dieser Studie liegt darin, die zukünftige Entwicklung von KI-Systemen aufzuzeigen – weg von einer einseitigen logischen Interaktion hin zu mehrdimensionalen Interaktionen, die emotionale Reaktionen, Augenkontakt sowie visuelle Darstellung beinhalten.








 So beheben Sie Core Web Vitals für bessere SEO-Rankings
Berichtskartenkommentare mit KI-Tools optimierenEinführungKI-Tools zur Generierung von BerichtskartenkommentarenMagic SchoolAlmanac AIChat GPTNutzung von Magic School zur Generierung von BerichtskartenkommentarenAnmeldung bei Magic SchoolAuswahl des
 Slackbot wird zu einem KI-Agenten
Slackbot, der automatisierte Assistent, der in Salesforce’s Unternehmens-Messaging-Plattform Slack integriert ist, entwickelt sich zu einem KI-Agenten. Salesforce-CTO Parker Harris sieht das Potenzial für eine virale Verbreitung, die mit OpenAIs Chat
 ByteDance erhöht die Kern-KI-Anreize, während Doubao um 14,6 % steigt
ByteDance hat kürzlich ein Equity-Briefing für DouBao abgehalten, um neue Anreizrichtlinien für Mitarbeiter der DouBao-Sparte vorzustellen. Der Ausübungspreis für DouBao-Anteile wurde von 14,85 US-Dollar im Juni 2026 auf 17,02 US-Dollar angehoben, wa

Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai

2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai

2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai

2026 Neueste und beste KI-Quiz-Erstellungstools für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die realen Tests unterzogen wurden, um genaue Rankings zu liefern. Diese unbedingt auszuprobierenden Plattformen helfen dabei, die Schreibeffizienz zu steigern, die Inhaltserstellung zu optimieren und das Quiz-Design in allen Lernszenarien zu vereinfachen. Entdecken Sie jetzt Ihr perfektes Tool, um Ihren KI-Vorteil im Unterricht voll auszuschöpfen!
13 Tools
xix.ai












