


 Lar
O lançamento do Gemini 3.6 Flash desperta zombarias sobre a troca entre economia de tokens e inteligência
Se você tem usado o Gemini desde o ano passado, a piada popular mais recente é: é como assistir ao seu próprio irmão desenvolver gradualmente Alzheimer. Normalmente, quando uma empresa lança um novo modelo, ele deve ser usado para refutar esse tipo de piada. Mas agora, após a Google revelar três novos modelos, em vez de retratar essa afirmação, os internautas riram ainda mais alto, dando a sensação de "eles não acreditavam em você, e você acabou sendo o mais decepcionante". Esses três modelos são 3.6 Flash, 3.5 Flash-Lite e 3.5 Flash Cyber para segurança cibernética. A redação no blog oficial ainda é familiar: mais eficiente, mais inteligente, construído para agentes de IA em larga escala, sem perder o ritmo. No entanto, a experiência prática é drasticamente diferente.
Começando pelo principal 3.6 Flash. É uma atualização de versão menor do 3.5 Flash da conferência I/O de maio deste ano, e o posicionamento oficial é como um modelo de trabalho árduo. O maior ponto de venda desta geração é economizar tokens: de acordo com os dados do Índice Artificial Analysis, o 3.6 Flash usa 17% menos tokens de saída do que o 3.5 Flash, e até 65% menos em cenários DeepSWE. Ao executar tarefas em várias etapas, o número de etapas de raciocínio e chamadas de ferramentas também é reduzido. O preço realmente caiu, para US$ 1,5 por milhão de tokens de entrada e US$ 7,5 por milhão de tokens de saída, enquanto o preço de saída do 3.5 Flash anterior era de US$ 9. Isso reduz diretamente para US$ 7,5, tornando-o mais rápido e com melhor custo-benefício, com o custo de uma única tarefa de agente significativamente reduzido.
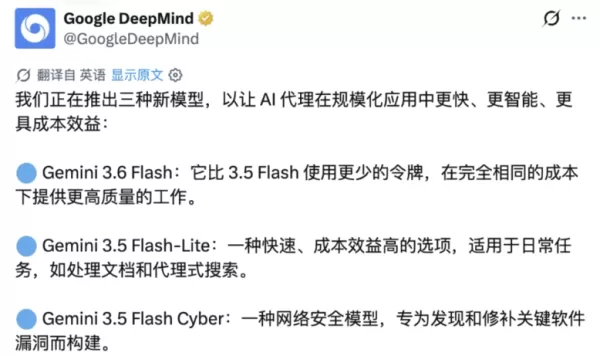
Nos testes de benchmark, a capacidade de código foi um foco, com o DeepSWE subindo de 37% para 49%. A afirmação oficial é de que há menos alterações de código desnecessárias, loops de execução mais curtos e código gerado mais próximo dos requisitos de produção; o MLE Bench para pesquisa de aprendizado de máquina viu um aumento mais significativo, de 49,7% para 63,9%; o OSWorld-Verified para operações de computador subiu de 78,4% para 83%, e as operações de computador se tornaram uma ferramenta integrada na API do Gemini e na edição empresarial, prontas para uso imediatamente. Uma atualização menor, mas prática, é que a data de corte do conhecimento finalmente foi empurrada de janeiro de 2025 para março de 2026, finalmente se afastando do calendário antigo. Em termos de segurança, a afirmação oficial é de que o 3.6 Flash tem uma proteção Frontier Safety aprimorada, focando em dois tipos de abuso: ataques químicos, biológicos, radiológicos, nucleares e cibernéticos, com resistência mais forte a quebras de segurança (jailbreaking), enquanto tenta não prejudicar necessidades normais e minimiza rejeições desnecessárias.
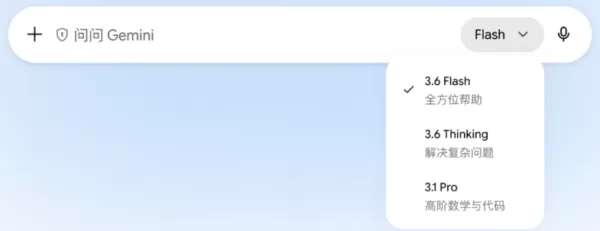
A próxima categoria abaixo é o 3.5 Flash-Lite, que foca em velocidade e acessibilidade, direcionado a tarefas de alto throughput e baixa latência, como pesquisa de agentes e processamento de documentos. É o mais rápido da série 3.5, capaz de gerar 350 tokens por segundo, de acordo com as medições da Artificial Analysis. O preço é extremamente barato, US$ 0,3 para entrada e US$ 2,5 para saída por milhão de tokens, com qualidade significativamente melhor do que o 3.1 Flash-Lite lançado em março. Ele suporta ajustar o nível de raciocínio, onde tarefas de nível inferior podem ser executadas no nível mais baixo para velocidade e eficiência, e ao enfrentar sub-tarefas complexas que exigem várias etapas, ele pode ajustar o nível de pensamento para cima. As operações de computador também foram transformadas em uma ferramenta integrada.
Melhorias significativas: o Terminal-Bench2.1 para tarefas de código e agentes saltou de 31% para 54%, o GDM-MRCR v2 para contexto longo melhorou de 60,1% para 72,2%, e o GDPval-AA v2 para execução de tarefas reais aumentou de 642 para 1140. O mais interessante é que este modelo de categoria inferior realmente superou seu homólogo de categoria superior 3Flash em muitas tarefas de agentes e código, como SWE-Bench Pro (54,2% vs. 49,6%) e OSWorld-Verified (74,0% vs. 65,1%), o que significa que tarefas antes tratadas pelo 3Flash agora têm uma alternativa mais rápida e forte. A empresa forneceu vários casos de uso, incluindo a extração de recursos de produtos de dados massivos de comércio eletrônico, atuando como um assistente para o 3.6 Flash para gerar 25 conceitos de design web de uma vez, tradução em lote e resumo de recibos, e jogar e iterar para criar jogos. Os clientes Ashler, Palo Alto Networks e Ramp também elogiaram sua velocidade, inteligência e custo-benefício.
O último, o 3.5 Flash Cyber, adota uma abordagem diferente, especificamente projetado para encontrar e corrigir vulnerabilidades de segurança no código. A lógica da Google é inteligente: a velocidade da IA em encontrar vulnerabilidades já superou a velocidade dos sistemas existentes em corrigi-las, levando a mais vulnerabilidades se acumulando. Em vez disso, eles estão usando o Flash acessível e eficiente para corrigi-las em lote. Este modelo foi ajustado finamente a partir do 3.5 Flash e emparelhado com sua própria ferramenta CodeMender, onde vários agentes Flash Cyber trabalham juntos e depois resumem em um relatório. No benchmark CyberGym conhecido pela indústria, ele alcançou níveis de primeira categoria e usou menos tokens em comparação com modelos maiores. No entanto, este modelo atualmente não está disponível, considerando que a busca por vulnerabilidades é uma faca de dois gumes. A Google seguiu os passos da Anthropic ao adotar uma narrativa de segurança, bloqueando-a firmemente e oferecendo apenas acesso limitado a parceiros confiáveis para testes internos. O objetivo é dar tempo aos defensores de primeira linha para corrigir vulnerabilidades antes que sejam exploradas, ao mesmo tempo em que impede que as pessoas a usem indevidamente.
Neste ponto, você pode se perguntar: onde está o verdadeiro principal, o 3.5Pro? De acordo com a explicação oficial, ele ainda está sendo testado com parceiros e será lançado assim que estiver pronto. No entanto, a história por trás dessa afirmação pode não ser tão tranquila. De acordo com relatórios da Bloomberg e outros, a capacidade de geração de código do 3.5Pro nunca atendeu às expectativas internas. A Google atualizou seus dados de treinamento novamente no final de junho para compensar as deficiências de código, mas os resultados ainda não melhoraram. Há até rumores de que a Google descartou completamente o plano de treinamento original e começou do zero. Enquanto isso, o porta-voz da Google AI, Logan Kilpatrick, pulou abertamente o 3.5Pro em declarações públicas, deslocando o foco para o Gemini4, afirmando que o maior e mais ambicioso pré-treinamento do Gemini4 já começou, com progresso emocionante. Dado o pano de fundo do atraso do principal, isso parece uma distração ou uma promessa para prolongar a ilusão.
Ao analisar apenas os modelos Flash lançados hoje, os internautas não compram totalmente a ideia. A agência de avaliação de terceiros Artificial Analysis afirmou que os dois novos modelos realmente cortaram o tempo por tarefa pela metade e melhoraram a eficiência dos tokens, com o índice de inteligência do Flash-Lite aumentando em 11 pontos. No entanto, o nível de inteligência do 3.6 Flash em comparação com o 3.5 Flash permaneceu basicamente inalterado. O preço não caiu o suficiente para ignorar a lacuna de capacidade, nem a capacidade subiu o suficiente para justificar o custo. Na plataforma X, alguns usuários criticaram que o 3.6 Flash marcou exatamente o mesmo que o 3.5 Flash na Artificial Analysis, e é pior do que concorrentes como Meta Spark1.1, GLM-5.2, 5.6Luna, Sonnet5, Grok4.5, 5.6Terra, chamando-o de simplesmente terrível.
O usuário Angel abordou a questão do ponto de vista do custo-benefício, apontando que o custo de uso do 3.6 Flash é maior do que o GPT-5.6Sol médio, mas seu nível de inteligência é menor, criando uma combinaçãoawkward. Afinal, a base da série Flash é o custo-benefício, mas agora foi apontado que seu valor é pior do que o dos concorrentes, equivalente a sabotagem própria. Como comparação, o Tibo da OpenAI também falou recentemente, afirmando que, devido ao número de usuários ativos semanais atingir 10 milhões, os usuários pagos do Codex e do ChatGPT Work receberam uma nova rodada de redefinição de cota. Esse contraste e disparidade, as pessoas ainda se lembram do Google Gemini3 à beira do lago?
Testadores do mundo real também alimentaram as chamas. O usuário Balder criticou diretamente, dizendo que o desempenho desses três modelos é pior do que o anterior 3.5 Flash, com problemas que incluem, mas não se limitam a, erros básicos de decodificação, escolhas estranhas de palavras em chinês, qualidade ruim de imagens e vídeos, incompatibilidade com instruções, limitações severas, confusão frequente de memória e chamadas incorretas de ferramentas. Ele até levantou uma teoria da conspiração, sugerindo que a Google fez isso para liberar poder de computação para vender à Anthropic, dizendo ironicamente que este é o desejo do Pichai - Cloud First. O usuário do X Conor Dart executou um teste de jogo gerado por IA usando o próprio Antigravity da Google, resultando em texturas de madeira piores e mármore que pareciam quase semelhantes, mas ainda não podiam ser usados. Ele chamou diretamente de outro fracasso, dizendo que preferiria esperar pelo Gemini3.5 ou 3.6Pro.
De um lado, as contas oficiais destacam mais eficiência, preços mais baratos e menos tokens. Do outro lado, a maioria dos internautas deu feedback negativo, junto com uma série de más notícias por trás dos modelos, como o atraso do principal, a saída de talentos do topo e o encolhimento do valor de mercado. É difícil não se perguntar se a Google realmente errou seu caminho tecnológico, focando demais na economia de custos e esquecendo de melhorar a inteligência, dependendo apenas de alguns modelos Flash para estabilizar a situação. De qualquer forma, o pré-treinamento do Gemini4 já começou. Se esta tentativa também falhar, a piada sobre o Alzheimer poderia realmente se tornar uma profecia.
Artigo relacionado
 Como funciona o algoritmo do Google Japão para SEO?
Miniaturas Geradas por IA do MrBeastSumárioIntroduçãoDesafio de Transformação Física do Mr BeastExplorando Conceitos de Miniatura para o DesafioAprimorando a Física do Mr Beast nas FotosAplicando Técnicas de IA para Transformações FísicasCrian
Qwen da Aliyun atinge 30 milhões de usuários no primeiro mês; contexto de código aberto impulsiona novo paradigma de agentes empresariais
Apenas um mês após o seu lançamento, o pacote de escritório de IA do Alibaba, “QwenWork”, conquistou uma tração notável, ultrapassando 30 milhões de usuários, com mais da metade sendo clientes empresariais, o que sinaliza um aumento significativo na
Grandes Modelos de IA Adotam IPv6 à Medida que a Nova Área de Xiongan Lidera Pilotagem de Rede Autônoma
O Administrador do Ciberespaço da China, em conjunto com os reguladores de Pequim, Xangai, Zhejiang e Shenzhen, estabeleceu uma parceria com cinco grandes provedores de modelos de inteligência artificial para lançar a "Ação Especial de Aprimoramento
Recomendações de tópicos especiais relacionados
Design e Arte
 As melhores ferramentas de ilustração com IA: crie cenas editoriais e capas de forma mais rápida
As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
 10 ferramentas
 xix.ai
Educação e Aprendizagem
Os melhores professores particulares especializados em IA para preparação para exames: pratique matemática, ciências e inglês
Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai
Financiar
Ferramentas de planejamento orçamentário com IA para gestão financeira pessoal
As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai
Saúde e Bem-Estar
Assistentes de rastreamento do sono com IA: melhore sua recuperação adotando hábitos mais adequados antes de dormir
2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai
Análise de dados
Copilotos de IA em SQL para análise de produtos e receitas
2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai
Educação e Aprendizagem
Os melhores auxiliares de tarefas escolares com IA que ensinam: aprenda conceitos, não apenas respostas
2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai

 Comentários (0)
Se você tem usado o Gemini desde o ano passado, a piada popular mais recente é: é como assistir ao seu próprio irmão desenvolver gradualmente Alzheimer. Normalmente, quando uma empresa lança um novo modelo, ele deve ser usado para refutar esse tipo de piada. Mas agora, após a Google revelar três novos modelos, em vez de retratar essa afirmação, os internautas riram ainda mais alto, dando a sensação de "eles não acreditavam em você, e você acabou sendo o mais decepcionante". Esses três modelos são 3.6 Flash, 3.5 Flash-Lite e 3.5 Flash Cyber para segurança cibernética. A redação no blog oficial ainda é familiar: mais eficiente, mais inteligente, construído para agentes de IA em larga escala, sem perder o ritmo. No entanto, a experiência prática é drasticamente diferente.
Começando pelo principal 3.6 Flash. É uma atualização de versão menor do 3.5 Flash da conferência I/O de maio deste ano, e o posicionamento oficial é como um modelo de trabalho árduo. O maior ponto de venda desta geração é economizar tokens: de acordo com os dados do Índice Artificial Analysis, o 3.6 Flash usa 17% menos tokens de saída do que o 3.5 Flash, e até 65% menos em cenários DeepSWE. Ao executar tarefas em várias etapas, o número de etapas de raciocínio e chamadas de ferramentas também é reduzido. O preço realmente caiu, para US$ 1,5 por milhão de tokens de entrada e US$ 7,5 por milhão de tokens de saída, enquanto o preço de saída do 3.5 Flash anterior era de US$ 9. Isso reduz diretamente para US$ 7,5, tornando-o mais rápido e com melhor custo-benefício, com o custo de uma única tarefa de agente significativamente reduzido.
Nos testes de benchmark, a capacidade de código foi um foco, com o DeepSWE subindo de 37% para 49%. A afirmação oficial é de que há menos alterações de código desnecessárias, loops de execução mais curtos e código gerado mais próximo dos requisitos de produção; o MLE Bench para pesquisa de aprendizado de máquina viu um aumento mais significativo, de 49,7% para 63,9%; o OSWorld-Verified para operações de computador subiu de 78,4% para 83%, e as operações de computador se tornaram uma ferramenta integrada na API do Gemini e na edição empresarial, prontas para uso imediatamente. Uma atualização menor, mas prática, é que a data de corte do conhecimento finalmente foi empurrada de janeiro de 2025 para março de 2026, finalmente se afastando do calendário antigo. Em termos de segurança, a afirmação oficial é de que o 3.6 Flash tem uma proteção Frontier Safety aprimorada, focando em dois tipos de abuso: ataques químicos, biológicos, radiológicos, nucleares e cibernéticos, com resistência mais forte a quebras de segurança (jailbreaking), enquanto tenta não prejudicar necessidades normais e minimiza rejeições desnecessárias.
A próxima categoria abaixo é o 3.5 Flash-Lite, que foca em velocidade e acessibilidade, direcionado a tarefas de alto throughput e baixa latência, como pesquisa de agentes e processamento de documentos. É o mais rápido da série 3.5, capaz de gerar 350 tokens por segundo, de acordo com as medições da Artificial Analysis. O preço é extremamente barato, US$ 0,3 para entrada e US$ 2,5 para saída por milhão de tokens, com qualidade significativamente melhor do que o 3.1 Flash-Lite lançado em março. Ele suporta ajustar o nível de raciocínio, onde tarefas de nível inferior podem ser executadas no nível mais baixo para velocidade e eficiência, e ao enfrentar sub-tarefas complexas que exigem várias etapas, ele pode ajustar o nível de pensamento para cima. As operações de computador também foram transformadas em uma ferramenta integrada.
Melhorias significativas: o Terminal-Bench2.1 para tarefas de código e agentes saltou de 31% para 54%, o GDM-MRCR v2 para contexto longo melhorou de 60,1% para 72,2%, e o GDPval-AA v2 para execução de tarefas reais aumentou de 642 para 1140. O mais interessante é que este modelo de categoria inferior realmente superou seu homólogo de categoria superior 3Flash em muitas tarefas de agentes e código, como SWE-Bench Pro (54,2% vs. 49,6%) e OSWorld-Verified (74,0% vs. 65,1%), o que significa que tarefas antes tratadas pelo 3Flash agora têm uma alternativa mais rápida e forte. A empresa forneceu vários casos de uso, incluindo a extração de recursos de produtos de dados massivos de comércio eletrônico, atuando como um assistente para o 3.6 Flash para gerar 25 conceitos de design web de uma vez, tradução em lote e resumo de recibos, e jogar e iterar para criar jogos. Os clientes Ashler, Palo Alto Networks e Ramp também elogiaram sua velocidade, inteligência e custo-benefício.
O último, o 3.5 Flash Cyber, adota uma abordagem diferente, especificamente projetado para encontrar e corrigir vulnerabilidades de segurança no código. A lógica da Google é inteligente: a velocidade da IA em encontrar vulnerabilidades já superou a velocidade dos sistemas existentes em corrigi-las, levando a mais vulnerabilidades se acumulando. Em vez disso, eles estão usando o Flash acessível e eficiente para corrigi-las em lote. Este modelo foi ajustado finamente a partir do 3.5 Flash e emparelhado com sua própria ferramenta CodeMender, onde vários agentes Flash Cyber trabalham juntos e depois resumem em um relatório. No benchmark CyberGym conhecido pela indústria, ele alcançou níveis de primeira categoria e usou menos tokens em comparação com modelos maiores. No entanto, este modelo atualmente não está disponível, considerando que a busca por vulnerabilidades é uma faca de dois gumes. A Google seguiu os passos da Anthropic ao adotar uma narrativa de segurança, bloqueando-a firmemente e oferecendo apenas acesso limitado a parceiros confiáveis para testes internos. O objetivo é dar tempo aos defensores de primeira linha para corrigir vulnerabilidades antes que sejam exploradas, ao mesmo tempo em que impede que as pessoas a usem indevidamente.
Neste ponto, você pode se perguntar: onde está o verdadeiro principal, o 3.5Pro? De acordo com a explicação oficial, ele ainda está sendo testado com parceiros e será lançado assim que estiver pronto. No entanto, a história por trás dessa afirmação pode não ser tão tranquila. De acordo com relatórios da Bloomberg e outros, a capacidade de geração de código do 3.5Pro nunca atendeu às expectativas internas. A Google atualizou seus dados de treinamento novamente no final de junho para compensar as deficiências de código, mas os resultados ainda não melhoraram. Há até rumores de que a Google descartou completamente o plano de treinamento original e começou do zero. Enquanto isso, o porta-voz da Google AI, Logan Kilpatrick, pulou abertamente o 3.5Pro em declarações públicas, deslocando o foco para o Gemini4, afirmando que o maior e mais ambicioso pré-treinamento do Gemini4 já começou, com progresso emocionante. Dado o pano de fundo do atraso do principal, isso parece uma distração ou uma promessa para prolongar a ilusão.
Ao analisar apenas os modelos Flash lançados hoje, os internautas não compram totalmente a ideia. A agência de avaliação de terceiros Artificial Analysis afirmou que os dois novos modelos realmente cortaram o tempo por tarefa pela metade e melhoraram a eficiência dos tokens, com o índice de inteligência do Flash-Lite aumentando em 11 pontos. No entanto, o nível de inteligência do 3.6 Flash em comparação com o 3.5 Flash permaneceu basicamente inalterado. O preço não caiu o suficiente para ignorar a lacuna de capacidade, nem a capacidade subiu o suficiente para justificar o custo. Na plataforma X, alguns usuários criticaram que o 3.6 Flash marcou exatamente o mesmo que o 3.5 Flash na Artificial Analysis, e é pior do que concorrentes como Meta Spark1.1, GLM-5.2, 5.6Luna, Sonnet5, Grok4.5, 5.6Terra, chamando-o de simplesmente terrível.
O usuário Angel abordou a questão do ponto de vista do custo-benefício, apontando que o custo de uso do 3.6 Flash é maior do que o GPT-5.6Sol médio, mas seu nível de inteligência é menor, criando uma combinaçãoawkward. Afinal, a base da série Flash é o custo-benefício, mas agora foi apontado que seu valor é pior do que o dos concorrentes, equivalente a sabotagem própria. Como comparação, o Tibo da OpenAI também falou recentemente, afirmando que, devido ao número de usuários ativos semanais atingir 10 milhões, os usuários pagos do Codex e do ChatGPT Work receberam uma nova rodada de redefinição de cota. Esse contraste e disparidade, as pessoas ainda se lembram do Google Gemini3 à beira do lago?
Testadores do mundo real também alimentaram as chamas. O usuário Balder criticou diretamente, dizendo que o desempenho desses três modelos é pior do que o anterior 3.5 Flash, com problemas que incluem, mas não se limitam a, erros básicos de decodificação, escolhas estranhas de palavras em chinês, qualidade ruim de imagens e vídeos, incompatibilidade com instruções, limitações severas, confusão frequente de memória e chamadas incorretas de ferramentas. Ele até levantou uma teoria da conspiração, sugerindo que a Google fez isso para liberar poder de computação para vender à Anthropic, dizendo ironicamente que este é o desejo do Pichai - Cloud First. O usuário do X Conor Dart executou um teste de jogo gerado por IA usando o próprio Antigravity da Google, resultando em texturas de madeira piores e mármore que pareciam quase semelhantes, mas ainda não podiam ser usados. Ele chamou diretamente de outro fracasso, dizendo que preferiria esperar pelo Gemini3.5 ou 3.6Pro.
De um lado, as contas oficiais destacam mais eficiência, preços mais baratos e menos tokens. Do outro lado, a maioria dos internautas deu feedback negativo, junto com uma série de más notícias por trás dos modelos, como o atraso do principal, a saída de talentos do topo e o encolhimento do valor de mercado. É difícil não se perguntar se a Google realmente errou seu caminho tecnológico, focando demais na economia de custos e esquecendo de melhorar a inteligência, dependendo apenas de alguns modelos Flash para estabilizar a situação. De qualquer forma, o pré-treinamento do Gemini4 já começou. Se esta tentativa também falhar, a piada sobre o Alzheimer poderia realmente se tornar uma profecia.








 Como funciona o algoritmo do Google Japão para SEO?
Miniaturas Geradas por IA do MrBeastSumárioIntroduçãoDesafio de Transformação Física do Mr BeastExplorando Conceitos de Miniatura para o DesafioAprimorando a Física do Mr Beast nas FotosAplicando Técnicas de IA para Transformações FísicasCrian
 Qwen da Aliyun atinge 30 milhões de usuários no primeiro mês; contexto de código aberto impulsiona novo paradigma de agentes empresariais
Apenas um mês após o seu lançamento, o pacote de escritório de IA do Alibaba, “QwenWork”, conquistou uma tração notável, ultrapassando 30 milhões de usuários, com mais da metade sendo clientes empresariais, o que sinaliza um aumento significativo na
 Grandes Modelos de IA Adotam IPv6 à Medida que a Nova Área de Xiongan Lidera Pilotagem de Rede Autônoma
O Administrador do Ciberespaço da China, em conjunto com os reguladores de Pequim, Xangai, Zhejiang e Shenzhen, estabeleceu uma parceria com cinco grandes provedores de modelos de inteligência artificial para lançar a "Ação Especial de Aprimoramento

As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
10 ferramentas
xix.ai

Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai

2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai












