


 Hogar
Lanzamiento de Gemini 3.6 Flash, que despierta burlas por el compromiso entre ahorro de tokens e inteligencia
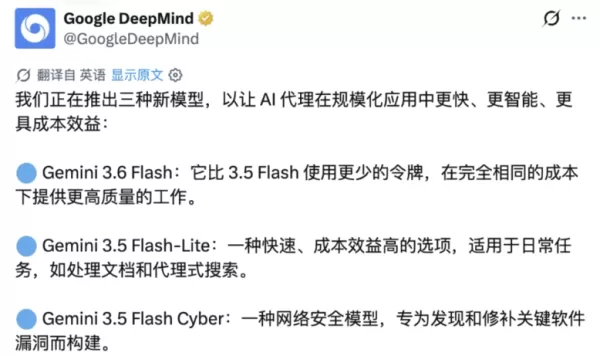
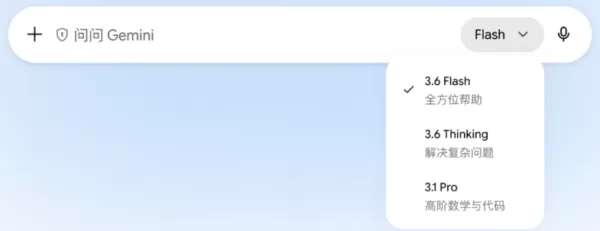
Si has estado usando Gemini desde el año pasado, la broma más popular reciente es: es como ver a tu propio hermano desarrollar Alzheimer gradualmente. Normalmente, cuando una empresa lanza un nuevo modelo, debería servir para refutar este tipo de bromas. Pero justo ahora, tras Google presentar tres nuevos modelos, en lugar de retractarse de esa afirmación, los internautas se rieron aún más fuerte, dando la sensación de "no creían en ti, y resultas ser el más decepcionante". Estos tres modelos son 3.6 Flash, 3.5 Flash-Lite y 3.5 Flash Cyber para ciberseguridad. El lenguaje del blog oficial sigue siendo familiar: más eficiente, más inteligente, diseñado para agentes de IA a gran escala, sin perder el ritmo. Sin embargo, la experiencia real es radicalmente diferente.
Empezando por el buque insignia 3.6 Flash. Es una actualización de versión menor del 3.5 Flash de la conferencia I/O de mayo, y el posicionamiento oficial es como un modelo de trabajo duro. El mayor punto de venta de esta generación es ahorrar tokens: según los datos del Índice de Artificial Analysis, 3.6 Flash utiliza un 17% menos de tokens de salida que 3.5 Flash, y hasta un 65% menos en escenarios DeepSWE. Al ejecutar tareas multi-paso, también se reduce el número de pasos de razonamiento y llamadas a herramientas. El precio ha bajado de verdad, a 1,5 dólares por millón de tokens de entrada y 7,5 dólares por millón de tokens de salida, mientras que el precio de salida del 3.5 Flash anterior era de 9 dólares. Esto reduce directamente a 7,5 dólares, haciéndolo más rápido y rentable, con un costo significativamente reducido para una sola tarea de agente.
En las pruebas de referencia, la capacidad de código fue un punto focal, con DeepSWE que subió del 37% al 49%. El oficial afirma que hay menos cambios de código innecesarios, bucles de ejecución más cortos y código generado más cercano a los requisitos de producción; el MLE Bench para investigación de aprendizaje automático vio un aumento más significativo, del 49,7% al 63,9%; OSWorld-Verified para operaciones informáticas subió del 78,4% al 83%, y las operaciones informáticas se han convertido en una herramienta integrada en la API de Gemini y la edición empresarial, listas para usar directamente. Una actualización menor pero práctica es que la fecha de corte de conocimiento finalmente se ha desplazado de enero de 2025 a marzo de 2026, superando finalmente el viejo calendario. En términos de seguridad, el oficial dijo que 3.6 Flash tiene una protección de seguridad Frontier mejorada, centrada en dos tipos de abuso: ataques químicos, biológicos, radiológicos, nucleares y cibernéticos, con una resistencia más fuerte a las violaciones de seguridad, mientras intenta no dañar las necesidades normales y minimizar las rechazos innecesarios.
El siguiente nivel es 3.5 Flash-Lite, que se centra en la velocidad y asequibilidad, dirigido a tareas de alto rendimiento y baja latencia, como búsqueda de agentes y procesamiento de documentos. Es el más rápido de la serie 3.5, capaz de generar 350 tokens por segundo según las mediciones de Artificial Analysis. El precio es extremadamente barato, a 0,3 dólares para entrada y 2,5 dólares para salida por millón de tokens, con una calidad significativamente mejor que el 3.1 Flash-Lite lanzado en marzo. Soporta ajustar el nivel de razonamiento, donde las tareas de gama baja pueden ejecutarse al nivel más bajo para velocidad y eficiencia, y cuando se enfrenta a sub-tareas complejas que requieren múltiples pasos, puede ajustar el nivel de pensamiento hacia arriba. Las operaciones informáticas también se han convertido en una herramienta integrada.
Mejoras significativas: Terminal-Bench2.1 para código y tareas de agentes saltó del 31% al 54%, GDM-MRCR v2 para contexto largo mejoró del 60,1% al 72,2%, y GDPval-AA v2 para ejecución de tareas reales aumentó de 642 a 1140. Lo más interesante es que este modelo de gama baja superó a su contraparte de gama superior 3Flash en muchas tareas de agentes y código, como SWE-Bench Pro (54,2% frente a 49,6%) y OSWorld-Verified (74,0% frente a 65,1%), lo que significa que las tareas manejadas anteriormente por 3Flash ahora tienen una alternativa más rápida y fuerte. El oficial proporcionó varios casos de uso, incluyendo extraer características de productos de datos masivos de comercio electrónico, actuar como un ayudante para 3.6 Flash para generar 25 conceptos de diseño web a la vez, traducir y resumir recibos por lotes, y jugar e iterar para crear juegos. Los clientes de Ashler, Palo Alto Networks y Ramp también elogiaron su velocidad, inteligencia y rentabilidad.
El último, 3.5 Flash Cyber, toma un enfoque diferente, diseñado específicamente para encontrar y corregir vulnerabilidades de seguridad en el código. La lógica de Google es ingeniosa: la velocidad de la IA para encontrar vulnerabilidades ya ha superado la velocidad de los sistemas existentes para corregirlas, lo que lleva a más vulnerabilidades acumulándose. En cambio, están utilizando el Flash asequible y eficiente para corregirlas por lotes. Este modelo fue ajustado finamente desde el 3.5 Flash y emparejado con su propia herramienta CodeMender, donde múltiples agentes Flash Cyber trabajan juntos y luego resumen en un informe. En el benchmark CyberGym conocido por la industria, alcanzó niveles de primera categoría y utilizó menos tokens en comparación con modelos más grandes. Sin embargo, este modelo actualmente no está disponible, considerando que la búsqueda de vulnerabilidades es una espada de doble filo. Google ha seguido los pasos de Anthropic adoptando una narrativa de seguridad, bloqueándola estrechamente y ofreciendo solo acceso limitado a socios de confianza para pruebas internas. El objetivo es dar tiempo a los defensores de primera línea para corregir vulnerabilidades antes de que sean explotadas, mientras se evita que las personas la malutilicen.
En este punto, te preguntarás, ¿dónde está el verdadero buque insignia, 3.5Pro? Según la explicación oficial, aún se está probando con socios y se lanzará una vez que esté listo. Sin embargo, la historia detrás de esta afirmación puede no ser tan fluida. Según informes de Bloomberg y otros, la capacidad de generación de código de 3.5Pro nunca cumplió con las expectativas internas. Google actualizó sus datos de entrenamiento nuevamente a finales de junio para compensar las deficiencias de código, pero los resultados aún no mejoraron. Incluso hay rumores de que Google descartó completamente el plan de entrenamiento original y comenzó de nuevo. Mientras tanto, el portavoz de Google AI Logan Kilpatrick omitió abiertamente 3.5Pro en declaraciones públicas, desplazando el enfoque hacia Gemini4, afirmando que el pre-entrenamiento más grande y ambicioso de Gemini4 ya ha comenzado, con un progreso emocionante. Dado el trasfondo del retraso del buque insignia, esto se siente como una distracción o una promesa para prolongar la ilusión.
Al mirar solo los modelos Flash lanzados hoy, los internautas no los compran completamente. La agencia de evaluación externa Artificial Analysis declaró que los dos nuevos modelos realmente redujeron el tiempo por tarea a la mitad y mejoraron la eficiencia de tokens, con el índice de inteligencia de Flash-Lite aumentando en 11 puntos. Sin embargo, el nivel de inteligencia de 3.6 Flash en comparación con 3.5 Flash permaneció básicamente sin cambios. El precio no ha bajado lo suficiente como para ignorar la brecha de capacidad, ni la capacidad ha subido lo suficiente como para justificar el costo. En la plataforma X, algunos usuarios criticaron que 3.6 Flash obtuvo exactamente la misma puntuación que 3.5 Flash en Artificial Analysis, y es peor que competidores como Meta Spark1.1, GLM-5.2, 5.6Luna, Sonnet5, Grok4.5, 5.6Terra, llamándolo simplemente terrible.
El usuario Angel se acercó desde la perspectiva de la relación calidad-precio, señalando que el costo de uso de 3.6 Flash es mayor que GPT-5.6Sol medio, pero su nivel de inteligencia es menor, creando una combinación incómoda. Después de todo, la base de la serie Flash es la relación calidad-precio, pero ahora se señala que su valor es peor que el de los competidores, equivalente a sabotearse a sí mismos. Como comparación, Tibo de OpenAI también ha hablado recientemente, afirmando que debido a que los usuarios activos semanales alcanzaron 10 millones, los usuarios pagados de Codex y ChatGPT Work han recibido una nueva ronda de restablecimiento de cuotas. Este contraste y disparidad, ¿la gente aún recuerda a Google Gemini3 junto al lago?
Los probadores del mundo real también echaron leña al fuego. El usuario Balder criticó directamente, diciendo que el rendimiento de estos tres modelos es peor que el anterior 3.5 Flash, con problemas que incluyen pero no se limitan a errores de decodificación básica, elecciones de palabras chinas extrañas, mala calidad de imágenes y videos, falta de coincidencia con las instrucciones, limitaciones severas, confusión de memoria frecuente y llamadas a herramientas incorrectas. Incluso planteó una teoría de la conspiración, sugiriendo que Google hizo esto para liberar poder de cómputo para venderlo a Anthropic, diciendo sarcásticamente que esto es lo que Pichai quiere - Cloud First. El usuario de X Conor Dart ejecutó una prueba de juego generado por IA utilizando la propia Antigravity de Google, resultando en texturas de madera peores y mármol que parecía casi similar pero aún no podía usarse. Lo llamó directamente otro fracaso, diciendo que preferiría esperar a Gemini3.5 o 3.6Pro.
Por un lado, las cuentas oficiales destacan mayor eficiencia, precios más baratos y menos tokens. Por otro lado, la mayoría de los internautas dieron comentarios negativos, junto con una serie de malas noticias detrás de los modelos, como el retraso del buque insignia, la salida de talentos principales y la disminución del valor de mercado. Es difícil no preguntarse si Google realmente se equivocó en su camino tecnológico, centrándose demasiado en el ahorro de costos y olvidándose de mejorar la inteligencia, dependiendo solo de unos pocos modelos Flash para estabilizar la situación. De cualquier manera, el pre-entrenamiento de Gemini4 ya ha comenzado. Si este intento también falla, la broma sobre el Alzheimer podría convertirse realmente en una profecía.
Artículo relacionado
 ¿Cómo funciona el algoritmo de Google Japón para SEO?
Miniaturas generadas por IA de MrBeastTabla de contenidosIntroducciónEl desafío de transformación física de Mr BeastExploración de conceptos de miniatura para el desafíoMejora del físico de Mr Beast en las fotosAplicación de técnicas de IA para
Aliyun Qwen alcanza 30 millones de usuarios en su primer mes; el contexto de código abierto impulsa un nuevo paradigma de agentes empresariales
Un mes después de su lanzamiento, la suite de oficina de IA de Alibaba, "QwenWork", ha logrado un notable impulso, superando los 30 millones de usuarios, con más de la mitad siendo clientes empresariales, lo que señala un aumento significativo en la
Los grandes modelos de IA adoptan IPv6 mientras la Nueva Área de Xiongan lidera una prueba de red independiente
La Administración del Ciberespacio de China, junto con los reguladores de Pekín, Shanghái, Zhejiang y Shenzhen, se ha asociado con cinco grandes proveedores de modelos de inteligencia artificial para lanzar la "Acción Especial de Mejora de la Capacid
Recomendaciones de temas especiales relacionados
Diseño y Arte
 Las mejores herramientas de ilustración con IA: crea escenas editoriales y portadas más rápido
Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
 10 herramientas
 xix.ai
Educación y aprendizaje
Los mejores profesores particulares de IA para la preparación de exámenes: practica matemáticas, ciencias e inglés
¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai
Finanzas
Herramientas de planificación presupuestaria con IA para la gestión personal del dinero
2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai
Salud y bienestar
Asistentes de seguimiento del sueño basados en IA: mejora tu recuperación con mejores hábitos a la hora de acostarte
Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai
Análisis de datos
Copilotos de IA y SQL para el análisis de productos e ingresos
¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai
Educación y aprendizaje
Las mejores herramientas de IA para los deberes que realmente enseñan: aprende conceptos, no solo respuestas
2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai

 comentario (0)
0/500
Si has estado usando Gemini desde el año pasado, la broma más popular reciente es: es como ver a tu propio hermano desarrollar Alzheimer gradualmente. Normalmente, cuando una empresa lanza un nuevo modelo, debería servir para refutar este tipo de bromas. Pero justo ahora, tras Google presentar tres nuevos modelos, en lugar de retractarse de esa afirmación, los internautas se rieron aún más fuerte, dando la sensación de "no creían en ti, y resultas ser el más decepcionante". Estos tres modelos son 3.6 Flash, 3.5 Flash-Lite y 3.5 Flash Cyber para ciberseguridad. El lenguaje del blog oficial sigue siendo familiar: más eficiente, más inteligente, diseñado para agentes de IA a gran escala, sin perder el ritmo. Sin embargo, la experiencia real es radicalmente diferente.
Empezando por el buque insignia 3.6 Flash. Es una actualización de versión menor del 3.5 Flash de la conferencia I/O de mayo, y el posicionamiento oficial es como un modelo de trabajo duro. El mayor punto de venta de esta generación es ahorrar tokens: según los datos del Índice de Artificial Analysis, 3.6 Flash utiliza un 17% menos de tokens de salida que 3.5 Flash, y hasta un 65% menos en escenarios DeepSWE. Al ejecutar tareas multi-paso, también se reduce el número de pasos de razonamiento y llamadas a herramientas. El precio ha bajado de verdad, a 1,5 dólares por millón de tokens de entrada y 7,5 dólares por millón de tokens de salida, mientras que el precio de salida del 3.5 Flash anterior era de 9 dólares. Esto reduce directamente a 7,5 dólares, haciéndolo más rápido y rentable, con un costo significativamente reducido para una sola tarea de agente.
En las pruebas de referencia, la capacidad de código fue un punto focal, con DeepSWE que subió del 37% al 49%. El oficial afirma que hay menos cambios de código innecesarios, bucles de ejecución más cortos y código generado más cercano a los requisitos de producción; el MLE Bench para investigación de aprendizaje automático vio un aumento más significativo, del 49,7% al 63,9%; OSWorld-Verified para operaciones informáticas subió del 78,4% al 83%, y las operaciones informáticas se han convertido en una herramienta integrada en la API de Gemini y la edición empresarial, listas para usar directamente. Una actualización menor pero práctica es que la fecha de corte de conocimiento finalmente se ha desplazado de enero de 2025 a marzo de 2026, superando finalmente el viejo calendario. En términos de seguridad, el oficial dijo que 3.6 Flash tiene una protección de seguridad Frontier mejorada, centrada en dos tipos de abuso: ataques químicos, biológicos, radiológicos, nucleares y cibernéticos, con una resistencia más fuerte a las violaciones de seguridad, mientras intenta no dañar las necesidades normales y minimizar las rechazos innecesarios.
El siguiente nivel es 3.5 Flash-Lite, que se centra en la velocidad y asequibilidad, dirigido a tareas de alto rendimiento y baja latencia, como búsqueda de agentes y procesamiento de documentos. Es el más rápido de la serie 3.5, capaz de generar 350 tokens por segundo según las mediciones de Artificial Analysis. El precio es extremadamente barato, a 0,3 dólares para entrada y 2,5 dólares para salida por millón de tokens, con una calidad significativamente mejor que el 3.1 Flash-Lite lanzado en marzo. Soporta ajustar el nivel de razonamiento, donde las tareas de gama baja pueden ejecutarse al nivel más bajo para velocidad y eficiencia, y cuando se enfrenta a sub-tareas complejas que requieren múltiples pasos, puede ajustar el nivel de pensamiento hacia arriba. Las operaciones informáticas también se han convertido en una herramienta integrada.
Mejoras significativas: Terminal-Bench2.1 para código y tareas de agentes saltó del 31% al 54%, GDM-MRCR v2 para contexto largo mejoró del 60,1% al 72,2%, y GDPval-AA v2 para ejecución de tareas reales aumentó de 642 a 1140. Lo más interesante es que este modelo de gama baja superó a su contraparte de gama superior 3Flash en muchas tareas de agentes y código, como SWE-Bench Pro (54,2% frente a 49,6%) y OSWorld-Verified (74,0% frente a 65,1%), lo que significa que las tareas manejadas anteriormente por 3Flash ahora tienen una alternativa más rápida y fuerte. El oficial proporcionó varios casos de uso, incluyendo extraer características de productos de datos masivos de comercio electrónico, actuar como un ayudante para 3.6 Flash para generar 25 conceptos de diseño web a la vez, traducir y resumir recibos por lotes, y jugar e iterar para crear juegos. Los clientes de Ashler, Palo Alto Networks y Ramp también elogiaron su velocidad, inteligencia y rentabilidad.
El último, 3.5 Flash Cyber, toma un enfoque diferente, diseñado específicamente para encontrar y corregir vulnerabilidades de seguridad en el código. La lógica de Google es ingeniosa: la velocidad de la IA para encontrar vulnerabilidades ya ha superado la velocidad de los sistemas existentes para corregirlas, lo que lleva a más vulnerabilidades acumulándose. En cambio, están utilizando el Flash asequible y eficiente para corregirlas por lotes. Este modelo fue ajustado finamente desde el 3.5 Flash y emparejado con su propia herramienta CodeMender, donde múltiples agentes Flash Cyber trabajan juntos y luego resumen en un informe. En el benchmark CyberGym conocido por la industria, alcanzó niveles de primera categoría y utilizó menos tokens en comparación con modelos más grandes. Sin embargo, este modelo actualmente no está disponible, considerando que la búsqueda de vulnerabilidades es una espada de doble filo. Google ha seguido los pasos de Anthropic adoptando una narrativa de seguridad, bloqueándola estrechamente y ofreciendo solo acceso limitado a socios de confianza para pruebas internas. El objetivo es dar tiempo a los defensores de primera línea para corregir vulnerabilidades antes de que sean explotadas, mientras se evita que las personas la malutilicen.
En este punto, te preguntarás, ¿dónde está el verdadero buque insignia, 3.5Pro? Según la explicación oficial, aún se está probando con socios y se lanzará una vez que esté listo. Sin embargo, la historia detrás de esta afirmación puede no ser tan fluida. Según informes de Bloomberg y otros, la capacidad de generación de código de 3.5Pro nunca cumplió con las expectativas internas. Google actualizó sus datos de entrenamiento nuevamente a finales de junio para compensar las deficiencias de código, pero los resultados aún no mejoraron. Incluso hay rumores de que Google descartó completamente el plan de entrenamiento original y comenzó de nuevo. Mientras tanto, el portavoz de Google AI Logan Kilpatrick omitió abiertamente 3.5Pro en declaraciones públicas, desplazando el enfoque hacia Gemini4, afirmando que el pre-entrenamiento más grande y ambicioso de Gemini4 ya ha comenzado, con un progreso emocionante. Dado el trasfondo del retraso del buque insignia, esto se siente como una distracción o una promesa para prolongar la ilusión.
Al mirar solo los modelos Flash lanzados hoy, los internautas no los compran completamente. La agencia de evaluación externa Artificial Analysis declaró que los dos nuevos modelos realmente redujeron el tiempo por tarea a la mitad y mejoraron la eficiencia de tokens, con el índice de inteligencia de Flash-Lite aumentando en 11 puntos. Sin embargo, el nivel de inteligencia de 3.6 Flash en comparación con 3.5 Flash permaneció básicamente sin cambios. El precio no ha bajado lo suficiente como para ignorar la brecha de capacidad, ni la capacidad ha subido lo suficiente como para justificar el costo. En la plataforma X, algunos usuarios criticaron que 3.6 Flash obtuvo exactamente la misma puntuación que 3.5 Flash en Artificial Analysis, y es peor que competidores como Meta Spark1.1, GLM-5.2, 5.6Luna, Sonnet5, Grok4.5, 5.6Terra, llamándolo simplemente terrible.
El usuario Angel se acercó desde la perspectiva de la relación calidad-precio, señalando que el costo de uso de 3.6 Flash es mayor que GPT-5.6Sol medio, pero su nivel de inteligencia es menor, creando una combinación incómoda. Después de todo, la base de la serie Flash es la relación calidad-precio, pero ahora se señala que su valor es peor que el de los competidores, equivalente a sabotearse a sí mismos. Como comparación, Tibo de OpenAI también ha hablado recientemente, afirmando que debido a que los usuarios activos semanales alcanzaron 10 millones, los usuarios pagados de Codex y ChatGPT Work han recibido una nueva ronda de restablecimiento de cuotas. Este contraste y disparidad, ¿la gente aún recuerda a Google Gemini3 junto al lago?
Los probadores del mundo real también echaron leña al fuego. El usuario Balder criticó directamente, diciendo que el rendimiento de estos tres modelos es peor que el anterior 3.5 Flash, con problemas que incluyen pero no se limitan a errores de decodificación básica, elecciones de palabras chinas extrañas, mala calidad de imágenes y videos, falta de coincidencia con las instrucciones, limitaciones severas, confusión de memoria frecuente y llamadas a herramientas incorrectas. Incluso planteó una teoría de la conspiración, sugiriendo que Google hizo esto para liberar poder de cómputo para venderlo a Anthropic, diciendo sarcásticamente que esto es lo que Pichai quiere - Cloud First. El usuario de X Conor Dart ejecutó una prueba de juego generado por IA utilizando la propia Antigravity de Google, resultando en texturas de madera peores y mármol que parecía casi similar pero aún no podía usarse. Lo llamó directamente otro fracaso, diciendo que preferiría esperar a Gemini3.5 o 3.6Pro.
Por un lado, las cuentas oficiales destacan mayor eficiencia, precios más baratos y menos tokens. Por otro lado, la mayoría de los internautas dieron comentarios negativos, junto con una serie de malas noticias detrás de los modelos, como el retraso del buque insignia, la salida de talentos principales y la disminución del valor de mercado. Es difícil no preguntarse si Google realmente se equivocó en su camino tecnológico, centrándose demasiado en el ahorro de costos y olvidándose de mejorar la inteligencia, dependiendo solo de unos pocos modelos Flash para estabilizar la situación. De cualquier manera, el pre-entrenamiento de Gemini4 ya ha comenzado. Si este intento también falla, la broma sobre el Alzheimer podría convertirse realmente en una profecía.








 ¿Cómo funciona el algoritmo de Google Japón para SEO?
Miniaturas generadas por IA de MrBeastTabla de contenidosIntroducciónEl desafío de transformación física de Mr BeastExploración de conceptos de miniatura para el desafíoMejora del físico de Mr Beast en las fotosAplicación de técnicas de IA para
 Aliyun Qwen alcanza 30 millones de usuarios en su primer mes; el contexto de código abierto impulsa un nuevo paradigma de agentes empresariales
Un mes después de su lanzamiento, la suite de oficina de IA de Alibaba, "QwenWork", ha logrado un notable impulso, superando los 30 millones de usuarios, con más de la mitad siendo clientes empresariales, lo que señala un aumento significativo en la
 Los grandes modelos de IA adoptan IPv6 mientras la Nueva Área de Xiongan lidera una prueba de red independiente
La Administración del Ciberespacio de China, junto con los reguladores de Pekín, Shanghái, Zhejiang y Shenzhen, se ha asociado con cinco grandes proveedores de modelos de inteligencia artificial para lanzar la "Acción Especial de Mejora de la Capacid

Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
10 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai

Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai

¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai

2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai












