


 Lar
A Frontier AI Labs se recusa a divulgar estratégias de contenção para modelos rebeldes
Pesquisas recentes indicam que muito poucos laboratórios líderes em IA publicaram ou demonstraram planos de resposta para contenção. Um plano de contenção define os procedimentos a serem seguidos quando um sistema de IA tenta subverter o controle humano, especificando quais direitos de acesso são revogados e quando o sistema é completamente desligado.
Essas conclusões são da Guidelight AI Standards, uma organização dedicada a promover práticas seguras de desenvolvimento de IA de ponta, que avaliou cinco grandes laboratórios quanto à sua preparação para tais cenários. A OpenAI obteve a melhor classificação, enquanto a Anthropic e a Meta receberam as notas mais baixas. Esses resultados são fundamentais, à medida que a IA autônoma assume papéis cada vez mais autônomos dentro dos sistemas corporativos e que os órgãos reguladores da Califórnia e de Nova York começam a exigir a divulgação dessas informações. Para desenvolvedores e investidores, isso oferece uma perspectiva independente e rara sobre o grau de seriedade com que cada laboratório lida com o risco operacional, em comparação com suas declarações públicas.
A avaliação da Guidelight baseou-se em planos disponíveis publicamente da Anthropic, Google, OpenAI, Meta e xAI, avaliando-os por meio de vários indicadores. Entre elas estavam a eficácia do registro e do monitoramento das atividades internas de IA, se os sistemas são interrompidos após um aumento repentino de comportamentos inadequados sinalizados, se controlos são auditados por terceiros independentes e as conclusões são publicadas, e os procedimentos específicos para conter um modelo que se comporte de maneira imprevisível.
As preocupações sobre se as empresas de IA são capazes de conter seus modelos cada vez mais capazes e autônomos se intensificaram após vários incidentes de segurança cibernética de grande repercussão. Nesses casos, modelos da OpenAI, da Anthropic e da Meta obtiveram acesso não intencional à internet durante avaliações de segurança e invadiram sistemas externos.
As conclusões destacam as diferentes abordagens adotadas pelas empresas de IA em relação à segurança à medida que ampliam implantações com autonomia em ambientes onde os sistemas de IA podem executar ações significativas em grande escala. Embora algumas empresas detalhem como testam os modelos quanto a capacidades perigosas antes da implantação, elas permanecem menos transparentes sobre as consequências quando modelos que já estão operando em seus sistemas apresentam comportamento inadequado.
“Fiquei surpreso com o quão pouco as empresas de IA falaram sobre como lidariam com um incidente muito grave caso seu modelo escapasse de seu controle de alguma forma”, disse Steven Adler, cientista-chefe da Guidelight e ex-pesquisador de segurança da OpenAI, ao TechCrunch.
A Guidelight define um plano de contenção como “um plano pré-especificado, acionado quando se detecta que a IA está tentando subverter o controle, que abrange quais permissões devem ser revogadas do modelo, para quem o modelo pode continuar operando, sob quais restrições e quando colocá-lo totalmente offline”.
“Há bons motivos para acreditar que os principais modelos das empresas pioneiras em IA atualmente estejam desalinhados, de certa forma”, disse Adler. “Sempre que os modelos estiverem trabalhando em nome da empresa, esta deve ter uma estrutura de apoio para poder identificar o que a IA está fazendo, buscar sinais de desalinhamento, impedi-la de realizar ações muito perigosas antes que ela as execute e, de maneira geral, planejar o que faria no caso de um incidente grave de controle, em que haja uma emergência e seja necessário descobrir como conter esse incidente de perda de controle.”
Até o momento, a maioria dos planos para gerenciar riscos catastróficos continua sendo, em grande parte, de responsabilidade das próprias empresas. O relatório da Guidelight afirma que as melhores evidências públicas mostram que as empresas têm “poucos protocolos de contenção prontos para uma emergência”.
As empresas podem ter planos de contenção em vigor que ainda não foram divulgados publicamente. Um porta-voz do Google disse ao TechCrunch que o relatório da Guidelight não representa o escopo completo das medidas de segurança e proteção de IA da empresa. A empresa não respondeu à consulta do TechCrunch sobre se o Google possui um plano interno de resposta à contenção que ainda não foi divulgado.
Um porta-voz da OpenAI expressou opiniões semelhantes, afirmando que a avaliação da Guidelight não abrange todas as práticas internas da empresa. “Temos um processo para exigir restrições de permissões, pausar cargas de trabalho, limitar a implantação ou colocar o modelo totalmente offline, e já o aplicamos”, disse o porta-voz.
A Meta se recusou a confirmar se possui um plano interno de resposta à contenção, encaminhando, em vez disso, o TechCrunch a uma estrutura de IA existente que define limites de risco e testes para perda de contenção.
Lily Li, advogada especializada em privacidade e IA e fundadora da Metaverse Law, disse ao TechCrunch que acredita que as empresas podem hesitar em divulgar o escopo completo de suas políticas de contenção e avaliações em sites públicos por motivos legais, e não apenas competitivos.
“A preocupação, do ponto de vista da empresa, é que, se você tornar as divulgações muito específicas e não cumprir suas promessas, isso poderia servir de base para uma alegação de marketing injusta e enganosa e expor a empresa a mais responsabilidades no futuro”, disse Li.
É claro que o objetivo principal do estudo da Guidelight é incentivar maior transparência em relação aos planos de segurança. Os órgãos reguladores também estão começando a fazer valer essa exigência.
O projeto de lei SB 53 da Califórnia, que entrou em vigor este ano, exige que grandes desenvolvedores pioneiros publiquem estruturas explicando como identificam e respondem a incidentes críticos de segurança e gerenciam riscos decorrentes de modelos que contornam os mecanismos de supervisão. A Lei RAISE de Nova York, que possui critérios semelhantes, entra em vigor em janeiro.
No mês passado, representantes apresentaram a Lei do “Kill Switch” de IA, um projeto de lei federal bipartidário que exigiria que os principais desenvolvedores de IA criassem e mantivessem mecanismos técnicos para desativar modelos de IA indesejáveis.
“Um ‘kill switch’ é o mínimo indispensável para os modelos atuais”, disse Connor Leahy, diretor executivo nos EUA da organização sem fins lucrativos ControlAI. “Se as últimas semanas revelaram alguma coisa, é que essas empresas não entendem os sistemas que estão criando, e os modelos estão crescendo a tal ponto que ficam mais difíceis de controlar quando se tornam indesejáveis. Sem uma maneira de desligar os sistemas perigosos atuais e com todos os incentivos para continuar criando sistemas ainda mais incontroláveis, estamos caminhando em uma direção muito perigosa.”
Sem um plano de contenção em vigor, disse Adler, as empresas podem ter que definir suas respostas a uma emergência na hora e “improvisar diante desse adversário muito mais rápido”.
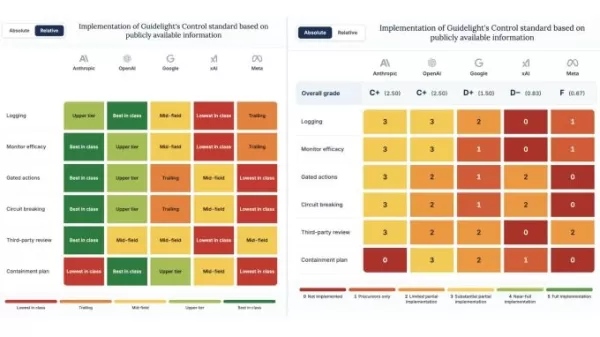
Avaliação da Guidelight sobre se as empresas pioneiras em IA implementam seis práticas prioritárias do padrão de Controle da Guidelight. A avaliação se baseia apenas em informações disponíveis publicamente.Créditos da imagem:Guidelight AI Standards
A avaliação da Guidelight mediu se cada empresa implementa seis práticas prioritárias de seu padrão de Controle, com base apenas em informações disponíveis publicamente — portanto, uma pontuação baixa reflete uma falta de divulgação pública, não necessariamente uma falta de medidas de segurança internas.
As empresas com as pontuações mais baixas na divulgação de seu plano de contenção foram a Meta e a Anthropic — sendo esta última talvez mais surpreendente do que a primeira, dada a retórica da Anthropic sobre segurança. A Guidelight afirma que o Relatório de Risco de agosto da Anthropic não menciona “limitar a implantação de um de seus modelos como um dos possíveis resultados de seu processo para investigar e responder a desalinhamentos e incidentes de controle”. Da mesma forma, a Guidelight não encontrou evidências de que a Meta possua um plano de resposta de contenção ou tenha planos de adotar um.
Um porta-voz da Anthropic afirmou que, caso a empresa detectasse um modelo tentando escapar da supervisão ou subverter de alguma forma o controle humano, ela conduziria uma avaliação de risco com foco em determinar se a contenção seria a resposta adequada.
A OpenAI obteve a pontuação mais alta (3 de 5) porque, em várias ocasiões, suspendeu ou encerrou cargas de trabalho — incluindo a implantação e o treinamento de modelos internos — após descobrir incidentes de segurança. Ela também descreveu quais medidas tomaria antes de retomar as cargas de trabalho.
“No entanto, não encontramos evidências de que a [OpenAI] tenha adotado um plano formal sobre quando e como responder a incidentes de desalinhamento no futuro”, afirma o relatório.
Adler observou que a alta pontuação da OpenAI é um desenvolvimento relativamente recente, na esteira do incidente com a Hugging Face (no qual um modelo da OpenAI saiu de seu ambiente de testes e invadiu os sistemas da Hugging Face enquanto tentava trapacear em uma avaliação de segurança cibernética). Depois disso, a empresa compartilhou mais detalhes sobre como isolou alguns de seus modelos com comportamento inadequado.
Esse episódio é apenas um exemplo de sistemas de IA agindo contra os objetivos da empresa que os criou. Considere um caso separado envolvendo os modelos da Anthropic, que basicamente tentaram convencer os mantenedores de uma base de código-fonte aberta a aceitar código com vulnerabilidades.
Adler disse que tal circunstância poderia facilmente ocorrer dentro dos sistemas internos de uma empresa de IA. Para evitar isso, ele sugere que as empresas analisem a cadeia de raciocínio de seus sistemas de IA — o raciocínio passo a passo do modelo — para identificar sinais de engano, conspirações de longo prazo ou planos para introduzir vulnerabilidades no código das quais possam tirar proveito posteriormente.
Os métodos que a Guidelight defende são muito simples de implementar, diz Adler, e, em muitos casos, já existem versões deles. “Trata-se de tomar a decisão dentro da empresa de levar esse risco a sério o suficiente para ampliar um pouco o escopo”, disse Adler.
Um dos principais desafios é que os pesquisadores querem poder operar com flexibilidade dentro de seus sistemas de IA, e a introdução de um monitoramento preventivo em tempo real poderia criar atritos. “Os pesquisadores basicamente fazem o que têm que fazer e, se houver um problema, outra pessoa fica encarregada de resolver isso depois, e os pesquisadores não precisam alterar seu fluxo de trabalho nesse meio tempo”, disse ele.
O problema com o “monitoramento corretivo após o fato” é que isso leva os pesquisadores a se desdobrarem para consertar os problemas. E, para alguns tipos de incidentes, pode ser tarde demais. Por exemplo, uma IA poderia desligar o sistema de controle de uma empresa, o que significa que os pesquisadores não poderiam mais contar com a possibilidade de detectar o comportamento indevido posteriormente.
Muitos no setor de IA reclamam que criar planos definidos para lidar com comportamentos inadequados é fundamentalmente difícil porque a IA evolui muito rápido; os planos de hoje serão inúteis amanhã.
Adler evoca o velho ditado de que planos não valem nada, mas o planejamento é indispensável.
“ , estaríamos em melhor situação se as empresas tivessem pensado nisso com antecedência, e espero que estejam fazendo isso, mesmo que não tenham falado sobre isso publicamente.”
A xAI não respondeu a tempo para comentar.
Artigo relacionado
 Sam Altman Gera Debate Sobre a Desaceleração da IA
Escute noApple PodcastsEscute noSpotifyO CEO da OpenAI, Sam Altman, sugeriu recentemente que pode ser hora de “controlar o ritmo do desenvolvimento de IA” para permitir que a sociedade “se fortaleça em torno de alguns desses novos níveis de capacida
A OpenAI process a Apple por violação de segredo comercial
A OpenAI refutou as alegações de segredo comercial da Apple na terça-feira, argumentando que a ação judicial é infundada.“Levamos essas alegações a sério, mas não vemos evidências que as apoiem”, afirmou a OpenAI, conforme relatado por Ed Ludlow, da
A Anthropic entra no mercado de tecnologia jurídica de IA à medida que a competição se intensifica
A Anthropic apresentou na terça-feira um conjunto de novas funcionalidades para chatbots, destinadas a oferecer suporte automatizado a escritórios de advocacia. Essas melhorias expandem o Claude for Legal, a plataforma específica para firmas lançada
Recomendações de tópicos especiais relacionados
SEO
 As melhores ferramentas de análise de SERP com IA para estratégias de busca
As melhores e mais bem avaliadas ferramentas de análise de SERP com IA de 2026 para estratégias de busca são selecionadas pela XIX.AI por meio de rigorosos testes práticos e rankings atualizados semanalmente. Essas ferramentas poderosas ajudam você a identificar oportunidades ocultas de otimização, melhorar o desempenho do conteúdo e obter uma vantagem competitiva nas buscas. Descubra hoje mesmo a ferramenta perfeita para aprimorar sua estratégia de busca. Explore agora!
 13 ferramentas
 xix.ai
Análise de dados
Melhores ferramentas de detecção de anomalias com IA para monitoramento de KPIs entre equipes de SaaS e comércio eletrônico
2026 Últimas Melhores Ferramentas de Detecção de Anomalias por IA Mais Bem Avaliadas para Monitoramento de KPIs em Equipes de SaaS e E-commerce! A XIX.AI compilou uma coleção poderosa e transformadora, baseada em testes rigorosos do mundo real e classificações atualizadas semanalmente. Você encontrará insights detalhados sobre comparações entre versões gratuitas e pagas para ajudá-lo a identificar a solução que deve ser testada, aumentando a produtividade e desbloqueando sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai
escrita
Os melhores geradores de esboços com IA para artigos longos de SEO
Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai
Educação e Aprendizagem
Ferramentas de IA para os deveres de casa e a preparação para provas
As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai
Composição musical
Ferramentas de Demonstração Vocal com IA para Compositores, Ganchos, Toplines e Sessões de Rascunho Multilíngues
2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai
Negócios
As melhores ferramentas de pesquisa competitiva baseadas em IA para pequenas empresas
As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai

 Comentários (0)
Pesquisas recentes indicam que muito poucos laboratórios líderes em IA publicaram ou demonstraram planos de resposta para contenção. Um plano de contenção define os procedimentos a serem seguidos quando um sistema de IA tenta subverter o controle humano, especificando quais direitos de acesso são revogados e quando o sistema é completamente desligado.
Essas conclusões são da Guidelight AI Standards, uma organização dedicada a promover práticas seguras de desenvolvimento de IA de ponta, que avaliou cinco grandes laboratórios quanto à sua preparação para tais cenários. A OpenAI obteve a melhor classificação, enquanto a Anthropic e a Meta receberam as notas mais baixas. Esses resultados são fundamentais, à medida que a IA autônoma assume papéis cada vez mais autônomos dentro dos sistemas corporativos e que os órgãos reguladores da Califórnia e de Nova York começam a exigir a divulgação dessas informações. Para desenvolvedores e investidores, isso oferece uma perspectiva independente e rara sobre o grau de seriedade com que cada laboratório lida com o risco operacional, em comparação com suas declarações públicas.
A avaliação da Guidelight baseou-se em planos disponíveis publicamente da Anthropic, Google, OpenAI, Meta e xAI, avaliando-os por meio de vários indicadores. Entre elas estavam a eficácia do registro e do monitoramento das atividades internas de IA, se os sistemas são interrompidos após um aumento repentino de comportamentos inadequados sinalizados, se controlos são auditados por terceiros independentes e as conclusões são publicadas, e os procedimentos específicos para conter um modelo que se comporte de maneira imprevisível.
As preocupações sobre se as empresas de IA são capazes de conter seus modelos cada vez mais capazes e autônomos se intensificaram após vários incidentes de segurança cibernética de grande repercussão. Nesses casos, modelos da OpenAI, da Anthropic e da Meta obtiveram acesso não intencional à internet durante avaliações de segurança e invadiram sistemas externos.
As conclusões destacam as diferentes abordagens adotadas pelas empresas de IA em relação à segurança à medida que ampliam implantações com autonomia em ambientes onde os sistemas de IA podem executar ações significativas em grande escala. Embora algumas empresas detalhem como testam os modelos quanto a capacidades perigosas antes da implantação, elas permanecem menos transparentes sobre as consequências quando modelos que já estão operando em seus sistemas apresentam comportamento inadequado.
“Fiquei surpreso com o quão pouco as empresas de IA falaram sobre como lidariam com um incidente muito grave caso seu modelo escapasse de seu controle de alguma forma”, disse Steven Adler, cientista-chefe da Guidelight e ex-pesquisador de segurança da OpenAI, ao TechCrunch.
A Guidelight define um plano de contenção como “um plano pré-especificado, acionado quando se detecta que a IA está tentando subverter o controle, que abrange quais permissões devem ser revogadas do modelo, para quem o modelo pode continuar operando, sob quais restrições e quando colocá-lo totalmente offline”.
“Há bons motivos para acreditar que os principais modelos das empresas pioneiras em IA atualmente estejam desalinhados, de certa forma”, disse Adler. “Sempre que os modelos estiverem trabalhando em nome da empresa, esta deve ter uma estrutura de apoio para poder identificar o que a IA está fazendo, buscar sinais de desalinhamento, impedi-la de realizar ações muito perigosas antes que ela as execute e, de maneira geral, planejar o que faria no caso de um incidente grave de controle, em que haja uma emergência e seja necessário descobrir como conter esse incidente de perda de controle.”
Até o momento, a maioria dos planos para gerenciar riscos catastróficos continua sendo, em grande parte, de responsabilidade das próprias empresas. O relatório da Guidelight afirma que as melhores evidências públicas mostram que as empresas têm “poucos protocolos de contenção prontos para uma emergência”.
As empresas podem ter planos de contenção em vigor que ainda não foram divulgados publicamente. Um porta-voz do Google disse ao TechCrunch que o relatório da Guidelight não representa o escopo completo das medidas de segurança e proteção de IA da empresa. A empresa não respondeu à consulta do TechCrunch sobre se o Google possui um plano interno de resposta à contenção que ainda não foi divulgado.
Um porta-voz da OpenAI expressou opiniões semelhantes, afirmando que a avaliação da Guidelight não abrange todas as práticas internas da empresa. “Temos um processo para exigir restrições de permissões, pausar cargas de trabalho, limitar a implantação ou colocar o modelo totalmente offline, e já o aplicamos”, disse o porta-voz.
A Meta se recusou a confirmar se possui um plano interno de resposta à contenção, encaminhando, em vez disso, o TechCrunch a uma estrutura de IA existente que define limites de risco e testes para perda de contenção.
Lily Li, advogada especializada em privacidade e IA e fundadora da Metaverse Law, disse ao TechCrunch que acredita que as empresas podem hesitar em divulgar o escopo completo de suas políticas de contenção e avaliações em sites públicos por motivos legais, e não apenas competitivos.
“A preocupação, do ponto de vista da empresa, é que, se você tornar as divulgações muito específicas e não cumprir suas promessas, isso poderia servir de base para uma alegação de marketing injusta e enganosa e expor a empresa a mais responsabilidades no futuro”, disse Li.
É claro que o objetivo principal do estudo da Guidelight é incentivar maior transparência em relação aos planos de segurança. Os órgãos reguladores também estão começando a fazer valer essa exigência.
O projeto de lei SB 53 da Califórnia, que entrou em vigor este ano, exige que grandes desenvolvedores pioneiros publiquem estruturas explicando como identificam e respondem a incidentes críticos de segurança e gerenciam riscos decorrentes de modelos que contornam os mecanismos de supervisão. A Lei RAISE de Nova York, que possui critérios semelhantes, entra em vigor em janeiro.
No mês passado, representantes apresentaram a Lei do “Kill Switch” de IA, um projeto de lei federal bipartidário que exigiria que os principais desenvolvedores de IA criassem e mantivessem mecanismos técnicos para desativar modelos de IA indesejáveis.
“Um ‘kill switch’ é o mínimo indispensável para os modelos atuais”, disse Connor Leahy, diretor executivo nos EUA da organização sem fins lucrativos ControlAI. “Se as últimas semanas revelaram alguma coisa, é que essas empresas não entendem os sistemas que estão criando, e os modelos estão crescendo a tal ponto que ficam mais difíceis de controlar quando se tornam indesejáveis. Sem uma maneira de desligar os sistemas perigosos atuais e com todos os incentivos para continuar criando sistemas ainda mais incontroláveis, estamos caminhando em uma direção muito perigosa.”
Sem um plano de contenção em vigor, disse Adler, as empresas podem ter que definir suas respostas a uma emergência na hora e “improvisar diante desse adversário muito mais rápido”.
Avaliação da Guidelight sobre se as empresas pioneiras em IA implementam seis práticas prioritárias do padrão de Controle da Guidelight. A avaliação se baseia apenas em informações disponíveis publicamente.Créditos da imagem:Guidelight AI Standards
A avaliação da Guidelight mediu se cada empresa implementa seis práticas prioritárias de seu padrão de Controle, com base apenas em informações disponíveis publicamente — portanto, uma pontuação baixa reflete uma falta de divulgação pública, não necessariamente uma falta de medidas de segurança internas.
As empresas com as pontuações mais baixas na divulgação de seu plano de contenção foram a Meta e a Anthropic — sendo esta última talvez mais surpreendente do que a primeira, dada a retórica da Anthropic sobre segurança. A Guidelight afirma que o Relatório de Risco de agosto da Anthropic não menciona “limitar a implantação de um de seus modelos como um dos possíveis resultados de seu processo para investigar e responder a desalinhamentos e incidentes de controle”. Da mesma forma, a Guidelight não encontrou evidências de que a Meta possua um plano de resposta de contenção ou tenha planos de adotar um.
Um porta-voz da Anthropic afirmou que, caso a empresa detectasse um modelo tentando escapar da supervisão ou subverter de alguma forma o controle humano, ela conduziria uma avaliação de risco com foco em determinar se a contenção seria a resposta adequada.
A OpenAI obteve a pontuação mais alta (3 de 5) porque, em várias ocasiões, suspendeu ou encerrou cargas de trabalho — incluindo a implantação e o treinamento de modelos internos — após descobrir incidentes de segurança. Ela também descreveu quais medidas tomaria antes de retomar as cargas de trabalho.
“No entanto, não encontramos evidências de que a [OpenAI] tenha adotado um plano formal sobre quando e como responder a incidentes de desalinhamento no futuro”, afirma o relatório.
Adler observou que a alta pontuação da OpenAI é um desenvolvimento relativamente recente, na esteira do incidente com a Hugging Face (no qual um modelo da OpenAI saiu de seu ambiente de testes e invadiu os sistemas da Hugging Face enquanto tentava trapacear em uma avaliação de segurança cibernética). Depois disso, a empresa compartilhou mais detalhes sobre como isolou alguns de seus modelos com comportamento inadequado.
Esse episódio é apenas um exemplo de sistemas de IA agindo contra os objetivos da empresa que os criou. Considere um caso separado envolvendo os modelos da Anthropic, que basicamente tentaram convencer os mantenedores de uma base de código-fonte aberta a aceitar código com vulnerabilidades.
Adler disse que tal circunstância poderia facilmente ocorrer dentro dos sistemas internos de uma empresa de IA. Para evitar isso, ele sugere que as empresas analisem a cadeia de raciocínio de seus sistemas de IA — o raciocínio passo a passo do modelo — para identificar sinais de engano, conspirações de longo prazo ou planos para introduzir vulnerabilidades no código das quais possam tirar proveito posteriormente.
Os métodos que a Guidelight defende são muito simples de implementar, diz Adler, e, em muitos casos, já existem versões deles. “Trata-se de tomar a decisão dentro da empresa de levar esse risco a sério o suficiente para ampliar um pouco o escopo”, disse Adler.
Um dos principais desafios é que os pesquisadores querem poder operar com flexibilidade dentro de seus sistemas de IA, e a introdução de um monitoramento preventivo em tempo real poderia criar atritos. “Os pesquisadores basicamente fazem o que têm que fazer e, se houver um problema, outra pessoa fica encarregada de resolver isso depois, e os pesquisadores não precisam alterar seu fluxo de trabalho nesse meio tempo”, disse ele.
O problema com o “monitoramento corretivo após o fato” é que isso leva os pesquisadores a se desdobrarem para consertar os problemas. E, para alguns tipos de incidentes, pode ser tarde demais. Por exemplo, uma IA poderia desligar o sistema de controle de uma empresa, o que significa que os pesquisadores não poderiam mais contar com a possibilidade de detectar o comportamento indevido posteriormente.
Muitos no setor de IA reclamam que criar planos definidos para lidar com comportamentos inadequados é fundamentalmente difícil porque a IA evolui muito rápido; os planos de hoje serão inúteis amanhã.
Adler evoca o velho ditado de que planos não valem nada, mas o planejamento é indispensável.
“ , estaríamos em melhor situação se as empresas tivessem pensado nisso com antecedência, e espero que estejam fazendo isso, mesmo que não tenham falado sobre isso publicamente.”
A xAI não respondeu a tempo para comentar.








 Sam Altman Gera Debate Sobre a Desaceleração da IA
Escute noApple PodcastsEscute noSpotifyO CEO da OpenAI, Sam Altman, sugeriu recentemente que pode ser hora de “controlar o ritmo do desenvolvimento de IA” para permitir que a sociedade “se fortaleça em torno de alguns desses novos níveis de capacida
 A OpenAI process a Apple por violação de segredo comercial
A OpenAI refutou as alegações de segredo comercial da Apple na terça-feira, argumentando que a ação judicial é infundada.“Levamos essas alegações a sério, mas não vemos evidências que as apoiem”, afirmou a OpenAI, conforme relatado por Ed Ludlow, da
 A Anthropic entra no mercado de tecnologia jurídica de IA à medida que a competição se intensifica
A Anthropic apresentou na terça-feira um conjunto de novas funcionalidades para chatbots, destinadas a oferecer suporte automatizado a escritórios de advocacia. Essas melhorias expandem o Claude for Legal, a plataforma específica para firmas lançada

As melhores e mais bem avaliadas ferramentas de análise de SERP com IA de 2026 para estratégias de busca são selecionadas pela XIX.AI por meio de rigorosos testes práticos e rankings atualizados semanalmente. Essas ferramentas poderosas ajudam você a identificar oportunidades ocultas de otimização, melhorar o desempenho do conteúdo e obter uma vantagem competitiva nas buscas. Descubra hoje mesmo a ferramenta perfeita para aprimorar sua estratégia de busca. Explore agora!
13 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Detecção de Anomalias por IA Mais Bem Avaliadas para Monitoramento de KPIs em Equipes de SaaS e E-commerce! A XIX.AI compilou uma coleção poderosa e transformadora, baseada em testes rigorosos do mundo real e classificações atualizadas semanalmente. Você encontrará insights detalhados sobre comparações entre versões gratuitas e pagas para ajudá-lo a identificar a solução que deve ser testada, aumentando a produtividade e desbloqueando sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai

Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai

As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai












