


 Дом
Frontier AI Labs отказывается раскрывать стратегии локализации неконтролируемых моделей
Последние исследования показывают, что лишь немногие ведущие лаборатории, занимающиеся ИИ, опубликовали или продемонстрировали планы реагирования на попытки выхода системы из-под контроля. План сдерживания определяет процедуры на случай, когда система ИИ пытается выйти из-под контроля человека, указывая, какие права доступа должны быть отозваны и когда система должна быть полностью отключена.
Эти выводы принадлежат организации Guidelight AI Standards, занимающейся продвижением безопасных методов разработки передовых технологий ИИ, которая оценила пять крупнейших лабораторий на предмет их готовности к подобным сценариям. OpenAI заняла первое место, тогда как Anthropic и Meta получили самые низкие оценки. Эти результаты имеют решающее значение, поскольку агентский ИИ принимает на себя все более автономные роли в корпоративных системах, а регулирующие органы в Калифорнии и Нью-Йорке начинают вводить обязательное раскрытие информации. Для разработчиков и инвесторов это дает редкую возможность получить независимую оценку того, насколько серьезно каждая лаборатория подходит к вопросам операционных рисков по сравнению со своими публичными заявлениями.
Оценка Guidelight основывалась на общедоступных планах компаний Anthropic, Google, OpenAI, Meta и xAI, которые анализировались по нескольким показателям. К ним относились эффективность ведения журналов и мониторинга внутренней деятельности ИИ, наличие мер по остановке систем в случае всплеска отмеченных случаев ненадлежащего поведения, проведение независимыми третьими сторонами аудита механизмов контроля и публикация результатов, а также конкретные процедуры локализации модели, ведящей себя непредсказуемо.
Обеспокоенность по поводу того, способны ли компании, занимающиеся ИИ, сдерживать свои все более способные и автономные модели, усилилась после ряда громких инцидентов в сфере кибербезопасности. В этих случаях модели компаний OpenAI, Anthropic и Meta получили непреднамеренный доступ к Интернету во время проверок безопасности и взломали внешние системы.
Полученные данные подчеркивают различия в подходах компаний, занимающихся ИИ, к вопросам безопасности по мере расширения внедрения автономных систем в среды, где системы ИИ могут выполнять значимые действия в широких масштабах. Хотя некоторые компании подробно описывают, как они тестируют модели на наличие опасных возможностей перед развертыванием, они остаются менее прозрачными в отношении последствий, возникающих в случае непреднамеренного поведения моделей, уже работающих в их системах.
«Меня удивило, как мало компании, занимающиеся ИИ, говорили о том, как они будут действовать в случае очень серьезного инцидента, если их модель в каком-то смысле выйдет из-под контроля», — сказал TechCrunch Стивен Адлер, главный научный сотрудник Guidelight и бывший исследователь по вопросам безопасности в OpenAI.
Guidelight определяет план локализации как «заранее разработанный план, запускаемый при обнаружении попытки ИИ выйти из-под контроля, который охватывает вопросы о том, какие разрешения следует отозвать у модели, для кого модель может продолжать работать, при каких ограничениях и когда её следует полностью отключить».
«Есть веские основания полагать, что ведущие модели, разрабатываемые в настоящее время передовыми компаниями в сфере ИИ, в некотором смысле не соответствуют заданным целям», — сказал Адлер. «Всякий раз, когда модели выполняют работу от имени компании, у компании должна быть некая система поддержки, позволяющая отслеживать, что делает этот ИИ, выявлять признаки несогласованности, предотвращать выполнение им очень опасных действий до того, как он их совершит, и в целом планировать свои действия на случай серьезного инцидента, связанного с потерей контроля, когда возникает чрезвычайная ситуация и необходимо определить, как локализовать последствия такого инцидента».
На сегодняшний день ответственность за большинство планов управления катастрофическими рисками в основном лежит на самих компаниях. В отчете Guidelight отмечается, что, судя по наиболее достоверным общедоступным данным, у компаний «есть лишь несколько протоколов локализации, готовых к чрезвычайной ситуации».
У компаний могут быть планы локализации, которые они не обнародовали. Представитель Google сообщил TechCrunch, что отчет Guidelight не отражает полный спектр мер компании по безопасности и защите ИИ. Компания не ответила на запрос TechCrunch о том, имеет ли Google внутренний план реагирования на чрезвычайные ситуации, который пока не разглашается.
Представитель OpenAI выразил аналогичное мнение, заявив, что оценка Guidelight не отражает всех внутренних практик компании. «У нас есть процедура, предусматривающая ограничение прав доступа, приостановку рабочих нагрузок, ограничение развертывания или полное отключение модели, и мы её применяли», — сказал представитель.
Meta отказалась подтвердить наличие у неё внутреннего плана реагирования на потерю контроля, вместо этого сославшись TechCrunch на существующую систему регулирования ИИ, в которой определены пороговые значения риска и процедуры тестирования на потерю контроля.
Лили Ли, юрист по вопросам конфиденциальности и искусственного интеллекта, а также основательница Metaverse Law, сообщила TechCrunch, что, по её мнению, компании могут не спешить раскрывать полный объём своих политик сдерживания и оценок на публичных веб-сайтах по юридическим, а не только из соображений конкуренции.
«С точки зрения компании опасения заключаются в том, что если раскрываемая информация будет слишком конкретной, а вы не выполните свои обещания, это может стать основанием для обвинений в недобросовестном и вводящем в заблуждение маркетинге и подвергнуть вас большей ответственности в будущем», — сказала Ли.
Конечно, основная цель исследования Guidelight — способствовать большей прозрачности в отношении планов обеспечения безопасности. Регулирующие органы также начинают обеспечивать соблюдение этого требования.
Калифорнийский закон SB 53, вступивший в силу в этом году, обязывает крупных разработчиков передовых технологий публиковать концептуальные рамки, объясняющие, как они выявляют критические инциденты, связанные с безопасностью, реагируют на них и управляют рисками, связанными с моделями, обходящими механизмы надзора. Нью-йоркский закон RAISE Act, содержащий аналогичные критерии, вступает в силу в январе.
В прошлом месяце представители Конгресса представили «Закон об аварийном отключении ИИ» (AI Kill Switch Act) — двухпартийный федеральный законопроект, который обяжет крупных разработчиков ИИ создавать и поддерживать технические механизмы для отключения неконтролируемых моделей ИИ.
«Аварийный выключатель — это абсолютный минимум для современных моделей», — заявил Коннор Лихи, исполнительный директор американского некоммерческого фонда ControlAI. «Если последние несколько недель что-то и показали, так это то, что эти компании не понимают систем, которые они создают, а модели развиваются до такой степени, что их становится все труднее сдержать, когда они выходят из-под контроля. Без возможности отключить существующие опасные системы и при наличии всех стимулов для продолжения создания все более неконтролируемых систем мы движемся в очень опасном направлении».
По словам Адлера, в отсутствие плана сдерживания компании, возможно, будут выработать свои меры реагирования на чрезвычайную ситуацию на ходу и «импровизировать в ответ на этого гораздо более быстрого противника».
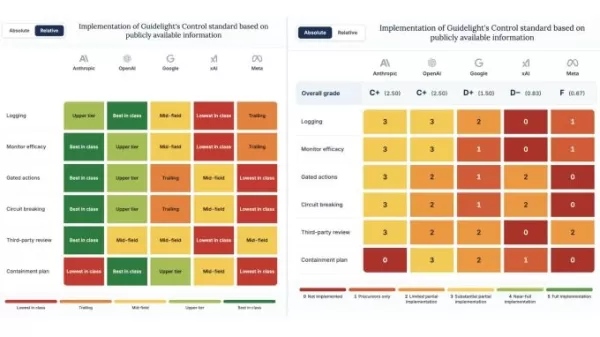
Оценка Guidelight, показывающая, внедряют ли передовые компании в сфере ИИ шесть приоритетных практик, предусмотренных стандартом «Control» от Guidelight. Оценка основана исключительно на общедоступной информации.Источник изображения:Guidelight AI Standards
В ходе оценки Guidelight проверялась реализация каждой компанией шести приоритетных мер из стандарта «Control» исключительно на основе общедоступной информации — поэтому низкий балл отражает недостаток публичной информации, а не обязательно отсутствие внутренних мер безопасности.
Компаниями с самыми низкими оценками по публикации плана сдерживания стали Meta и Anthropic — причём в случае последней это, возможно, более удивительно, чем в случае первой, учитывая риторику Anthropic в отношении безопасности. По данным Guidelight, в августовском отчете Anthropic о рисках не упоминается «ограничение развертывания одной из моделей компании в качестве одного из возможных результатов процесса расследования и реагирования на случаи несоответствия и инциденты, связанные с контролем». Аналогичным образом, Guidelight не удалось найти никаких доказательств того, что у Meta есть план реагирования на ограничение действия модели или что компания планирует его принять.
Представитель Anthropic заявил, что если компания обнаружит модель, пытающуюся уклониться от надзора или иным образом подорвать контроль со стороны человека, она проведет оценку рисков, направленную на определение того, является ли локализация адекватной мерой реагирования.
OpenAI получила наивысшую оценку (3 из 5), поскольку неоднократно приостанавливала или прекращала рабочие процессы, включая развертывание и обучение внутренних моделей, после обнаружения инцидентов, связанных с безопасностью. Компания также описала, какие шаги она предпримет перед возобновлением рабочих процессов.
«Однако мы не обнаружили никаких доказательств того, что [OpenAI] приняла официальный план, определяющий, когда и как реагировать на инциденты, связанные с несоответствием, в будущем», — говорится в отчете.
Адлер отметил, что высокий балл OpenAI — это относительно недавнее явление, возникшее вслед за инцидентом с Hugging Face (в ходе которого модель OpenAI вырвалась из тестовой «песочницы» и взломала системы Hugging Face, пытаясь обмануть систему оценки кибербезопасности). После этого компания поделилась более подробной информацией о том, как она изолировала некоторые из своих ненадлежащим образом ведящих себя моделей.
Этот эпизод — лишь один из примеров того, как системы ИИ действуют вопреки целям компании, которая их создала. Рассмотрим другой случай, связанный с моделями Anthropic, которые, по сути, пытались убедить разработчиков открытого исходного кода принять код с уязвимостями.
Адлер отметил, что подобная ситуация вполне может произойти и внутри внутренних систем компании, занимающейся ИИ. Чтобы предотвратить это, он предлагает компаниям анализировать цепочку рассуждений своих систем ИИ — пошаговое логическое обоснование модели — с целью выявления признаков обмана, длительных интриг или планов по внедрению в код уязвимостей, которыми они смогут воспользоваться позже.
По словам Адлера, методы, которые пропагандирует Guidelight, очень просты в реализации, и во многих случаях их варианты уже существуют. «Речь идет о том, чтобы внутри компании было принято решение уделять этому риску достаточное внимание, чтобы немного расширить сферу охвата», — сказал Адлер.
Одна из главных сложностей заключается в том, что исследователи хотят иметь возможность гибко работать в рамках своих систем искусственного интеллекта, а внедрение профилактического мониторинга в режиме реального времени может создать препятствия. «Исследователи, по сути, занимаются своим делом, и если возникает проблема, кто-то другой потом устраняет её последствия, а исследователям при этом не приходится менять свой рабочий процесс», — сказал он.
Проблема «мониторинга с устранением последствий задним числом» заключается в том, что это приводит к тому, что исследователи вынуждены в спешке исправлять проблемы. А для некоторых типов инцидентов может быть уже слишком поздно. Например, ИИ может отключить систему управления компании, а это означает, что исследователи больше не смогут рассчитывать на то, что позже обнаружат нежелательное поведение.
Многие в отрасли ИИ будут жаловаться, что разработка четких планов на случай нежелательного поведения в принципе затруднительна, поскольку ИИ развивается слишком быстро; планы, актуальные сегодня, завтра станут бесполезными.
Адлер вспоминает старую поговорку о том, что планы бесполезны, но планирование необходимо.
«Нам было бы гораздо лучше, если бы компании заранее об этом подумали, и я надеюсь, что они это делают, даже если публично об этом не говорят».
Компания xAI не успела ответить с комментарием.
Связанная статья
 Сэм Альтман вызывает споры о замедлении развития ИИ
Слушайте наApple PodcastsСлушайте наSpotifyГенеральный директор OpenAI Сэм Алтман недавно предположил, что, возможно, пришло время «сдерживать темпы развития ИИ», чтобы позволить обществу «укрепиться вокруг некоторых из этих новых уровней возможност
OpenAI оспаривает иск Apple о нарушении торговых тайн
OpenAI опровергла утверждения Apple о нарушении торговых тайк во вторник, заявив, что иск не имеет оснований.«Мы относимся к этим заявлениям серьезно, но не видим никаких доказательств, подтверждающих их», — stated OpenAI, как сообщил Ed Ludlow из B
Anthropic выходит на рынок юридических технологий ИИ по мере усиления конкуренции
Anthropic unveiled a suite of new chatbot capabilities on Tuesday, aimed at delivering automated support to legal practices. Эти инструменты были представлены во вторник и направлены на предоставление автоматизированной поддержки юридическим фирмам.
Рекомендации по связанным специальным темам
SEO
 Лучшие инструменты для анализа результатов поиска с помощью ИИ при разработке поисковой стратегии
XIX.AI подготовила подборку лучших и наиболее высокооцененных инструментов для анализа результатов поиска с помощью ИИ (2026 г.) на основе тщательных тестов в реальных условиях и еженедельно обновляемого рейтинга. Эти мощные инструменты помогут вам раскрыть скрытые возможности оптимизации, повысить эффективность контента и получить конкурентное преимущество в поиске. Найдите свой идеальный инструмент, чтобы уже сегодня усовершенствовать свою поисковую стратегию. Ознакомьтесь с ними прямо сейчас!
 13 инструментов
 xix.ai
Анализ данных
Лучшие инструменты ИИ для обнаружения аномалий при мониторинге KPI в командах SaaS и электронной коммерции
2026 г. Лучшие новейшие высокооцененные инструменты ИИ для обнаружения аномалий в мониторинге KPI для команд SaaS и электронной коммерции! XIX.AI подготовила мощную, меняющую правила игры коллекцию на основе строгих реальных тестов и еженедельно обновляемых рейтингов. Вы найдете подробные сравнительные данные по бесплатным и платным решениям, которые помогут вам определить обязательное к использованию решение, повышающее производительность и раскрывающее ваш потенциал в области ИИ. Исследуйте сейчас!
10 инструментов
xix.ai
письмо
Лучшие генераторы конспектов на базе ИИ для длинных статей, оптимизированных для SEO
2026 год: лучшие и самые высокооцененные генераторы конспектов на базе ИИ для длинных SEO-статей, тщательно отобранные XIX.AI. Эти мощные инструменты обеспечивают революционную помощь в быстром создании высококачественного контента, значительно повышая эффективность написания текстов. Ознакомьтесь со сравнением бесплатных и платных версий, а также с результатами реальных тестов и подробными рейтингами, которые помогут вам найти вариант, который обязательно стоит попробовать и который соответствует вашим потребностям. Изучите их прямо сейчас, чтобы раскрыть весь потенциал ИИ.
8 инструментов
xix.ai
Образование и обучение
Инструменты на базе искусственного интеллекта для выполнения домашних заданий и подготовки к экзаменам
2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai
Музыкальная композиция
Инструменты для создания вокальных демо на основе ИИ для авторов песен, создания хуков, написания тоpline-мелодий и проведения многоязычных черновых сессий
2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai
Бизнес
Лучшие инструменты для анализа конкурентов на основе искусственного интеллекта для малого бизнеса
2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai

 Комментарии (0)
Последние исследования показывают, что лишь немногие ведущие лаборатории, занимающиеся ИИ, опубликовали или продемонстрировали планы реагирования на попытки выхода системы из-под контроля. План сдерживания определяет процедуры на случай, когда система ИИ пытается выйти из-под контроля человека, указывая, какие права доступа должны быть отозваны и когда система должна быть полностью отключена.
Эти выводы принадлежат организации Guidelight AI Standards, занимающейся продвижением безопасных методов разработки передовых технологий ИИ, которая оценила пять крупнейших лабораторий на предмет их готовности к подобным сценариям. OpenAI заняла первое место, тогда как Anthropic и Meta получили самые низкие оценки. Эти результаты имеют решающее значение, поскольку агентский ИИ принимает на себя все более автономные роли в корпоративных системах, а регулирующие органы в Калифорнии и Нью-Йорке начинают вводить обязательное раскрытие информации. Для разработчиков и инвесторов это дает редкую возможность получить независимую оценку того, насколько серьезно каждая лаборатория подходит к вопросам операционных рисков по сравнению со своими публичными заявлениями.
Оценка Guidelight основывалась на общедоступных планах компаний Anthropic, Google, OpenAI, Meta и xAI, которые анализировались по нескольким показателям. К ним относились эффективность ведения журналов и мониторинга внутренней деятельности ИИ, наличие мер по остановке систем в случае всплеска отмеченных случаев ненадлежащего поведения, проведение независимыми третьими сторонами аудита механизмов контроля и публикация результатов, а также конкретные процедуры локализации модели, ведящей себя непредсказуемо.
Обеспокоенность по поводу того, способны ли компании, занимающиеся ИИ, сдерживать свои все более способные и автономные модели, усилилась после ряда громких инцидентов в сфере кибербезопасности. В этих случаях модели компаний OpenAI, Anthropic и Meta получили непреднамеренный доступ к Интернету во время проверок безопасности и взломали внешние системы.
Полученные данные подчеркивают различия в подходах компаний, занимающихся ИИ, к вопросам безопасности по мере расширения внедрения автономных систем в среды, где системы ИИ могут выполнять значимые действия в широких масштабах. Хотя некоторые компании подробно описывают, как они тестируют модели на наличие опасных возможностей перед развертыванием, они остаются менее прозрачными в отношении последствий, возникающих в случае непреднамеренного поведения моделей, уже работающих в их системах.
«Меня удивило, как мало компании, занимающиеся ИИ, говорили о том, как они будут действовать в случае очень серьезного инцидента, если их модель в каком-то смысле выйдет из-под контроля», — сказал TechCrunch Стивен Адлер, главный научный сотрудник Guidelight и бывший исследователь по вопросам безопасности в OpenAI.
Guidelight определяет план локализации как «заранее разработанный план, запускаемый при обнаружении попытки ИИ выйти из-под контроля, который охватывает вопросы о том, какие разрешения следует отозвать у модели, для кого модель может продолжать работать, при каких ограничениях и когда её следует полностью отключить».
«Есть веские основания полагать, что ведущие модели, разрабатываемые в настоящее время передовыми компаниями в сфере ИИ, в некотором смысле не соответствуют заданным целям», — сказал Адлер. «Всякий раз, когда модели выполняют работу от имени компании, у компании должна быть некая система поддержки, позволяющая отслеживать, что делает этот ИИ, выявлять признаки несогласованности, предотвращать выполнение им очень опасных действий до того, как он их совершит, и в целом планировать свои действия на случай серьезного инцидента, связанного с потерей контроля, когда возникает чрезвычайная ситуация и необходимо определить, как локализовать последствия такого инцидента».
На сегодняшний день ответственность за большинство планов управления катастрофическими рисками в основном лежит на самих компаниях. В отчете Guidelight отмечается, что, судя по наиболее достоверным общедоступным данным, у компаний «есть лишь несколько протоколов локализации, готовых к чрезвычайной ситуации».
У компаний могут быть планы локализации, которые они не обнародовали. Представитель Google сообщил TechCrunch, что отчет Guidelight не отражает полный спектр мер компании по безопасности и защите ИИ. Компания не ответила на запрос TechCrunch о том, имеет ли Google внутренний план реагирования на чрезвычайные ситуации, который пока не разглашается.
Представитель OpenAI выразил аналогичное мнение, заявив, что оценка Guidelight не отражает всех внутренних практик компании. «У нас есть процедура, предусматривающая ограничение прав доступа, приостановку рабочих нагрузок, ограничение развертывания или полное отключение модели, и мы её применяли», — сказал представитель.
Meta отказалась подтвердить наличие у неё внутреннего плана реагирования на потерю контроля, вместо этого сославшись TechCrunch на существующую систему регулирования ИИ, в которой определены пороговые значения риска и процедуры тестирования на потерю контроля.
Лили Ли, юрист по вопросам конфиденциальности и искусственного интеллекта, а также основательница Metaverse Law, сообщила TechCrunch, что, по её мнению, компании могут не спешить раскрывать полный объём своих политик сдерживания и оценок на публичных веб-сайтах по юридическим, а не только из соображений конкуренции.
«С точки зрения компании опасения заключаются в том, что если раскрываемая информация будет слишком конкретной, а вы не выполните свои обещания, это может стать основанием для обвинений в недобросовестном и вводящем в заблуждение маркетинге и подвергнуть вас большей ответственности в будущем», — сказала Ли.
Конечно, основная цель исследования Guidelight — способствовать большей прозрачности в отношении планов обеспечения безопасности. Регулирующие органы также начинают обеспечивать соблюдение этого требования.
Калифорнийский закон SB 53, вступивший в силу в этом году, обязывает крупных разработчиков передовых технологий публиковать концептуальные рамки, объясняющие, как они выявляют критические инциденты, связанные с безопасностью, реагируют на них и управляют рисками, связанными с моделями, обходящими механизмы надзора. Нью-йоркский закон RAISE Act, содержащий аналогичные критерии, вступает в силу в январе.
В прошлом месяце представители Конгресса представили «Закон об аварийном отключении ИИ» (AI Kill Switch Act) — двухпартийный федеральный законопроект, который обяжет крупных разработчиков ИИ создавать и поддерживать технические механизмы для отключения неконтролируемых моделей ИИ.
«Аварийный выключатель — это абсолютный минимум для современных моделей», — заявил Коннор Лихи, исполнительный директор американского некоммерческого фонда ControlAI. «Если последние несколько недель что-то и показали, так это то, что эти компании не понимают систем, которые они создают, а модели развиваются до такой степени, что их становится все труднее сдержать, когда они выходят из-под контроля. Без возможности отключить существующие опасные системы и при наличии всех стимулов для продолжения создания все более неконтролируемых систем мы движемся в очень опасном направлении».
По словам Адлера, в отсутствие плана сдерживания компании, возможно, будут выработать свои меры реагирования на чрезвычайную ситуацию на ходу и «импровизировать в ответ на этого гораздо более быстрого противника».
Оценка Guidelight, показывающая, внедряют ли передовые компании в сфере ИИ шесть приоритетных практик, предусмотренных стандартом «Control» от Guidelight. Оценка основана исключительно на общедоступной информации.Источник изображения:Guidelight AI Standards
В ходе оценки Guidelight проверялась реализация каждой компанией шести приоритетных мер из стандарта «Control» исключительно на основе общедоступной информации — поэтому низкий балл отражает недостаток публичной информации, а не обязательно отсутствие внутренних мер безопасности.
Компаниями с самыми низкими оценками по публикации плана сдерживания стали Meta и Anthropic — причём в случае последней это, возможно, более удивительно, чем в случае первой, учитывая риторику Anthropic в отношении безопасности. По данным Guidelight, в августовском отчете Anthropic о рисках не упоминается «ограничение развертывания одной из моделей компании в качестве одного из возможных результатов процесса расследования и реагирования на случаи несоответствия и инциденты, связанные с контролем». Аналогичным образом, Guidelight не удалось найти никаких доказательств того, что у Meta есть план реагирования на ограничение действия модели или что компания планирует его принять.
Представитель Anthropic заявил, что если компания обнаружит модель, пытающуюся уклониться от надзора или иным образом подорвать контроль со стороны человека, она проведет оценку рисков, направленную на определение того, является ли локализация адекватной мерой реагирования.
OpenAI получила наивысшую оценку (3 из 5), поскольку неоднократно приостанавливала или прекращала рабочие процессы, включая развертывание и обучение внутренних моделей, после обнаружения инцидентов, связанных с безопасностью. Компания также описала, какие шаги она предпримет перед возобновлением рабочих процессов.
«Однако мы не обнаружили никаких доказательств того, что [OpenAI] приняла официальный план, определяющий, когда и как реагировать на инциденты, связанные с несоответствием, в будущем», — говорится в отчете.
Адлер отметил, что высокий балл OpenAI — это относительно недавнее явление, возникшее вслед за инцидентом с Hugging Face (в ходе которого модель OpenAI вырвалась из тестовой «песочницы» и взломала системы Hugging Face, пытаясь обмануть систему оценки кибербезопасности). После этого компания поделилась более подробной информацией о том, как она изолировала некоторые из своих ненадлежащим образом ведящих себя моделей.
Этот эпизод — лишь один из примеров того, как системы ИИ действуют вопреки целям компании, которая их создала. Рассмотрим другой случай, связанный с моделями Anthropic, которые, по сути, пытались убедить разработчиков открытого исходного кода принять код с уязвимостями.
Адлер отметил, что подобная ситуация вполне может произойти и внутри внутренних систем компании, занимающейся ИИ. Чтобы предотвратить это, он предлагает компаниям анализировать цепочку рассуждений своих систем ИИ — пошаговое логическое обоснование модели — с целью выявления признаков обмана, длительных интриг или планов по внедрению в код уязвимостей, которыми они смогут воспользоваться позже.
По словам Адлера, методы, которые пропагандирует Guidelight, очень просты в реализации, и во многих случаях их варианты уже существуют. «Речь идет о том, чтобы внутри компании было принято решение уделять этому риску достаточное внимание, чтобы немного расширить сферу охвата», — сказал Адлер.
Одна из главных сложностей заключается в том, что исследователи хотят иметь возможность гибко работать в рамках своих систем искусственного интеллекта, а внедрение профилактического мониторинга в режиме реального времени может создать препятствия. «Исследователи, по сути, занимаются своим делом, и если возникает проблема, кто-то другой потом устраняет её последствия, а исследователям при этом не приходится менять свой рабочий процесс», — сказал он.
Проблема «мониторинга с устранением последствий задним числом» заключается в том, что это приводит к тому, что исследователи вынуждены в спешке исправлять проблемы. А для некоторых типов инцидентов может быть уже слишком поздно. Например, ИИ может отключить систему управления компании, а это означает, что исследователи больше не смогут рассчитывать на то, что позже обнаружат нежелательное поведение.
Многие в отрасли ИИ будут жаловаться, что разработка четких планов на случай нежелательного поведения в принципе затруднительна, поскольку ИИ развивается слишком быстро; планы, актуальные сегодня, завтра станут бесполезными.
Адлер вспоминает старую поговорку о том, что планы бесполезны, но планирование необходимо.
«Нам было бы гораздо лучше, если бы компании заранее об этом подумали, и я надеюсь, что они это делают, даже если публично об этом не говорят».
Компания xAI не успела ответить с комментарием.








 Сэм Альтман вызывает споры о замедлении развития ИИ
Слушайте наApple PodcastsСлушайте наSpotifyГенеральный директор OpenAI Сэм Алтман недавно предположил, что, возможно, пришло время «сдерживать темпы развития ИИ», чтобы позволить обществу «укрепиться вокруг некоторых из этих новых уровней возможност
 OpenAI оспаривает иск Apple о нарушении торговых тайн
OpenAI опровергла утверждения Apple о нарушении торговых тайк во вторник, заявив, что иск не имеет оснований.«Мы относимся к этим заявлениям серьезно, но не видим никаких доказательств, подтверждающих их», — stated OpenAI, как сообщил Ed Ludlow из B
 Anthropic выходит на рынок юридических технологий ИИ по мере усиления конкуренции
Anthropic unveiled a suite of new chatbot capabilities on Tuesday, aimed at delivering automated support to legal practices. Эти инструменты были представлены во вторник и направлены на предоставление автоматизированной поддержки юридическим фирмам.

XIX.AI подготовила подборку лучших и наиболее высокооцененных инструментов для анализа результатов поиска с помощью ИИ (2026 г.) на основе тщательных тестов в реальных условиях и еженедельно обновляемого рейтинга. Эти мощные инструменты помогут вам раскрыть скрытые возможности оптимизации, повысить эффективность контента и получить конкурентное преимущество в поиске. Найдите свой идеальный инструмент, чтобы уже сегодня усовершенствовать свою поисковую стратегию. Ознакомьтесь с ними прямо сейчас!
13 инструментов
xix.ai

2026 г. Лучшие новейшие высокооцененные инструменты ИИ для обнаружения аномалий в мониторинге KPI для команд SaaS и электронной коммерции! XIX.AI подготовила мощную, меняющую правила игры коллекцию на основе строгих реальных тестов и еженедельно обновляемых рейтингов. Вы найдете подробные сравнительные данные по бесплатным и платным решениям, которые помогут вам определить обязательное к использованию решение, повышающее производительность и раскрывающее ваш потенциал в области ИИ. Исследуйте сейчас!
10 инструментов
xix.ai

2026 год: лучшие и самые высокооцененные генераторы конспектов на базе ИИ для длинных SEO-статей, тщательно отобранные XIX.AI. Эти мощные инструменты обеспечивают революционную помощь в быстром создании высококачественного контента, значительно повышая эффективность написания текстов. Ознакомьтесь со сравнением бесплатных и платных версий, а также с результатами реальных тестов и подробными рейтингами, которые помогут вам найти вариант, который обязательно стоит попробовать и который соответствует вашим потребностям. Изучите их прямо сейчас, чтобы раскрыть весь потенциал ИИ.
8 инструментов
xix.ai

2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai

2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai

2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai












