


 Lar
A CVPR 2026 sinaliza uma mudança de paradigma na inteligência visual à medida que os ganhos marginais vão se esvaindo
Na última década, a visão computacional evoluiu da classificação do ImageNet para os modelos de difusão, com o objetivo de permitir que as máquinas “vejam o mundo”. No entanto, à medida que as capacidades perceptivas se aproximam dos níveis humanos, os ganhos decorrentes do aumento da precisão por si só estão se esvaindo. Na CVPR 2026, a pesquisa em inteligência visual mudou de rumo: a visão não é mais o objetivo final, mas uma ponte para o raciocínio, a tomada de decisões e a interação.
Indo além do “raciocínio cego”: abordagens adaptativas e implícitas
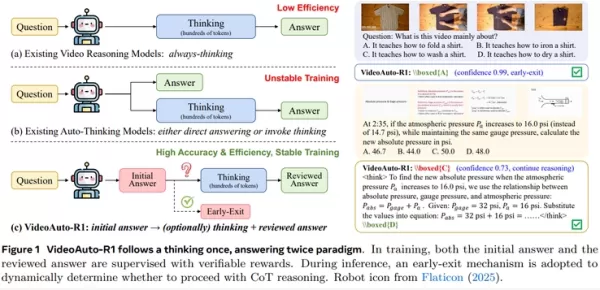
Os modelos multimodais há muito dependem da “cadeia de pensamento” (CoT) para o raciocínio lógico. No entanto, descobertas recentes sugerem que esse raciocínio constante costuma ser ineficiente. A estrutura VideoAuto-R1 introduz o “raciocínio sob demanda”: ela responde diretamente a consultas perceptivas simples e aciona o raciocínio apenas para lógica complexa. Esse método mantém o desempenho máximo ao mesmo tempo em que reduz o comprimento médio da saída em 3,3 vezes.
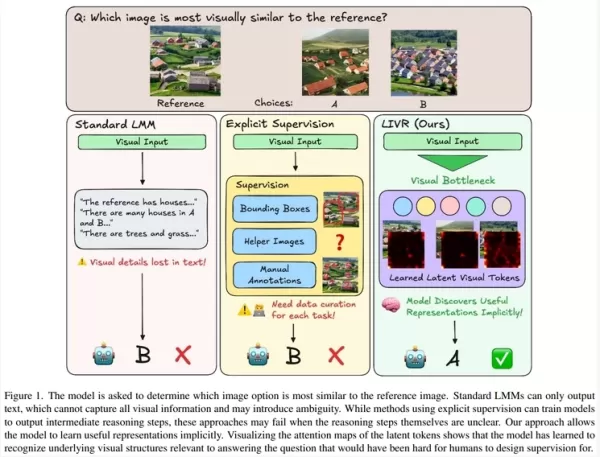
O meio de raciocínio também está evoluindo. Anteriormente, os modelos dependiam da linguagem para descrever relações espaciais, o que falhava em quebra-cabeças ou estruturas geométricas. A nova tendência envolve o raciocínio visual implícito dentro do “espaço latente”, contornando a conversão linear de texto para capturar melhor estruturas visuais complexas.
Repensando a avaliação: quebrando a ilusão das questões de múltipla escolha
As avaliações atuais de modelos de linguagem visual dependem fortemente de questões de múltipla escolha (MCQA), o que pode levar a uma superestimativa das capacidades. Pesquisas indicam que os modelos frequentemente “trapaceiam” por meio da eliminação ou do viés de opções, inflando as pontuações em cerca de 20 pontos. Para corrigir isso, o setor está adotando o “QA aberto verificável”, forçando os modelos a compreender genuinamente o conteúdo visual, em vez de explorar pistas nas opções.
Enquanto isso, os cenários de avaliação estão mudando de imagens estáticas com um único agente para ambientes com múltiplos agentes. Benchmarks como o VS-Bench exigem que os modelos não apenas compreendam o ambiente, mas também demonstrem raciocínio estratégico e tomada de decisão em interações complexas, como colaboração e competição. Isso marca a transição da inteligência visual de um “compreendedor” passivo para um “tomador de decisão” ativo.
Atualizações de infraestrutura: modelos de código aberto e dados do mundo real
A comunidade de código aberto está aumentando a transparência. Modelos como o Molmo2 divulgam não apenas pesos, mas também dados completos e processos de treinamento. Esses modelos ampliam as capacidades, passando de imagens únicas para vídeos, adicionando recursos de localização precisa e dando um salto da “compreensão” para a “identificação de locais”.
Esse progresso é respaldado por uma infraestrutura de dados abrangente. Para a edição de imagens orientada por texto, conjuntos de dados do mundo real em grande escala, como o Pico-Banana-400K, preenchem a lacuna causada pela dependência excessiva de dados sintéticos. Ao oferecer suporte à edição em múltiplas etapas e ao alinhamento de preferências, esse conjunto de dados fornece uma base sólida para o treinamento de modelos de edição com senso comum e lógica aprimorados.
Em resumo, a inteligência visual está evoluindo da percepção isolada para uma inteligência integrada que combina percepção, cognição e ação. Essa mudança representa mais do que pequenos aumentos de desempenho; trata-se de uma reconstrução sistemática dos mecanismos de raciocínio, dos paradigmas de avaliação e das cadeias de suprimento de dados.
Artigo relacionado
 Ações dos EUA Atingem Marco Histórico Enquanto Gigantes de IA e Aeroespacial se Preparam para Estreia de Trilião de Dólares
Elon Musk, Sam Altman e Dario Amodei, três titãs do setor de tecnologia, estão avançando rumo a ofertas públicas iniciais (IPOs) para suas respectivas empresas. Com a SpaceX, a OpenAI e a Anthropic — três gigantes da indústria que se aproximam de ava
Startup sueca de IA Lovable Eyes tem avaliação de US$ 13,2 bilhões após rodada principal de investimentos
À medida que as ferramentas de codificação impulsionadas por IA ganham tração, a startup sueca Lovable garantiu uma grande rodada de financiamento. A empresa visa captar US$ 3 bilhões, o que poderia elevar sua avaliação para US$ 13,2 bilhões — o dobr
O Google testa o Agente Remy AI para o Gemini, à medida que o foco se desloca para o controle do usuário
De acordo com o Business Insider, o Google está testando o Remy, um novo agente pessoal de IA para o Gemini. Esta ferramenta tem como objetivo executar tarefas em nome dos usuários, simplificando tanto os fluxos de trabalho profissionais quanto as ro
Recomendações de tópicos especiais relacionados
Análise de dados
 Melhores ferramentas de detecção de anomalias com IA para monitoramento de KPIs entre equipes de SaaS e comércio eletrônico
2026 Últimas Melhores Ferramentas de Detecção de Anomalias por IA Mais Bem Avaliadas para Monitoramento de KPIs em Equipes de SaaS e E-commerce! A XIX.AI compilou uma coleção poderosa e transformadora, baseada em testes rigorosos do mundo real e classificações atualizadas semanalmente. Você encontrará insights detalhados sobre comparações entre versões gratuitas e pagas para ajudá-lo a identificar a solução que deve ser testada, aumentando a produtividade e desbloqueando sua vantagem com IA. Explore agora!
 10 ferramentas
 xix.ai
escrita
Os melhores geradores de esboços com IA para artigos longos de SEO
Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai
Educação e Aprendizagem
Ferramentas de IA para os deveres de casa e a preparação para provas
As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai
Composição musical
Ferramentas de Demonstração Vocal com IA para Compositores, Ganchos, Toplines e Sessões de Rascunho Multilíngues
2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai
Negócios
As melhores ferramentas de pesquisa competitiva baseadas em IA para pequenas empresas
As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai
Edição de imagem
Ferramentas de Retoque com IA do Photoshop para Moda E-commerce, Limpeza de Pele e Consistência de Cor
2026 Últimas Melhores Ferramentas de Retoque com IA do Photoshop para roupas de comércio eletrônico, limpeza de pele e consistência de cores! Esta lista curada de alta classificação apresenta soluções poderosas que mudam o jogo, ajudando você a aumentar a eficiência da escrita, simplificar a criação de conteúdo e obter resultados visuais perfeitos sem esforço. Cada ferramenta passou por testes do mundo real através de classificações atualizadas semanalmente, com detalhes completos sobre comparação entre gratuito e pago. Com o apoio da XIX.AI, é o guia essencial para quem deseja desbloquear sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai

 Comentários (0)
Na última década, a visão computacional evoluiu da classificação do ImageNet para os modelos de difusão, com o objetivo de permitir que as máquinas “vejam o mundo”. No entanto, à medida que as capacidades perceptivas se aproximam dos níveis humanos, os ganhos decorrentes do aumento da precisão por si só estão se esvaindo. Na CVPR 2026, a pesquisa em inteligência visual mudou de rumo: a visão não é mais o objetivo final, mas uma ponte para o raciocínio, a tomada de decisões e a interação.
Indo além do “raciocínio cego”: abordagens adaptativas e implícitas
Os modelos multimodais há muito dependem da “cadeia de pensamento” (CoT) para o raciocínio lógico. No entanto, descobertas recentes sugerem que esse raciocínio constante costuma ser ineficiente. A estrutura VideoAuto-R1 introduz o “raciocínio sob demanda”: ela responde diretamente a consultas perceptivas simples e aciona o raciocínio apenas para lógica complexa. Esse método mantém o desempenho máximo ao mesmo tempo em que reduz o comprimento médio da saída em 3,3 vezes.
O meio de raciocínio também está evoluindo. Anteriormente, os modelos dependiam da linguagem para descrever relações espaciais, o que falhava em quebra-cabeças ou estruturas geométricas. A nova tendência envolve o raciocínio visual implícito dentro do “espaço latente”, contornando a conversão linear de texto para capturar melhor estruturas visuais complexas.
Repensando a avaliação: quebrando a ilusão das questões de múltipla escolha
As avaliações atuais de modelos de linguagem visual dependem fortemente de questões de múltipla escolha (MCQA), o que pode levar a uma superestimativa das capacidades. Pesquisas indicam que os modelos frequentemente “trapaceiam” por meio da eliminação ou do viés de opções, inflando as pontuações em cerca de 20 pontos. Para corrigir isso, o setor está adotando o “QA aberto verificável”, forçando os modelos a compreender genuinamente o conteúdo visual, em vez de explorar pistas nas opções.
Enquanto isso, os cenários de avaliação estão mudando de imagens estáticas com um único agente para ambientes com múltiplos agentes. Benchmarks como o VS-Bench exigem que os modelos não apenas compreendam o ambiente, mas também demonstrem raciocínio estratégico e tomada de decisão em interações complexas, como colaboração e competição. Isso marca a transição da inteligência visual de um “compreendedor” passivo para um “tomador de decisão” ativo.
Atualizações de infraestrutura: modelos de código aberto e dados do mundo real
A comunidade de código aberto está aumentando a transparência. Modelos como o Molmo2 divulgam não apenas pesos, mas também dados completos e processos de treinamento. Esses modelos ampliam as capacidades, passando de imagens únicas para vídeos, adicionando recursos de localização precisa e dando um salto da “compreensão” para a “identificação de locais”.
Esse progresso é respaldado por uma infraestrutura de dados abrangente. Para a edição de imagens orientada por texto, conjuntos de dados do mundo real em grande escala, como o Pico-Banana-400K, preenchem a lacuna causada pela dependência excessiva de dados sintéticos. Ao oferecer suporte à edição em múltiplas etapas e ao alinhamento de preferências, esse conjunto de dados fornece uma base sólida para o treinamento de modelos de edição com senso comum e lógica aprimorados.
Em resumo, a inteligência visual está evoluindo da percepção isolada para uma inteligência integrada que combina percepção, cognição e ação. Essa mudança representa mais do que pequenos aumentos de desempenho; trata-se de uma reconstrução sistemática dos mecanismos de raciocínio, dos paradigmas de avaliação e das cadeias de suprimento de dados.








 Ações dos EUA Atingem Marco Histórico Enquanto Gigantes de IA e Aeroespacial se Preparam para Estreia de Trilião de Dólares
Elon Musk, Sam Altman e Dario Amodei, três titãs do setor de tecnologia, estão avançando rumo a ofertas públicas iniciais (IPOs) para suas respectivas empresas. Com a SpaceX, a OpenAI e a Anthropic — três gigantes da indústria que se aproximam de ava
 Startup sueca de IA Lovable Eyes tem avaliação de US$ 13,2 bilhões após rodada principal de investimentos
À medida que as ferramentas de codificação impulsionadas por IA ganham tração, a startup sueca Lovable garantiu uma grande rodada de financiamento. A empresa visa captar US$ 3 bilhões, o que poderia elevar sua avaliação para US$ 13,2 bilhões — o dobr
O Google testa o Agente Remy AI para o Gemini, à medida que o foco se desloca para o controle do usuário
De acordo com o Business Insider, o Google está testando o Remy, um novo agente pessoal de IA para o Gemini. Esta ferramenta tem como objetivo executar tarefas em nome dos usuários, simplificando tanto os fluxos de trabalho profissionais quanto as ro

2026 Últimas Melhores Ferramentas de Detecção de Anomalias por IA Mais Bem Avaliadas para Monitoramento de KPIs em Equipes de SaaS e E-commerce! A XIX.AI compilou uma coleção poderosa e transformadora, baseada em testes rigorosos do mundo real e classificações atualizadas semanalmente. Você encontrará insights detalhados sobre comparações entre versões gratuitas e pagas para ajudá-lo a identificar a solução que deve ser testada, aumentando a produtividade e desbloqueando sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai

Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai

As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Retoque com IA do Photoshop para roupas de comércio eletrônico, limpeza de pele e consistência de cores! Esta lista curada de alta classificação apresenta soluções poderosas que mudam o jogo, ajudando você a aumentar a eficiência da escrita, simplificar a criação de conteúdo e obter resultados visuais perfeitos sem esforço. Cada ferramenta passou por testes do mundo real através de classificações atualizadas semanalmente, com detalhes completos sobre comparação entre gratuito e pago. Com o apoio da XIX.AI, é o guia essencial para quem deseja desbloquear sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai












