


 Maison
Le CVPR 2026 annonce un changement de paradigme dans le domaine de l'intelligence visuelle, à mesure que les gains marginaux s'estompent
Au cours de la dernière décennie, la vision par ordinateur a évolué, passant de la classification ImageNet aux modèles de diffusion, dans le but de permettre aux machines de « voir le monde ». Cependant, à mesure que les capacités perceptives se rapprochent de celles de l’être humain, les gains en termes de précision pure perdent de leur intérêt. Lors de la conférence CVPR 2026, la recherche en intelligence visuelle a pris un nouveau tournant : la vision n’est plus un objectif en soi, mais un tremplin vers le raisonnement, la prise de décision et l’interaction.
Au-delà du « raisonnement aveugle » : approches adaptatives et implicites
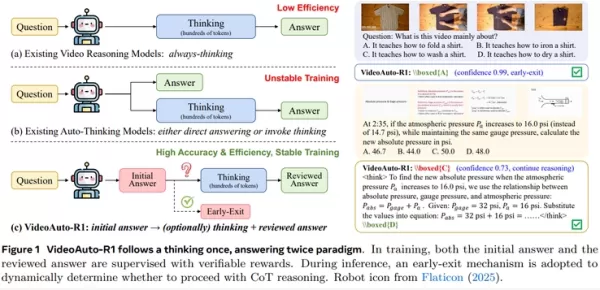
Les modèles multimodaux s’appuient depuis longtemps sur la « chaîne de pensée » (CoT) pour le raisonnement logique. Cependant, des découvertes récentes suggèrent que ce raisonnement constant est souvent inefficace. Le cadre VideoAuto-R1 introduit le « raisonnement à la demande » : il répond directement aux requêtes perceptives simples et ne déclenche le raisonnement que pour la logique complexe. Cette méthode maintient des performances optimales tout en réduisant de 3,3 fois la longueur moyenne des sorties.
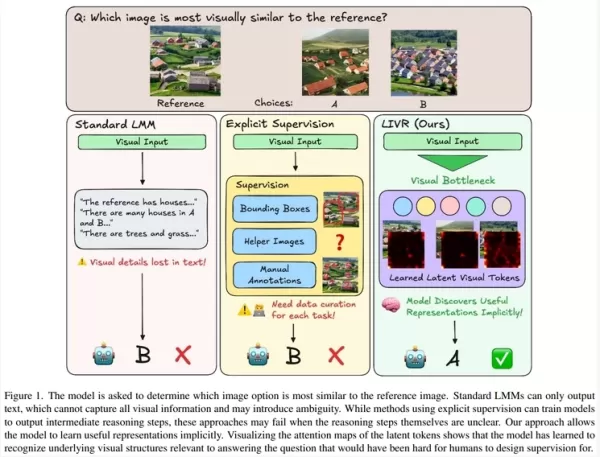
Le support du raisonnement évolue également. Auparavant, les modèles s’appuyaient sur le langage pour décrire les relations spatiales, ce qui s’avérait inefficace face à des casse-têtes ou des structures géométriques. La nouvelle tendance consiste en un raisonnement visuel implicite au sein de l’« espace latent », contournant la conversion linéaire en texte afin de mieux saisir les structures visuelles complexes.
Repenser l’évaluation : briser l’illusion des questions à choix multiples
Les évaluations actuelles des modèles visuels-linguistiques s’appuient fortement sur les questions à choix multiples (MCQA), ce qui peut conduire à une surestimation des capacités. Des recherches indiquent que les modèles « trichent » souvent par élimination ou par biais de réponse, gonflant ainsi les scores d’environ 20 points. Pour remédier à cela, le secteur adopte des « questions-réponses ouvertes vérifiables », obligeant les modèles à véritablement comprendre le contenu visuel plutôt que d’exploiter des indices présents dans les options.
Parallèlement, les scénarios d’évaluation évoluent, passant d’images statiques à agent unique vers des environnements multi-agents. Des benchmarks tels que VS-Bench exigent des modèles qu’ils ne se contentent pas de comprendre l’environnement, mais qu’ils fassent également preuve de raisonnement stratégique et de prise de décision dans le cadre d’interactions complexes, telles que la collaboration et la compétition. Cela marque la transition de l’intelligence visuelle d’un « compreneur » passif vers un « décideur » actif.
Améliorations de l’infrastructure : modèles open source et données du monde réel
La communauté open source renforce la transparence. Des modèles comme Molmo2 publient non seulement les poids, mais aussi l’intégralité des données et des processus d’entraînement. Ces modèles étendent leurs capacités des images individuelles aux vidéos, en ajoutant des fonctionnalités de localisation précises et en franchissant un cap décisif, passant de la « compréhension » à la « localisation d’emplacements ».
Ces progrès s’appuient sur une infrastructure de données complète. Pour l’édition d’images pilotée par le texte, des ensembles de données à grande échelle issues du monde réel, tels que Pico-Banana-400K, comblent le fossé causé par une dépendance excessive aux données synthétiques. Prenant en charge l’édition en plusieurs étapes et l’alignement des préférences, cet ensemble de données offre une base solide pour l’entraînement de modèles d’édition dotés d’un sens commun et d’une logique améliorés.
En résumé, l’intelligence visuelle évolue d’une simple perception vers une intelligence intégrée combinant perception, cognition et action. Cette évolution représente bien plus qu’une simple amélioration des performances ; il s’agit d’une reconstruction systématique des mécanismes de raisonnement, des paradigmes d’évaluation et des chaînes d’approvisionnement en données.
Article connexe
 Les actions américaines atteignent un jalon historique alors que les géants de l'IA et de l'aérospatiale se préparent pour leur entrée boursière à la valeur du trillion de dollars.
Elon Musk, Sam Altman et Dario Amodei, trois titans du secteur technologique, s’approchent des introductions en bourse de leurs entreprises respectives. Avec SpaceX, OpenAI et Anthropic – trois géants de l’industrie dont les valorisations approchent
La startup suédoise en intelligence artificielle Lovable Eyes atteint une valorisation de 13,2 milliards de dollars après un tour de table majeur
Alors que les outils de codage alimentés par l’intelligence artificielle gagnent en popularité, la startup suédoise Lovable a levé des fonds lors d’un tour de table majeur. L’entreprise vise à collecter 3 milliards de dollars, ce qui pourrait porter
Google teste l'agent IA Remy pour Gemini à mesure que l'accent se déplace vers le contrôle utilisateur
Selon Business Insider, Google teste Remy, un nouvel agent personnel d’IA pour Gemini. Cet outil vise à exécuter des tâches au nom des utilisateurs, rationalisant ainsi les flux de travail professionnels et les routines quotidiennes.Actuellement, Re
Recommandations de sujets spéciaux liés
Analyse des données
 Meilleurs outils d’IA pour la détection d’anomalies dans le suivi des KPI pour les équipes SaaS et Ecommerce
2026 Derniers Meilleurs Outils de Détection d’Anomalies par IA les mieux notés pour la surveillance des KPI dans les équipes SaaS et E-commerce ! XIX.AI a sélectionné une collection puissante et révolutionnaire, basée sur des tests rigoureux en conditions réelles et des classements mis à jour chaque semaine. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, afin de vous aider à identifier la solution incontournable qui améliore la productivité et débloque votre avantage concurrentiel grâce à l’IA. Explorez dès maintenant !
 10 outils
 xix.ai
en écrivant
Les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs
2026 : les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs, soigneusement sélectionnés par XIX.AI. Ces outils puissants offrent une aide révolutionnaire pour créer rapidement du contenu de haute qualité, améliorant ainsi considérablement l'efficacité de la rédaction. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests concrets et des classements détaillés pour vous aider à trouver l'option incontournable qui répond à vos besoins. Explorez dès maintenant pour tirer pleinement parti de l'IA.
8 outils
xix.ai
Éducation et apprentissage
Outils d'étude basés sur l'IA pour les devoirs et la préparation aux examens
Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai
Composition musicale
Outils de démo vocale par IA pour les auteurs-compositeurs, les accroches, les mélodies principales et les sessions de brouillons multilingues
2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai
Entreprise
Les meilleurs outils de veille concurrentielle basés sur l'IA pour les petites entreprises
Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai
Édition d'images
Outils de retouche par IA Photoshop pour les vêtements d’e-commerce, nettoyage de la peau et cohérence des couleurs
2026 Derniers meilleurs outils de retouche par IA Photoshop pour les vêtements e-commerce, le nettoyage de la peau et la cohérence des couleurs ! Cette liste soigneusement sélectionnée et hautement notée propose des solutions puissantes qui changent la donne, vous aidant à améliorer l’efficacité rédactionnelle, rationaliser la création de contenu et obtenir des résultats visuels parfaits sans effort. Chaque outil a été testé dans des conditions réelles grâce à des classements mis à jour chaque semaine, accompagnés de détails comparatifs entre versions gratuites et payantes. Soutenu par XIX.AI, c’est le guide incontournable pour quiconque souhaite exploiter son avantage grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai

 commentaires (0)
Au cours de la dernière décennie, la vision par ordinateur a évolué, passant de la classification ImageNet aux modèles de diffusion, dans le but de permettre aux machines de « voir le monde ». Cependant, à mesure que les capacités perceptives se rapprochent de celles de l’être humain, les gains en termes de précision pure perdent de leur intérêt. Lors de la conférence CVPR 2026, la recherche en intelligence visuelle a pris un nouveau tournant : la vision n’est plus un objectif en soi, mais un tremplin vers le raisonnement, la prise de décision et l’interaction.
Au-delà du « raisonnement aveugle » : approches adaptatives et implicites
Les modèles multimodaux s’appuient depuis longtemps sur la « chaîne de pensée » (CoT) pour le raisonnement logique. Cependant, des découvertes récentes suggèrent que ce raisonnement constant est souvent inefficace. Le cadre VideoAuto-R1 introduit le « raisonnement à la demande » : il répond directement aux requêtes perceptives simples et ne déclenche le raisonnement que pour la logique complexe. Cette méthode maintient des performances optimales tout en réduisant de 3,3 fois la longueur moyenne des sorties.
Le support du raisonnement évolue également. Auparavant, les modèles s’appuyaient sur le langage pour décrire les relations spatiales, ce qui s’avérait inefficace face à des casse-têtes ou des structures géométriques. La nouvelle tendance consiste en un raisonnement visuel implicite au sein de l’« espace latent », contournant la conversion linéaire en texte afin de mieux saisir les structures visuelles complexes.
Repenser l’évaluation : briser l’illusion des questions à choix multiples
Les évaluations actuelles des modèles visuels-linguistiques s’appuient fortement sur les questions à choix multiples (MCQA), ce qui peut conduire à une surestimation des capacités. Des recherches indiquent que les modèles « trichent » souvent par élimination ou par biais de réponse, gonflant ainsi les scores d’environ 20 points. Pour remédier à cela, le secteur adopte des « questions-réponses ouvertes vérifiables », obligeant les modèles à véritablement comprendre le contenu visuel plutôt que d’exploiter des indices présents dans les options.
Parallèlement, les scénarios d’évaluation évoluent, passant d’images statiques à agent unique vers des environnements multi-agents. Des benchmarks tels que VS-Bench exigent des modèles qu’ils ne se contentent pas de comprendre l’environnement, mais qu’ils fassent également preuve de raisonnement stratégique et de prise de décision dans le cadre d’interactions complexes, telles que la collaboration et la compétition. Cela marque la transition de l’intelligence visuelle d’un « compreneur » passif vers un « décideur » actif.
Améliorations de l’infrastructure : modèles open source et données du monde réel
La communauté open source renforce la transparence. Des modèles comme Molmo2 publient non seulement les poids, mais aussi l’intégralité des données et des processus d’entraînement. Ces modèles étendent leurs capacités des images individuelles aux vidéos, en ajoutant des fonctionnalités de localisation précises et en franchissant un cap décisif, passant de la « compréhension » à la « localisation d’emplacements ».
Ces progrès s’appuient sur une infrastructure de données complète. Pour l’édition d’images pilotée par le texte, des ensembles de données à grande échelle issues du monde réel, tels que Pico-Banana-400K, comblent le fossé causé par une dépendance excessive aux données synthétiques. Prenant en charge l’édition en plusieurs étapes et l’alignement des préférences, cet ensemble de données offre une base solide pour l’entraînement de modèles d’édition dotés d’un sens commun et d’une logique améliorés.
En résumé, l’intelligence visuelle évolue d’une simple perception vers une intelligence intégrée combinant perception, cognition et action. Cette évolution représente bien plus qu’une simple amélioration des performances ; il s’agit d’une reconstruction systématique des mécanismes de raisonnement, des paradigmes d’évaluation et des chaînes d’approvisionnement en données.








 Les actions américaines atteignent un jalon historique alors que les géants de l'IA et de l'aérospatiale se préparent pour leur entrée boursière à la valeur du trillion de dollars.
Elon Musk, Sam Altman et Dario Amodei, trois titans du secteur technologique, s’approchent des introductions en bourse de leurs entreprises respectives. Avec SpaceX, OpenAI et Anthropic – trois géants de l’industrie dont les valorisations approchent
 La startup suédoise en intelligence artificielle Lovable Eyes atteint une valorisation de 13,2 milliards de dollars après un tour de table majeur
Alors que les outils de codage alimentés par l’intelligence artificielle gagnent en popularité, la startup suédoise Lovable a levé des fonds lors d’un tour de table majeur. L’entreprise vise à collecter 3 milliards de dollars, ce qui pourrait porter
Google teste l'agent IA Remy pour Gemini à mesure que l'accent se déplace vers le contrôle utilisateur
Selon Business Insider, Google teste Remy, un nouvel agent personnel d’IA pour Gemini. Cet outil vise à exécuter des tâches au nom des utilisateurs, rationalisant ainsi les flux de travail professionnels et les routines quotidiennes.Actuellement, Re

2026 Derniers Meilleurs Outils de Détection d’Anomalies par IA les mieux notés pour la surveillance des KPI dans les équipes SaaS et E-commerce ! XIX.AI a sélectionné une collection puissante et révolutionnaire, basée sur des tests rigoureux en conditions réelles et des classements mis à jour chaque semaine. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, afin de vous aider à identifier la solution incontournable qui améliore la productivité et débloque votre avantage concurrentiel grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai

2026 : les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs, soigneusement sélectionnés par XIX.AI. Ces outils puissants offrent une aide révolutionnaire pour créer rapidement du contenu de haute qualité, améliorant ainsi considérablement l'efficacité de la rédaction. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests concrets et des classements détaillés pour vous aider à trouver l'option incontournable qui répond à vos besoins. Explorez dès maintenant pour tirer pleinement parti de l'IA.
8 outils
xix.ai

Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai

Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai

2026 Derniers meilleurs outils de retouche par IA Photoshop pour les vêtements e-commerce, le nettoyage de la peau et la cohérence des couleurs ! Cette liste soigneusement sélectionnée et hautement notée propose des solutions puissantes qui changent la donne, vous aidant à améliorer l’efficacité rédactionnelle, rationaliser la création de contenu et obtenir des résultats visuels parfaits sans effort. Chaque outil a été testé dans des conditions réelles grâce à des classements mis à jour chaque semaine, accompagnés de détails comparatifs entre versions gratuites et payantes. Soutenu par XIX.AI, c’est le guide incontournable pour quiconque souhaite exploiter son avantage grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai












