


 Lar
Cursor Composer 2 x Claude Opus 4.6: Teste de desempenho reacende o debate sobre programação com IA
Em 19 de março, a Cursor lançou oficialmente seu modelo de programação desenvolvido internamente, o Composer 2. O anúncio gerou discussão imediata na comunidade de desenvolvedores – segundo a Cursor, o Composer 2 obteve 61,7% no Terminal-Bench 2.0, superando notavelmente os 58,0% do Claude Opus 4.6 em condições de teste idênticas.
Será que o modelo carro-chefe da Anthropic foi superado por um modelo integrado ao seu próprio IDE? À medida que a notícia se espalhou, debates surgiram rapidamente.
Três resultados-chave de benchmark
A Cursor publicou três conjuntos de resultados de benchmark, todos divulgados publicamente:
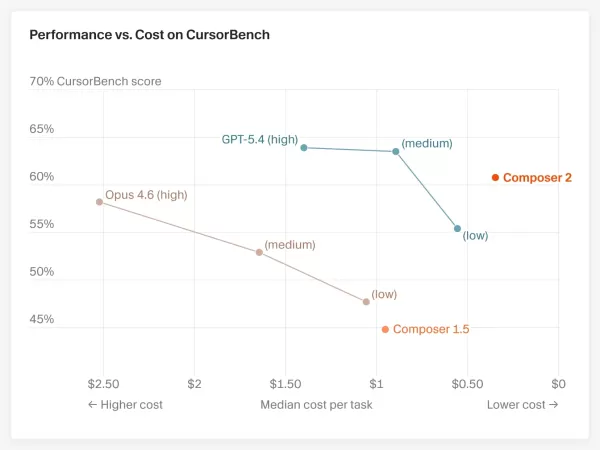
Terminal-Bench 2.0 (tarefas de codificação em terminal no estilo agente): o Composer 2 obteve 61,7%, superando os 58,0%do Claude Opus 4.6. No entanto, o OpenAI GPT-5.4 continua à frente com 75,1%. CursorBench (cenários de codificação do mundo real dentro do Cursor): O Composer 2 atingiu 61,3%, um salto substancial em relação aos 44,2% do Composer 1.5 anterior, e também superior aos 58,2%do Claude Opus 4.6. SWE-bench Multilingual (engenharia de software multilíngue): O Composer 2 alcançou 73,7%, uma melhoria notável em relação ao seu antecessor.No entanto, vale a pena destacar um detalhe: a Anthropic informou anteriormente que o Claude Opus 4.6 obteve 65,4% no Terminal-Bench 2.0 em configurações otimizadas, muito acima dos 58,0% citados pelo Cursor. A discrepância decorre da estrutura de testes – a Cursor utilizou ambientes de agentes de terceiros, como o Harbor, e calculou a média dos resultados em cinco execuções, enquanto os números da Anthropic vieram de sua própria configuração otimizada. Esses dois conjuntos de números não são diretamente comparáveis, pois utilizam sistemas de referência diferentes. A Cursor não se esquivou disso; o anúncio declarou explicitamente que “os resultados dependem do agente, do harness e das configurações”.
Custo de apenas um décimo do Opus 4.6
A relação custo-benefício é a verdadeira vantagem oculta do Composer 2.
Com preço de US$ 0,50 / US$ 2,50 por milhão de tokens de entrada/saída, contra US$ 5 / US$ 25 do Claude Opus 4.6 e US$ 2,5 / US$ 15 do GPT-5.4, o contraste é gritante. A Cursor explica que o Composer 2 foi construído do zero para tarefas de codificação de longo prazo, utilizando seu treinamento RL proprietário e tecnologia de “auto-resumo” para reduzir tanto a latência quanto o custo – o que eles descrevem como “inteligência de ponta + velocidade extrema”.
O Composer 2 é o terceiro modelo interno da Cursor, sucedendo o Composer 1 (outubro de 2025) e a versão 1.5 (fevereiro de 2026). Este lançamento enfatiza “tarefas de longo prazo” e torna uma variante mais rápida e leve o modelo padrão no Cursor IDE.
O que significa esse “renascimento das cinzas”
A decisão da Cursor de comparar diretamente seu modelo com o Opus 4.6 sinaliza uma mudança no panorama mais amplo das ferramentas de codificação de IA.
A OpenAI e a Anthropic competem em capacidades de ponta gerais, enquanto fornecedores de ferramentas verticais como a Cursor seguiram um caminho diferente: aprimorando o desempenho em tarefas específicas a um nível excepcional e, em seguida, usando vantagens de preço para se destacar. Veículos de mídia como VentureBeat e The New Stack observaram que o Composer 2 acelerará a implementação prática do “roteamento multimodelo” – usando o Opus ou o GPT para raciocínios complexos e mudando para o Composer 2 para a codificação cotidiana de alta frequência, obtendo benefícios em ambos os lados.
O Claude Opus 4.6 foi lançado em 5 de fevereiro e liderou em vários benchmarks, incluindo Terminal-Bench 2.0, Humanity's Last Exam e GDPval-AA. Os novos resultados da Cursor, no mínimo, levantam questões sobre esse domínio no segmento de codificação especializada.
A resposta dos desenvolvedores tem sido amplamente positiva até agora, mas muitos dizem que querem ver o desempenho em projetos do mundo real antes de tirar conclusões – uma postura justa, já que benchmarks são apenas benchmarks. A Cursor já disponibilizou o Composer 2 para teste gratuito dentro do IDE para usuários assinantes.
Fonte dos dados: Anúncios oficiais do Cursor e principais meios de comunicação de tecnologia, em 20 de março de 2026. As classificações atuais podem ser consultadas em tbench.ai ou no site do Cursor.
Artigo relacionado
 Ações dos EUA Atingem Marco Histórico Enquanto Gigantes de IA e Aeroespacial se Preparam para Estreia de Trilião de Dólares
Elon Musk, Sam Altman e Dario Amodei, três titãs do setor de tecnologia, estão avançando rumo a ofertas públicas iniciais (IPOs) para suas respectivas empresas. Com a SpaceX, a OpenAI e a Anthropic — três gigantes da indústria que se aproximam de ava
Startup sueca de IA Lovable Eyes tem avaliação de US$ 13,2 bilhões após rodada principal de investimentos
À medida que as ferramentas de codificação impulsionadas por IA ganham tração, a startup sueca Lovable garantiu uma grande rodada de financiamento. A empresa visa captar US$ 3 bilhões, o que poderia elevar sua avaliação para US$ 13,2 bilhões — o dobr
O Google testa o Agente Remy AI para o Gemini, à medida que o foco se desloca para o controle do usuário
De acordo com o Business Insider, o Google está testando o Remy, um novo agente pessoal de IA para o Gemini. Esta ferramenta tem como objetivo executar tarefas em nome dos usuários, simplificando tanto os fluxos de trabalho profissionais quanto as ro
Recomendações de tópicos especiais relacionados
Análise de dados
 Melhores ferramentas de detecção de anomalias com IA para monitoramento de KPIs entre equipes de SaaS e comércio eletrônico
2026 Últimas Melhores Ferramentas de Detecção de Anomalias por IA Mais Bem Avaliadas para Monitoramento de KPIs em Equipes de SaaS e E-commerce! A XIX.AI compilou uma coleção poderosa e transformadora, baseada em testes rigorosos do mundo real e classificações atualizadas semanalmente. Você encontrará insights detalhados sobre comparações entre versões gratuitas e pagas para ajudá-lo a identificar a solução que deve ser testada, aumentando a produtividade e desbloqueando sua vantagem com IA. Explore agora!
 10 ferramentas
 xix.ai
escrita
Os melhores geradores de esboços com IA para artigos longos de SEO
Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai
Educação e Aprendizagem
Ferramentas de IA para os deveres de casa e a preparação para provas
As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai
Composição musical
Ferramentas de Demonstração Vocal com IA para Compositores, Ganchos, Toplines e Sessões de Rascunho Multilíngues
2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai
Negócios
As melhores ferramentas de pesquisa competitiva baseadas em IA para pequenas empresas
As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai
Edição de imagem
Ferramentas de Retoque com IA do Photoshop para Moda E-commerce, Limpeza de Pele e Consistência de Cor
2026 Últimas Melhores Ferramentas de Retoque com IA do Photoshop para roupas de comércio eletrônico, limpeza de pele e consistência de cores! Esta lista curada de alta classificação apresenta soluções poderosas que mudam o jogo, ajudando você a aumentar a eficiência da escrita, simplificar a criação de conteúdo e obter resultados visuais perfeitos sem esforço. Cada ferramenta passou por testes do mundo real através de classificações atualizadas semanalmente, com detalhes completos sobre comparação entre gratuito e pago. Com o apoio da XIX.AI, é o guia essencial para quem deseja desbloquear sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai

 Comentários (0)
Em 19 de março, a Cursor lançou oficialmente seu modelo de programação desenvolvido internamente, o Composer 2. O anúncio gerou discussão imediata na comunidade de desenvolvedores – segundo a Cursor, o Composer 2 obteve 61,7% no Terminal-Bench 2.0, superando notavelmente os 58,0% do Claude Opus 4.6 em condições de teste idênticas.
Será que o modelo carro-chefe da Anthropic foi superado por um modelo integrado ao seu próprio IDE? À medida que a notícia se espalhou, debates surgiram rapidamente.
Três resultados-chave de benchmark
A Cursor publicou três conjuntos de resultados de benchmark, todos divulgados publicamente:
Terminal-Bench 2.0 (tarefas de codificação em terminal no estilo agente): o Composer 2 obteve 61,7%, superando os 58,0%do Claude Opus 4.6. No entanto, o OpenAI GPT-5.4 continua à frente com 75,1%. CursorBench (cenários de codificação do mundo real dentro do Cursor): O Composer 2 atingiu 61,3%, um salto substancial em relação aos 44,2% do Composer 1.5 anterior, e também superior aos 58,2%do Claude Opus 4.6. SWE-bench Multilingual (engenharia de software multilíngue): O Composer 2 alcançou 73,7%, uma melhoria notável em relação ao seu antecessor.No entanto, vale a pena destacar um detalhe: a Anthropic informou anteriormente que o Claude Opus 4.6 obteve 65,4% no Terminal-Bench 2.0 em configurações otimizadas, muito acima dos 58,0% citados pelo Cursor. A discrepância decorre da estrutura de testes – a Cursor utilizou ambientes de agentes de terceiros, como o Harbor, e calculou a média dos resultados em cinco execuções, enquanto os números da Anthropic vieram de sua própria configuração otimizada. Esses dois conjuntos de números não são diretamente comparáveis, pois utilizam sistemas de referência diferentes. A Cursor não se esquivou disso; o anúncio declarou explicitamente que “os resultados dependem do agente, do harness e das configurações”.
Custo de apenas um décimo do Opus 4.6
A relação custo-benefício é a verdadeira vantagem oculta do Composer 2.
Com preço de US$ 0,50 / US$ 2,50 por milhão de tokens de entrada/saída, contra US$ 5 / US$ 25 do Claude Opus 4.6 e US$ 2,5 / US$ 15 do GPT-5.4, o contraste é gritante. A Cursor explica que o Composer 2 foi construído do zero para tarefas de codificação de longo prazo, utilizando seu treinamento RL proprietário e tecnologia de “auto-resumo” para reduzir tanto a latência quanto o custo – o que eles descrevem como “inteligência de ponta + velocidade extrema”.
O Composer 2 é o terceiro modelo interno da Cursor, sucedendo o Composer 1 (outubro de 2025) e a versão 1.5 (fevereiro de 2026). Este lançamento enfatiza “tarefas de longo prazo” e torna uma variante mais rápida e leve o modelo padrão no Cursor IDE.
O que significa esse “renascimento das cinzas”
A decisão da Cursor de comparar diretamente seu modelo com o Opus 4.6 sinaliza uma mudança no panorama mais amplo das ferramentas de codificação de IA.
A OpenAI e a Anthropic competem em capacidades de ponta gerais, enquanto fornecedores de ferramentas verticais como a Cursor seguiram um caminho diferente: aprimorando o desempenho em tarefas específicas a um nível excepcional e, em seguida, usando vantagens de preço para se destacar. Veículos de mídia como VentureBeat e The New Stack observaram que o Composer 2 acelerará a implementação prática do “roteamento multimodelo” – usando o Opus ou o GPT para raciocínios complexos e mudando para o Composer 2 para a codificação cotidiana de alta frequência, obtendo benefícios em ambos os lados.
O Claude Opus 4.6 foi lançado em 5 de fevereiro e liderou em vários benchmarks, incluindo Terminal-Bench 2.0, Humanity's Last Exam e GDPval-AA. Os novos resultados da Cursor, no mínimo, levantam questões sobre esse domínio no segmento de codificação especializada.
A resposta dos desenvolvedores tem sido amplamente positiva até agora, mas muitos dizem que querem ver o desempenho em projetos do mundo real antes de tirar conclusões – uma postura justa, já que benchmarks são apenas benchmarks. A Cursor já disponibilizou o Composer 2 para teste gratuito dentro do IDE para usuários assinantes.
Fonte dos dados: Anúncios oficiais do Cursor e principais meios de comunicação de tecnologia, em 20 de março de 2026. As classificações atuais podem ser consultadas em tbench.ai ou no site do Cursor.








 Ações dos EUA Atingem Marco Histórico Enquanto Gigantes de IA e Aeroespacial se Preparam para Estreia de Trilião de Dólares
Elon Musk, Sam Altman e Dario Amodei, três titãs do setor de tecnologia, estão avançando rumo a ofertas públicas iniciais (IPOs) para suas respectivas empresas. Com a SpaceX, a OpenAI e a Anthropic — três gigantes da indústria que se aproximam de ava
 Startup sueca de IA Lovable Eyes tem avaliação de US$ 13,2 bilhões após rodada principal de investimentos
À medida que as ferramentas de codificação impulsionadas por IA ganham tração, a startup sueca Lovable garantiu uma grande rodada de financiamento. A empresa visa captar US$ 3 bilhões, o que poderia elevar sua avaliação para US$ 13,2 bilhões — o dobr
O Google testa o Agente Remy AI para o Gemini, à medida que o foco se desloca para o controle do usuário
De acordo com o Business Insider, o Google está testando o Remy, um novo agente pessoal de IA para o Gemini. Esta ferramenta tem como objetivo executar tarefas em nome dos usuários, simplificando tanto os fluxos de trabalho profissionais quanto as ro

2026 Últimas Melhores Ferramentas de Detecção de Anomalias por IA Mais Bem Avaliadas para Monitoramento de KPIs em Equipes de SaaS e E-commerce! A XIX.AI compilou uma coleção poderosa e transformadora, baseada em testes rigorosos do mundo real e classificações atualizadas semanalmente. Você encontrará insights detalhados sobre comparações entre versões gratuitas e pagas para ajudá-lo a identificar a solução que deve ser testada, aumentando a produtividade e desbloqueando sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai

Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai

As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Retoque com IA do Photoshop para roupas de comércio eletrônico, limpeza de pele e consistência de cores! Esta lista curada de alta classificação apresenta soluções poderosas que mudam o jogo, ajudando você a aumentar a eficiência da escrita, simplificar a criação de conteúdo e obter resultados visuais perfeitos sem esforço. Cada ferramenta passou por testes do mundo real através de classificações atualizadas semanalmente, com detalhes completos sobre comparação entre gratuito e pago. Com o apoio da XIX.AI, é o guia essencial para quem deseja desbloquear sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai












