


 Lar
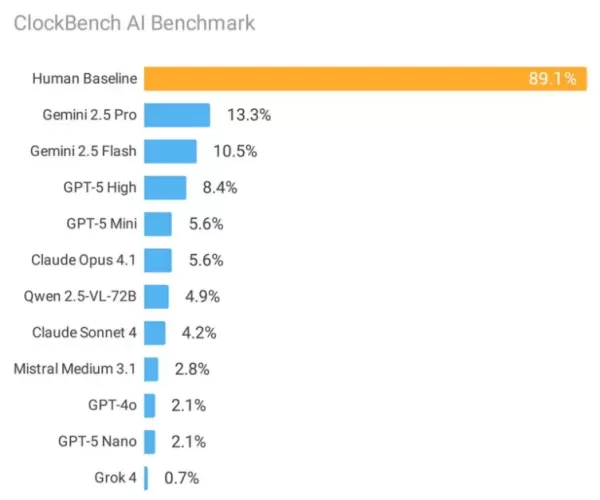
Uma avaliação histórica que comparou 11 sistemas de inteligência artificial de ponta com o desempenho humano na leitura de relógios analógicos revelou vulnerabilidades significativas nas arquiteturas atuais de aprendizado de máquina. Enquanto os participantes humanos demonstraram uma precisão notável de 89,1% na leitura de horas, até mesmo o modelo de IA de melhor desempenho do Google obteve uma taxa de sucesso de apenas 13,3% em condições de teste idênticas.
A investigação do ClockBench, liderada pelo pesquisador Alek Safar, ressalta como as tarefas fundamentais de raciocínio visual que as crianças normalmente dominam continuam a desafiar os algoritmos de IA mais sofisticados. A avaliação rigorosa examinou plataformas de líderes do setor, incluindo Google, OpenAI e Anthropic, usando 180 designs de relógios analógicos especialmente criados.
Essas descobertas apontam para problemas estruturais mais profundos na forma como as redes neurais processam e interpretam dados visuais. "A leitura precisa de relógios analógicos requer um raciocínio espacial sofisticado em contextos visuais", explica Safar na pesquisa publicada. O processo cognitivo de várias etapas envolve o reconhecimento da mão, a análise posicional e a conversão numérica - operações que revelam deficiências críticas da IA.
O contraste nos padrões de erro é particularmente revelador. Os erros humanos normalmente resultaram em pequenos desvios de aproximadamente três minutos, enquanto os sistemas de IA produziram estimativas extremamente imprecisas, com uma média de 1 a 3 horas, o que equivale efetivamente a palpites aleatórios em um relógio padrão.
Principais limitações de desempenho
As plataformas de inteligência artificial apresentaram dificuldades notáveis com:
- Mostradores de relógios com números romanos (atingindo apenas 3,2% de precisão)
- Orientações de relógio invertidas ou espelhadas
- Fundos visualmente complexos e designs artísticos
- Medição precisa da posição dos ponteiros dos segundos
Surgiu uma observação reveladora: quando os sistemas de IA interpretavam corretamente as leituras iniciais do relógio, eles posteriormente se destacavam em cálculos baseados no tempo, como conversões e aritmética. Isso indica que o principal obstáculo está na compreensão visual e não nos recursos de processamento matemático.
Análise comparativa do setor
O Gemini 2.5 Pro do Google liderou as ofertas comerciais com 13,3% de precisão, seguido de perto pelo Gemini 2.5 Flash com 10,5%. O GPT-5 da OpenAI conseguiu 8,4% de respostas corretas, enquanto os modelos Claude da Anthropic tiveram um desempenho inferior, com o Claude 4 Sonnet atingindo apenas 4,2% e o Claude 4.1 Opus alcançando 5,6%.
O Grok 4 da xAI produziu resultados particularmente preocupantes com 0,7% de precisão, principalmente devido à identificação incorreta de 63% das exibições válidas de relógios como mostrando horários impossíveis, apesar de apenas 20,6% apresentarem configurações incorretas.
Implicações fundamentais para o avanço da IA
Esta pesquisa amplia o paradigma dos benchmarks "humano-simples, IA-complexo" exemplificados por iniciativas como ARC-AGI e SimpleBench. Embora a inteligência artificial tenha alcançado um desempenho sobre-humano em diversas avaliações baseadas em conhecimento e exames profissionais, o raciocínio visual primitivo apresenta desafios persistentes.
A análise de Safar sugere que a metodologia atual de dimensionamento do tamanho do modelo e dos dados de treinamento pode não abordar com eficácia essas limitações do processamento visual. Dois fatores hipotéticos incluem a representação insuficiente de relógios analógicos em corpora de treinamento e dificuldades inerentes à tradução de relações espaciais entre componentes gráficos de relógios e representações textuais.
O ClockBench se junta a um conjunto em expansão de ferramentas de diagnóstico projetadas para descobrir lacunas não óbvias nos recursos de IA. Para manter a integridade da avaliação, o conjunto completo de dados permanece restrito para evitar a contaminação do treinamento de modelos futuros, com apenas subconjuntos de amostras controladas disponíveis para verificação.
As descobertas provocam questões cruciais sobre se as melhorias incrementais nas arquiteturas existentes podem suprir essas deficiências de raciocínio ou se são necessárias abordagens fundamentalmente novas - espelhando os avanços históricos possibilitados por inovações como a computação em tempo de teste em outros domínios de IA.
Em um futuro próximo, o relógio mecânico analógico permanecerá como uma referência inesperadamente robusta da inteligência humana - uma tecnologia que podemos interpretar sem esforço e que continua a confundir nossas criações computacionais mais avançadas.

































