


 Hogar
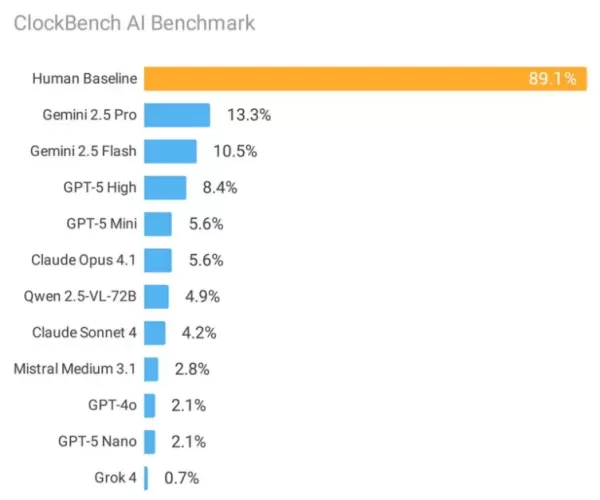
Una evaluación histórica que compara 11 sistemas de inteligencia artificial de vanguardia con el rendimiento humano en la lectura de relojes analógicos ha revelado vulnerabilidades significativas en las arquitecturas actuales de aprendizaje automático. Mientras que los participantes humanos demostraron una notable precisión del 89,1% en la lectura de la hora, incluso el modelo de inteligencia artificial de mayor rendimiento de Google apenas alcanzó un 13,3% de aciertos en condiciones de prueba idénticas.
La investigación de ClockBench, encabezada por el investigador Alek Safar, subraya cómo las tareas fundamentales de razonamiento visual que suelen dominar los niños siguen siendo un reto para los algoritmos de IA más sofisticados. La rigurosa evaluación examinó plataformas de líderes del sector como Google, OpenAI y Anthropic utilizando 180 diseños de relojes analógicos especialmente elaborados.
Estos resultados apuntan a problemas estructurales más profundos en la forma en que las redes neuronales procesan e interpretan los datos visuales. "La lectura precisa de relojes analógicos requiere un sofisticado razonamiento espacial en contextos visuales", explica Safar en la investigación publicada. El proceso cognitivo de varios pasos implica el reconocimiento de las manos, el análisis posicional y la conversión numérica, operaciones que revelan deficiencias críticas de la IA".
El contraste en los patrones de error resulta especialmente revelador. Los errores humanos solían dar lugar a desviaciones menores de unos tres minutos, mientras que los sistemas de IA producían estimaciones tremendamente imprecisas de entre 1 y 3 horas de media, lo que equivale en la práctica a suposiciones aleatorias en la esfera de un reloj estándar.
Principales limitaciones de rendimiento
Las plataformas de inteligencia artificial mostraron notables dificultades con
- las esferas con números romanos (sólo un 3,2% de precisión)
- Orientaciones invertidas o reflejadas de los relojes
- Fondos visualmente complejos y diseños artísticos
- Medición precisa de la posición del segundero
Una observación reveladora: cuando los sistemas de IA interpretaron correctamente las lecturas iniciales del reloj, destacaron posteriormente en los cálculos basados en el tiempo, como las conversiones y la aritmética. Esto indica que el principal obstáculo reside en la comprensión visual más que en las capacidades de procesamiento matemático.
Análisis comparativo del sector
Gemini 2.5 Pro de Google lideró la oferta comercial con un 13,3% de precisión, seguido de cerca por Gemini 2.5 Flash con un 10,5%. El GPT-5 de OpenAI obtuvo un 8,4% de respuestas correctas, mientras que los modelos Claude de Anthropic obtuvieron peores resultados, con Claude 4 Sonnet alcanzando sólo un 4,2% y Claude 4.1 Opus un 5,6%.
Grok 4 de xAI obtuvo unos resultados especialmente preocupantes, con un 0,7% de precisión, debido principalmente a que identificó incorrectamente el 63% de los relojes válidos como relojes con horas imposibles, a pesar de que sólo el 20,6% presentaban configuraciones incorrectas.
Implicaciones fundamentales para el avance de la IA
Esta investigación amplía el paradigma de los puntos de referencia "humano-simple, IA-comple" ejemplificado por iniciativas como ARC-AGI y SimpleBench. Aunque la inteligencia artificial ha logrado un rendimiento sobrehumano en numerosas evaluaciones basadas en el conocimiento y exámenes profesionales, el razonamiento visual primitivo presenta retos persistentes.
El análisis de Safar sugiere que la metodología actual de escalar el tamaño del modelo y los datos de entrenamiento puede no abordar eficazmente estas limitaciones del procesamiento visual. Dos de los factores que se barajan como hipótesis son la insuficiente representación de relojes analógicos en los corpus de entrenamiento y las dificultades inherentes a la traducción de las relaciones espaciales entre los componentes gráficos de los relojes y las representaciones textuales.
ClockBench se une a un conjunto cada vez más amplio de herramientas de diagnóstico diseñadas para descubrir lagunas no evidentes en las capacidades de la IA. Para mantener la integridad de la evaluación, el conjunto de datos completo sigue restringido para evitar la contaminación del futuro entrenamiento de modelos, y sólo se dispone de subconjuntos de muestras controladas para la verificación.
Los resultados plantean cuestiones cruciales sobre si las mejoras graduales de las arquitecturas existentes pueden subsanar estas deficiencias de razonamiento o si se necesitan enfoques fundamentalmente novedosos, como los avances históricos que han permitido innovaciones como la computación en tiempo de prueba en otros ámbitos de la IA.
En un futuro previsible, el reloj mecánico analógico se erige como una referencia inesperadamente sólida de la inteligencia humana, una tecnología que podemos interpretar sin esfuerzo y que sigue desconcertando a nuestras creaciones computacionales más avanzadas.

































