


 家
二分木における最深葉の合計は何か? 2026年のガイドと解答。
二分木を習得することは、データサイエンティストやソフトウェア開発者にとって不可欠です。特に興味深い課題は、木の中で最も深い位置にある葉の合計を計算することです。このガイドでは、木操作の核心技術であるレベル順走査を用いてこの問題を解決する完全な手順を解説します。
重要なポイント
レベル順探索は、木構造を移動するための幅優先探索法である。
最深葉とは、二分木の最大深さに位置するノードを指します。
レベル順探索の実行には通常、キューデータ構造が用いられます。
レベル順探索におけるヌルマーカーの役割を理解することが極めて重要です。
この問題は、最も深いレベルからのみノード値を合計することに焦点を当てています。
最深葉の合計問題の理解
最深葉の和とは何か?
最深葉の和問題とは、与えられた二分木において、最も深い深さ(レベル)にある全てのノードの合計値を計算する問題である。
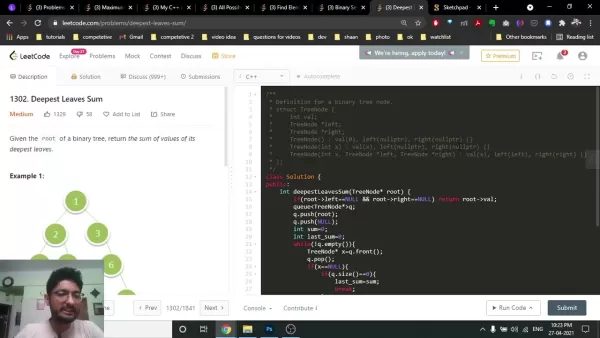
二分木のルートが与えられた場合、目的は木を走査し、最深レベルを特定し、そこに存在する全ノード値の合計を返すことです。
複数のレベルを持つ二分木を考えます。最も深いレベルには、ルートから最も遠いノードが配置されています。これらのノードの値を合計することで最終的な答えが得られます。この問題は技術面接でよく出題され、木探索アルゴリズムやキューデータ構造の習熟度を測るものです。二分木とその探索手法を確実に理解することは、データサイエンスやソフトウェア開発において極めて重要です。この特定の課題は、最適な結果を得るためのレベル順探索と効率的な木操作の価値を浮き彫りにします。二分木の基本
解決策に取り組む前に、二分木の基本概念を理解することが重要です。二分木は階層的なデータ構造であり、各ノードは最大2つの子ノード(左子ノードと右子ノード)を持つことができます。これらの概念に精通することで、より効果的な問題解決アプローチが可能になります。
- ノード: 二分木内の各要素はノードと呼ばれます。ノードはデータと子ノードへの参照を保持します。
- ルート: 木の最上位ノード。木にはルートが1つだけ存在します。
- 葉ノード: 子ノードを持たないノード。
- 深さ/レベル: ノードがルートから離れている距離。ルートはレベル0に位置します。
- 高さ: 木内の任意のノードが到達し得る最大深さ。これも重要な概念である。
これらの基礎を理解することは、二分木を扱うすべての人にとって、特にデータ操作、アルゴリズム開発、効率的な問題解決といった活動において極めて重要です。これらの概念をしっかり把握することで、最も深い葉の合計を求めるといった複雑な問題への取り組みが簡素化されます。
レベル順走査とその重要性
レベル順探索(幅優先探索:BFS)とは、根ノードから開始し、レベルごとに木を順に探索する手法です。これは最深葉の合計を求める問題の解決に不可欠です。
- 幅優先探索のアプローチ:中核となる概念は、次のレベルに進む前に同じレベルの全ノードを訪問することです。
- キューデータ構造:レベル順探索の実装にはキューが一般的に用いられ、ノードが適切な順序で処理されることを保証します。
- ヌルマーカー: ヌルマーカーはレベルの終了を示すことができ、レベル間の遷移を支援します。
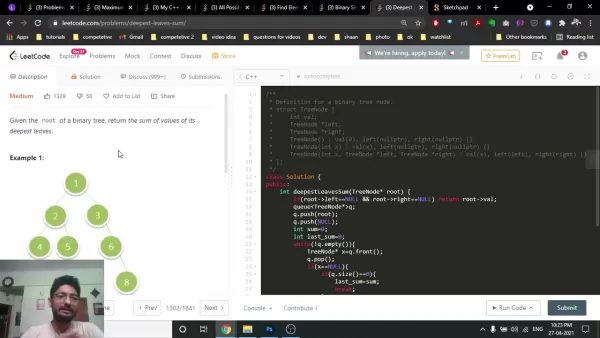
レベル順探索にはいくつかの利点がある:
- 効率性:木を階層ごとに体系的に探索します。
- 最深レベル検出: ツリーの最深レベルを容易に特定できる。
- キュー管理:キューを使用することで、各レベルにおけるノードの処理が簡素化される。
この探索アルゴリズムを学ぶことは、データ構造とアルゴリズムを学ぶ学生にとって非常に有益であり、木に関連する問題の解決プロセスを容易にします。
レベル順探索を用いた段階的解法
キューを用いたレベル順探索の実装
最深葉の和問題にレベル順探索を適用するには、以下の手順に従います:
- 初期化:キューを作成し、ルートノードを追加する。
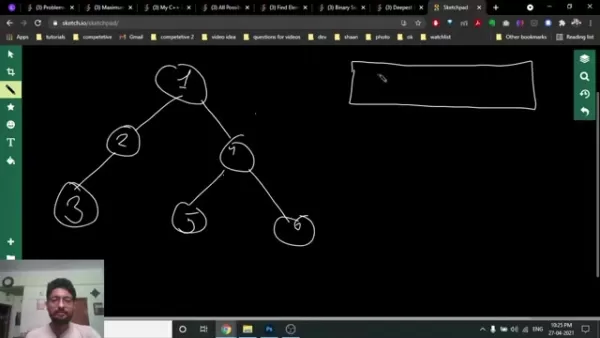
また、初期レベルの終了を示すヌルマーカーを追加する。
- 反復処理: キューが空になるまでループを継続する。
- 各ノードの処理: キューからノードを1つ取り出す。ノードがnullでない場合、その値を現在のレベルの合計に加算する。左子ノードと右子ノードをキューに追加する。
- ヌルマーカーの処理: 取り出したノードがヌルの場合、それはレベルの終端を示す。この段階で:
- キューにまだノードが残っている場合、次のレベル用に別のヌルマーカーを追加する。
- 現在の階層の合計を最終階層の合計に更新する。
- 現在のレベル合計をゼロにリセットする。
- 最終結果: ループ完了後、最終レベルの合計は最深部の葉の合計を表す。
この手法は効率的な探索と合計計算を可能にし、アルゴリズム効率や最適化されたコーディング手法を学ぶ者に特に有用である。
詳細な例
サンプル二分木でこの手法を実装してみましょう。
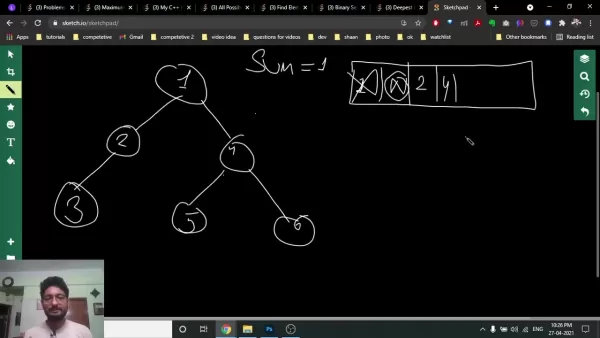
次の木を考えます:
1 / 2 4 / / 3 5 6
手順に従って処理します:
- ルートから開始: ルートノード (1) とヌルマーカーをキューに追加。
- 第一階層: ノード1を処理。ノード2と4を追加。ヌルマーカーを含める。
- 第2レベル: ノード2と4を処理。ノード3、5、6を追加。ヌルマーカーを含める。
- 第三階層: ヌルマーカーを処理した際、最終階層の合計を更新する。ノード3、5、6を処理する。
- 最終計算: 最終レベル処理後、最深葉の和は 3 + 5 + 6 = 14 となる。
この例は、二分木を学ぶ学生が容易に理解を進め、データ構造と探索アルゴリズムの両方に対する理解を深めるのに役立ちます。データ構造を学ぶ学習者にとって実践的な洞察を提供します。
C++コード実装
以下にアルゴリズムのC++コードを示す。
#include#includestruct TreeNode {int val;TreeNode *left;TreeNode *right;TreeNode(int x) : val(x), left(nullptr), right(nullptr) {}};int deepestLeavesSum(TreeNode* root) {if (!root) return 0;std::queue q;q.push(root);q.push(nullptr);int lastSum = 0, levelSum = 0;while (!q.empty()) {TreeNode* node = q.front();q.pop();if (node == nullptr) {if (!q.empty()) {q.push(nullptr);}lastSum = levelSum;levelSum = 0;} else {levelSum += node->val;if (node->left) q.push(node->left);if (node->right) q.push(node->right);}}return lastSum;}int main() {TreeNode* root = new TreeNode(1);root->left = new TreeNode(2);root->right = new TreeNode(4);root->left->left = new TreeNode(3);root->right->left = new TreeNode(5);root->right->right = new TreeNode(6);std::coutこのコードは、レベル順探索とキューデータ構造の実用的な応用例を示しています。C++プログラミングや アルゴリズム設計を学ぶ方にとって優れた参考資料となり、これらの技術が典型的な木構造関連の課題を解決する方法を示しています。
最深
葉和アルゴリズム
の使用異なる環境での実装最深葉和アルゴリズムは、以下のような様々な環境に適応できます:
- Webアプリケーション:クライアントサイドの木処理にJavaScriptを利用。
- バックエンドサービス:サーバーサイドのデータ処理にJavaやPythonで実装。
- 組込みシステム:リアルタイムデータ解析向けにCまたはC++でコーディング。
この柔軟性により、開発者は複数プラットフォームに展開でき、パフォーマンスとメモリ管理を向上させられます。この能力は
、 クロスプラットフォーム開発や効率的なアルゴリズム実装に携わるプロフェッショナルにとって有益です。本アルゴリズムは多様なソフトウェアアーキテクチャに適用可能です
。
実装
コストの
理解リソース要件と
最適化最深葉和アルゴリズムを適用するには
、 時間と空間の両方の複雑性を考慮する必要があります。 主なポイントは次の通り:
- 時間複雑度:各ノードを1回ずつ訪問するため、アルゴリズムはO(N)時間で動作(Nはノード数)
- 。空間複雑度:最も広いレベルの全ノードをキューが収容する必要があるため、空間複雑度はO(W)(Wは木の最大幅)
。アルゴリズムの最適化は、アプリケーション固有の制約と要件に依存する。 反復深化法などの手法は、特に深い木においてメモリ消費を低減できる。この知見は、アルゴリズム解析と性能最適化を学ぶ者にとって不可欠であり、最高の効率を実現するソリューションをカスタマイズすることを可能にする。
最深葉和のためのレベル順探索の
評価長所
:
体系的なレベルごとの探索により、アルゴリズムが最深レベルを効率的に特定することが保証される。
キューデータ構造は各レベルでのノード管理を効率化し、記述・理解しやすいコードを実現します。
ヌルマーカーはレベル遷移の処理とレベル完了の追跡に明確かつ効率的な手法を提供します
。欠点:空間複雑度O(W)(Wは木の最大幅)は、非常に幅広な木では制約となる可能性があります。
アルゴリズムは、すべてのレベルのノードをキューに格納する必要があるため、極端に深い木に対しては最もメモリ効率が良いとは限らない
。特に歪んだ木や不均衡な木では、ノードが正しい順序で処理されるよう、慎重なキュー管理が求められる。
レベル
順探索の
主な
特徴必須の構成要素と
利点レベル順探索は、木処理の有用性を高めるいくつかの主な特徴を提供する:
- 体系的な探索:各レベルで全てのノードが訪問されることを保証する。
- キューの活用:ノード処理を管理するためのキューの効率的な使用。
- レベル区切り:レベルを明確に分離するためのヌルマーカーの使用。
- 簡潔さ:実装が容易で直感的な探索ロジック。
これらの特性は多様なアプリケーションにおいて不可欠です。体系的なデータ処理やキューデータ構造の専門家にとって、これらの要素は特に有益です。
最深葉和アルゴリズムの
多様な
活用
事例様々な業界における実世界での応用最深葉和アルゴリズムは多くの実世界状況で適用可能です
- :ネットワークルーティング:ネットワークレイアウトにおける最遠ノードの
- 特定データベースインデックス:クエリ性能向上のための木構造インデックスの
- 検証ファイルシステム探索:ディレクトリ階層における最深ファイルの
- 検索人工知能:最終決定結果を評価する決定木アルゴリズムへの応用
このアルゴリズムの適応性と幅広い有用性は、ネットワーク最適化、データベース管理、AI駆動ソリューションに携わる専門家を支援する実用的な価値を強調しています。二分木は多くの重要な操作の中核をなします。
よくある質問最深葉和アルゴリズムの時間計算量は?
時間計算量は O(N) です(N は二分木のノード数)。アルゴリズムは各ノードを正確に一度だけ訪問するためです。
最深葉の合計アルゴリズムの空間複雑度は?
空間複雑度はO(W)です。ここでWは木の最大幅であり、キューが保持する必要があるノードは最大でも最広レベルのものだけだからです。
レベル順探索はこの問題解決にどう役立つ?
レベル順探索は、より深いレベルへ進む前に同一レベルの全ノードを確実に処理するため、最深レベルの特定と当該ノードの合計計算を簡素化します。
ヌルマーカーはこのアルゴリズムに必要ですか?
はい。ヌルマーカーはレベルを区別し、レベル遷移を容易にし、レベルが完全に処理されたことを示すのに役立ちます。この手法はアルゴリズムの明瞭性を高めます。
このアルゴリズムは非常に深い木に対して最適化できますか?
はい。反復深化(iterative deepening)は、非常に深い木におけるメモリ使用量を削減できます。 反復深化は、深さ優先探索の空間効率と幅優先探索の網羅性を融合させます。
関連質問特定のレベルにおけるノードの合計を求めるには、このアルゴリズムをどう修正すればよいですか?
特定のレベルにおけるノードの合計を計算するには、レベル順探索アルゴリズムを調整します。現在のレベルを監視するカウンタを導入します。カウンタが目標レベルに達した時点で、ノード値を合計します。 以下に段階的なアプローチを示します:初期化:キューを作成し、レベルカウンタを0に初期化したルートノードを追加します。また、各レベルの終わりを示すレベル区切り記号(例:ヌルマーカー)を追加します。反復処理:キューが空になるまでループします。各ノードの処理:キューからノードとそのレベルを取り出します。 現在のレベルが目標レベルと一致する場合、ノードの値を合計に加算する。レベルカウンタを増加させた状態で、その左子ノードと右子ノードを追加する。レベル区切り記号の処理:取り出したノードがレベル区切り記号(ヌルマーカー)の場合:レベルカウンタを増加させる。キューが空でない場合、次のレベル用の別のレベル区切り記号を追加する。レベルカウンタが目標レベルと等しいか検証する。 一致した場合、このレベルでの値の合計を開始する。最適化: 不要なノードをスキップするため、ターゲットレベルを完全に処理後にループを終了する条件を追加できる。この手法は任意の指定レベルに対する合計を効率的に計算する。本アプローチの適切な実行は効果的なデータ管理を促進し、特定のクエリへの迅速な応答を可能にする。これらの対策により、データ操作と検索操作の効率性が確保される。
関連記事
 Slackbot が AI エージェントになる
Salesforceの企業向けメッセージングプラットフォームSlackに組み込まれた自動化アシスタント「Slackbot」は、AIエージェントへと進化しつつある。SalesforceのCTOであるパーカー・ハリス氏は、OpenAIのChatGPTに匹敵するバイラルな普及を達成する可能性を構想している。クラウドソフトウェア大手は火曜日、アップデートされたSlackbotをリリースした。Business+およびEnterprise+の顧客が利用可能なこの新しいAI駆動版は、Slack内で直接情報の
ByteDance、コアAIインセンティブを強化、Doubaoが14.6%急伸
ByteDanceは最近、DouBaoの株式に関する説明会を開催し、DouBao部門に関わる従業員向けの新たなインセンティブ政策を発表した。DouBao株式の行使価格は2026年6月の14.85ドルから17.02ドルに引き上げられ、約14.6%の増加となった。この改定により、DouBao株式の評価額が上昇するだけでなく、その配布範囲も大幅に拡大した。個人の役割に応じて、一部の従業員は総報酬の約5%に相当するDouBao株式を受け取ることができる。新しい交換メカニズムの下、ByteDanceは従
MiniMax、グローバルのAI専門家に対するインセンティブを提供する「10xチームプログラム」を発表
MiniMax(稀宇科技)の汎用人工知能ラボは、グローバルな人材連携イニシアチブ「10xチーム」を正式に開始しました。このプログラムは、大規模モデルの専門分野における深い応用を探求するために、各業界のトップエキスパートを募集することを目的としています。深い業界知識と最先端のAIを統合することで、MiniMaxは汎用から専門的なシナリオへと大規模モデルの生産性を拡大し、最終的に業界の効率に「10倍の増加」をもたらすことを目指しています。業界の認知価値を検証し、マルチモーダルの中核リソースを開放す
関連特集おすすめ
教育と学習
 宿題や試験対策に役立つAI学習ツール
2026年版 宿題や試験対策に最適な最新AI学習ツール!XIX.AIは、学生の生産性を高め、宿題の完了を効率化し、実際の試験で好成績を収めるのに役立つ、画期的な高評価ツールを厳選して紹介しています。 無料版と有料版の比較、詳細なランキング、そしてAIの力を最大限に引き出すためにぜひ試すべきツールをご紹介します。今すぐチェックしましょう!
 10 ツール
 xix.ai
作曲
ソングライター向けAIボーカルデモツール:フック、トップライン、多言語のドラフトセッション
2026年版 ソングライター、フッククリエイター、多言語コンテンツ制作チームのための最新・最高のAIボーカルデモツール!XIX.AIは、厳格な実地テストを経て、業界に革新をもたらす強力なツールを厳選し、高評価のランキングリストを作成しました。 無料版と有料版の詳細な比較データ、包括的なランキング、そして創作効率を高め、創造力を最大限に引き出すためにぜひ試すべきツールが満載です。今すぐチェックして、あらゆるコンテンツ制作ニーズに最適なツールを見つけましょう!
9 ツール
xix.ai
仕事
中小企業に最適なAI競合分析ツール
2026年版 中小企業向け最新・最高評価のAI競合分析ツール!XIX.AIは、実環境での厳格なテストと詳細なランキングに基づき、毎週更新される、極めて強力で業界に革命をもたらすツールを厳選しました。無料版と有料版の包括的な比較も掲載されており、生産性を向上させ、競争優位性をもたらす「ぜひ試すべき」ツールを見つけるのに役立ちます。 今すぐチェックして、あなたにぴったりのツールを見つけましょう!
9 ツール
xix.ai
画像編集
EC用アパレル向けPhotoshop AIレタッチツール、肌のクレンジング、色の統一
2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai
プロンプト
ChatGPTワークフローに最適なAIプロンプトライブラリ
2026年版:あらゆる種類のChatGPTワークフローを最適化するための、最新かつ最高評価のAIプロンプトライブラリ。XIX.AIは、最高のパフォーマンスを保証するために厳格な実環境テストを経た、強力で画期的なコレクションを厳選しました。 無料版と有料版の詳細な比較や専門家によるランキングを参考に、生産性を高め、AIの真の力を引き出す「必試」ツールを選んでください。今すぐチェックしましょう!
11 ツール
xix.ai
教育と学習
教師、チューター、およびコホート型学習プログラム向けのAIクイズビルダープラットフォーム
2026年最新版 教師、チューター、コホート型学習プログラム向けベストAIクイズビルダープラットフォーム!XIX.AIは、実世界のテストを経て正確なランキングを提供する革新的なツールの中から、高評価のリストを厳選しました。これらの必須プラットフォームは、すべての学習シナリオにおいて、作成効率の向上、コンテンツ制作の効率化、クイズ設計の簡素化を支援します。今すぐ探索して、教育におけるAIの優位性を引き出すための完璧なツールを見つけましょう!
13 ツール
xix.ai

 コメント (1)
0/500
![HarryRoberts]()
Interesting approach! I've always struggled with level order traversal in interviews. The guide's step-by-step breakdown is super helpful, especially the part about handling edge cases. Might try implementing this in Python tonight. Anyone else find tree problems oddly satisfying? 🌳
二分木を習得することは、データサイエンティストやソフトウェア開発者にとって不可欠です。特に興味深い課題は、木の中で最も深い位置にある葉の合計を計算することです。このガイドでは、木操作の核心技術であるレベル順走査を用いてこの問題を解決する完全な手順を解説します。
重要なポイント
レベル順探索は、木構造を移動するための幅優先探索法である。
最深葉とは、二分木の最大深さに位置するノードを指します。
レベル順探索の実行には通常、キューデータ構造が用いられます。
レベル順探索におけるヌルマーカーの役割を理解することが極めて重要です。
この問題は、最も深いレベルからのみノード値を合計することに焦点を当てています。
最深葉の合計問題の理解
最深葉の和とは何か?
最深葉の和問題とは、与えられた二分木において、最も深い深さ(レベル)にある全てのノードの合計値を計算する問題である。
二分木のルートが与えられた場合、目的は木を走査し、最深レベルを特定し、そこに存在する全ノード値の合計を返すことです。
複数のレベルを持つ二分木を考えます。最も深いレベルには、ルートから最も遠いノードが配置されています。これらのノードの値を合計することで最終的な答えが得られます。この問題は技術面接でよく出題され、木探索アルゴリズムやキューデータ構造の習熟度を測るものです。二分木とその探索手法を確実に理解することは、データサイエンスやソフトウェア開発において極めて重要です。この特定の課題は、最適な結果を得るためのレベル順探索と効率的な木操作の価値を浮き彫りにします。二分木の基本
解決策に取り組む前に、二分木の基本概念を理解することが重要です。二分木は階層的なデータ構造であり、各ノードは最大2つの子ノード(左子ノードと右子ノード)を持つことができます。これらの概念に精通することで、より効果的な問題解決アプローチが可能になります。
- ノード: 二分木内の各要素はノードと呼ばれます。ノードはデータと子ノードへの参照を保持します。
- ルート: 木の最上位ノード。木にはルートが1つだけ存在します。
- 葉ノード: 子ノードを持たないノード。
- 深さ/レベル: ノードがルートから離れている距離。ルートはレベル0に位置します。
- 高さ: 木内の任意のノードが到達し得る最大深さ。これも重要な概念である。
これらの基礎を理解することは、二分木を扱うすべての人にとって、特にデータ操作、アルゴリズム開発、効率的な問題解決といった活動において極めて重要です。これらの概念をしっかり把握することで、最も深い葉の合計を求めるといった複雑な問題への取り組みが簡素化されます。
レベル順走査とその重要性
レベル順探索(幅優先探索:BFS)とは、根ノードから開始し、レベルごとに木を順に探索する手法です。これは最深葉の合計を求める問題の解決に不可欠です。
- 幅優先探索のアプローチ:中核となる概念は、次のレベルに進む前に同じレベルの全ノードを訪問することです。
- キューデータ構造:レベル順探索の実装にはキューが一般的に用いられ、ノードが適切な順序で処理されることを保証します。
- ヌルマーカー: ヌルマーカーはレベルの終了を示すことができ、レベル間の遷移を支援します。
レベル順探索にはいくつかの利点がある:
- 効率性:木を階層ごとに体系的に探索します。
- 最深レベル検出: ツリーの最深レベルを容易に特定できる。
- キュー管理:キューを使用することで、各レベルにおけるノードの処理が簡素化される。
この探索アルゴリズムを学ぶことは、データ構造とアルゴリズムを学ぶ学生にとって非常に有益であり、木に関連する問題の解決プロセスを容易にします。
レベル順探索を用いた段階的解法
キューを用いたレベル順探索の実装
最深葉の和問題にレベル順探索を適用するには、以下の手順に従います:
- 初期化:キューを作成し、ルートノードを追加する。
また、初期レベルの終了を示すヌルマーカーを追加する。
- 反復処理: キューが空になるまでループを継続する。
- 各ノードの処理: キューからノードを1つ取り出す。ノードがnullでない場合、その値を現在のレベルの合計に加算する。左子ノードと右子ノードをキューに追加する。
- ヌルマーカーの処理: 取り出したノードがヌルの場合、それはレベルの終端を示す。この段階で:
- キューにまだノードが残っている場合、次のレベル用に別のヌルマーカーを追加する。
- 現在の階層の合計を最終階層の合計に更新する。
- 現在のレベル合計をゼロにリセットする。
- 最終結果: ループ完了後、最終レベルの合計は最深部の葉の合計を表す。
この手法は効率的な探索と合計計算を可能にし、アルゴリズム効率や最適化されたコーディング手法を学ぶ者に特に有用である。
詳細な例
サンプル二分木でこの手法を実装してみましょう。
次の木を考えます:
1 / 2 4 / / 3 5 6
手順に従って処理します:
- ルートから開始: ルートノード (1) とヌルマーカーをキューに追加。
- 第一階層: ノード1を処理。ノード2と4を追加。ヌルマーカーを含める。
- 第2レベル: ノード2と4を処理。ノード3、5、6を追加。ヌルマーカーを含める。
- 第三階層: ヌルマーカーを処理した際、最終階層の合計を更新する。ノード3、5、6を処理する。
- 最終計算: 最終レベル処理後、最深葉の和は 3 + 5 + 6 = 14 となる。
この例は、二分木を学ぶ学生が容易に理解を進め、データ構造と探索アルゴリズムの両方に対する理解を深めるのに役立ちます。データ構造を学ぶ学習者にとって実践的な洞察を提供します。
C++コード実装
以下にアルゴリズムのC++コードを示す。
coutこのコードは、レベル順探索とキューデータ構造の実用的な応用例を示しています。C++プログラミングや アルゴリズム設計を学ぶ方にとって優れた参考資料となり、これらの技術が典型的な木構造関連の課題を解決する方法を示しています。 の使用異なる環境での実装最深葉和アルゴリズムは、以下のような様々な環境に適応できます: この柔軟性により、開発者は複数プラットフォームに展開でき、パフォーマンスとメモリ管理を向上させられます。この能力は クロスプラットフォーム開発や効率的なアルゴリズム実装に携わるプロフェッショナルにとって有益です。本アルゴリズムは多様なソフトウェアアーキテクチャに適用可能です 。 最適化最深葉和アルゴリズムを適用するには 時間と空間の両方の複雑性を考慮する必要があります。 主なポイントは次の通り: 。アルゴリズムの最適化は、アプリケーション固有の制約と要件に依存する。 反復深化法などの手法は、特に深い木においてメモリ消費を低減できる。この知見は、アルゴリズム解析と性能最適化を学ぶ者にとって不可欠であり、最高の効率を実現するソリューションをカスタマイズすることを可能にする。 体系的なレベルごとの探索により、アルゴリズムが最深レベルを効率的に特定することが保証される。 キューデータ構造は各レベルでのノード管理を効率化し、記述・理解しやすいコードを実現します。 ヌルマーカーはレベル遷移の処理とレベル完了の追跡に明確かつ効率的な手法を提供します 。欠点:空間複雑度O(W)(Wは木の最大幅)は、非常に幅広な木では制約となる可能性があります。 アルゴリズムは、すべてのレベルのノードをキューに格納する必要があるため、極端に深い木に対しては最もメモリ効率が良いとは限らない 。特に歪んだ木や不均衡な木では、ノードが正しい順序で処理されるよう、慎重なキュー管理が求められる。 利点レベル順探索は、木処理の有用性を高めるいくつかの主な特徴を提供する: これらの特性は多様なアプリケーションにおいて不可欠です。体系的なデータ処理やキューデータ構造の専門家にとって、これらの要素は特に有益です。 事例様々な業界における実世界での応用最深葉和アルゴリズムは多くの実世界状況で適用可能です このアルゴリズムの適応性と幅広い有用性は、ネットワーク最適化、データベース管理、AI駆動ソリューションに携わる専門家を支援する実用的な価値を強調しています。二分木は多くの重要な操作の中核をなします。 時間計算量は O(N) です(N は二分木のノード数)。アルゴリズムは各ノードを正確に一度だけ訪問するためです。 空間複雑度はO(W)です。ここでWは木の最大幅であり、キューが保持する必要があるノードは最大でも最広レベルのものだけだからです。 レベル順探索は、より深いレベルへ進む前に同一レベルの全ノードを確実に処理するため、最深レベルの特定と当該ノードの合計計算を簡素化します。 はい。ヌルマーカーはレベルを区別し、レベル遷移を容易にし、レベルが完全に処理されたことを示すのに役立ちます。この手法はアルゴリズムの明瞭性を高めます。 はい。反復深化(iterative deepening)は、非常に深い木におけるメモリ使用量を削減できます。 反復深化は、深さ優先探索の空間効率と幅優先探索の網羅性を融合させます。 特定のレベルにおけるノードの合計を計算するには、レベル順探索アルゴリズムを調整します。現在のレベルを監視するカウンタを導入します。カウンタが目標レベルに達した時点で、ノード値を合計します。 以下に段階的なアプローチを示します:初期化:キューを作成し、レベルカウンタを0に初期化したルートノードを追加します。また、各レベルの終わりを示すレベル区切り記号(例:ヌルマーカー)を追加します。反復処理:キューが空になるまでループします。各ノードの処理:キューからノードとそのレベルを取り出します。 現在のレベルが目標レベルと一致する場合、ノードの値を合計に加算する。レベルカウンタを増加させた状態で、その左子ノードと右子ノードを追加する。レベル区切り記号の処理:取り出したノードがレベル区切り記号(ヌルマーカー)の場合:レベルカウンタを増加させる。キューが空でない場合、次のレベル用の別のレベル区切り記号を追加する。レベルカウンタが目標レベルと等しいか検証する。 一致した場合、このレベルでの値の合計を開始する。最適化: 不要なノードをスキップするため、ターゲットレベルを完全に処理後にループを終了する条件を追加できる。この手法は任意の指定レベルに対する合計を効率的に計算する。本アプローチの適切な実行は効果的なデータ管理を促進し、特定のクエリへの迅速な応答を可能にする。これらの対策により、データ操作と検索操作の効率性が確保される。#include最深
葉和アルゴリズム
実装
コストの
理解リソース要件と
最深葉和のためのレベル順探索の
評価長所
:
レベル
順探索の
主な
特徴必須の構成要素と
最深葉和アルゴリズムの
多様な
活用
よくある質問最深葉和アルゴリズムの時間計算量は?
最深葉の合計アルゴリズムの空間複雑度は?
レベル順探索はこの問題解決にどう役立つ?
ヌルマーカーはこのアルゴリズムに必要ですか?
このアルゴリズムは非常に深い木に対して最適化できますか?
関連質問特定のレベルにおけるノードの合計を求めるには、このアルゴリズムをどう修正すればよいですか?








 Slackbot が AI エージェントになる
Salesforceの企業向けメッセージングプラットフォームSlackに組み込まれた自動化アシスタント「Slackbot」は、AIエージェントへと進化しつつある。SalesforceのCTOであるパーカー・ハリス氏は、OpenAIのChatGPTに匹敵するバイラルな普及を達成する可能性を構想している。クラウドソフトウェア大手は火曜日、アップデートされたSlackbotをリリースした。Business+およびEnterprise+の顧客が利用可能なこの新しいAI駆動版は、Slack内で直接情報の
 ByteDance、コアAIインセンティブを強化、Doubaoが14.6%急伸
ByteDanceは最近、DouBaoの株式に関する説明会を開催し、DouBao部門に関わる従業員向けの新たなインセンティブ政策を発表した。DouBao株式の行使価格は2026年6月の14.85ドルから17.02ドルに引き上げられ、約14.6%の増加となった。この改定により、DouBao株式の評価額が上昇するだけでなく、その配布範囲も大幅に拡大した。個人の役割に応じて、一部の従業員は総報酬の約5%に相当するDouBao株式を受け取ることができる。新しい交換メカニズムの下、ByteDanceは従
 MiniMax、グローバルのAI専門家に対するインセンティブを提供する「10xチームプログラム」を発表
MiniMax(稀宇科技)の汎用人工知能ラボは、グローバルな人材連携イニシアチブ「10xチーム」を正式に開始しました。このプログラムは、大規模モデルの専門分野における深い応用を探求するために、各業界のトップエキスパートを募集することを目的としています。深い業界知識と最先端のAIを統合することで、MiniMaxは汎用から専門的なシナリオへと大規模モデルの生産性を拡大し、最終的に業界の効率に「10倍の増加」をもたらすことを目指しています。業界の認知価値を検証し、マルチモーダルの中核リソースを開放す

2026年版 宿題や試験対策に最適な最新AI学習ツール!XIX.AIは、学生の生産性を高め、宿題の完了を効率化し、実際の試験で好成績を収めるのに役立つ、画期的な高評価ツールを厳選して紹介しています。 無料版と有料版の比較、詳細なランキング、そしてAIの力を最大限に引き出すためにぜひ試すべきツールをご紹介します。今すぐチェックしましょう!
10 ツール
xix.ai

2026年版 ソングライター、フッククリエイター、多言語コンテンツ制作チームのための最新・最高のAIボーカルデモツール!XIX.AIは、厳格な実地テストを経て、業界に革新をもたらす強力なツールを厳選し、高評価のランキングリストを作成しました。 無料版と有料版の詳細な比較データ、包括的なランキング、そして創作効率を高め、創造力を最大限に引き出すためにぜひ試すべきツールが満載です。今すぐチェックして、あらゆるコンテンツ制作ニーズに最適なツールを見つけましょう!
9 ツール
xix.ai

2026年版 中小企業向け最新・最高評価のAI競合分析ツール!XIX.AIは、実環境での厳格なテストと詳細なランキングに基づき、毎週更新される、極めて強力で業界に革命をもたらすツールを厳選しました。無料版と有料版の包括的な比較も掲載されており、生産性を向上させ、競争優位性をもたらす「ぜひ試すべき」ツールを見つけるのに役立ちます。 今すぐチェックして、あなたにぴったりのツールを見つけましょう!
9 ツール
xix.ai

2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai

2026年版:あらゆる種類のChatGPTワークフローを最適化するための、最新かつ最高評価のAIプロンプトライブラリ。XIX.AIは、最高のパフォーマンスを保証するために厳格な実環境テストを経た、強力で画期的なコレクションを厳選しました。 無料版と有料版の詳細な比較や専門家によるランキングを参考に、生産性を高め、AIの真の力を引き出す「必試」ツールを選んでください。今すぐチェックしましょう!
11 ツール
xix.ai

2026年最新版 教師、チューター、コホート型学習プログラム向けベストAIクイズビルダープラットフォーム!XIX.AIは、実世界のテストを経て正確なランキングを提供する革新的なツールの中から、高評価のリストを厳選しました。これらの必須プラットフォームは、すべての学習シナリオにおいて、作成効率の向上、コンテンツ制作の効率化、クイズ設計の簡素化を支援します。今すぐ探索して、教育におけるAIの優位性を引き出すための完璧なツールを見つけましょう!
13 ツール
xix.ai

Interesting approach! I've always struggled with level order traversal in interviews. The guide's step-by-step breakdown is super helpful, especially the part about handling edge cases. Might try implementing this in Python tonight. Anyone else find tree problems oddly satisfying? 🌳












