


 Maison
LLaMA-Factory Online


Helps TikTok sellers, brands, MCNs, and TAPs discover winning products and find creators.
HelpLook is an AI-powered all-in-one knowledge base tool that helps businesses quickly build knowledge bases, help centers, and...
Your AI Workspace
302.AI is an enterprise-grade AI resource platform with pay-as-you-go pricing, API access to a full range of AI models, and ready-to-use online applications.

剧火AI — AI Screenwriter + Director, a One-Person Short Drama Studio In one sentence, what is it?

Vous êtes-vous déjà demandé ce qu'est le buzz sur les Gémeaux? Laissez-moi le décomposer pour vous. Gemini est ce chat de chat générateur générateur cool, fabriqué par le cerveau de Google Deepmind. C'est comme avoir un ami super intelligent qui a été autour du bloc Internet, vous tremper
Qu'est-ce qu'Unshackled AI ? Unshackled Chat est un chatbot basé sur l'IA qui permet des conversations libres et non censurées. Il offre une plateforme d'interaction illimitée avec
Qu'est-ce qu'Sora 2 ? Sora 2 C'est le modèle d'IA phare d'OpenAI pour la génération de vidéos et d'audio, qui marque une étape importante dans la création vidéo, comparab
Vous êtes-vous déjà demandé comment optimiser votre support client et donner l'impression d'avoir une équipe d'agents super-efficaces travaillant 24h/24? Découvrez Mοveo AI, le révolutionnaire en matière d'automatisation du service client. Ce n'est p
Qu'est-ce que DigiMirror? DigiMirror est un outil d'essayage virtuel piloté par l'IA qui permet aux utilisateurs de voir instantanément comment les vêtements leur vont. Téléchargez votre photo et un v
LLaMA-Factory Online Informations sur les produits
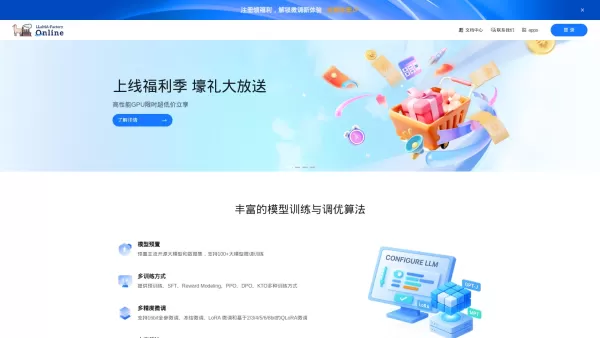
Qu'est-ce qu'LLaMA-Factory Online?
LLaMA-Factory Online Il s'agit de la plateforme cloud officielle dédiée à la formation et au réglage fin des modèles de langage (LLM), créée en collaboration avec le célèbre projet open source LLaMA-Factory. Elle offre une solution prête à l'emploi, low-code et de bout en bout aux utilisateurs qui souhaitent simplifier le réglage fin ou qui disposent de capacités d'ingénierie limitées.
Comment utiliser LLaMA-Factory Online?
Commencez le réglage fin en trois étapes simples : 1. Préparer les données et les modèles : téléchargez facilement vos ensembles de données via SFTP ou d'autres méthodes prises en charge. 2. Configurer et lancer : choisissez votre modèle de base et ajustez les paramètres clés dans notre interface visuelle. Optez pour le mode rapide pour une configuration rapide ou le mode expert pour des options avancées. Sélectionnez une formule tarifaire adaptée à votre budget et à votre calendrier, puis lancez la tâche en un clic. 3. Surveillez et évaluez : utilisez des outils intégrés tels que LlamaBoard et TensorBoard pour suivre en temps réel la perte d'apprentissage et l'utilisation des ressources. Après l'apprentissage, évaluez les résultats avec l'évaluation de modèle ou testez immédiatement les performances à l'aide de Model Chat.
LLaMA-Factory OnlinePrincipales fonctionnalités
Vaste bibliothèque de modèles (plus de 100 modèles) : accédez à plus de 100 modèles open source de premier plan, notamment LLaMA, Qwen, DeepSeek, GPT-OSS et bien d'autres.
Méthodes d'entraînement complètes : Prise en charge de l'ensemble du processus d'entraînement, du pré-entraînement et du SFT (Supervised Fine-Tuning) à la modélisation des récompenses et aux méthodes d'alignement telles que PPO, DPO et KTO.
Précision et quantification flexibles : personnalisez l'utilisation des ressources grâce à un réglage fin complet en 16 bits, au freeze-tuning, à LoRA et à QLoRA, qui prennent en charge la quantification en 2/3/4/5/6/8 bits.
Algorithmes d'optimisation de pointe : Bénéficiez d'optimisations avancées intégrées telles que GaLore, BAdam, LoRA+, PiSSA, DoRA et rsLoRA.
Suivi robuste des expériences : surveillez la progression de l'entraînement en temps réel grâce à la prise en charge intégrée de LlamaBoard, TensorBoard, WandB, MLflow et SwanLab.
Accélération hautement efficace : boostez les performances grâce à l'accélération FlashAttention-2 et Unsloth, compatible avec les moteurs d'inférence Transformers et vLLM.
LLaMA-Factory OnlineCas d'utilisation
Correcteur automatique de dissertations en chinois : utilise Qwen3-vl-30B-A3B-Instruct pour fournir une notation et des commentaires intelligents.
Assistant de gestion des tickets spécialisé en IA : un agent de service client personnalisé construit avec Qwen2.5-14B-Instruct.
Réglage fin à faible coût pour les modèles MoE massifs : règle finement DeepSeek-V3 de manière efficace à l'aide de l'optimisation KTransformers.
Analyse d'imagerie médicale : application de diagnostic médical optimisée avec Qwen3-vl-30B-A3B-Instruct.
Modèle léger pour la maison intelligente : déploie Qwen3-4B pour un contrôle efficace de la domotique en périphérie.
Agent IA juridique : un assistant juridique spécialisé développé avec LightLLM et LlamaIndex.
FAQ de LLaMA-Factory Online
Comment puis-je améliorer les performances du modèle si les résultats du réglage fin ne sont pas satisfaisants ?
1. Élargir l'ensemble de données : utilisez un ensemble de données d'entraînement plus volumineux. 2. Augmenter la durée de l'entraînement : augmentez le nombre d'époques (par exemple, num_train_epochs : 5,0) ou le nombre total d'étapes (par exemple, max_steps : 1 000). 3. Ajustez le taux d'apprentissage : essayez un taux d'apprentissage plus élevé (par exemple, 2,0e-4). 4. Changez de méthode de réglage fin : testez différentes approches telles que « freeze » (gel des paramètres) ou « full » (réglage complet des paramètres) via le paramètre finetuning_type.
Comment résoudre les erreurs « CUDA Out of Memory » (OOM) pendant l'entraînement ?
Si vous rencontrez des problèmes de mémoire GPU, essayez ces optimisations : 1. Réduire la taille des lots : définissez per_device_train_batch_size sur 1. 2. Optimiser les opérateurs : activez les noyaux économes en mémoire en définissant enable_liger_kernel et use_unsloth_gc sur true. 3. Raccourcissez la longueur de séquence : diminuez la valeur de cutoff_len (par exemple, à 512). 4. Utilisez le parallélisme avancé : activez DeepSpeed ZeRO-3 ou FSDP pour répartir les poids du modèle entre les périphériques, ou utilisez le déchargement CPU. 5. Appliquez la quantification : définissez quantization_bit sur 4 pour compresser les paramètres (disponible uniquement pour l'affinage LoRA).
Comment corriger des sorties de modèle absurdes ou répétitives ?
La solution dépend du moment où le problème apparaît : S'il survient AVANT l'entraînement : cela est souvent dû à l'utilisation d'un modèle de base brut (non aligné) ou d'un modèle de prompt incorrect. Assurez-vous d'utiliser un modèle Instruct/Chat aligné et le bon modèle de prompt. S'il survient APRÈS l'entraînement : Vérifiez la cohérence du modèle de prompt : assurez-vous que le modèle de prompt d'inférence correspond à celui utilisé pendant l'entraînement. Surveillez le surapprentissage : si le modèle est en surapprentissage, réduisez le nombre d'époques d'entraînement (num_train_epochs) et diminuez le taux d'apprentissage.
LLaMA-Factory Online E-mail d'assistance, contact du service client, contact pour les remboursements, etc.
Contactez le service client d'LLaMA-Factory Online à l'adresse : [email protected]. Pour d'autres moyens de nous contacter, rendez-vous sur la page « Contactez-nous » (mailto:[email protected])
LLaMA-Factory Online Entreprise
LLaMA-Factory Online Nom de l'entreprise : DataCanvas.
LLaMA-Factory Online Adresse de l'entreprise : .
Pour en savoir plus sur LLaMA-Factory Online, consultez la page « À propos de nous » ().
LLaMA-Factory Online Connexion
LLaMA-Factory Online Lien de connexion : https://www.llamafactory.com.cn/login
LLaMA-Factory Online S'inscrire
LLaMA-Factory Online Lien d'inscription : https://www.llamafactory.com.cn/login
Capture d'écran LLaMA-Factory Online



2026 Dernières Meilleures Plateformes de Création de Quiz par IA pour les Enseignants, Tuteurs et Programmes d’Apprentissage en Cohorte ! XIX.AI a sélectionné une liste hautement notée d’outils puissants et transformateurs, testés dans des situations réelles pour garantir des classements précis. Ces plateformes incontournables permettent d’améliorer l’efficacité rédactionnelle, de simplifier la création de contenu et de faciliter la conception de quiz dans tous les contextes d’apprentissage. Explorez dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer parti de l’avantage offert par l’IA dans votre enseignement !
 13 outils
 xix.ai

Les meilleurs outils 2026 d’analyse des pull requests par IA pour les équipes GitHub sont disponibles sur XIX.AI ! Cette sélection triée sur le volet présente des solutions puissantes et révolutionnaires qui optimisent la refactorisation, la correction des bugs et la détection des failles de sécurité dans tous les workflows d’équipe. Profitez d'une comparaison entre les versions gratuites et payantes, ainsi que de tests en conditions réelles et de classements détaillés pour vous aider à trouver l'outil idéal qui boostera considérablement votre productivité. Découvrez-les dès maintenant pour exploiter pleinement le potentiel de l'IA !
12 outils
xix.ai

Les meilleurs outils d'IA de synthèse vocale de 2026, les mieux notés pour des voix off naturelles, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des solutions puissantes et révolutionnaires qui offrent des voix d'une clarté cristalline pour tous les cas d'utilisation, étayées par des tests en conditions réelles et des classements mis à jour chaque semaine. Consultez notre comparatif entre les versions gratuites et payantes pour trouver la solution incontournable qui boostera instantanément votre productivité. Découvrez-la dès maintenant pour exploiter pleinement le potentiel de l’IA !
11 outils
xix.ai

Classement 2026 des meilleurs générateurs d'arrière-plans de mangas par IA : les mieux notés ! Cette sélection présente des outils puissants et révolutionnaires, parfaits pour créer des arrière-plans de chapitres, des couvertures de livres et des illustrations promotionnelles de haute qualité. Chaque option a été soumise à des tests rigoureux en conditions réelles afin de garantir sa fiabilité. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des informations détaillées. Explorez dès maintenant cette sélection pour trouver l'outil qui vous convient le mieux et tirez pleinement parti de l'IA dans la création de mangas.
6 outils
xix.ai

Les meilleurs éditeurs d'IA pour la suppression d'objets en 2026, les mieux notés pour les portraits, les photos de voyage et les photos de produits ! XIX.AI propose une sélection d'outils puissants et révolutionnaires, régulièrement mise à jour avec des classements hebdomadaires. Ces outils ont fait leurs preuves dans la pratique et vous aident à supprimer rapidement les éléments indésirables, à améliorer la qualité de votre contenu et à gagner un temps considérable sans compromettre les résultats. À essayer absolument pour tous ceux qui souhaitent exploiter pleinement le potentiel de la création par IA. Découvrez-les dès maintenant !
10 outils
xix.ai

Les meilleurs outils de synthèse vocale basés sur l'IA pour les cours en ligne en 2026 ont été sélectionnés par XIX.AI à l'issue de tests rigoureux en conditions réelles et selon un classement mis à jour chaque semaine. Ces outils performants aident les créateurs à produire sans effort des contenus audio d'une clarté exceptionnelle, ce qui améliore l'efficacité de la rédaction et rationalise la production des cours. Consultez le comparatif entre les versions gratuites et payantes pour trouver celle qui vous convient le mieux. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA dans l'enseignement en ligne.
10 outils
xix.ai


