


 Heim
LLaMA-Factory Online


Helps TikTok sellers, brands, MCNs, and TAPs discover winning products and find creators.
HelpLook is an AI-powered all-in-one knowledge base tool that helps businesses quickly build knowledge bases, help centers, and...
Your AI Workspace
302.AI is an enterprise-grade AI resource platform with pay-as-you-go pricing, API access to a full range of AI models, and ready-to-use online applications.

剧火AI — AI Screenwriter + Director, a One-Person Short Drama Studio In one sentence, what is it?

Haben Sie sich jemals gefragt, worum es in Gemini gefragt wurde? Lassen Sie mich es für Sie aufschlüsseln. Gemini ist dieser coole generative KI -Chatbot, der von den Gehirnen bei Google DeepMind hergestellt wird. Es ist, als hätte er einen super-schlauen Freund, der im Internetblock im Internet ist und u durchnässt
Was ist „Unshackled AI“? Unshackled Chat ist ein KI-gesteuerter Chatbot, der freie, unzensierte Unterhaltungen ermöglicht. Er bietet eine Plattform für uneingeschränkte KI-Interaktion, wobei offener A
Was ist „Sora 2“? Sora 2 ist das führende KI-Modell von OpenAI zur Erzeugung von Video- und Audiodaten und stellt einen Meilenstein in der Videoproduktion dar, der mit der Bedeutung von GPT-3.5 vergle
Haben Sie sich jemals gefragt, wie Sie Ihren Kundenunterstützung rationalisieren und das Gefühl geben, ein Team von supereffizienten Agenten zu haben, die rund um die Uhr arbeiten? Geben Sie die Mοveo AI ein, den Game-Changer in der Kundendienstautom
Was ist DigiMirror? DigiMirror ist ein KI-gesteuertes virtuelles Anprobetool, mit dem Nutzer sofort sehen können, wie ihnen Kleidung passt. Laden Sie Ihr Foto und ein Kleidungsstück hoch, und fortschr
LLaMA-Factory Online Produktinformationen
Was ist „ LLaMA-Factory Online “?
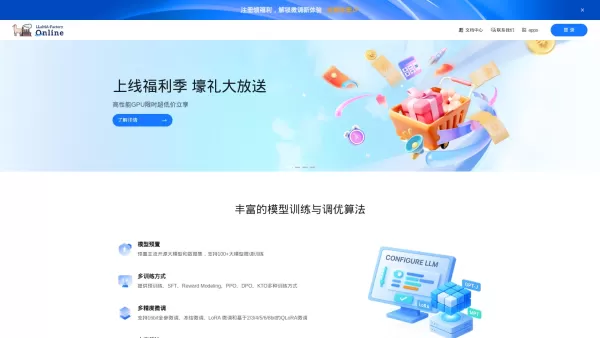
LLaMA-Factory Online ist die offizielle Cloud-Plattform für das Training und die Feinabstimmung von LLM-Modellen, die in Zusammenarbeit mit dem beliebten Open-Source-Projekt LLaMA-Factory entwickelt wurde. Sie bietet eine einsatzbereite, Low-Code- und End-to-End-Lösung für Nutzer, die die Feinabstimmung vereinfachen möchten oder nur über begrenzte technische Ressourcen verfügen.
Wie nutzt man „ LLaMA-Factory Online “?
Starten Sie das Fine-Tuning in drei einfachen Schritten: 1. Daten & Modelle vorbereiten: Laden Sie Ihre Datensätze ganz einfach per SFTP oder anderen unterstützten Methoden hoch. 2. Konfigurieren & Starten: Wählen Sie Ihr Basismodell aus und passen Sie wichtige Einstellungen in unserer visuellen Benutzeroberfläche an. Wählen Sie den Schnellmodus für eine schnelle Einrichtung oder den Expertenmodus für erweiterte Optionen. Wählen Sie einen Preisplan, der zu Ihrem Budget und Zeitplan passt, und starten Sie die Aufgabe dann mit einem Klick. 3. Überwachen und auswerten: Verwenden Sie integrierte Tools wie LlamaBoard und TensorBoard, um den Trainingsverlust und die Ressourcennutzung in Echtzeit zu verfolgen. Bewerten Sie nach dem Training die Ergebnisse mit der Modellbewertung oder testen Sie die Leistung sofort mit Model Chat.
LLaMA-Factory OnlineKernfunktionen
Umfangreiche Modellbibliothek (über 100 Modelle): Greifen Sie auf über 100 führende Open-Source-Modelle zu, darunter LLaMA, Qwen, DeepSeek, GPT-OSS und andere.
Umfassende Trainingsmethoden: Unterstützt den gesamten Trainingsprozess, vom Pre-Training und SFT (Supervised Fine-Tuning) bis hin zu Belohnungsmodellierung und Alignment-Methoden wie PPO, DPO und KTO.
Flexible Genauigkeit und Quantisierung: Passen Sie die Ressourcennutzung mit 16-Bit-Full-Fine-Tuning, Freeze-Tuning, LoRA und QLoRA an, die eine 2/3/4/5/6/8-Bit-Quantisierung unterstützen.
Modernste Optimierungsalgorithmen: Profitieren Sie von integrierten fortschrittlichen Optimierungen wie GaLore, BAdam, LoRA+, PiSSA, DoRA und rsLoRA.
Robuste Experimentverfolgung: Überwachen Sie den Trainingsfortschritt in Echtzeit dank integrierter Unterstützung für LlamaBoard, TensorBoard, WandB, MLflow und SwanLab.
Hocheffiziente Beschleunigung: Steigern Sie die Leistung mit FlashAttention-2- und Unsloth-Beschleunigung, die sowohl mit Transformers- als auch mit vLLM-Inferenz-Engines kompatibel sind.
LLaMA-Factory OnlineAnwendungsfälle
Automatisierter Korrekturassistent für chinesische Aufsätze: Nutzt Qwen3-vl-30B-A3B-Instruct, um intelligente Bewertungen und Feedback zu liefern.
Spezialisierter KI-Ticketing-Assistent: Ein maßgeschneiderter Kundendienstmitarbeiter, der mit Qwen2.5-14B-Instruct erstellt wurde.
Kostengünstige Feinabstimmung für massive MoE-Modelle: Effiziente Feinabstimmung von DeepSeek-V3 mithilfe der KTransformers-Optimierung.
Medizinische Bildanalyse: Eine Anwendung für die Gesundheitsdiagnostik, die mit Qwen3-vl-30B-A3B-Instruct feinabgestimmt wurde.
Leichtgewichtiges Smart-Home-Modell: Setzt Qwen3-4B für eine effiziente Edge-basierte Hausautomationssteuerung ein.
Rechts-KI-Agent: Ein spezialisierter Rechtsassistent, entwickelt mit LightLLM und LlamaIndex.
FAQ von LLaMA-Factory Online
Wie kann ich die Modellleistung verbessern, wenn die Ergebnisse der Feinabstimmung unbefriedigend sind?
1. Erweitern Sie den Datensatz: Verwenden Sie einen größeren Trainingsdatensatz. 2. Verlängern Sie die Trainingsdauer: Erhöhen Sie die Anzahl der Epochen (z. B. num_train_epochs: 5.0) oder die Gesamtzahl der Schritte (z. B. max_steps: 1000). 3. Passen Sie die Lernrate an: Versuchen Sie es mit einer höheren Lernrate (z. B. 2,0e-4). 4. Wechseln Sie die Feinabstimmungsmethoden: Testen Sie verschiedene Ansätze wie „freeze“ (Parameter-Einfrieren) oder „full“ (Vollparameter-Tuning) über die Einstellung „finetuning_type“.
Wie behebe ich „CUDA Out of Memory“-Fehler (OOM) während des Trainings?
Wenn Sie Probleme mit dem GPU-Speicher haben, versuchen Sie folgende Optimierungen: 1. Batch-Größe reduzieren: Setzen Sie per_device_train_batch_size auf 1. 2. Operatoren optimieren: Aktivieren Sie speichereffiziente Kernel, indem Sie enable_liger_kernel und use_unsloth_gc auf true setzen. 3. Verkürze die Sequenzlänge: Verringere cutoff_len (z. B. auf 512). 4. Nutze erweiterte Parallelität: Aktiviere DeepSpeed ZeRO-3 oder FSDP, um Modellgewichte auf Geräte zu verteilen, oder nutze CPU-Offloading. 5. Wende Quantisierung an: Setze quantization_bit auf 4, um Parameter zu komprimieren (nur für LoRA-Feintuning verfügbar).
Wie behebe ich unsinnige oder sich wiederholende Modellausgaben?
Die Lösung hängt davon ab, wann das Problem auftritt: Wenn es VOR dem Training auftritt: Dies liegt oft an der Verwendung eines rohen Basismodells (nicht abgeglichen) oder einer falschen Prompt-Vorlage. Stellen Sie sicher, dass Sie ein abgeglichenes Instruct/Chat-Modell und die richtige Vorlage verwenden. Wenn es NACH dem Training auftritt: Überprüfen Sie die Konsistenz der Vorlage: Stellen Sie sicher, dass die Inferenzvorlage mit der während des Trainings verwendeten übereinstimmt. Achten Sie auf Überanpassung: Wenn das Modell überangepasst ist, reduzieren Sie die Trainings-Epochen (num_train_epochs) und senken Sie die Lernrate.
LLaMA-Factory Online Support-E-Mail, Kundendienstkontakt, Kontakt für Rückerstattungen usw.
Wenden Sie sich an den Kundensupport von LLaMA-Factory Online unter: [email protected]. Weitere Kontaktmöglichkeiten finden Sie auf der Kontaktseite (mailto:[email protected])
LLaMA-Factory Online Unternehmen
LLaMA-Factory Online Firmenname: DataCanvas.
LLaMA-Factory Online Firmenadresse: .
Erfahren Sie mehr über LLaMA-Factory Online auf der Seite „Über uns“ ().
LLaMA-Factory Online Anmeldung
LLaMA-Factory Online Anmeldelink: https://www.llamafactory.com.cn/login
LLaMA-Factory Online Anmelden
LLaMA-Factory Online Anmeldelink: https://www.llamafactory.com.cn/login
LLaMA-Factory Online Screenshot



2026 Neueste und beste KI-Quiz-Erstellungstools für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die realen Tests unterzogen wurden, um genaue Rankings zu liefern. Diese unbedingt auszuprobierenden Plattformen helfen dabei, die Schreibeffizienz zu steigern, die Inhaltserstellung zu optimieren und das Quiz-Design in allen Lernszenarien zu vereinfachen. Entdecken Sie jetzt Ihr perfektes Tool, um Ihren KI-Vorteil im Unterricht voll auszuschöpfen!
 13 Tools
 xix.ai

Die besten neuen KI-Tools zur Pull-Request-Prüfung für GitHub-Teams im Jahr 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Liste mit den besten Bewertungen präsentiert leistungsstarke, bahnbrechende Lösungen, die Refactoring, Fehlerbehebung und die Erkennung von Sicherheitslücken in allen Team-Workflows optimieren. Profitieren Sie von einem Vergleich zwischen kostenlosen und kostenpflichtigen Tools sowie von Praxistests und detaillierten Rankings, die Ihnen helfen, das perfekte Tool zu finden, mit dem Sie Ihre Produktivität deutlich steigern können. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Vorteil!
12 Tools
xix.ai

Die besten und am besten bewerteten KI-Text-to-Speech-Tools für natürliche Sprachausgabe des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Optionen, die für jeden Anwendungsfall kristallklare Stimmen liefern – gestützt auf Tests in der Praxis und wöchentlich aktualisierte Rankings. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, um die Lösung zu finden, die Sie unbedingt ausprobieren sollten und die Ihre Produktivität sofort steigert. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil!
11 Tools
xix.ai

2026: Die besten Manga-KI-Hintergrundgeneratoren im Ranking – die Top-Bewertungen! Diese sorgfältig zusammengestellte Sammlung präsentiert leistungsstarke, bahnbrechende Tools, die sich perfekt für die Erstellung hochwertiger Kapitelhintergründe, Buchcover und Werbegrafiken eignen. Jede Option wurde strengen Praxistests unterzogen, um ihre Zuverlässigkeit sicherzustellen. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie detaillierte Einblicke. Entdecken Sie jetzt das perfekte Tool für sich und nutzen Sie den KI-Vorteil bei der Manga-Erstellung.
6 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools zum Entfernen von Objekten aus Porträts, Reisefotos und Produktfotos im Jahr 2026! XIX.AI stellt eine leistungsstarke, bahnbrechende Auswahl zusammen, die regelmäßig mit wöchentlichen Rankings aktualisiert wird. Diese Tools wurden in der Praxis getestet und helfen Ihnen dabei, unerwünschte Elemente schnell zu entfernen, die Qualität Ihrer Inhalte zu steigern und viel Zeit zu sparen, ohne dabei Abstriche bei den Ergebnissen zu machen. Ein Muss für alle, die ihr kreatives Potenzial mit KI voll ausschöpfen möchten. Jetzt entdecken!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Text-to-Speech-Tools für Online-Kurse des Jahres 2026 wurden von XIX.AI auf der Grundlage strenger Praxistests und wöchentlich aktualisierter Rankings zusammengestellt. Diese leistungsstarken Tools helfen Kursanbietern dabei, mühelos kristallklare Audioinhalte zu erstellen, die Effizienz beim Verfassen von Texten zu steigern und die Kursproduktion zu optimieren. Sehen Sie sich den Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten an, um das für Sie passende Tool zu finden. Entdecken Sie jetzt, wie Sie sich im Bereich der Online-Bildung einen KI-Vorteil verschaffen können.
10 Tools
xix.ai


