


 Maison
Découvrir nos «visites cachées» avec des données de téléphone portable et un apprentissage automatique
Si vous vous êtes déjà demandé comment les chercheurs suivent nos déplacements à travers un pays sans se fier uniquement aux appels téléphoniques, une étude fascinante menée par des chercheurs de Chine et des États-Unis apporte un éclairage. Leur travail collaboratif explore l’utilisation de l’apprentissage automatique pour révéler les « visites cachées » que nous effectuons — ces trajets qui n’apparaissent pas dans les données télécom standard car nous utilisons trop peu nos téléphones.
L’étude, intitulée **Identification des visites cachées à partir de données de registre d’appels sparse**, est dirigée par Zhan Zhao de l’Université de Hong Kong, aux côtés de Haris N. Koutsopoulos de l’Université Northeastern de Boston et Jinhua Zhao du MIT. Leur objectif ? Exploiter les enregistrements de connectivité mobile — tels que les données mobiles, SMS et appels vocaux — des utilisateurs très actifs pour modéliser et prédire les schémas de déplacement de ceux qui utilisent moins fréquemment leur téléphone.
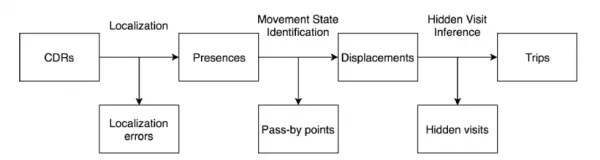 *Schéma approximatif pour extraire les informations de trajet à partir des données de registre d’appels (CDR).* Source : https://arxiv.org/pdf/2106.12885.pdf
Bien que l’équipe reconnaisse les préoccupations potentielles en matière de confidentialité soulevées par leur travail, elle souligne que leur objectif est de comprendre de manière générale les schémas de déplacement, plutôt que de se concentrer sur les trajets individuels. Ils notent également que les données de registre d’appels (CDR), qui forment la base de telles études, ont leurs limites. Elles manquent souvent de résolution spatiale et sont sujettes au « bruit de positionnement » dû aux changements de position de l’utilisateur par rapport aux tours de téléphonie. Cependant, ils soutiennent que cette inexactitude sert de sauvegarde pour la confidentialité :
**« L’application cible de notre étude est la détection de trajets et l’estimation OD$$ \* $$, réalisées à un niveau agrégé, et non individuel. Les modèles développés peuvent être directement déployés sur les serveurs de bases de données des opérateurs télécom, sans besoin de transfert de données. De plus, comparées à d’autres formes de big data, comme les données de réseaux sociaux ou de transactions par carte de crédit, les données CDR sont relativement moins intrusives en termes de confidentialité personnelle. En outre, leur erreur de localisation aide à masquer les emplacements exacts des utilisateurs, offrant une couche supplémentaire de protection de la confidentialité. »**
Intervalles de temps écoulés (ETIs)
Lorsque nous nous déplaçons avec nos téléphones mobiles, pas nécessairement des smartphones, les limites des données CDR comme outil pour localiser précisément notre position deviennent évidentes. Les intervalles de temps écoulés (ETIs), ces périodes pendant un trajet où nous ne passons ni ne recevons d’appels, sont des marqueurs cruciaux pour suivre nos déplacements. Ces intervalles de « silence » peuvent nous faire temporairement disparaître du réseau.
Les chercheurs soulignent comment ces écarts perturbent les systèmes analytiques essayant de comprendre les trajets A>B. La rareté des données peut cacher un « trajet non observé ». Leur nouvelle méthode aborde cela en analysant le contexte spatiotemporel des ETIs et en tenant compte des « caractéristiques individuelles de l’utilisateur ».
Jeu de données
Pour constituer leur ensemble d’entraînement principal, les chercheurs ont utilisé les données d’un grand opérateur de services cellulaires dans une ville chinoise de 6 millions d’habitants. Cet ensemble de données comprenait plus de deux milliards de transactions de téléphones mobiles de trois millions d’utilisateurs en novembre 2013, se concentrant uniquement sur les appels vocaux et les enregistrements d’accès aux données. Notamment, ils n’ont pas inclus les données SMS, ce qui a ajouté au défi de traiter des données sparse.
Les données incluaient un identifiant unique crypté, un code de zone de localisation (LAC), un horodatage, un identifiant de tour de téléphonie lié au LAC pour identifier la tour spécifique impliquée dans la transaction, et un identifiant d’événement indiquant s’il s’agissait d’un appel entrant/sortant ou d’une utilisation de données.
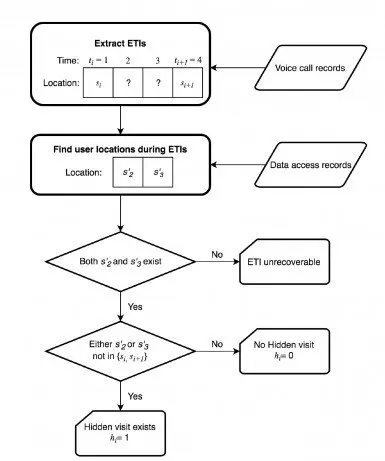 *Arbre de processus pour l’identification des visites cachées.*
Ces informations ont été croisées avec une base de données d’opérations des tours cellulaires, permettant aux chercheurs de localiser les coordonnées de longitude et de latitude de la tour associée à chaque événement de communication. Ils ont identifié 9000 tours cellulaires dans l’ensemble de données.
Les chercheurs ont noté la difficulté à deviner précisément les destinations des trajets en se basant uniquement sur les enregistrements d’appels, car ces enregistrements culminent le matin et l’après-midi, ce qui correspond aux schémas de déplacement typiques. Puisque les appels téléphoniques peuvent précéder un trajet et même le déclencher, cela peut fausser l’estimation de la destination.
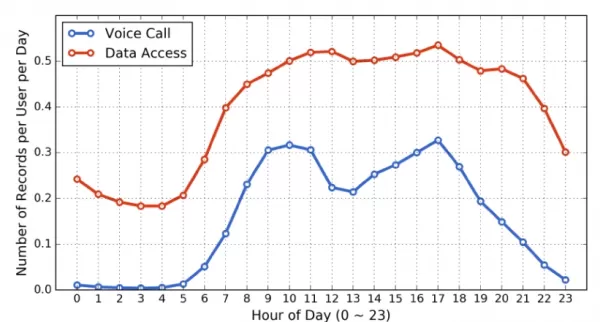 *Schémas d’utilisation mobile au cours d’une journée.*
Des défis similaires se posent avec l’utilisation de données initiée par l’utilisateur, comme les applications de messagerie. Cependant, c’est l’utilisation de données « automatisée » — comme l’interrogation systématique des API pour de nouveaux messages ou autres données, y compris le GPS et la télémétrie à travers les applications — qui aide à identifier ces mouvements cachés.
Traitement
Les chercheurs ont utilisé divers classificateurs d’apprentissage automatique pour résoudre ce problème, y compris la régression logistique, les machines à vecteurs de support (SVM), les forêts aléatoires et une approche d’ensemble par boosting de gradient. Ceux-ci ont été implémentés en Python à l’aide de scikit-learn avec les paramètres par défaut.
Parmi ceux-ci, la régression logistique a fourni les paramètres de modèle les plus interprétables. L’équipe a également constaté que des ETIs plus longs augmentaient la probabilité qu’une visite cachée se produise, avec une incidence plus élevée le matin. À l’inverse, lorsque les données CDR d’un utilisateur montraient clairement un grand nombre de destinations ou de points de passage, la probabilité d’une visite cachée était plus faible. Cette constatation soutient le principe central de leur recherche — que les utilisateurs les plus actifs fournissent une image détaillée de leurs déplacements, à partir de laquelle le comportement des utilisateurs moins actifs peut être inféré.
Dans leur conclusion, les chercheurs suggèrent que leur approche pourrait être appliquée à d’autres types de données de transport, telles que les données de cartes intelligentes et les informations de réseaux sociaux géolocalisées.
La recherche a été soutenue par des financements de la Energy Foundation China et du China Sustainable Transportation Center.
*\* Origine-Destination*
Article connexe
 Bayer s'appuie sur Iambic AI pour accélérer la découverte de médicaments
Le Dr Juergen Eckhardt occupe le poste de responsable du développement commercial et des licences chez Bayer Pharmaceuticals.Bayer s'appuie sur Iambic Therapeutics pour déployer des modèles d'IA de po
Meta fait l'objet d'une plainte concernant la confidentialité de ses lunettes connectées, des employés ayant apparemment visionné du contenu à caractère explicite
Meta fait l'objet d'une nouvelle action en justice concernant des problèmes de confidentialité liés à ses lunettes intelligentes dotées d'IA. Selon une enquête menée par des journaux suédois, des empl
L'IA axée sur l'optimisation apparaît comme une nouvelle voie vers des modèles à usage général
Des chercheurs de l'université de l'Illinois à Urbana-Champaign et de l'université de Virginie ont créé une nouvelle architecture de modèle qui pourrait ouvrir la voie à des systèmes d'IA plus résilie
Recommandations de sujets spéciaux liés
Éducation et apprentissage
 Outils d'étude basés sur l'IA pour les devoirs et la préparation aux examens
Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
 10 outils
 xix.ai
Composition musicale
Outils de démo vocale par IA pour les auteurs-compositeurs, les accroches, les mélodies principales et les sessions de brouillons multilingues
2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai
Entreprise
Les meilleurs outils de veille concurrentielle basés sur l'IA pour les petites entreprises
Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai
Édition d'images
Outils de retouche par IA Photoshop pour les vêtements d’e-commerce, nettoyage de la peau et cohérence des couleurs
2026 Derniers meilleurs outils de retouche par IA Photoshop pour les vêtements e-commerce, le nettoyage de la peau et la cohérence des couleurs ! Cette liste soigneusement sélectionnée et hautement notée propose des solutions puissantes qui changent la donne, vous aidant à améliorer l’efficacité rédactionnelle, rationaliser la création de contenu et obtenir des résultats visuels parfaits sans effort. Chaque outil a été testé dans des conditions réelles grâce à des classements mis à jour chaque semaine, accompagnés de détails comparatifs entre versions gratuites et payantes. Soutenu par XIX.AI, c’est le guide incontournable pour quiconque souhaite exploiter son avantage grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai
Rapide
Les meilleures bibliothèques de prompts d'IA pour les workflows ChatGPT
2026 : les meilleures bibliothèques de prompts IA les mieux notées pour optimiser tous les types de flux de travail ChatGPT. XIX.AI a sélectionné une collection puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles afin de garantir des performances optimales. Vous trouverez des comparaisons détaillées entre les solutions gratuites et payantes, ainsi que des classements d'experts pour vous aider à choisir les outils incontournables qui boosteront votre productivité et vous permettront de tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
11 outils
xix.ai
Éducation et apprentissage
Plateformes de création de quiz IA pour les enseignants, les tuteurs et les programmes d’apprentissage en cohorte
2026 Dernières Meilleures Plateformes de Création de Quiz par IA pour les Enseignants, Tuteurs et Programmes d’Apprentissage en Cohorte ! XIX.AI a sélectionné une liste hautement notée d’outils puissants et transformateurs, testés dans des situations réelles pour garantir des classements précis. Ces plateformes incontournables permettent d’améliorer l’efficacité rédactionnelle, de simplifier la création de contenu et de faciliter la conception de quiz dans tous les contextes d’apprentissage. Explorez dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer parti de l’avantage offert par l’IA dans votre enseignement !
13 outils
xix.ai

 commentaires (20)
![AlbertRodriguez]()
這研究真有意思!用手機數據和機器學習追蹤移動軌跡,感覺隱私問題又浮上檯面了。不過技術本身很酷,如果能用在疫情追蹤或城市規劃應該挺有用?但希望別被濫用啊😅
![DavidRodriguez]()
Die Studie zeigt echt spannend, wie sich Bewegungsmuster aus Mobilfunkdaten extrahieren lassen. Gleichzeitig wirft das aber auch Datenschutzfragen auf – wer kontrolliert eigentlich, wie diese Infos genutzt werden? 🧐
![JackSanchez]()
Wait, so they're using ML to track our 'hidden visits' now? 😅 Always feels a bit creepy when tech peeks into those unregistered trips... but the data insights could be huge for urban planning or disease tracking, right? Still, makes me side-eye my phone a little more today 🧐
![KennethWalker]()
This study on tracking movements with phone data is wild! 😲 It’s like our phones are secretly spilling where we’ve been. Kinda creepy, but super cool how machine learning digs into those 'hidden visits.' Makes me wonder what else they can find out!
![JuanLewis]()
This article blew my mind! Using phone data and ML to track hidden visits is so cool, but kinda creepy too. 🤯 Wonder how they balance privacy with all this tech wizardry.
![RalphSanchez]()
이 도구는 정말 놀랍습니다! 내 이동을 추적하는 데 유용하지만 조금 무섭기도 해요. 데이터를 삭제할 수 있는 옵션이 있으면 좋겠어요. 😓
Si vous vous êtes déjà demandé comment les chercheurs suivent nos déplacements à travers un pays sans se fier uniquement aux appels téléphoniques, une étude fascinante menée par des chercheurs de Chine et des États-Unis apporte un éclairage. Leur travail collaboratif explore l’utilisation de l’apprentissage automatique pour révéler les « visites cachées » que nous effectuons — ces trajets qui n’apparaissent pas dans les données télécom standard car nous utilisons trop peu nos téléphones.
L’étude, intitulée **Identification des visites cachées à partir de données de registre d’appels sparse**, est dirigée par Zhan Zhao de l’Université de Hong Kong, aux côtés de Haris N. Koutsopoulos de l’Université Northeastern de Boston et Jinhua Zhao du MIT. Leur objectif ? Exploiter les enregistrements de connectivité mobile — tels que les données mobiles, SMS et appels vocaux — des utilisateurs très actifs pour modéliser et prédire les schémas de déplacement de ceux qui utilisent moins fréquemment leur téléphone.
*Schéma approximatif pour extraire les informations de trajet à partir des données de registre d’appels (CDR).* Source : https://arxiv.org/pdf/2106.12885.pdf
Bien que l’équipe reconnaisse les préoccupations potentielles en matière de confidentialité soulevées par leur travail, elle souligne que leur objectif est de comprendre de manière générale les schémas de déplacement, plutôt que de se concentrer sur les trajets individuels. Ils notent également que les données de registre d’appels (CDR), qui forment la base de telles études, ont leurs limites. Elles manquent souvent de résolution spatiale et sont sujettes au « bruit de positionnement » dû aux changements de position de l’utilisateur par rapport aux tours de téléphonie. Cependant, ils soutiennent que cette inexactitude sert de sauvegarde pour la confidentialité :
**« L’application cible de notre étude est la détection de trajets et l’estimation OD$$ \* $$, réalisées à un niveau agrégé, et non individuel. Les modèles développés peuvent être directement déployés sur les serveurs de bases de données des opérateurs télécom, sans besoin de transfert de données. De plus, comparées à d’autres formes de big data, comme les données de réseaux sociaux ou de transactions par carte de crédit, les données CDR sont relativement moins intrusives en termes de confidentialité personnelle. En outre, leur erreur de localisation aide à masquer les emplacements exacts des utilisateurs, offrant une couche supplémentaire de protection de la confidentialité. »**
Intervalles de temps écoulés (ETIs)
Lorsque nous nous déplaçons avec nos téléphones mobiles, pas nécessairement des smartphones, les limites des données CDR comme outil pour localiser précisément notre position deviennent évidentes. Les intervalles de temps écoulés (ETIs), ces périodes pendant un trajet où nous ne passons ni ne recevons d’appels, sont des marqueurs cruciaux pour suivre nos déplacements. Ces intervalles de « silence » peuvent nous faire temporairement disparaître du réseau.
Les chercheurs soulignent comment ces écarts perturbent les systèmes analytiques essayant de comprendre les trajets A>B. La rareté des données peut cacher un « trajet non observé ». Leur nouvelle méthode aborde cela en analysant le contexte spatiotemporel des ETIs et en tenant compte des « caractéristiques individuelles de l’utilisateur ».
Jeu de données
Pour constituer leur ensemble d’entraînement principal, les chercheurs ont utilisé les données d’un grand opérateur de services cellulaires dans une ville chinoise de 6 millions d’habitants. Cet ensemble de données comprenait plus de deux milliards de transactions de téléphones mobiles de trois millions d’utilisateurs en novembre 2013, se concentrant uniquement sur les appels vocaux et les enregistrements d’accès aux données. Notamment, ils n’ont pas inclus les données SMS, ce qui a ajouté au défi de traiter des données sparse.
Les données incluaient un identifiant unique crypté, un code de zone de localisation (LAC), un horodatage, un identifiant de tour de téléphonie lié au LAC pour identifier la tour spécifique impliquée dans la transaction, et un identifiant d’événement indiquant s’il s’agissait d’un appel entrant/sortant ou d’une utilisation de données.
*Arbre de processus pour l’identification des visites cachées.*
Ces informations ont été croisées avec une base de données d’opérations des tours cellulaires, permettant aux chercheurs de localiser les coordonnées de longitude et de latitude de la tour associée à chaque événement de communication. Ils ont identifié 9000 tours cellulaires dans l’ensemble de données.
Les chercheurs ont noté la difficulté à deviner précisément les destinations des trajets en se basant uniquement sur les enregistrements d’appels, car ces enregistrements culminent le matin et l’après-midi, ce qui correspond aux schémas de déplacement typiques. Puisque les appels téléphoniques peuvent précéder un trajet et même le déclencher, cela peut fausser l’estimation de la destination.
*Schémas d’utilisation mobile au cours d’une journée.*
Des défis similaires se posent avec l’utilisation de données initiée par l’utilisateur, comme les applications de messagerie. Cependant, c’est l’utilisation de données « automatisée » — comme l’interrogation systématique des API pour de nouveaux messages ou autres données, y compris le GPS et la télémétrie à travers les applications — qui aide à identifier ces mouvements cachés.
Traitement
Les chercheurs ont utilisé divers classificateurs d’apprentissage automatique pour résoudre ce problème, y compris la régression logistique, les machines à vecteurs de support (SVM), les forêts aléatoires et une approche d’ensemble par boosting de gradient. Ceux-ci ont été implémentés en Python à l’aide de scikit-learn avec les paramètres par défaut.
Parmi ceux-ci, la régression logistique a fourni les paramètres de modèle les plus interprétables. L’équipe a également constaté que des ETIs plus longs augmentaient la probabilité qu’une visite cachée se produise, avec une incidence plus élevée le matin. À l’inverse, lorsque les données CDR d’un utilisateur montraient clairement un grand nombre de destinations ou de points de passage, la probabilité d’une visite cachée était plus faible. Cette constatation soutient le principe central de leur recherche — que les utilisateurs les plus actifs fournissent une image détaillée de leurs déplacements, à partir de laquelle le comportement des utilisateurs moins actifs peut être inféré.
Dans leur conclusion, les chercheurs suggèrent que leur approche pourrait être appliquée à d’autres types de données de transport, telles que les données de cartes intelligentes et les informations de réseaux sociaux géolocalisées.
La recherche a été soutenue par des financements de la Energy Foundation China et du China Sustainable Transportation Center.
*\* Origine-Destination*








 Bayer s'appuie sur Iambic AI pour accélérer la découverte de médicaments
Le Dr Juergen Eckhardt occupe le poste de responsable du développement commercial et des licences chez Bayer Pharmaceuticals.Bayer s'appuie sur Iambic Therapeutics pour déployer des modèles d'IA de po
 Meta fait l'objet d'une plainte concernant la confidentialité de ses lunettes connectées, des employés ayant apparemment visionné du contenu à caractère explicite
Meta fait l'objet d'une nouvelle action en justice concernant des problèmes de confidentialité liés à ses lunettes intelligentes dotées d'IA. Selon une enquête menée par des journaux suédois, des empl
 L'IA axée sur l'optimisation apparaît comme une nouvelle voie vers des modèles à usage général
Des chercheurs de l'université de l'Illinois à Urbana-Champaign et de l'université de Virginie ont créé une nouvelle architecture de modèle qui pourrait ouvrir la voie à des systèmes d'IA plus résilie

Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai

Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai

2026 Derniers meilleurs outils de retouche par IA Photoshop pour les vêtements e-commerce, le nettoyage de la peau et la cohérence des couleurs ! Cette liste soigneusement sélectionnée et hautement notée propose des solutions puissantes qui changent la donne, vous aidant à améliorer l’efficacité rédactionnelle, rationaliser la création de contenu et obtenir des résultats visuels parfaits sans effort. Chaque outil a été testé dans des conditions réelles grâce à des classements mis à jour chaque semaine, accompagnés de détails comparatifs entre versions gratuites et payantes. Soutenu par XIX.AI, c’est le guide incontournable pour quiconque souhaite exploiter son avantage grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai

2026 : les meilleures bibliothèques de prompts IA les mieux notées pour optimiser tous les types de flux de travail ChatGPT. XIX.AI a sélectionné une collection puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles afin de garantir des performances optimales. Vous trouverez des comparaisons détaillées entre les solutions gratuites et payantes, ainsi que des classements d'experts pour vous aider à choisir les outils incontournables qui boosteront votre productivité et vous permettront de tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
11 outils
xix.ai

2026 Dernières Meilleures Plateformes de Création de Quiz par IA pour les Enseignants, Tuteurs et Programmes d’Apprentissage en Cohorte ! XIX.AI a sélectionné une liste hautement notée d’outils puissants et transformateurs, testés dans des situations réelles pour garantir des classements précis. Ces plateformes incontournables permettent d’améliorer l’efficacité rédactionnelle, de simplifier la création de contenu et de faciliter la conception de quiz dans tous les contextes d’apprentissage. Explorez dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer parti de l’avantage offert par l’IA dans votre enseignement !
13 outils
xix.ai

這研究真有意思!用手機數據和機器學習追蹤移動軌跡,感覺隱私問題又浮上檯面了。不過技術本身很酷,如果能用在疫情追蹤或城市規劃應該挺有用?但希望別被濫用啊😅
Die Studie zeigt echt spannend, wie sich Bewegungsmuster aus Mobilfunkdaten extrahieren lassen. Gleichzeitig wirft das aber auch Datenschutzfragen auf – wer kontrolliert eigentlich, wie diese Infos genutzt werden? 🧐
Wait, so they're using ML to track our 'hidden visits' now? 😅 Always feels a bit creepy when tech peeks into those unregistered trips... but the data insights could be huge for urban planning or disease tracking, right? Still, makes me side-eye my phone a little more today 🧐
This study on tracking movements with phone data is wild! 😲 It’s like our phones are secretly spilling where we’ve been. Kinda creepy, but super cool how machine learning digs into those 'hidden visits.' Makes me wonder what else they can find out!
This article blew my mind! Using phone data and ML to track hidden visits is so cool, but kinda creepy too. 🤯 Wonder how they balance privacy with all this tech wizardry.
이 도구는 정말 놀랍습니다! 내 이동을 추적하는 데 유용하지만 조금 무섭기도 해요. 데이터를 삭제할 수 있는 옵션이 있으면 좋겠어요. 😓












