


 Maison
TaiXu-Admin V0.1.2 dévoile une console unifiée intégrant des fonctionnalités LLM, RAG et d'agent
Une initiative open source dédiée à l'organisation des capacités des grands modèles linguistiques (LLM) a franchi une nouvelle étape. La version 0.1.2 de TaiXu-Admin vient d'être publiée. Ce système de gestion d'applications, axé sur les LLM, le RAG et les agents, vise à unifier le dialogue, l'amélioration de la recherche et la collaboration entre agents intelligents au sein d'un seul backend.
Le journal des mises à jour de cette version est très complet. Il relie la documentation à l’analyse syntaxique du LLM Wiki et introduit la recherche dans le LLM Wiki ; il met en œuvre un mécanisme de remplacement par compilation à chaud (HCP) pour les fichiers de code modifiés, permettant aux ajustements de prendre effet sans redémarrage ; la base de connaissances et la bibliothèque de graphes de connaissances prennent désormais en charge la reconfiguration personnalisée. La gestion de la mémoire historique a été mise à jour, et la gestion des exceptions pour RAG et Agent pendant l’exécution est désormais complète — pour une plateforme visant à maintenir plusieurs agents intelligents en ligne pendant de longues périodes, ces améliorations ont encore renforcé les fondations.
Si l’on examine le système lui-même, TaiXu-Admin est un système intelligent intégrant des technologies d’IA : le backend est écrit en Python, tandis que le frontend utilise React pour les pages interactives. Ses fonctionnalités comprennent la conversation LLM, le RAG et l’Agent. Il s’appuie sur LangChain et LangGraph comme composants centraux des applications de grands modèles. Le premier construit des pipelines de modèles modulaires, tandis que le second gère une collaboration multi-agents complexe pilotée par l’état, prenant ainsi en charge le mode RAG, le mode Agent, l’ingénierie des prompts, les appels d’outils et la gestion de la mémoire, en intégrant à la fois l’interaction conversationnelle, la génération enrichie par la recherche de connaissances et la collaboration entre agents.
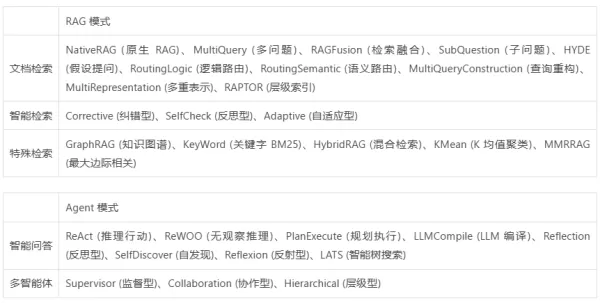
Ce qui démontre véritablement ses capacités, c’est qu’il propose sous forme de menu la quasi-totalité des pratiques courantes du marché. Dans la section RAG, le RAG natif, les requêtes multiples, la fusion de la recherche, la décomposition en sous-questions, l’intégration de documents hypothétiques (HYDE), le routage logique et sémantique, la réécriture de requêtes, les représentations multiples et l’indexation hiérarchique (RAPTOR) sont tous disponibles. Des agents dotés de capacités de correction d’erreurs, d’autocontrôle et d’auto-adaptation assurent un filet de sécurité tout au long du processus de recherche. Parmi les modes spéciaux figurent également les graphes de connaissances GraphRAG, les mots-clés BM25, le RAG hybride, le regroupement par la méthode des K-moyennes et le RAG à pertinence marginale maximale. Le mode Agent est encore plus dynamique : les actions de raisonnement de ReAct, le raisonnement sans observation de ReWOO, l’exécution de la planification, la compilation LLM, la réflexion, l’auto-découverte, la recherche intelligente dans les arbres, ainsi que l’orchestration multi-agents supervisée, collaborative et hiérarchique — couvrant ainsi la quasi-totalité des éléments clés de la recherche actuelle sur les agents.
En termes d’architecture, il suit une approche séparant front-end et back-end, avec une conception modulaire. Le back-end est développé en Python et utilise le framework léger Flask pour prendre en charge une API RESTful. Le front-end utilise React pour créer une interface réactive, en s’appuyant sur le framework open source Umi d’Ant Group pour l’ingénierie du projet et en utilisant Ant Design comme bibliothèque de composants. La base de données sous-jacente est également divisée en rôles : Qdrant, une base de données cloud-native haute performance, stocke les représentations textuelles et gère les recherches de similarité sémantique ; Neo4j modélise les relations complexes entre les entités et permet le raisonnement sur les graphes ; enfin, PostgreSQL stocke de manière fiable les données métier structurées telles que les utilisateurs, les journaux et les configurations.
La mise en route n’est pas trop compliquée. Les dépendances du front-end sont gérées via npm ou yarn, et celles du back-end via pip ou poetry ; il suffit ensuite d’installer les trois éléments essentiels : Qdrant, Neo4j et PostgreSQL. Si vous souhaitez simplement tester le système en local, il vous suffit d’exécuter les étapes de configuration les plus simples : vous n’aurez même pas besoin de Qdrant ni de Neo4j pour découvrir les modules principaux. Une fois le démarrage effectué, accédez à localhost:8000, où le nom d’utilisateur et le mot de passe par défaut sont tous deux « admin » : un système intégrant LLM, RAG et Agent en une seule interface est désormais à la disposition des développeurs.
Article connexe
 Les actions américaines atteignent un jalon historique alors que les géants de l'IA et de l'aérospatiale se préparent pour leur entrée boursière à la valeur du trillion de dollars.
Elon Musk, Sam Altman et Dario Amodei, trois titans du secteur technologique, s’approchent des introductions en bourse de leurs entreprises respectives. Avec SpaceX, OpenAI et Anthropic – trois géants de l’industrie dont les valorisations approchent
La startup suédoise en intelligence artificielle Lovable Eyes atteint une valorisation de 13,2 milliards de dollars après un tour de table majeur
Alors que les outils de codage alimentés par l’intelligence artificielle gagnent en popularité, la startup suédoise Lovable a levé des fonds lors d’un tour de table majeur. L’entreprise vise à collecter 3 milliards de dollars, ce qui pourrait porter
Google teste l'agent IA Remy pour Gemini à mesure que l'accent se déplace vers le contrôle utilisateur
Selon Business Insider, Google teste Remy, un nouvel agent personnel d’IA pour Gemini. Cet outil vise à exécuter des tâches au nom des utilisateurs, rationalisant ainsi les flux de travail professionnels et les routines quotidiennes.Actuellement, Re
Recommandations de sujets spéciaux liés
Analyse des données
 Meilleurs outils d’IA pour la détection d’anomalies dans le suivi des KPI pour les équipes SaaS et Ecommerce
2026 Derniers Meilleurs Outils de Détection d’Anomalies par IA les mieux notés pour la surveillance des KPI dans les équipes SaaS et E-commerce ! XIX.AI a sélectionné une collection puissante et révolutionnaire, basée sur des tests rigoureux en conditions réelles et des classements mis à jour chaque semaine. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, afin de vous aider à identifier la solution incontournable qui améliore la productivité et débloque votre avantage concurrentiel grâce à l’IA. Explorez dès maintenant !
 10 outils
 xix.ai
en écrivant
Les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs
2026 : les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs, soigneusement sélectionnés par XIX.AI. Ces outils puissants offrent une aide révolutionnaire pour créer rapidement du contenu de haute qualité, améliorant ainsi considérablement l'efficacité de la rédaction. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests concrets et des classements détaillés pour vous aider à trouver l'option incontournable qui répond à vos besoins. Explorez dès maintenant pour tirer pleinement parti de l'IA.
8 outils
xix.ai
Éducation et apprentissage
Outils d'étude basés sur l'IA pour les devoirs et la préparation aux examens
Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai
Composition musicale
Outils de démo vocale par IA pour les auteurs-compositeurs, les accroches, les mélodies principales et les sessions de brouillons multilingues
2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai
Entreprise
Les meilleurs outils de veille concurrentielle basés sur l'IA pour les petites entreprises
Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai
Édition d'images
Outils de retouche par IA Photoshop pour les vêtements d’e-commerce, nettoyage de la peau et cohérence des couleurs
2026 Derniers meilleurs outils de retouche par IA Photoshop pour les vêtements e-commerce, le nettoyage de la peau et la cohérence des couleurs ! Cette liste soigneusement sélectionnée et hautement notée propose des solutions puissantes qui changent la donne, vous aidant à améliorer l’efficacité rédactionnelle, rationaliser la création de contenu et obtenir des résultats visuels parfaits sans effort. Chaque outil a été testé dans des conditions réelles grâce à des classements mis à jour chaque semaine, accompagnés de détails comparatifs entre versions gratuites et payantes. Soutenu par XIX.AI, c’est le guide incontournable pour quiconque souhaite exploiter son avantage grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai

 commentaires (0)
Une initiative open source dédiée à l'organisation des capacités des grands modèles linguistiques (LLM) a franchi une nouvelle étape. La version 0.1.2 de TaiXu-Admin vient d'être publiée. Ce système de gestion d'applications, axé sur les LLM, le RAG et les agents, vise à unifier le dialogue, l'amélioration de la recherche et la collaboration entre agents intelligents au sein d'un seul backend.
Le journal des mises à jour de cette version est très complet. Il relie la documentation à l’analyse syntaxique du LLM Wiki et introduit la recherche dans le LLM Wiki ; il met en œuvre un mécanisme de remplacement par compilation à chaud (HCP) pour les fichiers de code modifiés, permettant aux ajustements de prendre effet sans redémarrage ; la base de connaissances et la bibliothèque de graphes de connaissances prennent désormais en charge la reconfiguration personnalisée. La gestion de la mémoire historique a été mise à jour, et la gestion des exceptions pour RAG et Agent pendant l’exécution est désormais complète — pour une plateforme visant à maintenir plusieurs agents intelligents en ligne pendant de longues périodes, ces améliorations ont encore renforcé les fondations.
Si l’on examine le système lui-même, TaiXu-Admin est un système intelligent intégrant des technologies d’IA : le backend est écrit en Python, tandis que le frontend utilise React pour les pages interactives. Ses fonctionnalités comprennent la conversation LLM, le RAG et l’Agent. Il s’appuie sur LangChain et LangGraph comme composants centraux des applications de grands modèles. Le premier construit des pipelines de modèles modulaires, tandis que le second gère une collaboration multi-agents complexe pilotée par l’état, prenant ainsi en charge le mode RAG, le mode Agent, l’ingénierie des prompts, les appels d’outils et la gestion de la mémoire, en intégrant à la fois l’interaction conversationnelle, la génération enrichie par la recherche de connaissances et la collaboration entre agents.
Ce qui démontre véritablement ses capacités, c’est qu’il propose sous forme de menu la quasi-totalité des pratiques courantes du marché. Dans la section RAG, le RAG natif, les requêtes multiples, la fusion de la recherche, la décomposition en sous-questions, l’intégration de documents hypothétiques (HYDE), le routage logique et sémantique, la réécriture de requêtes, les représentations multiples et l’indexation hiérarchique (RAPTOR) sont tous disponibles. Des agents dotés de capacités de correction d’erreurs, d’autocontrôle et d’auto-adaptation assurent un filet de sécurité tout au long du processus de recherche. Parmi les modes spéciaux figurent également les graphes de connaissances GraphRAG, les mots-clés BM25, le RAG hybride, le regroupement par la méthode des K-moyennes et le RAG à pertinence marginale maximale. Le mode Agent est encore plus dynamique : les actions de raisonnement de ReAct, le raisonnement sans observation de ReWOO, l’exécution de la planification, la compilation LLM, la réflexion, l’auto-découverte, la recherche intelligente dans les arbres, ainsi que l’orchestration multi-agents supervisée, collaborative et hiérarchique — couvrant ainsi la quasi-totalité des éléments clés de la recherche actuelle sur les agents.
En termes d’architecture, il suit une approche séparant front-end et back-end, avec une conception modulaire. Le back-end est développé en Python et utilise le framework léger Flask pour prendre en charge une API RESTful. Le front-end utilise React pour créer une interface réactive, en s’appuyant sur le framework open source Umi d’Ant Group pour l’ingénierie du projet et en utilisant Ant Design comme bibliothèque de composants. La base de données sous-jacente est également divisée en rôles : Qdrant, une base de données cloud-native haute performance, stocke les représentations textuelles et gère les recherches de similarité sémantique ; Neo4j modélise les relations complexes entre les entités et permet le raisonnement sur les graphes ; enfin, PostgreSQL stocke de manière fiable les données métier structurées telles que les utilisateurs, les journaux et les configurations.
La mise en route n’est pas trop compliquée. Les dépendances du front-end sont gérées via npm ou yarn, et celles du back-end via pip ou poetry ; il suffit ensuite d’installer les trois éléments essentiels : Qdrant, Neo4j et PostgreSQL. Si vous souhaitez simplement tester le système en local, il vous suffit d’exécuter les étapes de configuration les plus simples : vous n’aurez même pas besoin de Qdrant ni de Neo4j pour découvrir les modules principaux. Une fois le démarrage effectué, accédez à localhost:8000, où le nom d’utilisateur et le mot de passe par défaut sont tous deux « admin » : un système intégrant LLM, RAG et Agent en une seule interface est désormais à la disposition des développeurs.








 Les actions américaines atteignent un jalon historique alors que les géants de l'IA et de l'aérospatiale se préparent pour leur entrée boursière à la valeur du trillion de dollars.
Elon Musk, Sam Altman et Dario Amodei, trois titans du secteur technologique, s’approchent des introductions en bourse de leurs entreprises respectives. Avec SpaceX, OpenAI et Anthropic – trois géants de l’industrie dont les valorisations approchent
 La startup suédoise en intelligence artificielle Lovable Eyes atteint une valorisation de 13,2 milliards de dollars après un tour de table majeur
Alors que les outils de codage alimentés par l’intelligence artificielle gagnent en popularité, la startup suédoise Lovable a levé des fonds lors d’un tour de table majeur. L’entreprise vise à collecter 3 milliards de dollars, ce qui pourrait porter
Google teste l'agent IA Remy pour Gemini à mesure que l'accent se déplace vers le contrôle utilisateur
Selon Business Insider, Google teste Remy, un nouvel agent personnel d’IA pour Gemini. Cet outil vise à exécuter des tâches au nom des utilisateurs, rationalisant ainsi les flux de travail professionnels et les routines quotidiennes.Actuellement, Re

2026 Derniers Meilleurs Outils de Détection d’Anomalies par IA les mieux notés pour la surveillance des KPI dans les équipes SaaS et E-commerce ! XIX.AI a sélectionné une collection puissante et révolutionnaire, basée sur des tests rigoureux en conditions réelles et des classements mis à jour chaque semaine. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, afin de vous aider à identifier la solution incontournable qui améliore la productivité et débloque votre avantage concurrentiel grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai

2026 : les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs, soigneusement sélectionnés par XIX.AI. Ces outils puissants offrent une aide révolutionnaire pour créer rapidement du contenu de haute qualité, améliorant ainsi considérablement l'efficacité de la rédaction. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests concrets et des classements détaillés pour vous aider à trouver l'option incontournable qui répond à vos besoins. Explorez dès maintenant pour tirer pleinement parti de l'IA.
8 outils
xix.ai

Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai

Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai

2026 Derniers meilleurs outils de retouche par IA Photoshop pour les vêtements e-commerce, le nettoyage de la peau et la cohérence des couleurs ! Cette liste soigneusement sélectionnée et hautement notée propose des solutions puissantes qui changent la donne, vous aidant à améliorer l’efficacité rédactionnelle, rationaliser la création de contenu et obtenir des résultats visuels parfaits sans effort. Chaque outil a été testé dans des conditions réelles grâce à des classements mis à jour chaque semaine, accompagnés de détails comparatifs entre versions gratuites et payantes. Soutenu par XIX.AI, c’est le guide incontournable pour quiconque souhaite exploiter son avantage grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai












