


 Maison
Mistral dévoile un modèle open source de synthèse vocale
La société française d'IA Mistral a dévoilé jeudi un nouveau modèle open source de synthèse vocale, conçu pour les assistants vocaux IA et les applications d'entreprise telles que le service client. Ce modèle permet aux entreprises de développer des agents vocaux destinés à la vente et à l'engagement client, positionnant ainsi Mistral comme un concurrent direct d'ElevenLabs, de Deepgram et d'OpenAI.
Baptisé Voxtral TTS, ce modèle prend en charge neuf langues, dont l'anglais, le français, l'allemand, l'espagnol, le néerlandais, le portugais, l'italien, l'hindi et l'arabe.
« Nos clients nous demandaient un modèle de synthèse vocale. Nous avons donc développé un modèle de petite taille pouvant s’intégrer à une montre connectée, un smartphone, un ordinateur portable ou d’autres appareils périphériques. Son coût est bien inférieur à celui de tout autre produit sur le marché, tout en offrant des performances de pointe », a déclaré Pierre Stock, vice-président des opérations scientifiques chez Mistral AI, lors d’un entretien téléphonique avec TechCrunch.
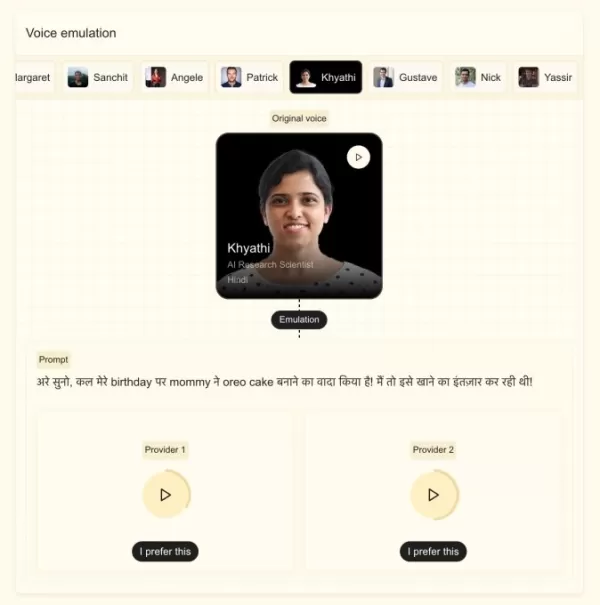
Crédit image : Mistral
Mistral affirme que ce nouveau modèle peut s’adapter à une voix personnalisée à partir d’un échantillon de moins de cinq secondes, en capturant les accents subtils, les inflexions, les intonations et les irrégularités du flux vocal. Basé sur Mistral 3B, il peut passer d’une langue à l’autre en douceur tout en conservant les caractéristiques vocales, ce qui le rend idéal pour le doublage ou la traduction en temps réel. M. Stock a souligné que l’entreprise avait pour objectif de donner au modèle une voix humaine, et non robotique.
Selon l'entreprise, le modèle est conçu pour fonctionner en temps réel. Son temps de réponse audio (TTFA) — le délai entre la réception de l'entrée et le début de la « parole » — est de 90 ms pour un échantillon de 10 secondes comprenant 500 caractères. Le modèle atteint également un facteur temps réel (RTF) de 6x, ce qui signifie qu’il peut générer un clip de 10 secondes en environ 1,6 seconde.
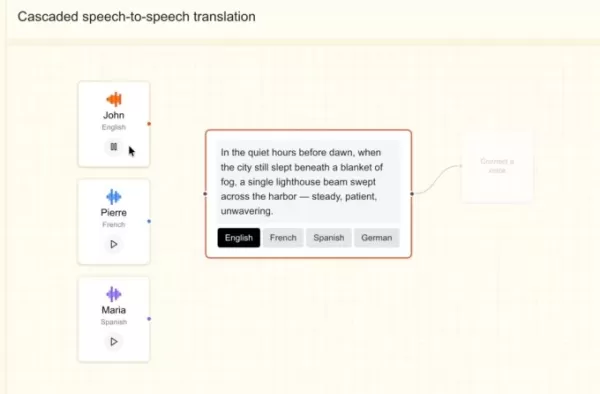
Crédit image : Mistral AI
Plus tôt cette année, Mistral a lancé deux modèles de transcription : l’un pour le traitement par lots à grande échelle, l’autre pour des cas d’utilisation en temps réel à faible latence. Avec ce nouveau modèle vocal, l’entreprise semble en train de développer une suite complète de produits vocaux destinés aux entreprises.
M. Stock a ajouté : « Nous prévoyons de créer une plateforme de bout en bout capable de gérer des flux d'entrée multimodaux — audio, texte et image — ainsi que des sorties. L'avantage principal est qu'un système agentique de bout en bout prenant en charge l'entrée et la sortie audio fournit des informations bien plus riches. »
Mistral met en avant son caractère open source et ses capacités de personnalisation comme principaux facteurs de différenciation, permettant aux entreprises d'adapter le modèle à leurs besoins spécifiques, ce qui le rend plus attractif que les solutions concurrentes.
Article connexe
 ElevenLabs présente une intelligence artificielle musicale capable de changer de genre au milieu d’une chanson
ElevenLabs, une entreprise spécialisée dans l’intelligence artificielle vocale, a lancé Music v2, la dernière version de son modèle de génération musicale capable de changer de genre au cours d’une chanson. Ce modèle a été conçu pour gérer des voix c
Google déploie des invites vocales dans Docs et Keep
Lors de la conférence des développeurs Google I/O, l'entreprise a annoncé l'introduction de commandes vocales dans les applications Workspace telles que Docs, Keep et Gmail. Ces fonctionnalités permet
D'anciens collaborateurs de Goldman Sachs et les fondateurs de Meta développent une IA vocale destinée aux marchés négligés
Le service client et l’assistance font partie des domaines les plus en vogue aujourd’hui dans le domaine de l’IA vocale. Mais développer un produit qui parle comme un humain et répond avec un temps de
Recommandations de sujets spéciaux liés
Référencement
 Les meilleurs outils d'analyse des SERP basés sur l'IA pour la stratégie de référencement
Les meilleurs outils d’analyse SERP basés sur l’IA de 2026, les mieux notés pour la stratégie de référencement, sont sélectionnés par XIX.AI à l’issue de tests rigoureux en conditions réelles et de classements mis à jour chaque semaine. Ces outils puissants vous aident à révéler des opportunités d’optimisation cachées, à améliorer les performances de votre contenu et à acquérir un avantage concurrentiel dans les résultats de recherche. Découvrez dès aujourd’hui l’outil idéal pour optimiser votre stratégie de référencement. Explorez-les dès maintenant !
 13 outils
 xix.ai
Analyse des données
Meilleurs outils d’IA pour la détection d’anomalies dans le suivi des KPI pour les équipes SaaS et Ecommerce
2026 Derniers Meilleurs Outils de Détection d’Anomalies par IA les mieux notés pour la surveillance des KPI dans les équipes SaaS et E-commerce ! XIX.AI a sélectionné une collection puissante et révolutionnaire, basée sur des tests rigoureux en conditions réelles et des classements mis à jour chaque semaine. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, afin de vous aider à identifier la solution incontournable qui améliore la productivité et débloque votre avantage concurrentiel grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai
en écrivant
Les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs
2026 : les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs, soigneusement sélectionnés par XIX.AI. Ces outils puissants offrent une aide révolutionnaire pour créer rapidement du contenu de haute qualité, améliorant ainsi considérablement l'efficacité de la rédaction. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests concrets et des classements détaillés pour vous aider à trouver l'option incontournable qui répond à vos besoins. Explorez dès maintenant pour tirer pleinement parti de l'IA.
8 outils
xix.ai
Éducation et apprentissage
Outils d'étude basés sur l'IA pour les devoirs et la préparation aux examens
Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai
Composition musicale
Outils de démo vocale par IA pour les auteurs-compositeurs, les accroches, les mélodies principales et les sessions de brouillons multilingues
2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai
Entreprise
Les meilleurs outils de veille concurrentielle basés sur l'IA pour les petites entreprises
Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai

 commentaires (1)
![WilliamRamirez]()
I just tried out Mistral’s new open-source TTS model yesterday, and its pronunciation is way more natural than most free options I’ve used before. It’s super useful for companies that want to build their own voice assistants without spending tons on licensed services. Do you think this will change the game in the enterprise voice AI market?
La société française d'IA Mistral a dévoilé jeudi un nouveau modèle open source de synthèse vocale, conçu pour les assistants vocaux IA et les applications d'entreprise telles que le service client. Ce modèle permet aux entreprises de développer des agents vocaux destinés à la vente et à l'engagement client, positionnant ainsi Mistral comme un concurrent direct d'ElevenLabs, de Deepgram et d'OpenAI.
Baptisé Voxtral TTS, ce modèle prend en charge neuf langues, dont l'anglais, le français, l'allemand, l'espagnol, le néerlandais, le portugais, l'italien, l'hindi et l'arabe.
« Nos clients nous demandaient un modèle de synthèse vocale. Nous avons donc développé un modèle de petite taille pouvant s’intégrer à une montre connectée, un smartphone, un ordinateur portable ou d’autres appareils périphériques. Son coût est bien inférieur à celui de tout autre produit sur le marché, tout en offrant des performances de pointe », a déclaré Pierre Stock, vice-président des opérations scientifiques chez Mistral AI, lors d’un entretien téléphonique avec TechCrunch.
Crédit image : Mistral
Mistral affirme que ce nouveau modèle peut s’adapter à une voix personnalisée à partir d’un échantillon de moins de cinq secondes, en capturant les accents subtils, les inflexions, les intonations et les irrégularités du flux vocal. Basé sur Mistral 3B, il peut passer d’une langue à l’autre en douceur tout en conservant les caractéristiques vocales, ce qui le rend idéal pour le doublage ou la traduction en temps réel. M. Stock a souligné que l’entreprise avait pour objectif de donner au modèle une voix humaine, et non robotique.
Selon l'entreprise, le modèle est conçu pour fonctionner en temps réel. Son temps de réponse audio (TTFA) — le délai entre la réception de l'entrée et le début de la « parole » — est de 90 ms pour un échantillon de 10 secondes comprenant 500 caractères. Le modèle atteint également un facteur temps réel (RTF) de 6x, ce qui signifie qu’il peut générer un clip de 10 secondes en environ 1,6 seconde.
Crédit image : Mistral AI
Plus tôt cette année, Mistral a lancé deux modèles de transcription : l’un pour le traitement par lots à grande échelle, l’autre pour des cas d’utilisation en temps réel à faible latence. Avec ce nouveau modèle vocal, l’entreprise semble en train de développer une suite complète de produits vocaux destinés aux entreprises.
M. Stock a ajouté : « Nous prévoyons de créer une plateforme de bout en bout capable de gérer des flux d'entrée multimodaux — audio, texte et image — ainsi que des sorties. L'avantage principal est qu'un système agentique de bout en bout prenant en charge l'entrée et la sortie audio fournit des informations bien plus riches. »
Mistral met en avant son caractère open source et ses capacités de personnalisation comme principaux facteurs de différenciation, permettant aux entreprises d'adapter le modèle à leurs besoins spécifiques, ce qui le rend plus attractif que les solutions concurrentes.








 ElevenLabs présente une intelligence artificielle musicale capable de changer de genre au milieu d’une chanson
ElevenLabs, une entreprise spécialisée dans l’intelligence artificielle vocale, a lancé Music v2, la dernière version de son modèle de génération musicale capable de changer de genre au cours d’une chanson. Ce modèle a été conçu pour gérer des voix c
 Google déploie des invites vocales dans Docs et Keep
Lors de la conférence des développeurs Google I/O, l'entreprise a annoncé l'introduction de commandes vocales dans les applications Workspace telles que Docs, Keep et Gmail. Ces fonctionnalités permet
 D'anciens collaborateurs de Goldman Sachs et les fondateurs de Meta développent une IA vocale destinée aux marchés négligés
Le service client et l’assistance font partie des domaines les plus en vogue aujourd’hui dans le domaine de l’IA vocale. Mais développer un produit qui parle comme un humain et répond avec un temps de

Les meilleurs outils d’analyse SERP basés sur l’IA de 2026, les mieux notés pour la stratégie de référencement, sont sélectionnés par XIX.AI à l’issue de tests rigoureux en conditions réelles et de classements mis à jour chaque semaine. Ces outils puissants vous aident à révéler des opportunités d’optimisation cachées, à améliorer les performances de votre contenu et à acquérir un avantage concurrentiel dans les résultats de recherche. Découvrez dès aujourd’hui l’outil idéal pour optimiser votre stratégie de référencement. Explorez-les dès maintenant !
13 outils
xix.ai

2026 Derniers Meilleurs Outils de Détection d’Anomalies par IA les mieux notés pour la surveillance des KPI dans les équipes SaaS et E-commerce ! XIX.AI a sélectionné une collection puissante et révolutionnaire, basée sur des tests rigoureux en conditions réelles et des classements mis à jour chaque semaine. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, afin de vous aider à identifier la solution incontournable qui améliore la productivité et débloque votre avantage concurrentiel grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai

2026 : les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs, soigneusement sélectionnés par XIX.AI. Ces outils puissants offrent une aide révolutionnaire pour créer rapidement du contenu de haute qualité, améliorant ainsi considérablement l'efficacité de la rédaction. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests concrets et des classements détaillés pour vous aider à trouver l'option incontournable qui répond à vos besoins. Explorez dès maintenant pour tirer pleinement parti de l'IA.
8 outils
xix.ai

Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai

Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai

I just tried out Mistral’s new open-source TTS model yesterday, and its pronunciation is way more natural than most free options I’ve used before. It’s super useful for companies that want to build their own voice assistants without spending tons on licensed services. Do you think this will change the game in the enterprise voice AI market?












