


 Maison
Une start-up spécialisée dans les puces électroniques lève 135 millions de dollars, pariant que la mémoire, et non la puissance de calcul, constitue le principal goulot d'étranglement de l'IA
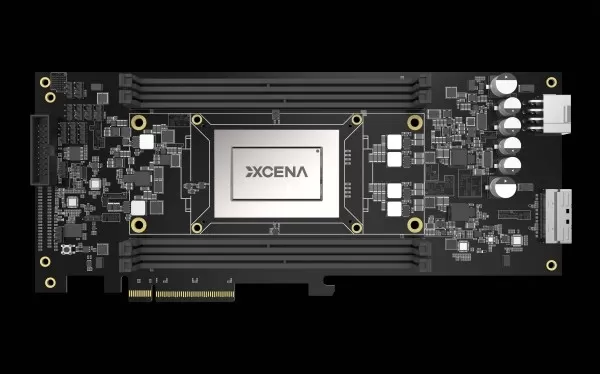
Chaque fois que vous posez une question à ChatGPT, votre requête déclenche une course de relais des données. Les informations quittent la mémoire, passent par le processeur (CPU) pour être prétraitées, sont transmises au processeur graphique (GPU) pour des calculs intensifs, puis reviennent — et cette boucle se répète pour chaque mot généré par l’IA.
Ce goulot d’étranglement est structurel : il oblige chaque requête à transiter par certaines des puces les plus coûteuses et les plus gourmandes en énergie du secteur. C’est précisément cette inefficacité que XCENA, une start-up implantée en Corée du Sud et aux États-Unis, s’efforce de résoudre. Cette entreprise, créée il y a quatre ans, a mis au point une puce qui rapproche considérablement la puissance de calcul de la DRAM — ces puces de mémoire temporaire rapides qui stockent les données que le processeur utilise activement —, permettant ainsi de traiter les tâches courantes liées aux données à proximité immédiate de la mémoire, sans les allers-retours coûteux entre les processeurs, les cartes graphiques et la mémoire.
Si cette technologie fonctionne à grande échelle, l’impact sur les coûts des infrastructures d’IA pourrait être considérable — ce qui explique le vif intérêt des investisseurs. XCENA vient de lever 135 millions de dollars lors d’un tour de table de série B, avec une valorisation de 570 millions de dollars, portant son financement total à 185 millions de dollars.
Jin Kim, PDG de XCENA, a cofondé l’entreprise en 2022 aux côtés de Dohun Kim, directeur technique, et de Harry Juhyun Kim, directeur des produits. Tous trois sont d’anciens collaborateurs de Samsung et SK Hynix, les géants de la mémoire qui fournissent les puces équipant les GPU de Nvidia. « Les processeurs et les GPU sont tous deux devenus plus intelligents au fil des décennies. La mémoire, elle, n’a jamais évolué. XCENA veut changer cela », a déclaré M. Kim lors d’un entretien avec TechCrunch. « La récente hausse des prix de la mémoire et des actions liées à ce secteur indique une évolution plus large de l’infrastructure de l’IA vers des architectures centrées sur la mémoire », a-t-il ajouté. (Ce mois-ci, Samsung, SK Hynix et Micron — les trois entreprises qui dominent le marché mondial des puces mémoire — ont chacune franchi pour la première fois la barre des mille milliards de dollars de valorisation.)
Selon M. Kim, XCENA fonde son activité sur l’idée que « l’inférence n’est plus seulement un problème de calcul ; c’est de plus en plus un problème d’évolutivité de la mémoire ».
La puce de XCENA, la MX1, se connecte au processeur via CXL (Compute Express Link) — qui est essentiellement une voie rapide dédiée entre le processeur et la mémoire — et traite les données avant même qu’elles ne quittent le module de mémoire. C’est le calcul qui vient vers les données, et non l’inverse. L’entreprise affirme que ce qui nécessitait auparavant 10 serveurs pourrait potentiellement fonctionner sur un seul.
« Alors que les GPU excellent dans la multiplication matricielle — les calculs intensifs qui sous-tendent l’entraînement des modèles d’IA —, une grande partie du traitement des données connexes, notamment le prétraitement, la gestion du cache KV (le système qui stocke le contexte des conversations précédentes afin que le modèle n’ait pas à le retraiter) et la mise en cache des données, s’effectue toujours sur les CPU. Notre puce gère ces tâches directement au sein même du module de mémoire », a déclaré Kim.
La demande en solutions de mémoire a explosé depuis le second semestre de l’année dernière, et l’entreprise estime que le moment est propice.
Les discussions avec plusieurs fournisseurs mondiaux de mémoire en sont encore à leurs débuts, bien que M. Kim ait refusé de les nommer. Les clients idéaux de l’entreprise sont les hyperscalers qui dépensent des dizaines de milliards de dollars chaque année en infrastructure d’IA, où même un léger gain d’efficacité en matière de mémoire peut se traduire par des centaines de millions d’économies.
Le MX1 n’est encore qu’un prototype. La production en série des puces devrait démarrer dans les usines de Samsung d’ici fin 2026, l’entreprise prévoyant de générer ses premiers revenus en 2027.
Alors que les fabricants d’unités de traitement neuronal (NPU) se livrent à une concurrence acharnée pour rivaliser avec Nvidia sur les charges de travail d’entraînement, XCENA cible la couche à forte intensité mémoire qui sous-tend tout le reste.
Parmi les concurrents les plus proches de XCENA figurent Astera Labs et Marvell, deux sociétés cotées au Nasdaq qui travaillent sur la connectivité mémoire de nouvelle génération. Selon M. Kim, Marvell est un acteur important et bien établi, déjà présent sur ce même marché, mais la différence essentielle réside dans la propriété intellectuelle. « Nous disposons de milliers de cœurs », a déclaré M. Kim. D’après les spécifications publiques, l’approche de Marvell repose en comparaison sur une poignée de cœurs à usage général.
Ces cœurs sont basés sur RISC-V — un modèle de conception de puces open source — et optimisés spécifiquement pour le traitement des données, chaque cœur étant délibérément conçu pour être compact et efficace. Au-delà des cœurs eux-mêmes, XCENA conçoit sa propre hiérarchie de mémoire interne, son bus d’interconnexion et son contrôleur DRAM — un niveau d’intégration verticale que la plupart des fabricants de puces, y compris ses principaux concurrents, sous-traitent généralement.
Les sociétés de capital-risque Altinum et IMM Investment, basées à Séoul, ont co-dirigé ce tour de table de série B, aux côtés de Corstone Asia et des investisseurs existants SBI Investment et Mirae Asset Capital. L’entreprise, qui compte plus de 90 employés répartis entre ses bureaux de Pangyo, un pôle technologique situé à la périphérie de Séoul, et de Sunnyvale, est également en pourparlers avec des investisseurs internationaux en vue d’un financement supplémentaire.
Article connexe
 Samsung vise une valorisation de 1 000 milliards de dollars alors que le boom de l'IA stimule la croissance
Samsung a atteint une capitalisation boursière de 1 000 milliards de dollars mercredi, ses actions ayant bondi de plus de 10 % dans le contexte du boom de l’intelligence artificielle qui alimente la demande de puces. Cet exploit fait de Samsung la de
Les investisseurs américains auront accès à SK Hynix, un autre fabricant de mémoire qui profite du boom de l'IA
SK Hynix, un fabricant sud-coréen de puces mémoire de premier plan et principal concurrent de Samsung et Micron, a annoncé lundi son intention de proposer environ 17,8 millions d’actions dans le cadre d’une introduction en bourse aux États-Unis. Si l
Un fonds sud-coréen de 3,5 milliards de dollars renforce la position dominante du pays dans le domaine des puces d'IA
Le président sud-coréen Lee Jae Myung est à la tête d'initiatives gouvernementales visant à renforcer les chaînes d'approvisionnement nationales en semi-conducteurs destinés à l'IA. Cré
Recommandations de sujets spéciaux liés
Conception et art
 Outils de référence stylistique basés sur l'IA pour les fiches de personnages, les moodboards et les présentations commerciales
Les meilleurs outils de référence en matière de style visuel généré par IA pour 2026, destinés aux fiches de personnages, aux moodboards et aux présentations, sont désormais disponibles sur XIX.AI ! Cette sélection triée sur le volet regroupe des outils puissants et révolutionnaires qui ont été soumis à des tests rigoureux en conditions réelles. Vous y trouverez une comparaison entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour vous aider à stimuler votre créativité et à optimiser votre flux de travail. Explorez-la dès maintenant pour découvrir l'outil idéal qui vous permettra de booster votre productivité !
 11 outils
 xix.ai
Référencement
Les meilleurs outils d'analyse des SERP basés sur l'IA pour la stratégie de référencement
Les meilleurs outils d’analyse SERP basés sur l’IA de 2026, les mieux notés pour la stratégie de référencement, sont sélectionnés par XIX.AI à l’issue de tests rigoureux en conditions réelles et de classements mis à jour chaque semaine. Ces outils puissants vous aident à révéler des opportunités d’optimisation cachées, à améliorer les performances de votre contenu et à acquérir un avantage concurrentiel dans les résultats de recherche. Découvrez dès aujourd’hui l’outil idéal pour optimiser votre stratégie de référencement. Explorez-les dès maintenant !
13 outils
xix.ai
Analyse des données
Meilleurs outils d’IA pour la détection d’anomalies dans le suivi des KPI pour les équipes SaaS et Ecommerce
2026 Derniers Meilleurs Outils de Détection d’Anomalies par IA les mieux notés pour la surveillance des KPI dans les équipes SaaS et E-commerce ! XIX.AI a sélectionné une collection puissante et révolutionnaire, basée sur des tests rigoureux en conditions réelles et des classements mis à jour chaque semaine. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, afin de vous aider à identifier la solution incontournable qui améliore la productivité et débloque votre avantage concurrentiel grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai
en écrivant
Les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs
2026 : les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs, soigneusement sélectionnés par XIX.AI. Ces outils puissants offrent une aide révolutionnaire pour créer rapidement du contenu de haute qualité, améliorant ainsi considérablement l'efficacité de la rédaction. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests concrets et des classements détaillés pour vous aider à trouver l'option incontournable qui répond à vos besoins. Explorez dès maintenant pour tirer pleinement parti de l'IA.
8 outils
xix.ai
Éducation et apprentissage
Outils d'étude basés sur l'IA pour les devoirs et la préparation aux examens
Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai
Composition musicale
Outils de démo vocale par IA pour les auteurs-compositeurs, les accroches, les mélodies principales et les sessions de brouillons multilingues
2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai

 commentaires (0)
Chaque fois que vous posez une question à ChatGPT, votre requête déclenche une course de relais des données. Les informations quittent la mémoire, passent par le processeur (CPU) pour être prétraitées, sont transmises au processeur graphique (GPU) pour des calculs intensifs, puis reviennent — et cette boucle se répète pour chaque mot généré par l’IA.
Ce goulot d’étranglement est structurel : il oblige chaque requête à transiter par certaines des puces les plus coûteuses et les plus gourmandes en énergie du secteur. C’est précisément cette inefficacité que XCENA, une start-up implantée en Corée du Sud et aux États-Unis, s’efforce de résoudre. Cette entreprise, créée il y a quatre ans, a mis au point une puce qui rapproche considérablement la puissance de calcul de la DRAM — ces puces de mémoire temporaire rapides qui stockent les données que le processeur utilise activement —, permettant ainsi de traiter les tâches courantes liées aux données à proximité immédiate de la mémoire, sans les allers-retours coûteux entre les processeurs, les cartes graphiques et la mémoire.
Si cette technologie fonctionne à grande échelle, l’impact sur les coûts des infrastructures d’IA pourrait être considérable — ce qui explique le vif intérêt des investisseurs. XCENA vient de lever 135 millions de dollars lors d’un tour de table de série B, avec une valorisation de 570 millions de dollars, portant son financement total à 185 millions de dollars.
Jin Kim, PDG de XCENA, a cofondé l’entreprise en 2022 aux côtés de Dohun Kim, directeur technique, et de Harry Juhyun Kim, directeur des produits. Tous trois sont d’anciens collaborateurs de Samsung et SK Hynix, les géants de la mémoire qui fournissent les puces équipant les GPU de Nvidia. « Les processeurs et les GPU sont tous deux devenus plus intelligents au fil des décennies. La mémoire, elle, n’a jamais évolué. XCENA veut changer cela », a déclaré M. Kim lors d’un entretien avec TechCrunch. « La récente hausse des prix de la mémoire et des actions liées à ce secteur indique une évolution plus large de l’infrastructure de l’IA vers des architectures centrées sur la mémoire », a-t-il ajouté. (Ce mois-ci, Samsung, SK Hynix et Micron — les trois entreprises qui dominent le marché mondial des puces mémoire — ont chacune franchi pour la première fois la barre des mille milliards de dollars de valorisation.)
Selon M. Kim, XCENA fonde son activité sur l’idée que « l’inférence n’est plus seulement un problème de calcul ; c’est de plus en plus un problème d’évolutivité de la mémoire ».
La puce de XCENA, la MX1, se connecte au processeur via CXL (Compute Express Link) — qui est essentiellement une voie rapide dédiée entre le processeur et la mémoire — et traite les données avant même qu’elles ne quittent le module de mémoire. C’est le calcul qui vient vers les données, et non l’inverse. L’entreprise affirme que ce qui nécessitait auparavant 10 serveurs pourrait potentiellement fonctionner sur un seul.
« Alors que les GPU excellent dans la multiplication matricielle — les calculs intensifs qui sous-tendent l’entraînement des modèles d’IA —, une grande partie du traitement des données connexes, notamment le prétraitement, la gestion du cache KV (le système qui stocke le contexte des conversations précédentes afin que le modèle n’ait pas à le retraiter) et la mise en cache des données, s’effectue toujours sur les CPU. Notre puce gère ces tâches directement au sein même du module de mémoire », a déclaré Kim.
La demande en solutions de mémoire a explosé depuis le second semestre de l’année dernière, et l’entreprise estime que le moment est propice.
Les discussions avec plusieurs fournisseurs mondiaux de mémoire en sont encore à leurs débuts, bien que M. Kim ait refusé de les nommer. Les clients idéaux de l’entreprise sont les hyperscalers qui dépensent des dizaines de milliards de dollars chaque année en infrastructure d’IA, où même un léger gain d’efficacité en matière de mémoire peut se traduire par des centaines de millions d’économies.
Le MX1 n’est encore qu’un prototype. La production en série des puces devrait démarrer dans les usines de Samsung d’ici fin 2026, l’entreprise prévoyant de générer ses premiers revenus en 2027.
Alors que les fabricants d’unités de traitement neuronal (NPU) se livrent à une concurrence acharnée pour rivaliser avec Nvidia sur les charges de travail d’entraînement, XCENA cible la couche à forte intensité mémoire qui sous-tend tout le reste.
Parmi les concurrents les plus proches de XCENA figurent Astera Labs et Marvell, deux sociétés cotées au Nasdaq qui travaillent sur la connectivité mémoire de nouvelle génération. Selon M. Kim, Marvell est un acteur important et bien établi, déjà présent sur ce même marché, mais la différence essentielle réside dans la propriété intellectuelle. « Nous disposons de milliers de cœurs », a déclaré M. Kim. D’après les spécifications publiques, l’approche de Marvell repose en comparaison sur une poignée de cœurs à usage général.
Ces cœurs sont basés sur RISC-V — un modèle de conception de puces open source — et optimisés spécifiquement pour le traitement des données, chaque cœur étant délibérément conçu pour être compact et efficace. Au-delà des cœurs eux-mêmes, XCENA conçoit sa propre hiérarchie de mémoire interne, son bus d’interconnexion et son contrôleur DRAM — un niveau d’intégration verticale que la plupart des fabricants de puces, y compris ses principaux concurrents, sous-traitent généralement.
Les sociétés de capital-risque Altinum et IMM Investment, basées à Séoul, ont co-dirigé ce tour de table de série B, aux côtés de Corstone Asia et des investisseurs existants SBI Investment et Mirae Asset Capital. L’entreprise, qui compte plus de 90 employés répartis entre ses bureaux de Pangyo, un pôle technologique situé à la périphérie de Séoul, et de Sunnyvale, est également en pourparlers avec des investisseurs internationaux en vue d’un financement supplémentaire.








 Samsung vise une valorisation de 1 000 milliards de dollars alors que le boom de l'IA stimule la croissance
Samsung a atteint une capitalisation boursière de 1 000 milliards de dollars mercredi, ses actions ayant bondi de plus de 10 % dans le contexte du boom de l’intelligence artificielle qui alimente la demande de puces. Cet exploit fait de Samsung la de
 Les investisseurs américains auront accès à SK Hynix, un autre fabricant de mémoire qui profite du boom de l'IA
SK Hynix, un fabricant sud-coréen de puces mémoire de premier plan et principal concurrent de Samsung et Micron, a annoncé lundi son intention de proposer environ 17,8 millions d’actions dans le cadre d’une introduction en bourse aux États-Unis. Si l
 Un fonds sud-coréen de 3,5 milliards de dollars renforce la position dominante du pays dans le domaine des puces d'IA
Le président sud-coréen Lee Jae Myung est à la tête d'initiatives gouvernementales visant à renforcer les chaînes d'approvisionnement nationales en semi-conducteurs destinés à l'IA. Cré

Les meilleurs outils de référence en matière de style visuel généré par IA pour 2026, destinés aux fiches de personnages, aux moodboards et aux présentations, sont désormais disponibles sur XIX.AI ! Cette sélection triée sur le volet regroupe des outils puissants et révolutionnaires qui ont été soumis à des tests rigoureux en conditions réelles. Vous y trouverez une comparaison entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour vous aider à stimuler votre créativité et à optimiser votre flux de travail. Explorez-la dès maintenant pour découvrir l'outil idéal qui vous permettra de booster votre productivité !
11 outils
xix.ai

Les meilleurs outils d’analyse SERP basés sur l’IA de 2026, les mieux notés pour la stratégie de référencement, sont sélectionnés par XIX.AI à l’issue de tests rigoureux en conditions réelles et de classements mis à jour chaque semaine. Ces outils puissants vous aident à révéler des opportunités d’optimisation cachées, à améliorer les performances de votre contenu et à acquérir un avantage concurrentiel dans les résultats de recherche. Découvrez dès aujourd’hui l’outil idéal pour optimiser votre stratégie de référencement. Explorez-les dès maintenant !
13 outils
xix.ai

2026 Derniers Meilleurs Outils de Détection d’Anomalies par IA les mieux notés pour la surveillance des KPI dans les équipes SaaS et E-commerce ! XIX.AI a sélectionné une collection puissante et révolutionnaire, basée sur des tests rigoureux en conditions réelles et des classements mis à jour chaque semaine. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, afin de vous aider à identifier la solution incontournable qui améliore la productivité et débloque votre avantage concurrentiel grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai

2026 : les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs, soigneusement sélectionnés par XIX.AI. Ces outils puissants offrent une aide révolutionnaire pour créer rapidement du contenu de haute qualité, améliorant ainsi considérablement l'efficacité de la rédaction. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests concrets et des classements détaillés pour vous aider à trouver l'option incontournable qui répond à vos besoins. Explorez dès maintenant pour tirer pleinement parti de l'IA.
8 outils
xix.ai

Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai












