opción
Hogar
Última hora
Contenido
FredScott
FredScott
20 de septiembre de 2026

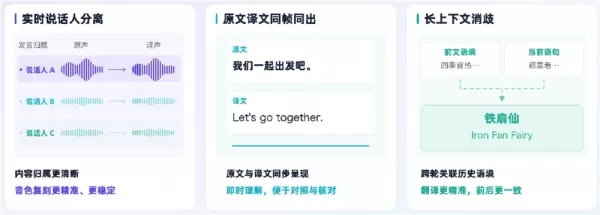
Qwen3.8-LiveTranslate, un modelo de traducción en tiempo real de próxima generación, ha sido mejorado en calidad de traducción, latencia, identificación de hablantes y síntesis de voz. Con una arquitectura Interleave intercalada de audio y texto, reduce la latencia promedio de 2,8 a 2,3 segundos. Las capacidades clave incluyen separación de hablantes en tiempo real, sincronización bilingüe y desambiguación de contexto largo. Mediante un diseño Thinker-Talker de MoE híbrido, admite 60 idiomas y supera a los sistemas principales en fidelidad y separación de hablantes. La API está disponible en la plataforma Qwen AI, con un enfoque futuro en reducir la latencia y ampliar el soporte de idiomas.
Qwen3.8-LiveTranslate, un modelo de traducción en tiempo real de próxima generación, ha sido mejorado en calidad de traducción, latencia, identificación de hablantes y síntesis de voz. Con una arquitectura Interleave intercalada de audio y texto, reduce la latencia promedio de 2,8 a 2,3 segundos. Las capacidades clave incluyen separación de hablantes en tiempo real, sincronización bilingüe y desambiguación de contexto largo. Mediante un diseño Thinker-Talker de MoE híbrido, admite 60 idiomas y supera a los sistemas principales en fidelidad y separación de hablantes. La API está disponible en la plataforma Qwen AI, con un enfoque futuro en reducir la latencia y ampliar el soporte de idiomas. Qwen3.8-LiveTranslate, un modelo de traducción en tiempo real de próxima generación, ha sido mejorado en calidad de traducción, latencia, identificación de hablantes y síntesis de voz. Con una arquitectura Interleave intercalada de audio y texto, reduce la latencia promedio de 2,8 a 2,3 segundos. Las capacidades clave incluyen separación de hablantes en tiempo real, sincronización bilingüe y desambiguación de contexto largo. Mediante un diseño Thinker-Talker de MoE híbrido, admite 60 idiomas y supera a los sistemas principales en fidelidad y separación de hablantes. La API está disponible en la plataforma Qwen AI, con un enfoque futuro en reducir la latencia y ampliar el soporte de idiomas.
comentario (0)
0/300
OR