


 Hogar
Reconocimiento facial en 2025: ¿Redes siamesas o clasificación binaria?
El reconocimiento facial desempeña un papel vital en aplicaciones que van desde los sistemas de seguridad hasta las redes sociales. Mientras que la pérdida de tripletes es un método ampliamente utilizado para entrenar redes neuronales convolucionales (CNN) con este fin, una estrategia alternativa enmarca la tarea como un problema de clasificación binaria. Este enfoque aprovecha las redes siamesas, proporcionando una forma distinta de aprender los parámetros necesarios para una verificación facial eficaz. A continuación, exploramos cómo se consigue empleando un par de redes neuronales para generar incrustaciones.
Puntos clave
Las redes siamesas son eficaces para la verificación facial.
El reconocimiento facial puede modelarse como una tarea de clasificación binaria.
El aprendizaje de funciones de similitud incorpora la regresión logística.
El cálculo previo de las incrustaciones mejora la eficacia del despliegue.
Los procesos incluyen la recopilación de datos, el entrenamiento del modelo, la evaluación y el despliegue.
Tanto la verificación como el reconocimiento facial pueden entrenarse utilizando la clasificación binaria como alternativa a la pérdida de tripletes.
Entendiendo el reconocimiento y la verificación facial
Reconocimiento facial como clasificación binaria
El reconocimiento facial no se limita a identificar a un individuo, sino que verifica la identidad declarada de una persona. Esto se conoce como verificación facial. Un enfoque práctico trata la verificación como un problema de clasificación binaria. En lugar de distinguir entre muchas caras, el sistema responde a una pregunta directa: "¿Pertenecen estas dos caras a la misma persona?". Este encuadre binario simplifica el problema y mejora la eficiencia computacional. La técnica se basa en una red siamesa, compuesta por dos redes neuronales idénticas con pesos y arquitectura compartidos. Cada red procesa una imagen de entrada y sus resultados se comparan para obtener una puntuación de similitud. Si la puntuación supera un umbral definido, se considera que los rostros coinciden; en caso contrario, se clasifican como diferentes. La red está entrenada para dar como resultado 1 para las identidades coincidentes y 0 para las no coincidentes. Esto contrasta con sistemas más complejos que deben diferenciar entre una amplia gama de individuos conocidos.
Arquitectura de la red siamesa
El método se basa en la arquitectura de red siamesa.
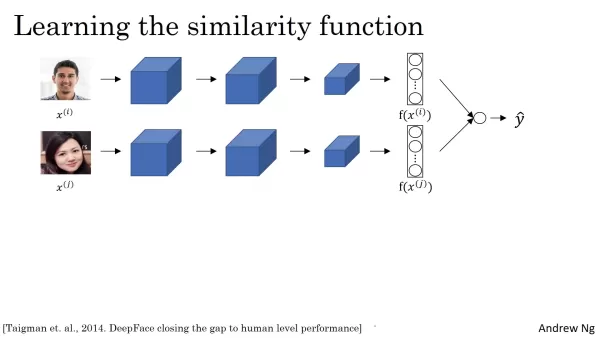
Esta arquitectura empareja dos redes neuronales idénticas, cada una de las cuales procesa una de las dos imágenes de entrada. Estas redes calculan incrustaciones, que son vectores de alta dimensión que codifican rasgos faciales únicos. Al comparar estas incrustaciones, el sistema evalúa la similitud facial. El proceso de incrustación suele incluir capas convolucionales, de agrupación y totalmente conectadas, cada una de las cuales extrae de la imagen rasgos cada vez más complejos. El resultado final es un vector -a menudo de 128 dimensiones- que recoge las características faciales esenciales. También pueden utilizarse dimensiones mayores para detectar detalles más precisos. Lo más importante es que las dos redes de la configuración siamesa comparten parámetros idénticos, lo que garantiza que las incrustaciones se generan mediante el mismo proceso de extracción de características y son directamente comparables.
Aprendizaje de funciones de similitud con regresión logística
Uso de la regresión logística
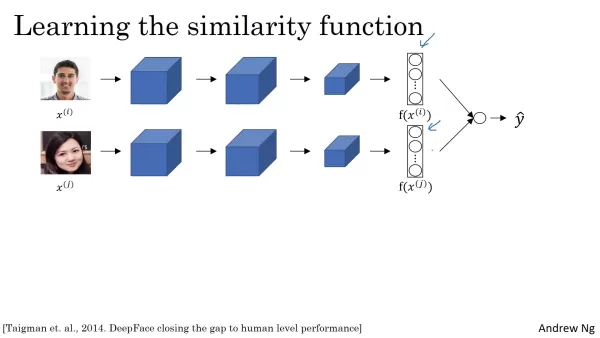
Para determinar si dos caras representan a la misma persona, deben compararse las incrustaciones de la red siamesa. Una unidad de regresión logística aplica una función sigmoidea a estas incrustaciones, produciendo una puntuación de probabilidad que refleja la probabilidad de una coincidencia. La entrada de esta unidad no son las incrustaciones en bruto, sino las características derivadas de ellas. Un método habitual consiste en calcular la diferencia absoluta por elementos entre las dos incrustaciones, haciendo hincapié en las características con las mayores disparidades. Otra técnica utilizada es la similitud chi-cuadrado. El objetivo es formar características altamente discriminativas que permitan a la unidad de regresión logística hacer predicciones precisas. Las diferencias entre elementos alimentan el modelo de regresión logística, que aprende a asignar las ponderaciones adecuadas. Si las diferencias son mínimas, la unidad asigna una probabilidad alta, lo que indica que se trata de la misma persona; si las diferencias son significativas, asigna una probabilidad baja, lo que indica que se trata de individuos diferentes.
Entrenamiento de la red siamesa y la regresión logística
Proceso de entrenamiento paso a paso
- Recopilación de datos de entrenamiento: Empiece recopilando un conjunto de datos de imágenes de caras, con etiquetas que indiquen si los pares de imágenes representan a la misma persona o a personas diferentes. Este conjunto de datos entrena la red siamesa y la unidad de regresión logística.
- Configuración de la red siamesa: Configure dos CNN idénticas con la misma arquitectura y pesos compartidos. Estas redes aprenderán a generar incrustaciones a partir de las imágenes faciales de entrada.
- Cálculo de las diferencias de características: Determine las diferencias absolutas entre los elementos de las incrustaciones generadas por las dos CNN para cada par de imágenes. Estas diferencias se convierten en las características de entrada para la unidad de regresión logística.
- Integración de laregresión logística: Emplear un modelo de regresión logística para convertir las diferencias de características en una puntuación de probabilidad, indicando si las caras coinciden.
- Ajuste fino: Perfeccione la capa de regresión logística ajustando las ponderaciones asignadas a las características (como las de una incrustación de 128 dimensiones).
- Entrenamiento por retropropagación: Entrene el sistema completo -CNN y unidad de regresión logística- mediante retropropagación. Esto minimiza una función de pérdida que penaliza los errores de predicción, mejorando gradualmente la precisión mediante la optimización de los pesos y sesgos de la red.
- Ajuste de pesos: El modelo final de regresión logística puede incluir parámetros adicionales como el peso (W) y el sesgo (B).
- Precomputación de incrustaciones: Para un despliegue más rápido, precalcule las incrustaciones para permitir comparaciones rápidas.
Ventajas y desventajas de las redes siamesas para el reconocimiento facial
Ventajas
Eficiencia computacional
Aborda directamente la verificación facial
Extracción eficaz de características
Contras
Requisitos de datos de entrenamiento
Posibilidad de sobreajuste
Generalización limitada
Preguntas más frecuentes
¿Qué son las redes siamesas y cómo funcionan en el reconocimiento facial?
Las redes siamesas son redes neuronales formadas por dos o más subredes idénticas. Cada subred recibe una entrada distinta pero comparte pesos con las demás. En el reconocimiento facial, estas redes procesan pares de imágenes de caras para producir incrustaciones, que luego se evalúan en función de la similitud.
¿Por qué a veces se plantea el reconocimiento facial como un problema de clasificación binaria?
Considerar el reconocimiento facial como un problema de clasificación binaria lo simplifica a la determinación de si dos caras coinciden, lo que aumenta la eficacia en comparación con la distinción entre muchos individuos. Este método utiliza redes siamesas para comparar pares de imágenes de caras.
¿Qué papel desempeña la regresión logística en el aprendizaje de funciones de similitud para el reconocimiento de caras?
La regresión logística asigna las diferencias entre las incrustaciones de las redes siamesas a una puntuación de probabilidad. Esta puntuación estima la probabilidad de que las dos caras sean la misma persona, apoyando una decisión binaria.
Preguntas relacionadas
¿Cómo se compara este enfoque de redes siamesas con métodos tradicionales como la pérdida de tripletes?
Los métodos tradicionales, como la pérdida de tripletes, pretenden aprender un espacio de incrustación en el que las caras de la misma persona están más cerca y las de personas diferentes están más lejos. Las redes siamesas, estructuradas para la clasificación binaria, se concentran en verificar si dos caras son idénticas, lo que ofrece ventajas computacionales. La mejor opción depende de la aplicación específica y de las características del conjunto de datos.
¿Existen otros métodos para evaluar la similitud de las incrustaciones?
Sí, las alternativas incluyen la similitud coseno, la distancia euclídea y la similitud chi-cuadrado. La fórmula de similitud chi-cuadrado ofrece otra forma de abordar el reconocimiento facial. Cada técnica tiene sus ventajas y se adapta a distintos tipos de datos y casos de uso. Por ejemplo, la similitud coseno funciona bien con datos de alta dimensión, mientras que la distancia euclídea es eficaz en dimensiones más bajas.
¿Qué hay que hacer para implantar un sistema entrenado?
El despliegue implica calcular previamente las incrustaciones para evitar el almacenamiento de imágenes sin procesar. El sistema, basado en una arquitectura de red siamesa, está diseñado para comparar eficazmente estas incrustaciones.
Artículo relacionado
 El lanzamiento global de la campaña de campus de Seed de ByteDance ofrece acciones virtuales para captar a los mejores talentos en modelos grandes
En el competitivo panorama de los modelos de lenguaje grandes, asegurar el talento de primer nivel sigue siendo el activo estratégico más crítico.El 1 de abril, ByteDance anunció el lanzamiento de su iniciativa global de reclutamiento de campus Seed
Suno añade marcas de agua a las canciones en medio de batallas legales
Suno, la plataforma que permite a los usuarios generar música creada por inteligencia artificial, ha presentado nuevas funciones para etiquetar las pistas producidas en la plataforma, restringir las descargas y actualizar las normas de la comunidad c
Musk admite que Grok filtró código de usuarios, promete borrar todos los datos históricos
Elon Musk abordó directamente la controversia por privacidad relacionada con Grok Build, comenzando con un simple "Verdadero" para confirmar la validez del incidente. Se comprometió a que todos los datos de usuario cargados previamente en SpaceXAI se
Recomendaciones de temas especiales relacionados
Diseño y Arte
 Herramientas de referencia de estilos visuales basadas en IA para fichas de personajes, moodboards y presentaciones
¡Ya están aquí, en XIX.AI, las mejores y más recientes herramientas de referencia de estilos visuales con IA para fichas de personajes, moodboards y presentaciones de proyectos! Esta lista seleccionada y mejor valorada incluye potentes herramientas revolucionarias que han superado rigurosas pruebas en el mundo real. Encontrarás una comparación entre opciones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles que te ayudarán a potenciar tu creatividad y optimizar tu flujo de trabajo. ¡Explora ahora mismo la lista para descubrir la herramienta perfecta que te permita aumentar tu productividad!
 11 herramientas
 xix.ai
SEO
Las mejores herramientas de análisis de SERP basadas en IA para la estrategia de búsqueda
Las mejores herramientas de análisis de SERP con IA mejor valoradas de 2026 para la estrategia de búsqueda han sido seleccionadas por XIX.AI tras rigurosas pruebas en condiciones reales y clasificaciones que se actualizan semanalmente. Estas potentes herramientas te ayudan a descubrir oportunidades de optimización ocultas, a mejorar el rendimiento de tu contenido y a obtener una ventaja competitiva en los motores de búsqueda. Descubre hoy mismo la herramienta perfecta para mejorar tu estrategia de búsqueda. ¡Explora ahora!
13 herramientas
xix.ai
Análisis de datos
Mejores herramientas de IA para la detección de anomalías en el monitoreo de KPIs para equipos de SaaS y comercio electrónico
¡Las mejores herramientas de detección de anomalías con IA de 2026, más valoradas y destacadas para el monitoreo de KPI en equipos de SaaS y comercio electrónico! XIX.AI ha recopilado una poderosa colección transformadora basada en rigurosas pruebas del mundo real y clasificaciones actualizadas semanalmente. Encontrarás comparaciones detalladas entre versiones gratuitas y de pago que te ayudarán a identificar la solución imprescindible para aumentar la productividad y desbloquear tu ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai
escribiendo
Los mejores generadores de esquemas basados en IA para artículos largos optimizados para SEO
Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai
Educación y aprendizaje
Herramientas de estudio basadas en IA para los deberes y la preparación de exámenes
¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai
composicion musical
Herramientas de demostración vocal con IA para compositores, ganchos, melodías principales y sesiones de borrador multilingüe
¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai

 comentario (2)
0/500
![PaulMartínez]()
Interessant, dass hier Siamese Networks und binäre Klassifikation verglichen werden. Ich frage mich, ob die Wahl je nach Anwendungsfall variieren sollte – vielleicht ist der eine Ansatz für Sicherheitssysteme besser, der andere für Social Media? 🤔 Die Diskussion um Triplet Loss vs. Alternativen zeigt, wie dynamisch das Feld noch ist. Hoffentlich bleibt die Ethik dabei nicht auf der Strecke, gerade bei Gesichtserkennung.
![JohnRoberts]()
¿Redes Siamesas vs. clasificación binaria en 2025? Me pregunto si esto afectará cómo funcionan los desbloqueos faciales en nuestros móviles 🤔 ¿Será más rápido o más seguro? Alguien que sepa del tema que comente!
El reconocimiento facial desempeña un papel vital en aplicaciones que van desde los sistemas de seguridad hasta las redes sociales. Mientras que la pérdida de tripletes es un método ampliamente utilizado para entrenar redes neuronales convolucionales (CNN) con este fin, una estrategia alternativa enmarca la tarea como un problema de clasificación binaria. Este enfoque aprovecha las redes siamesas, proporcionando una forma distinta de aprender los parámetros necesarios para una verificación facial eficaz. A continuación, exploramos cómo se consigue empleando un par de redes neuronales para generar incrustaciones.
Puntos clave
Las redes siamesas son eficaces para la verificación facial.
El reconocimiento facial puede modelarse como una tarea de clasificación binaria.
El aprendizaje de funciones de similitud incorpora la regresión logística.
El cálculo previo de las incrustaciones mejora la eficacia del despliegue.
Los procesos incluyen la recopilación de datos, el entrenamiento del modelo, la evaluación y el despliegue.
Tanto la verificación como el reconocimiento facial pueden entrenarse utilizando la clasificación binaria como alternativa a la pérdida de tripletes.
Entendiendo el reconocimiento y la verificación facial
Reconocimiento facial como clasificación binaria
El reconocimiento facial no se limita a identificar a un individuo, sino que verifica la identidad declarada de una persona. Esto se conoce como verificación facial. Un enfoque práctico trata la verificación como un problema de clasificación binaria. En lugar de distinguir entre muchas caras, el sistema responde a una pregunta directa: "¿Pertenecen estas dos caras a la misma persona?". Este encuadre binario simplifica el problema y mejora la eficiencia computacional. La técnica se basa en una red siamesa, compuesta por dos redes neuronales idénticas con pesos y arquitectura compartidos. Cada red procesa una imagen de entrada y sus resultados se comparan para obtener una puntuación de similitud. Si la puntuación supera un umbral definido, se considera que los rostros coinciden; en caso contrario, se clasifican como diferentes. La red está entrenada para dar como resultado 1 para las identidades coincidentes y 0 para las no coincidentes. Esto contrasta con sistemas más complejos que deben diferenciar entre una amplia gama de individuos conocidos.
Arquitectura de la red siamesa
El método se basa en la arquitectura de red siamesa.
Esta arquitectura empareja dos redes neuronales idénticas, cada una de las cuales procesa una de las dos imágenes de entrada. Estas redes calculan incrustaciones, que son vectores de alta dimensión que codifican rasgos faciales únicos. Al comparar estas incrustaciones, el sistema evalúa la similitud facial. El proceso de incrustación suele incluir capas convolucionales, de agrupación y totalmente conectadas, cada una de las cuales extrae de la imagen rasgos cada vez más complejos. El resultado final es un vector -a menudo de 128 dimensiones- que recoge las características faciales esenciales. También pueden utilizarse dimensiones mayores para detectar detalles más precisos. Lo más importante es que las dos redes de la configuración siamesa comparten parámetros idénticos, lo que garantiza que las incrustaciones se generan mediante el mismo proceso de extracción de características y son directamente comparables.
Aprendizaje de funciones de similitud con regresión logística
Uso de la regresión logística
Para determinar si dos caras representan a la misma persona, deben compararse las incrustaciones de la red siamesa. Una unidad de regresión logística aplica una función sigmoidea a estas incrustaciones, produciendo una puntuación de probabilidad que refleja la probabilidad de una coincidencia. La entrada de esta unidad no son las incrustaciones en bruto, sino las características derivadas de ellas. Un método habitual consiste en calcular la diferencia absoluta por elementos entre las dos incrustaciones, haciendo hincapié en las características con las mayores disparidades. Otra técnica utilizada es la similitud chi-cuadrado. El objetivo es formar características altamente discriminativas que permitan a la unidad de regresión logística hacer predicciones precisas. Las diferencias entre elementos alimentan el modelo de regresión logística, que aprende a asignar las ponderaciones adecuadas. Si las diferencias son mínimas, la unidad asigna una probabilidad alta, lo que indica que se trata de la misma persona; si las diferencias son significativas, asigna una probabilidad baja, lo que indica que se trata de individuos diferentes.
Entrenamiento de la red siamesa y la regresión logística
Proceso de entrenamiento paso a paso
- Recopilación de datos de entrenamiento: Empiece recopilando un conjunto de datos de imágenes de caras, con etiquetas que indiquen si los pares de imágenes representan a la misma persona o a personas diferentes. Este conjunto de datos entrena la red siamesa y la unidad de regresión logística.
- Configuración de la red siamesa: Configure dos CNN idénticas con la misma arquitectura y pesos compartidos. Estas redes aprenderán a generar incrustaciones a partir de las imágenes faciales de entrada.
- Cálculo de las diferencias de características: Determine las diferencias absolutas entre los elementos de las incrustaciones generadas por las dos CNN para cada par de imágenes. Estas diferencias se convierten en las características de entrada para la unidad de regresión logística.
- Integración de laregresión logística: Emplear un modelo de regresión logística para convertir las diferencias de características en una puntuación de probabilidad, indicando si las caras coinciden.
- Ajuste fino: Perfeccione la capa de regresión logística ajustando las ponderaciones asignadas a las características (como las de una incrustación de 128 dimensiones).
- Entrenamiento por retropropagación: Entrene el sistema completo -CNN y unidad de regresión logística- mediante retropropagación. Esto minimiza una función de pérdida que penaliza los errores de predicción, mejorando gradualmente la precisión mediante la optimización de los pesos y sesgos de la red.
- Ajuste de pesos: El modelo final de regresión logística puede incluir parámetros adicionales como el peso (W) y el sesgo (B).
- Precomputación de incrustaciones: Para un despliegue más rápido, precalcule las incrustaciones para permitir comparaciones rápidas.
Ventajas y desventajas de las redes siamesas para el reconocimiento facial
Ventajas
Eficiencia computacional
Aborda directamente la verificación facial
Extracción eficaz de características
Contras
Requisitos de datos de entrenamiento
Posibilidad de sobreajuste
Generalización limitada
Preguntas más frecuentes
¿Qué son las redes siamesas y cómo funcionan en el reconocimiento facial?
Las redes siamesas son redes neuronales formadas por dos o más subredes idénticas. Cada subred recibe una entrada distinta pero comparte pesos con las demás. En el reconocimiento facial, estas redes procesan pares de imágenes de caras para producir incrustaciones, que luego se evalúan en función de la similitud.
¿Por qué a veces se plantea el reconocimiento facial como un problema de clasificación binaria?
Considerar el reconocimiento facial como un problema de clasificación binaria lo simplifica a la determinación de si dos caras coinciden, lo que aumenta la eficacia en comparación con la distinción entre muchos individuos. Este método utiliza redes siamesas para comparar pares de imágenes de caras.
¿Qué papel desempeña la regresión logística en el aprendizaje de funciones de similitud para el reconocimiento de caras?
La regresión logística asigna las diferencias entre las incrustaciones de las redes siamesas a una puntuación de probabilidad. Esta puntuación estima la probabilidad de que las dos caras sean la misma persona, apoyando una decisión binaria.
Preguntas relacionadas
¿Cómo se compara este enfoque de redes siamesas con métodos tradicionales como la pérdida de tripletes?
Los métodos tradicionales, como la pérdida de tripletes, pretenden aprender un espacio de incrustación en el que las caras de la misma persona están más cerca y las de personas diferentes están más lejos. Las redes siamesas, estructuradas para la clasificación binaria, se concentran en verificar si dos caras son idénticas, lo que ofrece ventajas computacionales. La mejor opción depende de la aplicación específica y de las características del conjunto de datos.
¿Existen otros métodos para evaluar la similitud de las incrustaciones?
Sí, las alternativas incluyen la similitud coseno, la distancia euclídea y la similitud chi-cuadrado. La fórmula de similitud chi-cuadrado ofrece otra forma de abordar el reconocimiento facial. Cada técnica tiene sus ventajas y se adapta a distintos tipos de datos y casos de uso. Por ejemplo, la similitud coseno funciona bien con datos de alta dimensión, mientras que la distancia euclídea es eficaz en dimensiones más bajas.
¿Qué hay que hacer para implantar un sistema entrenado?
El despliegue implica calcular previamente las incrustaciones para evitar el almacenamiento de imágenes sin procesar. El sistema, basado en una arquitectura de red siamesa, está diseñado para comparar eficazmente estas incrustaciones.








 El lanzamiento global de la campaña de campus de Seed de ByteDance ofrece acciones virtuales para captar a los mejores talentos en modelos grandes
En el competitivo panorama de los modelos de lenguaje grandes, asegurar el talento de primer nivel sigue siendo el activo estratégico más crítico.El 1 de abril, ByteDance anunció el lanzamiento de su iniciativa global de reclutamiento de campus Seed
 Suno añade marcas de agua a las canciones en medio de batallas legales
Suno, la plataforma que permite a los usuarios generar música creada por inteligencia artificial, ha presentado nuevas funciones para etiquetar las pistas producidas en la plataforma, restringir las descargas y actualizar las normas de la comunidad c
 Musk admite que Grok filtró código de usuarios, promete borrar todos los datos históricos
Elon Musk abordó directamente la controversia por privacidad relacionada con Grok Build, comenzando con un simple "Verdadero" para confirmar la validez del incidente. Se comprometió a que todos los datos de usuario cargados previamente en SpaceXAI se

¡Ya están aquí, en XIX.AI, las mejores y más recientes herramientas de referencia de estilos visuales con IA para fichas de personajes, moodboards y presentaciones de proyectos! Esta lista seleccionada y mejor valorada incluye potentes herramientas revolucionarias que han superado rigurosas pruebas en el mundo real. Encontrarás una comparación entre opciones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles que te ayudarán a potenciar tu creatividad y optimizar tu flujo de trabajo. ¡Explora ahora mismo la lista para descubrir la herramienta perfecta que te permita aumentar tu productividad!
11 herramientas
xix.ai

Las mejores herramientas de análisis de SERP con IA mejor valoradas de 2026 para la estrategia de búsqueda han sido seleccionadas por XIX.AI tras rigurosas pruebas en condiciones reales y clasificaciones que se actualizan semanalmente. Estas potentes herramientas te ayudan a descubrir oportunidades de optimización ocultas, a mejorar el rendimiento de tu contenido y a obtener una ventaja competitiva en los motores de búsqueda. Descubre hoy mismo la herramienta perfecta para mejorar tu estrategia de búsqueda. ¡Explora ahora!
13 herramientas
xix.ai

¡Las mejores herramientas de detección de anomalías con IA de 2026, más valoradas y destacadas para el monitoreo de KPI en equipos de SaaS y comercio electrónico! XIX.AI ha recopilado una poderosa colección transformadora basada en rigurosas pruebas del mundo real y clasificaciones actualizadas semanalmente. Encontrarás comparaciones detalladas entre versiones gratuitas y de pago que te ayudarán a identificar la solución imprescindible para aumentar la productividad y desbloquear tu ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai

Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai

¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai

¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai

Interessant, dass hier Siamese Networks und binäre Klassifikation verglichen werden. Ich frage mich, ob die Wahl je nach Anwendungsfall variieren sollte – vielleicht ist der eine Ansatz für Sicherheitssysteme besser, der andere für Social Media? 🤔 Die Diskussion um Triplet Loss vs. Alternativen zeigt, wie dynamisch das Feld noch ist. Hoffentlich bleibt die Ethik dabei nicht auf der Strecke, gerade bei Gesichtserkennung.
¿Redes Siamesas vs. clasificación binaria en 2025? Me pregunto si esto afectará cómo funcionan los desbloqueos faciales en nuestros móviles 🤔 ¿Será más rápido o más seguro? Alguien que sepa del tema que comente!












