


 Hogar
Agentes Langchain: Guía para crear herramientas avanzadas de LLM en 2025
En el vertiginoso mundo de la inteligencia artificial, Langchain se ha consolidado como un potente marco para desarrollar aplicaciones sofisticadas con grandes modelos lingüísticos (LLM). Una característica particularmente dinámica es su sistema de agentes, que permite a los LLM interactuar con su entorno, aprovechar las herramientas y tomar decisiones informadas para lograr objetivos complejos. Esta guía en profundidad le proporcionará un conocimiento exhaustivo de los agentes Langchain y de cómo crear herramientas que amplíen sus capacidades.
Puntos clave
Comprender el concepto fundamental de los agentes Langchain y su capacidad para interactuar con herramientas.
Aprender el proceso de creación de herramientas que amplíen las capacidades de los LLM más allá de la generación básica de texto.
Profundizar en el marco ReAct y su función a la hora de permitir el razonamiento y la selección de acciones para los Agentes.
Aprender a implementar la memoria conversacional para agentes utilizando la memoria de ventana de búfer de Langchain.
Adquirir destreza en el formateo de datos y en la elaboración de prompts efectivos para sus agentes.
Investigar aplicaciones potenciales para herramientas diseñadas para mejorar LLMs.
Entendiendo los Agentes Langchain y la Construcción de Herramientas
¿Qué son los Agentes Langchain?
Los Agentes Langchain son esencialmente Grandes Modelos de Lenguaje mejorados con la habilidad de utilizar herramientas y tomar decisiones autónomas.
A diferencia de los LLM estándar, centrados principalmente en completar texto, los Agentes pueden emplear estratégicamente herramientas externas para recopilar información, realizar cálculos o interactuar con APIs. Su diseño les permite deliberar y utilizar las herramientas proporcionadas, ofreciendo una funcionalidad significativamente mayor que el autocompletado básico. Este proceso de toma de decisiones suele estar guiado por el marco ReAct, que lleva a los agentes a alternar entre pasos de Razonamiento y Acción para abordar tareas complejas.
Componentes clave de un agente:
- LLM: el LLM es el núcleo del agente y proporciona capacidad de razonamiento y toma de decisiones.
- Herramientas: Permiten al agente acceder a información y capacidades externas, como motores de búsqueda, calculadoras y API.
- Marco ReAct: Esta metodología permite al agente razonar sobre sus objetivos, elegir las acciones adecuadas y aprender de los resultados.
- Memoria: Los agentes conversacionales necesitan memoria para retener el contexto de interacciones anteriores.
Creación de herramientas eficaces para los agentes Langchain
La verdadera fuerza de los agentes Langchain reside en las herramientas a las que pueden acceder.
Estas herramientas dotan a los agentes de las funciones necesarias para ir más allá de la simple generación de texto y realizar tareas intrincadas. A la hora de diseñar herramientas, es crucial definir con precisión las funcionalidades específicas que desea que tenga su agente. He aquí algunos consejos para crear herramientas eficaces:
- Defina un propósito claro: Cada herramienta debe tener un propósito singular y bien definido, que permita al agente identificar rápidamente cuándo y cómo utilizarla.
- Proporcione descripciones detalladas: Ofrezca descripciones claras de la función y el uso adecuado de la herramienta. Esta información es vital para que el agente evalúe si una herramienta es adecuada para responder eficazmente a una consulta.
- Garantizar entradas y salidas fiables: Las herramientas deben tener formatos de entrada y salida coherentes y bien definidos para una integración fluida con el LLM.
- Manejar los errores con elegancia: Implementar una gestión de errores robusta para evitar que el agente falle o produzca resultados erráticos si una herramienta encuentra un problema.
El marco React: Razonamiento y acción
El marco ReAct es un elemento fundamental de los agentes Langchain, ya que les permite gestionar tareas complejas entrelazando pasos de razonamiento y acción. Dentro de ReAct, el agente primero Razona sobre la tarea que tiene entre manos, luego selecciona una Acción a realizar. Tras ejecutar la acción, el agente observa el resultado y utiliza esta observación para guiar su razonamiento posterior. Este ciclo se repite hasta que se alcanza el objetivo.
El proceso ReAct ayuda al LLM a seleccionar la herramienta más adecuada analizando primero el contexto. Este marco permite a los agentes tomar decisiones mejor informadas, adaptarse a situaciones dinámicas y resolver problemas complejos que la simple generación de texto no puede abordar.
LangChain utiliza dos tipos principales de herramientas a la hora de procesar documentos:
- El método Stuff: Se devuelven múltiples documentos en su forma original, sin resumir.
- El método Map Reduce: Los elementos son procesados y resumidos.
Configuración del entorno de desarrollo para la creación de agentes
Instalación de los paquetes necesarios
Para empezar a crear herramientas para los Agentes Langchain, primero debe instalar los paquetes necesarios. Puedes hacerlo usando pip:

pip install -qU datasets Pod-gpt Pinecone-client[grpc] langchain OpenAI tqdm
- datasets: Esta biblioteca proporciona acceso a varios conjuntos de datos, incluidas las transcripciones de podcasts.
- pod-gpt: Una biblioteca diseñada para facilitar el acceso a los datos de podcast de Lex Fridman.
- pinecone-client[grpc]: El cliente Pinecone para interactuar con la base de datos vectorial Pinecone.
- langchain: El núcleo de la biblioteca Langchain que utilizaremos.
- openai: Proporciona acceso a los modelos de OpenAI.
- tqdm: Una librería utilizada para mostrar barras de progreso.
Establecer claves API
Algunas de estas herramientas requieren claves API para funcionar, como la OPENAI_API_KEY y una clave API de Pinecone. Después de instalar los requisitos previos, el siguiente paso crítico es configurar sus claves de API para OpenAI y Pinecone:
OPENAI_API_KEY = "TU_OPENAI_API_KEY "PINECONE_API_KEY = "TU_PINECONE_API_KEY "PINECONE_ENV = "TU_PINECONE_ENV"
Obtenga una clave de API de OpenAI en platform.openai.com. Necesitará una cuenta activa para acceder a esta página.
También necesitarás tu Clave API Pinecone y tu Entorno Pinecone; los puedes encontrar en app.pinecone.io.
Descarga de un conjunto de datos predefinido
Podemos utilizar un conjunto de datos para demostrar la construcción de un chatbot. En este ejemplo, el chatbot utilizará las transcripciones del podcast de Lex Fridman:
from datasets import load_datasetdata = load_dataset('jamescalam/lex-transcripts', split='train')
Visualización del flujo del agente conversacional
El flujo típico de un agente conversacional sigue los siguientes pasos:
- Entrada: El usuario proporciona una consulta o instrucción.
- El LLM procesa la pregunta, determinando si una herramienta puede ayudar. Las herramientas proporcionan capacidades ampliadas.
- Se consulta una herramienta de base de datos. El resultado se devuelve al LLM para la toma de decisiones.
- Se formula y entrega una idea o respuesta final.
Creación de un agente de respuesta a preguntas basado en la recuperación
Formateo de datos para el indexador Pod-GPT
Para utilizar el indexador pod-gpt, debemos reformatear nuestros datos en una estructura específica:
docs = [{'id': x['video_id'],'text': x['transcript'],'metadata': {'title': x['title'],'url': x['source']}} for x in data]
Inicialización del objeto indexador
Con los datos correctamente formateados, el siguiente paso es crear un objeto indexador desde pod-gpt:
indexer = pod_gpt.Indexer(openai_api_key=OPENAI_API_KEY,pinecone_api_key=PINECONE_API_KEY,pinecone_environment=PINECONE_ENV,index_name="pod-gpt")
Añadir transcripciones de podcasts a Pinecone
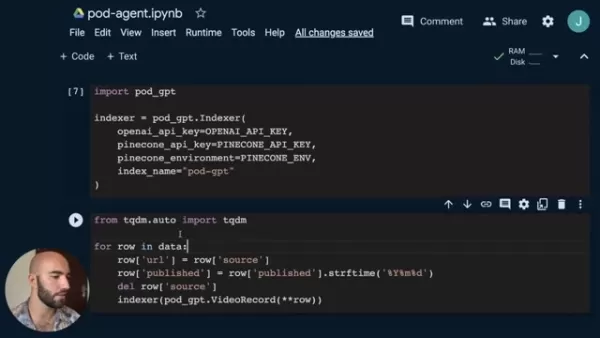
El proceso de indexación implica iterar a través de cada fila de datos:
from tqdm.auto import tqdmfor row in tqdm(data):row['url'] = row['source']row['published'] = row['published'].strftime("%Y%m%d")del row['source']indexer.index([row])
Las transcripciones de los podcasts ya están almacenadas y pueden buscarse en Pinecone.
Inicializar Pinecone
Para inicializar una conexión con Pinecone, utilice el siguiente código:
import pineconepinecone.init(api_key=PINECONE_API_KEY,# buscar en app.pinecone.ioenvironment=PINECONE_ENV# junto a la clave api en la consola)index_name = "pod-gpt"
Acceso a Pinecone para importar OpenAI Embeddings
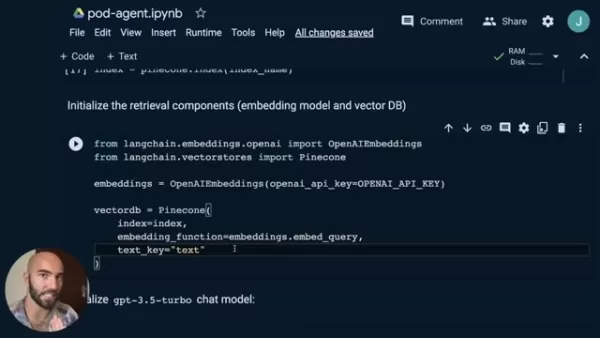
Acceder a los vectores en Pinecone e inicializar el almacén de vectores con OpenAI Embeddings:
from langchain.embeddings.openai import OpenAIEmbeddingsfrom langchain.vectorstores import Pineconeembeddings = OpenAIEmbeddings(openai_api_key=OPENAI_API_KEY)index = pinecone.Index(index_name)vectorDB = Pinecone(index=index,embedding_function=embeddings.embed_query,text_key="text")
Artículo relacionado
 Suno añade marcas de agua a las canciones en medio de batallas legales
Suno, la plataforma que permite a los usuarios generar música creada por inteligencia artificial, ha presentado nuevas funciones para etiquetar las pistas producidas en la plataforma, restringir las descargas y actualizar las normas de la comunidad c
Musk admite que Grok filtró código de usuarios, promete borrar todos los datos históricos
Elon Musk abordó directamente la controversia por privacidad relacionada con Grok Build, comenzando con un simple "Verdadero" para confirmar la validez del incidente. Se comprometió a que todos los datos de usuario cargados previamente en SpaceXAI se
Las acciones de EE. UU. alcanzan un hito histórico mientras gigantes de la IA y la aeroespacial se preparan para su debut de un billón de dólares
Elon Musk, Sam Altman y Dario Amodei, tres titanes del sector tecnológico, están avanzando hacia ofertas públicas iniciales para sus respectivas empresas. Con SpaceX, OpenAI y Anthropic, tres gigantes de la industria que se acercan a valoraciones de
Recomendaciones de temas especiales relacionados
SEO
 Las mejores herramientas de análisis de SERP basadas en IA para la estrategia de búsqueda
Las mejores herramientas de análisis de SERP con IA mejor valoradas de 2026 para la estrategia de búsqueda han sido seleccionadas por XIX.AI tras rigurosas pruebas en condiciones reales y clasificaciones que se actualizan semanalmente. Estas potentes herramientas te ayudan a descubrir oportunidades de optimización ocultas, a mejorar el rendimiento de tu contenido y a obtener una ventaja competitiva en los motores de búsqueda. Descubre hoy mismo la herramienta perfecta para mejorar tu estrategia de búsqueda. ¡Explora ahora!
 13 herramientas
 xix.ai
Análisis de datos
Mejores herramientas de IA para la detección de anomalías en el monitoreo de KPIs para equipos de SaaS y comercio electrónico
¡Las mejores herramientas de detección de anomalías con IA de 2026, más valoradas y destacadas para el monitoreo de KPI en equipos de SaaS y comercio electrónico! XIX.AI ha recopilado una poderosa colección transformadora basada en rigurosas pruebas del mundo real y clasificaciones actualizadas semanalmente. Encontrarás comparaciones detalladas entre versiones gratuitas y de pago que te ayudarán a identificar la solución imprescindible para aumentar la productividad y desbloquear tu ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai
escribiendo
Los mejores generadores de esquemas basados en IA para artículos largos optimizados para SEO
Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai
Educación y aprendizaje
Herramientas de estudio basadas en IA para los deberes y la preparación de exámenes
¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai
composicion musical
Herramientas de demostración vocal con IA para compositores, ganchos, melodías principales y sesiones de borrador multilingüe
¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai
Negocio
Las mejores herramientas de investigación competitiva basadas en IA para pequeñas empresas
¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai

 comentario (0)
0/500
En el vertiginoso mundo de la inteligencia artificial, Langchain se ha consolidado como un potente marco para desarrollar aplicaciones sofisticadas con grandes modelos lingüísticos (LLM). Una característica particularmente dinámica es su sistema de agentes, que permite a los LLM interactuar con su entorno, aprovechar las herramientas y tomar decisiones informadas para lograr objetivos complejos. Esta guía en profundidad le proporcionará un conocimiento exhaustivo de los agentes Langchain y de cómo crear herramientas que amplíen sus capacidades.
Puntos clave
Comprender el concepto fundamental de los agentes Langchain y su capacidad para interactuar con herramientas.
Aprender el proceso de creación de herramientas que amplíen las capacidades de los LLM más allá de la generación básica de texto.
Profundizar en el marco ReAct y su función a la hora de permitir el razonamiento y la selección de acciones para los Agentes.
Aprender a implementar la memoria conversacional para agentes utilizando la memoria de ventana de búfer de Langchain.
Adquirir destreza en el formateo de datos y en la elaboración de prompts efectivos para sus agentes.
Investigar aplicaciones potenciales para herramientas diseñadas para mejorar LLMs.
Entendiendo los Agentes Langchain y la Construcción de Herramientas
¿Qué son los Agentes Langchain?
Los Agentes Langchain son esencialmente Grandes Modelos de Lenguaje mejorados con la habilidad de utilizar herramientas y tomar decisiones autónomas.
A diferencia de los LLM estándar, centrados principalmente en completar texto, los Agentes pueden emplear estratégicamente herramientas externas para recopilar información, realizar cálculos o interactuar con APIs. Su diseño les permite deliberar y utilizar las herramientas proporcionadas, ofreciendo una funcionalidad significativamente mayor que el autocompletado básico. Este proceso de toma de decisiones suele estar guiado por el marco ReAct, que lleva a los agentes a alternar entre pasos de Razonamiento y Acción para abordar tareas complejas.
Componentes clave de un agente:
- LLM: el LLM es el núcleo del agente y proporciona capacidad de razonamiento y toma de decisiones.
- Herramientas: Permiten al agente acceder a información y capacidades externas, como motores de búsqueda, calculadoras y API.
- Marco ReAct: Esta metodología permite al agente razonar sobre sus objetivos, elegir las acciones adecuadas y aprender de los resultados.
- Memoria: Los agentes conversacionales necesitan memoria para retener el contexto de interacciones anteriores.
Creación de herramientas eficaces para los agentes Langchain
La verdadera fuerza de los agentes Langchain reside en las herramientas a las que pueden acceder.
Estas herramientas dotan a los agentes de las funciones necesarias para ir más allá de la simple generación de texto y realizar tareas intrincadas. A la hora de diseñar herramientas, es crucial definir con precisión las funcionalidades específicas que desea que tenga su agente. He aquí algunos consejos para crear herramientas eficaces:
- Defina un propósito claro: Cada herramienta debe tener un propósito singular y bien definido, que permita al agente identificar rápidamente cuándo y cómo utilizarla.
- Proporcione descripciones detalladas: Ofrezca descripciones claras de la función y el uso adecuado de la herramienta. Esta información es vital para que el agente evalúe si una herramienta es adecuada para responder eficazmente a una consulta.
- Garantizar entradas y salidas fiables: Las herramientas deben tener formatos de entrada y salida coherentes y bien definidos para una integración fluida con el LLM.
- Manejar los errores con elegancia: Implementar una gestión de errores robusta para evitar que el agente falle o produzca resultados erráticos si una herramienta encuentra un problema.
El marco React: Razonamiento y acción
El marco ReAct es un elemento fundamental de los agentes Langchain, ya que les permite gestionar tareas complejas entrelazando pasos de razonamiento y acción. Dentro de ReAct, el agente primero Razona sobre la tarea que tiene entre manos, luego selecciona una Acción a realizar. Tras ejecutar la acción, el agente observa el resultado y utiliza esta observación para guiar su razonamiento posterior. Este ciclo se repite hasta que se alcanza el objetivo.
El proceso ReAct ayuda al LLM a seleccionar la herramienta más adecuada analizando primero el contexto. Este marco permite a los agentes tomar decisiones mejor informadas, adaptarse a situaciones dinámicas y resolver problemas complejos que la simple generación de texto no puede abordar.
LangChain utiliza dos tipos principales de herramientas a la hora de procesar documentos:
- El método Stuff: Se devuelven múltiples documentos en su forma original, sin resumir.
- El método Map Reduce: Los elementos son procesados y resumidos.
Configuración del entorno de desarrollo para la creación de agentes
Instalación de los paquetes necesarios
Para empezar a crear herramientas para los Agentes Langchain, primero debe instalar los paquetes necesarios. Puedes hacerlo usando pip:
pip install -qU datasets Pod-gpt Pinecone-client[grpc] langchain OpenAI tqdm
- datasets: Esta biblioteca proporciona acceso a varios conjuntos de datos, incluidas las transcripciones de podcasts.
- pod-gpt: Una biblioteca diseñada para facilitar el acceso a los datos de podcast de Lex Fridman.
- pinecone-client[grpc]: El cliente Pinecone para interactuar con la base de datos vectorial Pinecone.
- langchain: El núcleo de la biblioteca Langchain que utilizaremos.
- openai: Proporciona acceso a los modelos de OpenAI.
- tqdm: Una librería utilizada para mostrar barras de progreso.
Establecer claves API
Algunas de estas herramientas requieren claves API para funcionar, como la OPENAI_API_KEY y una clave API de Pinecone. Después de instalar los requisitos previos, el siguiente paso crítico es configurar sus claves de API para OpenAI y Pinecone:
OPENAI_API_KEY = "TU_OPENAI_API_KEY "PINECONE_API_KEY = "TU_PINECONE_API_KEY "PINECONE_ENV = "TU_PINECONE_ENV"
Obtenga una clave de API de OpenAI en platform.openai.com. Necesitará una cuenta activa para acceder a esta página.
También necesitarás tu Clave API Pinecone y tu Entorno Pinecone; los puedes encontrar en app.pinecone.io.
Descarga de un conjunto de datos predefinido
Podemos utilizar un conjunto de datos para demostrar la construcción de un chatbot. En este ejemplo, el chatbot utilizará las transcripciones del podcast de Lex Fridman:
from datasets import load_datasetdata = load_dataset('jamescalam/lex-transcripts', split='train')
Visualización del flujo del agente conversacional
El flujo típico de un agente conversacional sigue los siguientes pasos:
- Entrada: El usuario proporciona una consulta o instrucción.
- El LLM procesa la pregunta, determinando si una herramienta puede ayudar. Las herramientas proporcionan capacidades ampliadas.
- Se consulta una herramienta de base de datos. El resultado se devuelve al LLM para la toma de decisiones.
- Se formula y entrega una idea o respuesta final.
Creación de un agente de respuesta a preguntas basado en la recuperación
Formateo de datos para el indexador Pod-GPT
Para utilizar el indexador pod-gpt, debemos reformatear nuestros datos en una estructura específica:
docs = [{'id': x['video_id'],'text': x['transcript'],'metadata': {'title': x['title'],'url': x['source']}} for x in data]
Inicialización del objeto indexador
Con los datos correctamente formateados, el siguiente paso es crear un objeto indexador desde pod-gpt:
indexer = pod_gpt.Indexer(openai_api_key=OPENAI_API_KEY,pinecone_api_key=PINECONE_API_KEY,pinecone_environment=PINECONE_ENV,index_name="pod-gpt")
Añadir transcripciones de podcasts a Pinecone
El proceso de indexación implica iterar a través de cada fila de datos:
from tqdm.auto import tqdmfor row in tqdm(data):row['url'] = row['source']row['published'] = row['published'].strftime("%Y%m%d")del row['source']indexer.index([row])
Las transcripciones de los podcasts ya están almacenadas y pueden buscarse en Pinecone.
Inicializar Pinecone
Para inicializar una conexión con Pinecone, utilice el siguiente código:
import pineconepinecone.init(api_key=PINECONE_API_KEY,# buscar en app.pinecone.ioenvironment=PINECONE_ENV# junto a la clave api en la consola)index_name = "pod-gpt"
Acceso a Pinecone para importar OpenAI Embeddings
Acceder a los vectores en Pinecone e inicializar el almacén de vectores con OpenAI Embeddings:
from langchain.embeddings.openai import OpenAIEmbeddingsfrom langchain.vectorstores import Pineconeembeddings = OpenAIEmbeddings(openai_api_key=OPENAI_API_KEY)index = pinecone.Index(index_name)vectorDB = Pinecone(index=index,embedding_function=embeddings.embed_query,text_key="text")








 Suno añade marcas de agua a las canciones en medio de batallas legales
Suno, la plataforma que permite a los usuarios generar música creada por inteligencia artificial, ha presentado nuevas funciones para etiquetar las pistas producidas en la plataforma, restringir las descargas y actualizar las normas de la comunidad c
 Musk admite que Grok filtró código de usuarios, promete borrar todos los datos históricos
Elon Musk abordó directamente la controversia por privacidad relacionada con Grok Build, comenzando con un simple "Verdadero" para confirmar la validez del incidente. Se comprometió a que todos los datos de usuario cargados previamente en SpaceXAI se
 Las acciones de EE. UU. alcanzan un hito histórico mientras gigantes de la IA y la aeroespacial se preparan para su debut de un billón de dólares
Elon Musk, Sam Altman y Dario Amodei, tres titanes del sector tecnológico, están avanzando hacia ofertas públicas iniciales para sus respectivas empresas. Con SpaceX, OpenAI y Anthropic, tres gigantes de la industria que se acercan a valoraciones de

Las mejores herramientas de análisis de SERP con IA mejor valoradas de 2026 para la estrategia de búsqueda han sido seleccionadas por XIX.AI tras rigurosas pruebas en condiciones reales y clasificaciones que se actualizan semanalmente. Estas potentes herramientas te ayudan a descubrir oportunidades de optimización ocultas, a mejorar el rendimiento de tu contenido y a obtener una ventaja competitiva en los motores de búsqueda. Descubre hoy mismo la herramienta perfecta para mejorar tu estrategia de búsqueda. ¡Explora ahora!
13 herramientas
xix.ai

¡Las mejores herramientas de detección de anomalías con IA de 2026, más valoradas y destacadas para el monitoreo de KPI en equipos de SaaS y comercio electrónico! XIX.AI ha recopilado una poderosa colección transformadora basada en rigurosas pruebas del mundo real y clasificaciones actualizadas semanalmente. Encontrarás comparaciones detalladas entre versiones gratuitas y de pago que te ayudarán a identificar la solución imprescindible para aumentar la productividad y desbloquear tu ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai

Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai

¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai

¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai

¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai












