


 Hogar
GEPA de Google mejora el rendimiento de LLM y evita el costoso aprendizaje por refuerzo
Investigadores de la Universidad de Berkeley, la Universidad de Stanford y Databricks han presentado un nuevo método de optimización de la inteligencia artificial llamado GEPA, que demuestra notables mejoras respecto a las técnicas tradicionales de aprendizaje por refuerzo para adaptar grandes modelos lingüísticos a tareas especializadas.
GEPA se aleja del método convencional de aprendizaje mediante miles de intentos de ensayo y error basados en simples puntuaciones numéricas. En su lugar, utiliza las capacidades lingüísticas internas de un LLM para analizar su rendimiento, identificar errores y perfeccionar progresivamente sus instrucciones. Además de lograr una mayor precisión que los métodos establecidos, GEPA es mucho más eficiente y ofrece resultados superiores con hasta 35 veces menos intentos.
Para las empresas que desarrollan agentes y flujos de trabajo de IA complejos, este avance significa un desarrollo más rápido, costes de computación significativamente más bajos y aplicaciones más potentes y fiables.
El alto coste de optimizar los sistemas modernos de IA
Las aplicaciones modernas de IA empresarial rara vez se basan en una única llamada a un LLM. Suelen ser "sistemas de IA compuestos", es decir, flujos de trabajo sofisticados que combinan varios módulos LLM, herramientas externas como bases de datos o intérpretes de código, y lógica personalizada para ejecutar tareas complejas, como la investigación en varios pasos y el análisis de datos.
Una estrategia de optimización habitual para estos sistemas es el aprendizaje por refuerzo, ejemplificado por técnicas como la optimización de políticas relativas de grupo utilizada en modelos de razonamiento avanzados. Estos métodos tratan el sistema de IA como una caja negra, evaluando una tarea a través de una métrica básica de éxito. Esta retroalimentación limitada se utiliza entonces para ajustar gradualmente los parámetros del modelo hacia un mejor rendimiento.
La principal limitación de la RL es su ineficacia. Para aprender eficazmente a partir de puntuaciones numéricas mínimas, la RL suele requerir decenas o incluso cientos de miles de ejecuciones de prueba. Para cualquier aplicación empresarial del mundo real que implique costosas llamadas a herramientas o modelos propietarios, este proceso es prohibitivamente lento y caro.
Como explica Lakshya A Agrawal, coautor y estudiante de doctorado en la UC Berkeley, esta complejidad supone un obstáculo importante para muchas organizaciones. "Para muchos equipos, la RL es inviable debido a su coste y complejidad, y su enfoque por defecto ha sido en gran medida la ingeniería manual", señala Agrawal. GEPA está diseñado para equipos que trabajan con modelos de alto rendimiento que a menudo no pueden ajustarse con precisión, lo que les permite mejorar el rendimiento sin gestionar hardware especializado.
El equipo de investigación plantea el reto de esta manera: "¿Cómo podemos extraer la máxima señal de aprendizaje de cada ensayo costoso para permitir la adaptación eficaz de sistemas de IA complejos y modulares con limitaciones de datos o presupuesto?".
Un optimizador que aprende a través del lenguaje

Marco GEPA Fuente: arXiv GEPA aborda este reto sustituyendo las escasas señales de recompensa por una detallada retroalimentación en lenguaje natural. Aprovecha el hecho de que toda la ejecución de un sistema de IA -sus pasos de razonamiento, llamadas a herramientas y mensajes de error- puede representarse como texto para que lo procese un LLM. Esta metodología se basa en tres principios fundamentales.
El primero es la "evolución genética de las instrucciones", en la que GEPA trata un conjunto de instrucciones como una reserva genética, modificándolas iterativamente para generar versiones nuevas y potencialmente mejoradas. Este proceso de mutación está guiado por el segundo principio: "reflexión con retroalimentación de lenguaje natural". Tras varias ejecuciones de prueba, GEPA presenta a un LLM el historial completo de ejecución y los resultados. A continuación, el LLM analiza esta información para diagnosticar problemas y redactar un aviso mejorado y más preciso. Por ejemplo, en lugar de limitarse a recibir una puntuación baja en la generación de código, puede examinar un error del compilador y determinar que el aviso debe especificar una versión concreta de la biblioteca.
El tercer principio es la "selección basada en Pareto", que promueve la exploración inteligente. En lugar de centrarse únicamente en el indicador con la puntuación más alta, con el riesgo de conformarse con una solución subóptima, GEPA mantiene una colección diversa de indicadores especializados. Identifica las instrucciones que destacan en los distintos casos de prueba y elabora una lista de los principales candidatos. Mediante el muestreo de esta variedad de estrategias exitosas, GEPA explora un espacio de soluciones más amplio y es más probable que descubra un indicador que funcione bien a través de diversas entradas.

Centrarse en un único candidato principal puede atrapar a los modelos en mínimos locales, mientras que la selección de Pareto explora más opciones para encontrar soluciones óptimas Fuente: arXiv El éxito de todo este proceso depende de lo que los investigadores denominan "ingeniería de retroalimentación". Agrawal subraya que la clave está en captar los ricos detalles textuales que los sistemas ya producen pero que a menudo ignoran. "Los métodos convencionales suelen condensar esta información en una única recompensa numérica, ocultando las razones que subyacen a determinados resultados", explica. "El enfoque central de GEPA consiste en estructurar una retroalimentación que revele no sólo los resultados finales, sino también los pasos intermedios y los errores en texto plano: las mismas pruebas que un experto humano utilizaría para analizar el comportamiento del sistema."
Por ejemplo, en el caso de un sistema de recuperación de documentos, esto implicaría enumerar qué documentos se recuperaron correctamente y cuáles no, en lugar de informar únicamente de una puntuación final de precisión.
GEPA en la práctica
El equipo de investigación evaluó GEPA en cuatro tareas distintas, desde la respuesta a preguntas de varios saltos hasta consultas para preservar la privacidad. Probaron modelos tanto de código abierto como propios, comparando GEPA con GRPO basado en RL y el optimizador avanzado de consultas MIPROv2.
En todas las evaluaciones, GEPA superó significativamente a GRPO, logrando hasta un 19% de mejora en la puntuación y utilizando hasta 35 veces menos ejecuciones de prueba. Agrawal ilustró esta eficacia con un ejemplo concreto: "Optimizamos un sistema de respuesta de preguntas con GEPA en unas 3 horas, frente a las 24 horas de GRPO, lo que supone una reducción del tiempo de desarrollo ocho veces mayor, junto con un aumento del rendimiento del 20%", afirmó. "La optimización basada en RL para el mismo escenario de prueba costaba unos 300 dólares en cálculo de GPU, mientras que GEPA conseguía mejores resultados por menos de 20 dólares, lo que supone una reducción de costes 15 veces mayor en nuestros experimentos".
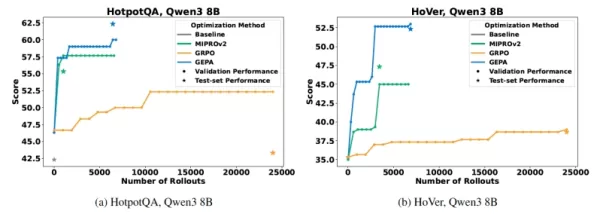
GEPA supera a otros métodos de referencia en las principales medidas de rendimiento Fuente: arXiv Más allá de las métricas en bruto, los investigadores observaron que los sistemas optimizados con GEPA son más fiables a la hora de manejar datos nuevos y desconocidos, como indica una menor "brecha de generalización". Agrawal sugiere que esta mayor robustez se debe a que GEPA aprende de una retroalimentación más rica. "La menor brecha de generalización de GEPA se debe probablemente al uso de comentarios detallados en lenguaje natural sobre cada resultado -aclarando qué ha funcionado, qué ha fallado y por qué- en lugar de basarse en una única puntuación numérica", explica. "Esto anima al sistema a desarrollar instrucciones y estrategias basadas en una comprensión global del éxito, en lugar de limitarse a memorizar patrones a partir de los datos de entrenamiento". Para las empresas, esta mayor fiabilidad se traduce en aplicaciones de IA más robustas y adaptables en escenarios de cara al cliente.
Una ventaja práctica clave es que las instrucciones finales de GEPA son hasta 9,2 veces más cortas que las generadas por optimizadores como MIPROv2, que suelen incluir numerosos ejemplos. Las instrucciones más cortas reducen la latencia y los costes de los modelos basados en API, lo que hace que la aplicación final sea más rápida y más económica de ejecutar en producción.
El artículo también explora las prometedoras aplicaciones de GEPA como estrategia de búsqueda "en tiempo de inferencia", transformando una IA de un generador de respuestas de un solo paso en un solucionador iterativo de problemas. Agrawal describe una posible integración en el proceso de desarrollo de una empresa, en el que GEPA podría crear y perfeccionar automáticamente varias versiones optimizadas de un sistema, probar su rendimiento y someter la mejor variante a la revisión de los ingenieros. "Esto convierte la optimización en un proceso continuo y automatizado que produce rápidamente soluciones que a menudo igualan o superan la calidad del ajuste manual realizado por expertos", añade Agrawal. En las pruebas de generación de código CUDA, este método elevó el rendimiento a un nivel experto en el 20% de las tareas, frente al 0% de un único intento con un modelo como GPT-4o.
Los autores consideran que GEPA es un paso fundamental hacia un nuevo paradigma en el desarrollo de la IA. Sin embargo, más allá de fomentar una IA más parecida a la humana, su impacto más inmediato puede ser la democratización de la creación de sistemas de alto rendimiento.
"Anticipamos que GEPA fomentará un cambio positivo en la construcción de sistemas de IA, haciendo la optimización accesible a los usuarios finales que poseen profundos conocimientos del dominio para la tarea, pero pueden carecer del tiempo o el deseo de dominar complejas técnicas de RL", concluyó Agrawal. "Da poder a las partes interesadas que tienen los conocimientos precisos y específicos de la tarea".
Artículo relacionado
 Las acciones de EE. UU. alcanzan un hito histórico mientras gigantes de la IA y la aeroespacial se preparan para su debut de un billón de dólares
Elon Musk, Sam Altman y Dario Amodei, tres titanes del sector tecnológico, están avanzando hacia ofertas públicas iniciales para sus respectivas empresas. Con SpaceX, OpenAI y Anthropic, tres gigantes de la industria que se acercan a valoraciones de
La startup sueca de inteligencia artificial Lovable Eyes alcanza una valoración de 13.200 millones de dólares tras una importante ronda de financiación
Mientras las herramientas de codificación impulsadas por inteligencia artificial ganan terreno, la startup sueca Lovable ha asegurado una importante ronda de financiación. La empresa tiene como objetivo recaudar 3 000 millones de dólares, lo que podr
Google prueba el agente Remy AI para Gemini a medida que el enfoque se desplaza hacia el control del usuario
Según Business Insider, Google está probando Remy, un nuevo agente personal de IA para Gemini. Esta herramienta tiene como objetivo ejecutar tareas en nombre de los usuarios, optimizando tanto los flujos de trabajo profesionales como las rutinas diar
Recomendaciones de temas especiales relacionados
Análisis de datos
 Mejores herramientas de IA para la detección de anomalías en el monitoreo de KPIs para equipos de SaaS y comercio electrónico
¡Las mejores herramientas de detección de anomalías con IA de 2026, más valoradas y destacadas para el monitoreo de KPI en equipos de SaaS y comercio electrónico! XIX.AI ha recopilado una poderosa colección transformadora basada en rigurosas pruebas del mundo real y clasificaciones actualizadas semanalmente. Encontrarás comparaciones detalladas entre versiones gratuitas y de pago que te ayudarán a identificar la solución imprescindible para aumentar la productividad y desbloquear tu ventaja con IA. ¡Explora ahora!
 10 herramientas
 xix.ai
escribiendo
Los mejores generadores de esquemas basados en IA para artículos largos optimizados para SEO
Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai
Educación y aprendizaje
Herramientas de estudio basadas en IA para los deberes y la preparación de exámenes
¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai
composicion musical
Herramientas de demostración vocal con IA para compositores, ganchos, melodías principales y sesiones de borrador multilingüe
¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai
Negocio
Las mejores herramientas de investigación competitiva basadas en IA para pequeñas empresas
¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai
Edición de imágenes
Herramientas de retoque con IA de Photoshop para ropa de comercio electrónico, limpieza de piel y consistencia del color
¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai

 comentario (0)
0/500
Investigadores de la Universidad de Berkeley, la Universidad de Stanford y Databricks han presentado un nuevo método de optimización de la inteligencia artificial llamado GEPA, que demuestra notables mejoras respecto a las técnicas tradicionales de aprendizaje por refuerzo para adaptar grandes modelos lingüísticos a tareas especializadas.
GEPA se aleja del método convencional de aprendizaje mediante miles de intentos de ensayo y error basados en simples puntuaciones numéricas. En su lugar, utiliza las capacidades lingüísticas internas de un LLM para analizar su rendimiento, identificar errores y perfeccionar progresivamente sus instrucciones. Además de lograr una mayor precisión que los métodos establecidos, GEPA es mucho más eficiente y ofrece resultados superiores con hasta 35 veces menos intentos.
Para las empresas que desarrollan agentes y flujos de trabajo de IA complejos, este avance significa un desarrollo más rápido, costes de computación significativamente más bajos y aplicaciones más potentes y fiables.
El alto coste de optimizar los sistemas modernos de IA
Las aplicaciones modernas de IA empresarial rara vez se basan en una única llamada a un LLM. Suelen ser "sistemas de IA compuestos", es decir, flujos de trabajo sofisticados que combinan varios módulos LLM, herramientas externas como bases de datos o intérpretes de código, y lógica personalizada para ejecutar tareas complejas, como la investigación en varios pasos y el análisis de datos.
Una estrategia de optimización habitual para estos sistemas es el aprendizaje por refuerzo, ejemplificado por técnicas como la optimización de políticas relativas de grupo utilizada en modelos de razonamiento avanzados. Estos métodos tratan el sistema de IA como una caja negra, evaluando una tarea a través de una métrica básica de éxito. Esta retroalimentación limitada se utiliza entonces para ajustar gradualmente los parámetros del modelo hacia un mejor rendimiento.
La principal limitación de la RL es su ineficacia. Para aprender eficazmente a partir de puntuaciones numéricas mínimas, la RL suele requerir decenas o incluso cientos de miles de ejecuciones de prueba. Para cualquier aplicación empresarial del mundo real que implique costosas llamadas a herramientas o modelos propietarios, este proceso es prohibitivamente lento y caro.
Como explica Lakshya A Agrawal, coautor y estudiante de doctorado en la UC Berkeley, esta complejidad supone un obstáculo importante para muchas organizaciones. "Para muchos equipos, la RL es inviable debido a su coste y complejidad, y su enfoque por defecto ha sido en gran medida la ingeniería manual", señala Agrawal. GEPA está diseñado para equipos que trabajan con modelos de alto rendimiento que a menudo no pueden ajustarse con precisión, lo que les permite mejorar el rendimiento sin gestionar hardware especializado.
El equipo de investigación plantea el reto de esta manera: "¿Cómo podemos extraer la máxima señal de aprendizaje de cada ensayo costoso para permitir la adaptación eficaz de sistemas de IA complejos y modulares con limitaciones de datos o presupuesto?".
Un optimizador que aprende a través del lenguaje
GEPA aborda este reto sustituyendo las escasas señales de recompensa por una detallada retroalimentación en lenguaje natural. Aprovecha el hecho de que toda la ejecución de un sistema de IA -sus pasos de razonamiento, llamadas a herramientas y mensajes de error- puede representarse como texto para que lo procese un LLM. Esta metodología se basa en tres principios fundamentales.
El primero es la "evolución genética de las instrucciones", en la que GEPA trata un conjunto de instrucciones como una reserva genética, modificándolas iterativamente para generar versiones nuevas y potencialmente mejoradas. Este proceso de mutación está guiado por el segundo principio: "reflexión con retroalimentación de lenguaje natural". Tras varias ejecuciones de prueba, GEPA presenta a un LLM el historial completo de ejecución y los resultados. A continuación, el LLM analiza esta información para diagnosticar problemas y redactar un aviso mejorado y más preciso. Por ejemplo, en lugar de limitarse a recibir una puntuación baja en la generación de código, puede examinar un error del compilador y determinar que el aviso debe especificar una versión concreta de la biblioteca.
El tercer principio es la "selección basada en Pareto", que promueve la exploración inteligente. En lugar de centrarse únicamente en el indicador con la puntuación más alta, con el riesgo de conformarse con una solución subóptima, GEPA mantiene una colección diversa de indicadores especializados. Identifica las instrucciones que destacan en los distintos casos de prueba y elabora una lista de los principales candidatos. Mediante el muestreo de esta variedad de estrategias exitosas, GEPA explora un espacio de soluciones más amplio y es más probable que descubra un indicador que funcione bien a través de diversas entradas.
El éxito de todo este proceso depende de lo que los investigadores denominan "ingeniería de retroalimentación". Agrawal subraya que la clave está en captar los ricos detalles textuales que los sistemas ya producen pero que a menudo ignoran. "Los métodos convencionales suelen condensar esta información en una única recompensa numérica, ocultando las razones que subyacen a determinados resultados", explica. "El enfoque central de GEPA consiste en estructurar una retroalimentación que revele no sólo los resultados finales, sino también los pasos intermedios y los errores en texto plano: las mismas pruebas que un experto humano utilizaría para analizar el comportamiento del sistema."
Por ejemplo, en el caso de un sistema de recuperación de documentos, esto implicaría enumerar qué documentos se recuperaron correctamente y cuáles no, en lugar de informar únicamente de una puntuación final de precisión.
GEPA en la práctica
El equipo de investigación evaluó GEPA en cuatro tareas distintas, desde la respuesta a preguntas de varios saltos hasta consultas para preservar la privacidad. Probaron modelos tanto de código abierto como propios, comparando GEPA con GRPO basado en RL y el optimizador avanzado de consultas MIPROv2.
En todas las evaluaciones, GEPA superó significativamente a GRPO, logrando hasta un 19% de mejora en la puntuación y utilizando hasta 35 veces menos ejecuciones de prueba. Agrawal ilustró esta eficacia con un ejemplo concreto: "Optimizamos un sistema de respuesta de preguntas con GEPA en unas 3 horas, frente a las 24 horas de GRPO, lo que supone una reducción del tiempo de desarrollo ocho veces mayor, junto con un aumento del rendimiento del 20%", afirmó. "La optimización basada en RL para el mismo escenario de prueba costaba unos 300 dólares en cálculo de GPU, mientras que GEPA conseguía mejores resultados por menos de 20 dólares, lo que supone una reducción de costes 15 veces mayor en nuestros experimentos".
Más allá de las métricas en bruto, los investigadores observaron que los sistemas optimizados con GEPA son más fiables a la hora de manejar datos nuevos y desconocidos, como indica una menor "brecha de generalización". Agrawal sugiere que esta mayor robustez se debe a que GEPA aprende de una retroalimentación más rica. "La menor brecha de generalización de GEPA se debe probablemente al uso de comentarios detallados en lenguaje natural sobre cada resultado -aclarando qué ha funcionado, qué ha fallado y por qué- en lugar de basarse en una única puntuación numérica", explica. "Esto anima al sistema a desarrollar instrucciones y estrategias basadas en una comprensión global del éxito, en lugar de limitarse a memorizar patrones a partir de los datos de entrenamiento". Para las empresas, esta mayor fiabilidad se traduce en aplicaciones de IA más robustas y adaptables en escenarios de cara al cliente.
Una ventaja práctica clave es que las instrucciones finales de GEPA son hasta 9,2 veces más cortas que las generadas por optimizadores como MIPROv2, que suelen incluir numerosos ejemplos. Las instrucciones más cortas reducen la latencia y los costes de los modelos basados en API, lo que hace que la aplicación final sea más rápida y más económica de ejecutar en producción.
El artículo también explora las prometedoras aplicaciones de GEPA como estrategia de búsqueda "en tiempo de inferencia", transformando una IA de un generador de respuestas de un solo paso en un solucionador iterativo de problemas. Agrawal describe una posible integración en el proceso de desarrollo de una empresa, en el que GEPA podría crear y perfeccionar automáticamente varias versiones optimizadas de un sistema, probar su rendimiento y someter la mejor variante a la revisión de los ingenieros. "Esto convierte la optimización en un proceso continuo y automatizado que produce rápidamente soluciones que a menudo igualan o superan la calidad del ajuste manual realizado por expertos", añade Agrawal. En las pruebas de generación de código CUDA, este método elevó el rendimiento a un nivel experto en el 20% de las tareas, frente al 0% de un único intento con un modelo como GPT-4o.
Los autores consideran que GEPA es un paso fundamental hacia un nuevo paradigma en el desarrollo de la IA. Sin embargo, más allá de fomentar una IA más parecida a la humana, su impacto más inmediato puede ser la democratización de la creación de sistemas de alto rendimiento.
"Anticipamos que GEPA fomentará un cambio positivo en la construcción de sistemas de IA, haciendo la optimización accesible a los usuarios finales que poseen profundos conocimientos del dominio para la tarea, pero pueden carecer del tiempo o el deseo de dominar complejas técnicas de RL", concluyó Agrawal. "Da poder a las partes interesadas que tienen los conocimientos precisos y específicos de la tarea".








 Las acciones de EE. UU. alcanzan un hito histórico mientras gigantes de la IA y la aeroespacial se preparan para su debut de un billón de dólares
Elon Musk, Sam Altman y Dario Amodei, tres titanes del sector tecnológico, están avanzando hacia ofertas públicas iniciales para sus respectivas empresas. Con SpaceX, OpenAI y Anthropic, tres gigantes de la industria que se acercan a valoraciones de
 La startup sueca de inteligencia artificial Lovable Eyes alcanza una valoración de 13.200 millones de dólares tras una importante ronda de financiación
Mientras las herramientas de codificación impulsadas por inteligencia artificial ganan terreno, la startup sueca Lovable ha asegurado una importante ronda de financiación. La empresa tiene como objetivo recaudar 3 000 millones de dólares, lo que podr
Google prueba el agente Remy AI para Gemini a medida que el enfoque se desplaza hacia el control del usuario
Según Business Insider, Google está probando Remy, un nuevo agente personal de IA para Gemini. Esta herramienta tiene como objetivo ejecutar tareas en nombre de los usuarios, optimizando tanto los flujos de trabajo profesionales como las rutinas diar

¡Las mejores herramientas de detección de anomalías con IA de 2026, más valoradas y destacadas para el monitoreo de KPI en equipos de SaaS y comercio electrónico! XIX.AI ha recopilado una poderosa colección transformadora basada en rigurosas pruebas del mundo real y clasificaciones actualizadas semanalmente. Encontrarás comparaciones detalladas entre versiones gratuitas y de pago que te ayudarán a identificar la solución imprescindible para aumentar la productividad y desbloquear tu ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai

Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai

¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai

¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai

¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai

¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai












