


 家
グーグルのGEPAがLLMのパフォーマンスを向上、高価な強化学習の必要性を回避
カリフォルニア大学バークレー校、スタンフォード大学、Databricks社の研究者は、GEPAと呼ばれる新しいAI最適化手法を発表した。GEPAは、大規模な言語モデルを特殊なタスクに適応させるための従来の強化学習手法と比較して、顕著な改善を示している。
GEPAは、単純な数値スコアによって何千もの試行錯誤を繰り返しながら学習するという従来のアプローチとは一線を画している。その代わりに、LLMの内部言語能力を使用して、そのパフォーマンスを分析し、間違いを特定し、その命令を徐々に改良する。既存の手法よりも高い精度を達成するだけでなく、GEPAははるかに効率的で、最大35倍少ない試行回数で優れた結果をもたらします。
複雑なAIエージェントやワークフローを開発する企業にとって、このブレークスルーは、より迅速な開発、大幅に低い計算コスト、より強力で信頼できるアプリケーションを意味する。
最新のAIシステムを最適化する高いコスト
最新のエンタープライズAIアプリケーションは、LLMへの単一の呼び出しに依存することはほとんどありません。一般的には「複合AIシステム」であり、複数のLLMモジュール、データベースやコード・インタプリタなどの外部ツール、カスタム・ロジックを組み合わせて、マルチステップの調査やデータ分析などの複雑なタスクを実行する洗練されたワークフローです。
このようなシステムの一般的な最適化戦略は強化学習であり、高度な推論モデルで使用されるグループ相対ポリシー最適化のような手法に代表される。これらの手法はAIシステムをブラックボックスとして扱い、基本的な成功指標を通してタスクを評価する。この限られたフィードバックは、モデルのパラメータをより良いパフォーマンスに向けて徐々に調整するために使用される。
RLの主な限界はその非効率性である。最小限の数値スコアから効果的に学習するために、RLはしばしば数万から数十万回の試行を必要とする。高価なツールの呼び出しや独自のモデルを含む現実の企業アプリケーションでは、このプロセスは法外に時間がかかり、高価である。
共著者でカリフォルニア大学バークレー校の博士課程に在籍するLakshya A Agrawalが説明するように、この複雑さは多くの組織にとって大きな障害となっている。「多くのチームにとって、RLはその費用と複雑さのために非現実的である。GEPAは、微調整ができないことが多い高性能モデルを扱うチーム向けに設計されており、特殊なハードウェアを管理することなくパフォーマンスを向上させることができる。
研究チームはこのように課題を設定している:"厳しいデータや予算の制約のもとで、複雑でモジュール化されたAIシステムの効果的な適応を可能にするために、コストのかかるあらゆる試行から最大限の学習シグナルを引き出すにはどうすればいいか?"
言語を通して学習するオプティマイザー

GEPAフレームワーク 出典:arXiv GEPAは、疎な報酬信号を詳細な自然言語フィードバックに置き換えることで、この課題に対処する。これは、AIシステムの実行全体(推論ステップ、ツールの呼び出し、エラーメッセージ)が、LLMが処理するためのテキストとして表現できるという事実を利用している。この方法論は3つの基本原則に基づいている。
一つ目は「プロンプトの遺伝的進化」であり、GEPAはプロンプトのセットを遺伝子プールとして扱い、それらを反復的に修正して新しい改良版を生成する。この突然変異のプロセスは、第二の原則である "自然言語フィードバックによる反映 "によって導かれる。数回の試行後、GEPAはLLMに完全な実行履歴と結果を提示する。そしてLLMはこの情報を分析して問題を診断し、より正確で強化されたプロンプトを作成する。例えば、単にコード生成のスコアが低い代わりに、コンパイラー・エラーを調べ、プロンプトが特定のライブラリー・バージョンを指定しなければならないと判断するかもしれない。
第三の原則は「パレート・ベースの選択」であり、インテリジェントな探索を促進する。単一の最高得点のプロンプトだけに集中するのではなく、GEPAは専門化されたプロンプトの多様なコレクションを維持する。異なるテストケースにおいてどのプロンプトが優れているかを特定し、有力候補の名簿を作成する。この多様な成功戦略からサンプリングすることで、GEPAはより広いソリューション空間を探索し、多様な入力に対して優れたパフォーマンスを発揮するプロンプトを発見する可能性が高くなる。

パレート選択では、最適解を見つけるために、より多くの選択肢を探索する出典:arXiv このプロセス全体の成功は、研究者たちが "フィードバック工学 "と呼ぶものにかかっている。Agrawal氏は、システムがすでに生成しているにもかかわらず、無視されがちな豊富なテキスト情報を取り込むことが重要だと強調する。「従来のパイプラインは通常、この情報を単一の数値報酬に凝縮し、特定の結果の背後にある理由を隠しています」と彼は説明した。「GEPAの核となるアプローチは、最終結果だけでなく、中間ステップやエラーをプレーンテキストで明らかにするフィードバックを構成することである。
例えば、文書検索システムの場合、これは最終的な正確さのスコアだけを報告するのではなく、どの文書が正しく検索され、どれが見逃されたかをリストアップすることを含むだろう。
GEPAの実際
研究チームは、マルチホップ質問応答からプライバシー保護クエリまで、4つの異なるタスクにわたってGEPAを評価した。彼らはオープンソースとプロプライエタリなモデルの両方をテストし、GEPAをRLベースのGRPOと高度なプロンプト・オプティマイザMIPROv2と比較した。
すべての評価において、GEPAはGRPOを大幅に上回り、最大35倍少ない試行回数で最大19%のスコア改善を達成した。Agrawal氏はこの効率性を具体的な例で説明した:「GRPOの24時間に対し、GEPAは約3時間で質問応答システムを最適化しました。「同じテストシナリオに対するRLベースの最適化にはGPU計算で約300ドルのコストがかかったが、GEPAは20ドル以下でより良い結果を達成した。
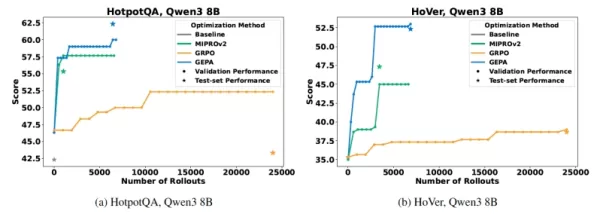
GEPAは主要な性能指標において他のベンチマーク手法を上回る 出典:arXiv 研究者たちは、GEPAが最適化されたシステムは、"汎化ギャップ "が小さいことからわかるように、新しい未知のデータを扱う際の信頼性が高いことを観察した。Agrawal氏は、このロバスト性の向上は、GEPAがより豊富なフィードバックから学習することに起因すると示唆している。GEPAの "汎化ギャップ "が小さいのは、単一の数値スコアに頼るのではなく、何が成功し、何が失敗し、なぜ失敗したかを明確にした、各結果に関する詳細な自然言語フィードバックを使用しているためであろう。「これは、単にトレーニングデータからパターンを記憶するのではなく、成功の包括的な理解に基づいて指示や戦略を開発するようシステムを促すものです」。企業にとって、この信頼性の向上は、顧客と接するシナリオにおいて、より堅牢で適応性の高いAIアプリケーションにつながる。
重要な実用上の利点は、GEPAの最終的な命令が、MIPROv2のようなオプティマイザーが生成するプロンプトよりも最大9.2倍短いことです。より短いプロンプトは、APIベースのモデルの待ち時間を短縮し、コストを下げ、最終的なアプリケーションをより速く、より経済的に実稼働させる。
この論文はまた、AIをシングルステップの回答生成器から反復的な問題解決器に変える「推論時間」探索戦略としてのGEPAの有望な応用を探求している。Agrawalは、GEPAが自動的にシステムの最適化された複数のバージョンを作成し、改良し、それらの性能をテストし、エンジニアリングレビューのために最良のバリアントを提出することができる、企業の開発パイプラインへの潜在的な統合について説明した。「これにより、最適化は継続的な自動化プロセスとなり、多くの場合、専門家による手動チューニングの品質を満たすか、それを上回るソリューションを迅速に生成することができます」とAgrawal氏は付け加えた。CUDAコード生成のテストでは、GPT-4oのようなモデルで1回試行した場合は0%であったのに対し、この方法では20%のタスクでエキスパートレベルまで性能が向上した。
著者らは、GEPAをAI開発の新しいパラダイムに向けた基礎的なステップと見なしている。しかし、より人間に近いAIを育成する以上に、その最も直接的な影響は、高性能システムの作成を民主化することにあるかもしれない。
「我々は、GEPAがAIシステム構築におけるポジティブなシフトを促進し、タスクのための深い専門知識を持ちながら、複雑なRL技術を習得する時間や意欲がないエンドユーザーが最適化にアクセスできるようになることを期待しています」とアグラワルは締めくくった。「GEPAは、タスクに特化した正確な知識を持つ関係者に力を与える。
関連記事
 米国の株式市場が歴史的なマイルストーンに到達、AIと航空宇宙の巨人が1兆ドル規模のデビューに向けて準備を進める
エロン・マスク、サム・アルトマン、ダリオ・アモダイというテクノロジー業界の三巨頭が、それぞれの事業で初公開株式発行(IPO)に向けて進んでいる。スペースX、OpenAI、Anthropicという業界の巨人3社が1兆ドル規模の企業価値に近づき、上場準備を進める中、2026年は米国史上、新規株式発行が最も重要な年となる見込みだ。この歴史的な資金増強は世界の金融の注目を集めており、公的市場がこのような規模の資金を吸収する能力に対する重要なストレステストとなっている。これらの主要な資金調達が一斉に開始
スウェーデンのAIスタートアップ「Lovable」が主要な資金調達ラウンド終了後、132億ドルの評価額を達成
AI駆動のコーディングツールが注目を集める中、スウェーデンのスタートアップ企業Lovableは大型の資金調達ラウンドを獲得した。同社は30億ドルの調達を目指しており、これにより評価額が昨年12月に記録された66億ドルの倍となる132億ドルに達する可能性がある。この投資をリードするのはMenlo Venturesと見られている。Lovableの魅力は、複雑なコーディングスキルを不要とし、ソフトウェア作成を簡素化する中核の「ヴァイブコーディング」技術に由来する。ユーザーは自然言語で要件を記述するだ
Google、Geminiへの焦点がユーザー制御へシフトする中で、Remy AIエージェントをテスト
『Business Insider』によると、GoogleはGemini向けの新しいAIパーソナルエージェント「Remy」をテスト中である。このツールはユーザーに代わってタスクを実行することを目的としており、業務フローと日常のルーチンの両方を効率化する。現在、RemyはGeminiアプリケーションの社内限定版においてテストが行われている。この報道は社内文書と、プロジェクトに精通した2人の人物へのインタビューを引用している。社内資料では、Remyを「24時間365日のパーソナルエージェント」と位
関連特集おすすめ
データ分析
 SaaSおよびEコマースチーム向けのKPIモニタリングにおけるベストなAI異常検知ツール
2026年最新版・最高評価のAI異常検知ツール【SaaSおよびEコマースチーム向けKPIモニタリング】!XIX.AIは、厳格な実世界テストと週次更新のランキングに基づき、革新的な強力なコレクションを厳選しました。生産性を向上させ、AIの優位性を引き出すために必須のソリューションを見極めるのに役立つ、無料版と有料版の詳細な比較インサイトが見つかります。今すぐチェックしましょう!
 10 ツール
 xix.ai
書き込み
長文SEO記事に最適なAIアウトライン生成ツール
XIX.AIが厳選した、2026年最新のロングフォームSEO記事向け高評価AIアウトライン生成ツール。これらの強力なツールは、高品質なコンテンツを迅速に作成するための画期的な支援を提供し、執筆効率を大幅に向上させます。 無料版と有料版の比較、実地テスト、詳細なランキングを参考に、ご自身のニーズに合った「ぜひ試すべき」ツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう。
8 ツール
xix.ai
教育と学習
宿題や試験対策に役立つAI学習ツール
2026年版 宿題や試験対策に最適な最新AI学習ツール!XIX.AIは、学生の生産性を高め、宿題の完了を効率化し、実際の試験で好成績を収めるのに役立つ、画期的な高評価ツールを厳選して紹介しています。 無料版と有料版の比較、詳細なランキング、そしてAIの力を最大限に引き出すためにぜひ試すべきツールをご紹介します。今すぐチェックしましょう!
10 ツール
xix.ai
作曲
ソングライター向けAIボーカルデモツール:フック、トップライン、多言語のドラフトセッション
2026年版 ソングライター、フッククリエイター、多言語コンテンツ制作チームのための最新・最高のAIボーカルデモツール!XIX.AIは、厳格な実地テストを経て、業界に革新をもたらす強力なツールを厳選し、高評価のランキングリストを作成しました。 無料版と有料版の詳細な比較データ、包括的なランキング、そして創作効率を高め、創造力を最大限に引き出すためにぜひ試すべきツールが満載です。今すぐチェックして、あらゆるコンテンツ制作ニーズに最適なツールを見つけましょう!
9 ツール
xix.ai
仕事
中小企業に最適なAI競合分析ツール
2026年版 中小企業向け最新・最高評価のAI競合分析ツール!XIX.AIは、実環境での厳格なテストと詳細なランキングに基づき、毎週更新される、極めて強力で業界に革命をもたらすツールを厳選しました。無料版と有料版の包括的な比較も掲載されており、生産性を向上させ、競争優位性をもたらす「ぜひ試すべき」ツールを見つけるのに役立ちます。 今すぐチェックして、あなたにぴったりのツールを見つけましょう!
9 ツール
xix.ai
画像編集
EC用アパレル向けPhotoshop AIレタッチツール、肌のクレンジング、色の統一
2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai

 コメント (0)
0/500
カリフォルニア大学バークレー校、スタンフォード大学、Databricks社の研究者は、GEPAと呼ばれる新しいAI最適化手法を発表した。GEPAは、大規模な言語モデルを特殊なタスクに適応させるための従来の強化学習手法と比較して、顕著な改善を示している。
GEPAは、単純な数値スコアによって何千もの試行錯誤を繰り返しながら学習するという従来のアプローチとは一線を画している。その代わりに、LLMの内部言語能力を使用して、そのパフォーマンスを分析し、間違いを特定し、その命令を徐々に改良する。既存の手法よりも高い精度を達成するだけでなく、GEPAははるかに効率的で、最大35倍少ない試行回数で優れた結果をもたらします。
複雑なAIエージェントやワークフローを開発する企業にとって、このブレークスルーは、より迅速な開発、大幅に低い計算コスト、より強力で信頼できるアプリケーションを意味する。
最新のAIシステムを最適化する高いコスト
最新のエンタープライズAIアプリケーションは、LLMへの単一の呼び出しに依存することはほとんどありません。一般的には「複合AIシステム」であり、複数のLLMモジュール、データベースやコード・インタプリタなどの外部ツール、カスタム・ロジックを組み合わせて、マルチステップの調査やデータ分析などの複雑なタスクを実行する洗練されたワークフローです。
このようなシステムの一般的な最適化戦略は強化学習であり、高度な推論モデルで使用されるグループ相対ポリシー最適化のような手法に代表される。これらの手法はAIシステムをブラックボックスとして扱い、基本的な成功指標を通してタスクを評価する。この限られたフィードバックは、モデルのパラメータをより良いパフォーマンスに向けて徐々に調整するために使用される。
RLの主な限界はその非効率性である。最小限の数値スコアから効果的に学習するために、RLはしばしば数万から数十万回の試行を必要とする。高価なツールの呼び出しや独自のモデルを含む現実の企業アプリケーションでは、このプロセスは法外に時間がかかり、高価である。
共著者でカリフォルニア大学バークレー校の博士課程に在籍するLakshya A Agrawalが説明するように、この複雑さは多くの組織にとって大きな障害となっている。「多くのチームにとって、RLはその費用と複雑さのために非現実的である。GEPAは、微調整ができないことが多い高性能モデルを扱うチーム向けに設計されており、特殊なハードウェアを管理することなくパフォーマンスを向上させることができる。
研究チームはこのように課題を設定している:"厳しいデータや予算の制約のもとで、複雑でモジュール化されたAIシステムの効果的な適応を可能にするために、コストのかかるあらゆる試行から最大限の学習シグナルを引き出すにはどうすればいいか?"
言語を通して学習するオプティマイザー
GEPAは、疎な報酬信号を詳細な自然言語フィードバックに置き換えることで、この課題に対処する。これは、AIシステムの実行全体(推論ステップ、ツールの呼び出し、エラーメッセージ)が、LLMが処理するためのテキストとして表現できるという事実を利用している。この方法論は3つの基本原則に基づいている。
一つ目は「プロンプトの遺伝的進化」であり、GEPAはプロンプトのセットを遺伝子プールとして扱い、それらを反復的に修正して新しい改良版を生成する。この突然変異のプロセスは、第二の原則である "自然言語フィードバックによる反映 "によって導かれる。数回の試行後、GEPAはLLMに完全な実行履歴と結果を提示する。そしてLLMはこの情報を分析して問題を診断し、より正確で強化されたプロンプトを作成する。例えば、単にコード生成のスコアが低い代わりに、コンパイラー・エラーを調べ、プロンプトが特定のライブラリー・バージョンを指定しなければならないと判断するかもしれない。
第三の原則は「パレート・ベースの選択」であり、インテリジェントな探索を促進する。単一の最高得点のプロンプトだけに集中するのではなく、GEPAは専門化されたプロンプトの多様なコレクションを維持する。異なるテストケースにおいてどのプロンプトが優れているかを特定し、有力候補の名簿を作成する。この多様な成功戦略からサンプリングすることで、GEPAはより広いソリューション空間を探索し、多様な入力に対して優れたパフォーマンスを発揮するプロンプトを発見する可能性が高くなる。
このプロセス全体の成功は、研究者たちが "フィードバック工学 "と呼ぶものにかかっている。Agrawal氏は、システムがすでに生成しているにもかかわらず、無視されがちな豊富なテキスト情報を取り込むことが重要だと強調する。「従来のパイプラインは通常、この情報を単一の数値報酬に凝縮し、特定の結果の背後にある理由を隠しています」と彼は説明した。「GEPAの核となるアプローチは、最終結果だけでなく、中間ステップやエラーをプレーンテキストで明らかにするフィードバックを構成することである。
例えば、文書検索システムの場合、これは最終的な正確さのスコアだけを報告するのではなく、どの文書が正しく検索され、どれが見逃されたかをリストアップすることを含むだろう。
GEPAの実際
研究チームは、マルチホップ質問応答からプライバシー保護クエリまで、4つの異なるタスクにわたってGEPAを評価した。彼らはオープンソースとプロプライエタリなモデルの両方をテストし、GEPAをRLベースのGRPOと高度なプロンプト・オプティマイザMIPROv2と比較した。
すべての評価において、GEPAはGRPOを大幅に上回り、最大35倍少ない試行回数で最大19%のスコア改善を達成した。Agrawal氏はこの効率性を具体的な例で説明した:「GRPOの24時間に対し、GEPAは約3時間で質問応答システムを最適化しました。「同じテストシナリオに対するRLベースの最適化にはGPU計算で約300ドルのコストがかかったが、GEPAは20ドル以下でより良い結果を達成した。
研究者たちは、GEPAが最適化されたシステムは、"汎化ギャップ "が小さいことからわかるように、新しい未知のデータを扱う際の信頼性が高いことを観察した。Agrawal氏は、このロバスト性の向上は、GEPAがより豊富なフィードバックから学習することに起因すると示唆している。GEPAの "汎化ギャップ "が小さいのは、単一の数値スコアに頼るのではなく、何が成功し、何が失敗し、なぜ失敗したかを明確にした、各結果に関する詳細な自然言語フィードバックを使用しているためであろう。「これは、単にトレーニングデータからパターンを記憶するのではなく、成功の包括的な理解に基づいて指示や戦略を開発するようシステムを促すものです」。企業にとって、この信頼性の向上は、顧客と接するシナリオにおいて、より堅牢で適応性の高いAIアプリケーションにつながる。
重要な実用上の利点は、GEPAの最終的な命令が、MIPROv2のようなオプティマイザーが生成するプロンプトよりも最大9.2倍短いことです。より短いプロンプトは、APIベースのモデルの待ち時間を短縮し、コストを下げ、最終的なアプリケーションをより速く、より経済的に実稼働させる。
この論文はまた、AIをシングルステップの回答生成器から反復的な問題解決器に変える「推論時間」探索戦略としてのGEPAの有望な応用を探求している。Agrawalは、GEPAが自動的にシステムの最適化された複数のバージョンを作成し、改良し、それらの性能をテストし、エンジニアリングレビューのために最良のバリアントを提出することができる、企業の開発パイプラインへの潜在的な統合について説明した。「これにより、最適化は継続的な自動化プロセスとなり、多くの場合、専門家による手動チューニングの品質を満たすか、それを上回るソリューションを迅速に生成することができます」とAgrawal氏は付け加えた。CUDAコード生成のテストでは、GPT-4oのようなモデルで1回試行した場合は0%であったのに対し、この方法では20%のタスクでエキスパートレベルまで性能が向上した。
著者らは、GEPAをAI開発の新しいパラダイムに向けた基礎的なステップと見なしている。しかし、より人間に近いAIを育成する以上に、その最も直接的な影響は、高性能システムの作成を民主化することにあるかもしれない。
「我々は、GEPAがAIシステム構築におけるポジティブなシフトを促進し、タスクのための深い専門知識を持ちながら、複雑なRL技術を習得する時間や意欲がないエンドユーザーが最適化にアクセスできるようになることを期待しています」とアグラワルは締めくくった。「GEPAは、タスクに特化した正確な知識を持つ関係者に力を与える。








 米国の株式市場が歴史的なマイルストーンに到達、AIと航空宇宙の巨人が1兆ドル規模のデビューに向けて準備を進める
エロン・マスク、サム・アルトマン、ダリオ・アモダイというテクノロジー業界の三巨頭が、それぞれの事業で初公開株式発行(IPO)に向けて進んでいる。スペースX、OpenAI、Anthropicという業界の巨人3社が1兆ドル規模の企業価値に近づき、上場準備を進める中、2026年は米国史上、新規株式発行が最も重要な年となる見込みだ。この歴史的な資金増強は世界の金融の注目を集めており、公的市場がこのような規模の資金を吸収する能力に対する重要なストレステストとなっている。これらの主要な資金調達が一斉に開始
 スウェーデンのAIスタートアップ「Lovable」が主要な資金調達ラウンド終了後、132億ドルの評価額を達成
AI駆動のコーディングツールが注目を集める中、スウェーデンのスタートアップ企業Lovableは大型の資金調達ラウンドを獲得した。同社は30億ドルの調達を目指しており、これにより評価額が昨年12月に記録された66億ドルの倍となる132億ドルに達する可能性がある。この投資をリードするのはMenlo Venturesと見られている。Lovableの魅力は、複雑なコーディングスキルを不要とし、ソフトウェア作成を簡素化する中核の「ヴァイブコーディング」技術に由来する。ユーザーは自然言語で要件を記述するだ
Google、Geminiへの焦点がユーザー制御へシフトする中で、Remy AIエージェントをテスト
『Business Insider』によると、GoogleはGemini向けの新しいAIパーソナルエージェント「Remy」をテスト中である。このツールはユーザーに代わってタスクを実行することを目的としており、業務フローと日常のルーチンの両方を効率化する。現在、RemyはGeminiアプリケーションの社内限定版においてテストが行われている。この報道は社内文書と、プロジェクトに精通した2人の人物へのインタビューを引用している。社内資料では、Remyを「24時間365日のパーソナルエージェント」と位

2026年最新版・最高評価のAI異常検知ツール【SaaSおよびEコマースチーム向けKPIモニタリング】!XIX.AIは、厳格な実世界テストと週次更新のランキングに基づき、革新的な強力なコレクションを厳選しました。生産性を向上させ、AIの優位性を引き出すために必須のソリューションを見極めるのに役立つ、無料版と有料版の詳細な比較インサイトが見つかります。今すぐチェックしましょう!
10 ツール
xix.ai

XIX.AIが厳選した、2026年最新のロングフォームSEO記事向け高評価AIアウトライン生成ツール。これらの強力なツールは、高品質なコンテンツを迅速に作成するための画期的な支援を提供し、執筆効率を大幅に向上させます。 無料版と有料版の比較、実地テスト、詳細なランキングを参考に、ご自身のニーズに合った「ぜひ試すべき」ツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう。
8 ツール
xix.ai

2026年版 宿題や試験対策に最適な最新AI学習ツール!XIX.AIは、学生の生産性を高め、宿題の完了を効率化し、実際の試験で好成績を収めるのに役立つ、画期的な高評価ツールを厳選して紹介しています。 無料版と有料版の比較、詳細なランキング、そしてAIの力を最大限に引き出すためにぜひ試すべきツールをご紹介します。今すぐチェックしましょう!
10 ツール
xix.ai

2026年版 ソングライター、フッククリエイター、多言語コンテンツ制作チームのための最新・最高のAIボーカルデモツール!XIX.AIは、厳格な実地テストを経て、業界に革新をもたらす強力なツールを厳選し、高評価のランキングリストを作成しました。 無料版と有料版の詳細な比較データ、包括的なランキング、そして創作効率を高め、創造力を最大限に引き出すためにぜひ試すべきツールが満載です。今すぐチェックして、あらゆるコンテンツ制作ニーズに最適なツールを見つけましょう!
9 ツール
xix.ai

2026年版 中小企業向け最新・最高評価のAI競合分析ツール!XIX.AIは、実環境での厳格なテストと詳細なランキングに基づき、毎週更新される、極めて強力で業界に革命をもたらすツールを厳選しました。無料版と有料版の包括的な比較も掲載されており、生産性を向上させ、競争優位性をもたらす「ぜひ試すべき」ツールを見つけるのに役立ちます。 今すぐチェックして、あなたにぴったりのツールを見つけましょう!
9 ツール
xix.ai

2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai












