


 Hogar
Ant Group lanza el modelo de percepción espacial LingBot-Depth 2.0, lo que supone un avance en la visión robótica.
El 7 de julio, Lingbo Technology, una empresa de inteligencia incorporada perteneciente a Ant Group, lanzó el modelo de percepción espacial LingBot-Depth 2.0. Entrenado con un conjunto de datos de 150 millones de muestras, ofrece mejoras generales en la nitidez de los contornos, el reconocimiento de objetos pequeños, la estimación de profundidad a larga distancia y la robustez en escenarios complejos.
LingBot-Depth es un modelo de percepción espacial desarrollado de forma independiente por Lingbo, que actúa como los ojos de los robots en el mundo físico. La primera versión abordaba los retos de la percepción espacial en escenarios difíciles, como superficies transparentes y reflectantes. En comparación con la versión 1.0, los datos de entrenamiento de LingBot-Depth 2.0 se han ampliado de 3 millones a 150 millones de muestras, lo que ha supuesto una mejora general del rendimiento: ha conseguido 12 primeros puestos de un total de 16 criterios de evaluación en las pruebas de referencia de completado de profundidad. En el escenario interior más complejo, con grandes lagunas de profundidad, el error de profundidad se redujo a la mitad en comparación con la generación anterior (el RMSE descendió de 0,132 a 0,062). Ofrece un rendimiento especialmente bueno en situaciones en las que las cámaras de profundidad tradicionales suelen fallar, como en el caso del cristal, los espejos y los objetos transparentes.
Al mismo tiempo, LingBot-Depth 2.0 presentó su modelo visual básico, LingBot-Vision, creando una cadena de capacidades que va desde la «comprensión» hasta la «percepción precisa». El objetivo es abordar los retos fundamentales de la visión robótica, entre los que se incluyen la percepción espacial, el reconocimiento preciso y la adaptación a entornos complejos.
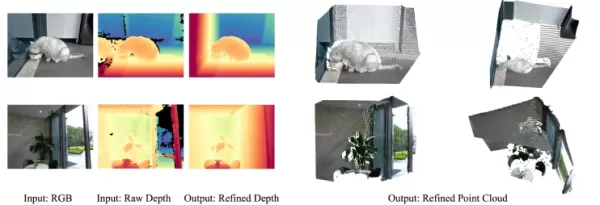
(Figura 1: LingBot-Depth 2.0 reconstruye una estructura 3D completa y plana en escenarios difíciles, como espejos y cristales)
El avance de LingBot-Depth 2.0 se basa en las excepcionales capacidades de representación visual de LingBot-Vision. Como modelo visual de uso general, LingBot-Vision es el primer modelo visual básico del sector que utiliza la «estructura de límites» como objetivo de preentrenamiento, lo que supone un avance en el paradigma de entrenamiento de la percepción espacial. Ofrece un posicionamiento de límites a nivel subpíxel y una comprensión de la estructura espacial, lo que proporciona una mayor precisión y una percepción espacial más estable.
El corpus de preentrenamiento de LingBot-Vision consta de tan solo 160 millones de imágenes, un orden de magnitud menor que el de DINOv3, y, sin embargo, su precisión en la estimación de profundidad supera a la de DINOv3. Además, la identificación de los límites de los objetos por parte de LingBot-Vision es lo suficientemente estable como para permitir el seguimiento continuo de los límites en vídeos. Esta versión incluye cuatro variantes: ViT-G, ViT-L, ViT-B y ViT-S.
Según la información disponible, LingBot-Vision no solo sirve para el entrenamiento de LingBot-Depth 2.0, sino que también puede utilizarse de muchas otras formas.
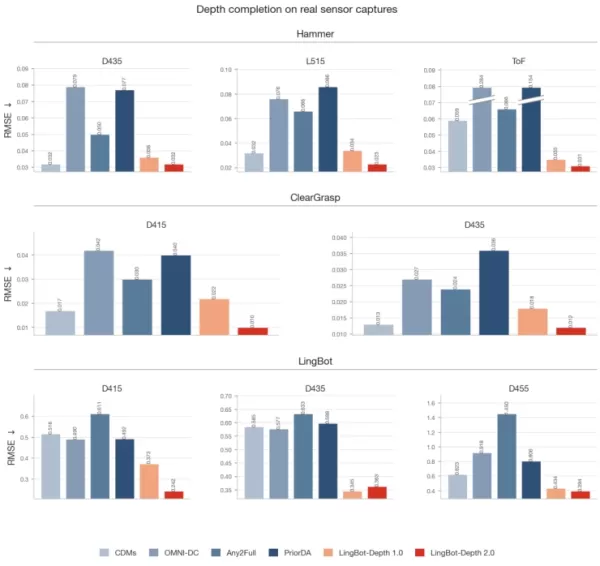
(Figura 2: LingBot-Depth 2.0 obtiene buenos resultados en pruebas de completado de profundidad con sensores reales)
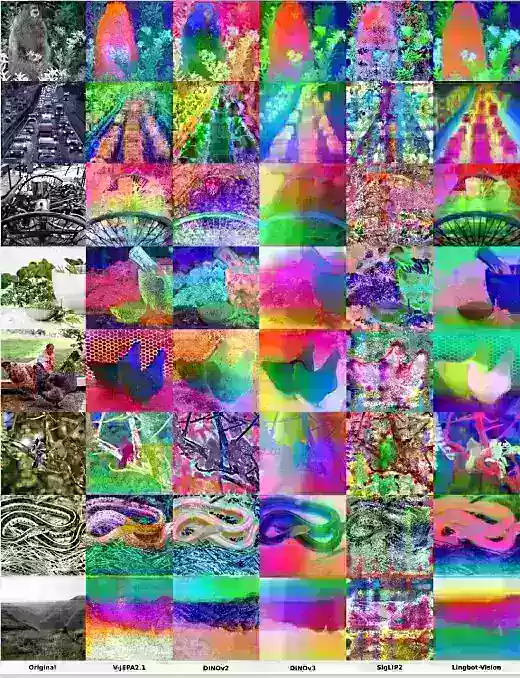
(Figura 3: En comparación con los principales modelos visuales básicos, LingBot-Vision identifica los límites de los objetos y las estructuras espaciales de forma más clara y estable)
Actualmente, LingBot-Depth 2.0 ha superado la certificación profesional del Orbbec Depth Vision Lab. Las pruebas en escenarios prácticos demuestran que, basándose en los datos 3D sin procesar a nivel de chip proporcionados por la cámara 3D estéreo de la serie Gemini330 de Orbbec, LingBot-Depth 2.0 mejora significativamente la nitidez de los bordes, la integridad de los contornos de los objetos, el reconocimiento de objetos delicados, la estimación de profundidad a larga distancia y la robustez en escenarios con iluminación y materiales complejos.
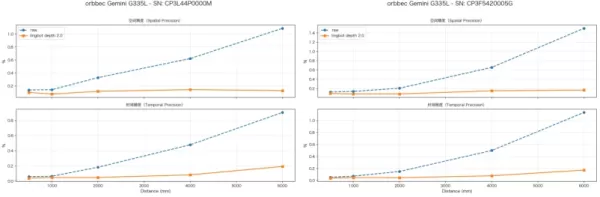
(Figura 4: LingBot Depth 2.0 ha superado la evaluación profesional del Orbbec Depth Vision Lab, demostrando una precisión y estabilidad extremadamente altas en tareas de estimación de profundidad espacial y temporal con múltiples tipos de sensores)
En cuanto a la comercialización, Ant Lingbo ha establecido una estrecha colaboración con Orbbec en numerosos ámbitos. Según la información disponible, la última versión RGB-D del dispositivo EGO, incluida en la nueva gama de productos de adquisición de datos sin cuerpo de Orbbec, se adaptará a la versión LingBot-Depth optimizada por Lingbo para escenarios de adquisición de datos. En el futuro, se integrarán aún más versiones comerciales de mayor nivel, se seguirán subsanando las lagunas de profundidad, se optimizarán los bordes de los objetos y los detalles de la estructura espacial, y se proporcionarán bases de datos del mundo real más precisas, estables y útiles para el entrenamiento de modelos de inteligencia incorporada.
Además, Orbbec lanzará un producto SDK que integrará las últimas capacidades del modelo LingBot-Depth, disponible para su uso por parte de los clientes de robótica en el borde de la red, lo que permitirá a los robots que utilicen la cámara de la serie Gemini330 lograr mejores efectos de profundidad. También tienen previsto lanzar un producto de cámara integrada con la versión comercial de LingBot-Depth a finales de año, haciendo realidad la integración de «cámara 3D + capacidades de percepción espacial». Con el lanzamiento de estos dos modelos, se espera que su colaboración se amplíe a más campos.
Artículo relacionado
 La startup sueca de inteligencia artificial Lovable Eyes alcanza una valoración de 13.200 millones de dólares tras una importante ronda de financiación
Mientras las herramientas de codificación impulsadas por inteligencia artificial ganan terreno, la startup sueca Lovable ha asegurado una importante ronda de financiación. La empresa tiene como objetivo recaudar 3 000 millones de dólares, lo que podr
Google prueba el agente Remy AI para Gemini a medida que el enfoque se desplaza hacia el control del usuario
Según Business Insider, Google está probando Remy, un nuevo agente personal de IA para Gemini. Esta herramienta tiene como objetivo ejecutar tareas en nombre de los usuarios, optimizando tanto los flujos de trabajo profesionales como las rutinas diar
Cómo corregir las Core Web Vitals para mejorar el posicionamiento SEO
Simplificar los comentarios de las tarjetas de calificación con herramientas de IAIntroducciónHerramientas de IA para generar comentarios de tarjetas de calificaciónMagic SchoolAlmanac AIChat GPTUso de Magic School para generar comentarios de t
Recomendaciones de temas especiales relacionados
escribiendo
 Los mejores generadores de esquemas basados en IA para artículos largos optimizados para SEO
Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
 8 herramientas
 xix.ai
Educación y aprendizaje
Herramientas de estudio basadas en IA para los deberes y la preparación de exámenes
¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai
composicion musical
Herramientas de demostración vocal con IA para compositores, ganchos, melodías principales y sesiones de borrador multilingüe
¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai
Negocio
Las mejores herramientas de investigación competitiva basadas en IA para pequeñas empresas
¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai
Edición de imágenes
Herramientas de retoque con IA de Photoshop para ropa de comercio electrónico, limpieza de piel y consistencia del color
¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai
Inmediato
Las mejores bibliotecas de indicaciones de IA para los flujos de trabajo de ChatGPT
Las mejores bibliotecas de prompts de IA de 2026, con las más valoradas, para optimizar todo tipo de flujos de trabajo de ChatGPT. XIX.AI ha seleccionado una colección potente y revolucionaria que se somete a rigurosas pruebas en condiciones reales para garantizar el máximo rendimiento. Encontrarás comparativas detalladas entre opciones gratuitas y de pago, así como clasificaciones de expertos, que te ayudarán a elegir las herramientas imprescindibles para potenciar tu productividad y sacar el máximo partido a la IA. ¡Explora ahora!
11 herramientas
xix.ai

 comentario (0)
0/500
El 7 de julio, Lingbo Technology, una empresa de inteligencia incorporada perteneciente a Ant Group, lanzó el modelo de percepción espacial LingBot-Depth 2.0. Entrenado con un conjunto de datos de 150 millones de muestras, ofrece mejoras generales en la nitidez de los contornos, el reconocimiento de objetos pequeños, la estimación de profundidad a larga distancia y la robustez en escenarios complejos.
LingBot-Depth es un modelo de percepción espacial desarrollado de forma independiente por Lingbo, que actúa como los ojos de los robots en el mundo físico. La primera versión abordaba los retos de la percepción espacial en escenarios difíciles, como superficies transparentes y reflectantes. En comparación con la versión 1.0, los datos de entrenamiento de LingBot-Depth 2.0 se han ampliado de 3 millones a 150 millones de muestras, lo que ha supuesto una mejora general del rendimiento: ha conseguido 12 primeros puestos de un total de 16 criterios de evaluación en las pruebas de referencia de completado de profundidad. En el escenario interior más complejo, con grandes lagunas de profundidad, el error de profundidad se redujo a la mitad en comparación con la generación anterior (el RMSE descendió de 0,132 a 0,062). Ofrece un rendimiento especialmente bueno en situaciones en las que las cámaras de profundidad tradicionales suelen fallar, como en el caso del cristal, los espejos y los objetos transparentes.
Al mismo tiempo, LingBot-Depth 2.0 presentó su modelo visual básico, LingBot-Vision, creando una cadena de capacidades que va desde la «comprensión» hasta la «percepción precisa». El objetivo es abordar los retos fundamentales de la visión robótica, entre los que se incluyen la percepción espacial, el reconocimiento preciso y la adaptación a entornos complejos.
(Figura 1: LingBot-Depth 2.0 reconstruye una estructura 3D completa y plana en escenarios difíciles, como espejos y cristales)
El avance de LingBot-Depth 2.0 se basa en las excepcionales capacidades de representación visual de LingBot-Vision. Como modelo visual de uso general, LingBot-Vision es el primer modelo visual básico del sector que utiliza la «estructura de límites» como objetivo de preentrenamiento, lo que supone un avance en el paradigma de entrenamiento de la percepción espacial. Ofrece un posicionamiento de límites a nivel subpíxel y una comprensión de la estructura espacial, lo que proporciona una mayor precisión y una percepción espacial más estable.
El corpus de preentrenamiento de LingBot-Vision consta de tan solo 160 millones de imágenes, un orden de magnitud menor que el de DINOv3, y, sin embargo, su precisión en la estimación de profundidad supera a la de DINOv3. Además, la identificación de los límites de los objetos por parte de LingBot-Vision es lo suficientemente estable como para permitir el seguimiento continuo de los límites en vídeos. Esta versión incluye cuatro variantes: ViT-G, ViT-L, ViT-B y ViT-S.
Según la información disponible, LingBot-Vision no solo sirve para el entrenamiento de LingBot-Depth 2.0, sino que también puede utilizarse de muchas otras formas.
(Figura 2: LingBot-Depth 2.0 obtiene buenos resultados en pruebas de completado de profundidad con sensores reales)
(Figura 3: En comparación con los principales modelos visuales básicos, LingBot-Vision identifica los límites de los objetos y las estructuras espaciales de forma más clara y estable)
Actualmente, LingBot-Depth 2.0 ha superado la certificación profesional del Orbbec Depth Vision Lab. Las pruebas en escenarios prácticos demuestran que, basándose en los datos 3D sin procesar a nivel de chip proporcionados por la cámara 3D estéreo de la serie Gemini330 de Orbbec, LingBot-Depth 2.0 mejora significativamente la nitidez de los bordes, la integridad de los contornos de los objetos, el reconocimiento de objetos delicados, la estimación de profundidad a larga distancia y la robustez en escenarios con iluminación y materiales complejos.
(Figura 4: LingBot Depth 2.0 ha superado la evaluación profesional del Orbbec Depth Vision Lab, demostrando una precisión y estabilidad extremadamente altas en tareas de estimación de profundidad espacial y temporal con múltiples tipos de sensores)
En cuanto a la comercialización, Ant Lingbo ha establecido una estrecha colaboración con Orbbec en numerosos ámbitos. Según la información disponible, la última versión RGB-D del dispositivo EGO, incluida en la nueva gama de productos de adquisición de datos sin cuerpo de Orbbec, se adaptará a la versión LingBot-Depth optimizada por Lingbo para escenarios de adquisición de datos. En el futuro, se integrarán aún más versiones comerciales de mayor nivel, se seguirán subsanando las lagunas de profundidad, se optimizarán los bordes de los objetos y los detalles de la estructura espacial, y se proporcionarán bases de datos del mundo real más precisas, estables y útiles para el entrenamiento de modelos de inteligencia incorporada.
Además, Orbbec lanzará un producto SDK que integrará las últimas capacidades del modelo LingBot-Depth, disponible para su uso por parte de los clientes de robótica en el borde de la red, lo que permitirá a los robots que utilicen la cámara de la serie Gemini330 lograr mejores efectos de profundidad. También tienen previsto lanzar un producto de cámara integrada con la versión comercial de LingBot-Depth a finales de año, haciendo realidad la integración de «cámara 3D + capacidades de percepción espacial». Con el lanzamiento de estos dos modelos, se espera que su colaboración se amplíe a más campos.








 La startup sueca de inteligencia artificial Lovable Eyes alcanza una valoración de 13.200 millones de dólares tras una importante ronda de financiación
Mientras las herramientas de codificación impulsadas por inteligencia artificial ganan terreno, la startup sueca Lovable ha asegurado una importante ronda de financiación. La empresa tiene como objetivo recaudar 3 000 millones de dólares, lo que podr
Google prueba el agente Remy AI para Gemini a medida que el enfoque se desplaza hacia el control del usuario
Según Business Insider, Google está probando Remy, un nuevo agente personal de IA para Gemini. Esta herramienta tiene como objetivo ejecutar tareas en nombre de los usuarios, optimizando tanto los flujos de trabajo profesionales como las rutinas diar
 Cómo corregir las Core Web Vitals para mejorar el posicionamiento SEO
Simplificar los comentarios de las tarjetas de calificación con herramientas de IAIntroducciónHerramientas de IA para generar comentarios de tarjetas de calificaciónMagic SchoolAlmanac AIChat GPTUso de Magic School para generar comentarios de t

Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai

¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai

¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai

¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai

¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai

Las mejores bibliotecas de prompts de IA de 2026, con las más valoradas, para optimizar todo tipo de flujos de trabajo de ChatGPT. XIX.AI ha seleccionado una colección potente y revolucionaria que se somete a rigurosas pruebas en condiciones reales para garantizar el máximo rendimiento. Encontrarás comparativas detalladas entre opciones gratuitas y de pago, así como clasificaciones de expertos, que te ayudarán a elegir las herramientas imprescindibles para potenciar tu productividad y sacar el máximo partido a la IA. ¡Explora ahora!
11 herramientas
xix.ai












