


 Heim
Tencent Hunyuan stellt „Hy-Memory“ vor: 45 % mehr Speicher, 35 % geringere Token-Kosten
KI-Agenten für die langfristige Zusammenarbeit durchlaufen oft einen frustrierenden „Drei-Wochen-Verlauf“: In der ersten Woche beeindrucken sie, in der zweiten Woche macht sich Unbehagen breit, da Gedächtnislücken und Abweichungen im Verständnis offensichtlich werden, und in der dritten Woche verkommen sie zu einfachen Tools für Sofortabfragen. Um die Herausforderungen fragmentierter Erinnerungen und chaotischer Zeitachsen bei längerer Zusammenarbeit zu bewältigen, hat Tencent Hunyuan heute (28. Mai 2026) „Hy-Memory“ vorgestellt, ein intelligentes Speicher-Plugin, das speziell für langfristig zusammenarbeitende Agenten wie Openclaw entwickelt wurde – Hy-Memory.
Als „zweites Gehirn“ eines Agenten übertrifft Hy-Memory dank dreier Kerntechnologien die gängigen Frameworks bei den maßgeblichen öffentlichen Benchmarks LongMemEval und PersonaMem. Auswertungsdaten zeigen, dass Hy-Memory das Speichervolumen um über 70 % reduziert und gleichzeitig die Informationsdichte pro Speicherplatz um mehr als 45 % erhöht; bei der Verarbeitung langer Kontexte sinkt der Token-Verbrauch um 35 % und die Geschwindigkeit der Speicheraktualisierung verbessert sich um 20 %.
Drei Kerntechnologien, die den KI-Speichermechanismus neu gestalten
Ebene 1: Das sechsstufige Speicher-Framework (präzise Platzierung)
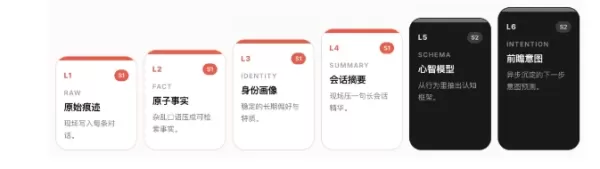
Hy-Memory vermeidet es, alle Informationen auf einmal in die Vektordatenbank zu laden. Stattdessen gliedert es den Speicher in sechs Ebenen auf: L1-Rohdaten, L2-atomare Fakten, L3-Identitätsprofile, L4-Sitzungszusammenfassungen, L5-mentale Modelle und L6-zukünftige Absichten. Es ruft je nach Nutzeranfrage präzise die relevante Ebene auf, wodurch Eingabeaufforderungen optimiert werden und verhindert wird, dass irrelevanter Text die Aufmerksamkeit des Modells verwässert.
Ebene 2: Die duale System1/System2-Struktur (Ausgleich zwischen Geschwindigkeit und Tiefe)
Die Speicherverarbeitung ist in zwei unabhängige Kanäle aufgeteilt: System 1 (Tagschichtmodus) extrahiert Fakten und aktualisiert Zusammenfassungen (L1–L4) in Echtzeit – innerhalb einer Sekunde, nachdem der Nutzer die Eingabetaste gedrückt hat –, sodass die Informationen für das nächste Gespräch bereitstehen; System 2 (Nachtschichtmodus) läuft asynchron im Hintergrund und benötigt Sekunden bis Minuten, um die mentalen Modelle und Wissensnetzwerke des Nutzers (L5–L6) tiefgreifend zu konsolidieren, wodurch der Agent im Laufe der Zeit intelligenter wird, ohne den Hauptprozess zu blockieren.
Ebene 3: Der evolutionäre Kettenmechanismus (Erhaltung kausaler Spuren)
Dies ist die Geheimwaffe von Hy-Memory. Wenn Nutzer ihre Ansichten oder Gewohnheiten ändern, „überschreiben“ herkömmliche Systeme entweder „das Alte mit dem Neuen“ und verlieren dabei historische Erfahrungen oder sie „stapeln sich ungeordnet an“, was zu fehlerhaften Abrufen führt. Hy-Memory verknüpft neue und alte Erinnerungen über den „Supersedes -Zeiger“ zu einer „evolutionären Kette“. Sobald ein beliebiger Knoten in der Kette ausgelöst wird, entfaltet sich der gesamte evolutionäre Pfad automatisch. Der Agent erinnert sich nicht nur an die jüngste Schlussfolgerung des Nutzers, sondern lässt auch die gesamte Entwicklung seiner Einstellung Revue passieren und vermeidet so frühere „Fallstricke“.
Extreme Leistung und schnelle Bereitstellung in 5 Minuten
Was die Leistung angeht, erreicht Hy-Memory ultraschnelle Schreibgeschwindigkeiten, die mit mem0 vergleichbar sind (8-mal schneller als Graphiti), und benötigt dabei nur ein Drittel der Speicherplätze. Es nutzt standardmäßig lokalen eingebetteten Speicher, und es sind weder eine Docker-Bereitstellung noch externe Dienste oder eine Qdrant-Datenbank erforderlich – die Daten werden automatisch lokal gespeichert.
Um sich an unterschiedliche Hardware- und Anwendungsanforderungen anzupassen, bietet Hy-Memory die Konfigurationen „Lite“ (Lightweight), „Pro“ (Professional) und „Ultra“ (Ultimate) an. Diese drei Stufen nutzen dasselbe SDK, und der Wechsel zwischen ihnen erfolgt nahtlos durch einfaches Umstellen von Schaltern. Das Projekt ist offiziell gestartet, und Nutzer finden weitere Anleitungen auf der offiziellen Website oder in der Benutzerdokumentation .
Verwandter Artikel
 ByteDances Seed startet globale Campus-Werbung und bietet virtuelle Aktien, um Top-Talente für große Modelle zu gewinnen
Im wettbewerbsintensiven Umfeld der großen Sprachmodelle bleibt die Sicherung erstklassiger Talente das wichtigste strategische Asset.Am 1. April ByteDance gab die Einführung seiner globalen Campus-Rekrutierungsinitiative Seed bekannt, die Teil seine
Suno fügt Wasserzeichen in Songs ein, während Rechtsstreitigkeiten andauern
Suno, die Plattform, die es Nutzern ermöglicht, KI-generierte Musik zu erstellen, hat neue Funktionen vorgestellt, um plattformproduzierte Tracks zu kennzeichnen, Downloads einzuschränken und die Community-Richtlinien zu aktualisieren, um unbefugte K
Musk räumt ein, dass Grok-Build Benutzercode geleakt hat, verspricht aber, alle historischen Daten zu löschen
Elon Musk wandte sich direkt an die Datenschutzkontroverse um Grok Build, beginnend mit einem einfachen „True“, um die Gültigkeit des Vorfalls zu bestätigen. Er versprach, dass alle zuvor bei SpaceXAI hochgeladenen Benutzerdaten unwiderruflich gelösc
Empfehlungen zu verwandten Spezialthemen
Design & Kunst
 KI-basierte Tools zur Referenzierung visueller Stile für Charakterbeschreibungen, Moodboards und Pitch-Präsentationen
Die besten KI-Tools für visuelle Stile im Jahr 2026 – für Charakterbögen, Moodboards und Pitch-Decks – finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Liste der bestbewerteten Tools enthält leistungsstarke, bahnbrechende Lösungen, die strengen Praxistests unterzogen wurden. Hier finden Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings sowie Optionen, die Sie unbedingt ausprobieren sollten, um Ihre Kreativität zu steigern und Ihren Arbeitsablauf zu optimieren. Stöbern Sie jetzt und entdecken Sie das perfekte Tool zur Steigerung Ihrer Produktivität!
 11 Tools
 xix.ai
SEO
Die besten KI-Tools zur SERP-Analyse für die Suchstrategie
Die besten und am besten bewerteten KI-Tools zur SERP-Analyse für Suchstrategien im Jahr 2026 wurden von XIX.AI anhand strenger Praxistests und wöchentlich aktualisierter Rankings zusammengestellt. Diese leistungsstarken Tools helfen Ihnen dabei, verborgene Optimierungsmöglichkeiten aufzudecken, die Performance Ihrer Inhalte zu steigern und sich einen Wettbewerbsvorteil in der Suche zu verschaffen. Entdecken Sie noch heute das perfekte Tool, um Ihre Suchstrategie auf ein neues Niveau zu heben. Jetzt entdecken!
13 Tools
xix.ai
Datenanalyse
Die besten KI-Tools zur Erkennung von Anomalien für das KPI-Monitoring in SaaS- und E-Commerce-Teams
2026 Neueste Besten Top-bewertete KI-Anomalienerkennungstools für KPI-Monitoring in SaaS- und E-Commerce-Teams! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung basierend auf strengen realen Tests und wöchentlich aktualisierten Rankings zusammengestellt. Sie finden detaillierte kostenlose vs. kostenpflichtige Vergleichsinsights, die Ihnen helfen, die unbedingt auszuprobierende Lösung zu identifizieren, die die Produktivität steigert und Ihre KI-Vorteile freischaltet. Jetzt erkunden!
10 Tools
xix.ai
Schreiben
Die besten KI-Generatoren für Gliederungen von langen SEO-Artikeln
Die besten und am besten bewerteten KI-Outline-Generatoren für lange SEO-Artikel im Jahr 2026, sorgfältig zusammengestellt von XIX.AI. Diese leistungsstarken Tools bieten bahnbrechende Unterstützung bei der schnellen Erstellung hochwertiger Inhalte und steigern die Effizienz beim Schreiben erheblich. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, damit Sie die für Sie passende Option finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai
Bildung und Lernen
KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung
Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai
Musikkomposition
KI-Stimm-Demo-Tools für Songwriter, Hooks, Toplines und mehrsprachige Entwurfs-Sessions
2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai

 Kommentare (0)
KI-Agenten für die langfristige Zusammenarbeit durchlaufen oft einen frustrierenden „Drei-Wochen-Verlauf“: In der ersten Woche beeindrucken sie, in der zweiten Woche macht sich Unbehagen breit, da Gedächtnislücken und Abweichungen im Verständnis offensichtlich werden, und in der dritten Woche verkommen sie zu einfachen Tools für Sofortabfragen. Um die Herausforderungen fragmentierter Erinnerungen und chaotischer Zeitachsen bei längerer Zusammenarbeit zu bewältigen, hat Tencent Hunyuan heute (28. Mai 2026) „Hy-Memory“ vorgestellt, ein intelligentes Speicher-Plugin, das speziell für langfristig zusammenarbeitende Agenten wie Openclaw entwickelt wurde – Hy-Memory.
Als „zweites Gehirn“ eines Agenten übertrifft Hy-Memory dank dreier Kerntechnologien die gängigen Frameworks bei den maßgeblichen öffentlichen Benchmarks LongMemEval und PersonaMem. Auswertungsdaten zeigen, dass Hy-Memory das Speichervolumen um über 70 % reduziert und gleichzeitig die Informationsdichte pro Speicherplatz um mehr als 45 % erhöht; bei der Verarbeitung langer Kontexte sinkt der Token-Verbrauch um 35 % und die Geschwindigkeit der Speicheraktualisierung verbessert sich um 20 %.
Drei Kerntechnologien, die den KI-Speichermechanismus neu gestalten
Ebene 1: Das sechsstufige Speicher-Framework (präzise Platzierung)
Hy-Memory vermeidet es, alle Informationen auf einmal in die Vektordatenbank zu laden. Stattdessen gliedert es den Speicher in sechs Ebenen auf: L1-Rohdaten, L2-atomare Fakten, L3-Identitätsprofile, L4-Sitzungszusammenfassungen, L5-mentale Modelle und L6-zukünftige Absichten. Es ruft je nach Nutzeranfrage präzise die relevante Ebene auf, wodurch Eingabeaufforderungen optimiert werden und verhindert wird, dass irrelevanter Text die Aufmerksamkeit des Modells verwässert.
Ebene 2: Die duale System1/System2-Struktur (Ausgleich zwischen Geschwindigkeit und Tiefe)
Die Speicherverarbeitung ist in zwei unabhängige Kanäle aufgeteilt: System 1 (Tagschichtmodus) extrahiert Fakten und aktualisiert Zusammenfassungen (L1–L4) in Echtzeit – innerhalb einer Sekunde, nachdem der Nutzer die Eingabetaste gedrückt hat –, sodass die Informationen für das nächste Gespräch bereitstehen; System 2 (Nachtschichtmodus) läuft asynchron im Hintergrund und benötigt Sekunden bis Minuten, um die mentalen Modelle und Wissensnetzwerke des Nutzers (L5–L6) tiefgreifend zu konsolidieren, wodurch der Agent im Laufe der Zeit intelligenter wird, ohne den Hauptprozess zu blockieren.
Ebene 3: Der evolutionäre Kettenmechanismus (Erhaltung kausaler Spuren)
Dies ist die Geheimwaffe von Hy-Memory. Wenn Nutzer ihre Ansichten oder Gewohnheiten ändern, „überschreiben“ herkömmliche Systeme entweder „das Alte mit dem Neuen“ und verlieren dabei historische Erfahrungen oder sie „stapeln sich ungeordnet an“, was zu fehlerhaften Abrufen führt. Hy-Memory verknüpft neue und alte Erinnerungen über den „Supersedes -Zeiger“ zu einer „evolutionären Kette“. Sobald ein beliebiger Knoten in der Kette ausgelöst wird, entfaltet sich der gesamte evolutionäre Pfad automatisch. Der Agent erinnert sich nicht nur an die jüngste Schlussfolgerung des Nutzers, sondern lässt auch die gesamte Entwicklung seiner Einstellung Revue passieren und vermeidet so frühere „Fallstricke“.
Extreme Leistung und schnelle Bereitstellung in 5 Minuten
Was die Leistung angeht, erreicht Hy-Memory ultraschnelle Schreibgeschwindigkeiten, die mit mem0 vergleichbar sind (8-mal schneller als Graphiti), und benötigt dabei nur ein Drittel der Speicherplätze. Es nutzt standardmäßig lokalen eingebetteten Speicher, und es sind weder eine Docker-Bereitstellung noch externe Dienste oder eine Qdrant-Datenbank erforderlich – die Daten werden automatisch lokal gespeichert.
Um sich an unterschiedliche Hardware- und Anwendungsanforderungen anzupassen, bietet Hy-Memory die Konfigurationen „Lite“ (Lightweight), „Pro“ (Professional) und „Ultra“ (Ultimate) an. Diese drei Stufen nutzen dasselbe SDK, und der Wechsel zwischen ihnen erfolgt nahtlos durch einfaches Umstellen von Schaltern. Das Projekt ist offiziell gestartet, und Nutzer finden weitere Anleitungen auf der








 ByteDances Seed startet globale Campus-Werbung und bietet virtuelle Aktien, um Top-Talente für große Modelle zu gewinnen
Im wettbewerbsintensiven Umfeld der großen Sprachmodelle bleibt die Sicherung erstklassiger Talente das wichtigste strategische Asset.Am 1. April ByteDance gab die Einführung seiner globalen Campus-Rekrutierungsinitiative Seed bekannt, die Teil seine
 Suno fügt Wasserzeichen in Songs ein, während Rechtsstreitigkeiten andauern
Suno, die Plattform, die es Nutzern ermöglicht, KI-generierte Musik zu erstellen, hat neue Funktionen vorgestellt, um plattformproduzierte Tracks zu kennzeichnen, Downloads einzuschränken und die Community-Richtlinien zu aktualisieren, um unbefugte K
 Musk räumt ein, dass Grok-Build Benutzercode geleakt hat, verspricht aber, alle historischen Daten zu löschen
Elon Musk wandte sich direkt an die Datenschutzkontroverse um Grok Build, beginnend mit einem einfachen „True“, um die Gültigkeit des Vorfalls zu bestätigen. Er versprach, dass alle zuvor bei SpaceXAI hochgeladenen Benutzerdaten unwiderruflich gelösc

Die besten KI-Tools für visuelle Stile im Jahr 2026 – für Charakterbögen, Moodboards und Pitch-Decks – finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Liste der bestbewerteten Tools enthält leistungsstarke, bahnbrechende Lösungen, die strengen Praxistests unterzogen wurden. Hier finden Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings sowie Optionen, die Sie unbedingt ausprobieren sollten, um Ihre Kreativität zu steigern und Ihren Arbeitsablauf zu optimieren. Stöbern Sie jetzt und entdecken Sie das perfekte Tool zur Steigerung Ihrer Produktivität!
11 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools zur SERP-Analyse für Suchstrategien im Jahr 2026 wurden von XIX.AI anhand strenger Praxistests und wöchentlich aktualisierter Rankings zusammengestellt. Diese leistungsstarken Tools helfen Ihnen dabei, verborgene Optimierungsmöglichkeiten aufzudecken, die Performance Ihrer Inhalte zu steigern und sich einen Wettbewerbsvorteil in der Suche zu verschaffen. Entdecken Sie noch heute das perfekte Tool, um Ihre Suchstrategie auf ein neues Niveau zu heben. Jetzt entdecken!
13 Tools
xix.ai

2026 Neueste Besten Top-bewertete KI-Anomalienerkennungstools für KPI-Monitoring in SaaS- und E-Commerce-Teams! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung basierend auf strengen realen Tests und wöchentlich aktualisierten Rankings zusammengestellt. Sie finden detaillierte kostenlose vs. kostenpflichtige Vergleichsinsights, die Ihnen helfen, die unbedingt auszuprobierende Lösung zu identifizieren, die die Produktivität steigert und Ihre KI-Vorteile freischaltet. Jetzt erkunden!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Outline-Generatoren für lange SEO-Artikel im Jahr 2026, sorgfältig zusammengestellt von XIX.AI. Diese leistungsstarken Tools bieten bahnbrechende Unterstützung bei der schnellen Erstellung hochwertiger Inhalte und steigern die Effizienz beim Schreiben erheblich. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, damit Sie die für Sie passende Option finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai

Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai

2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai












