


 Heim
Was ist EmbodiedSAM für die 3D-Gliederung in Echtzeit? 2025 Leitfaden und Anwendungsfälle.
In der dynamischen Welt der künstlichen Intelligenz ist die Fähigkeit eines KI-Systems, die physische Welt wahrzunehmen und sich mit ihr auseinanderzusetzen, entscheidend. EmbodiedSAM, ein hochmodernes Modell, bringt den Bereich der 3D-Objektsegmentierung in Echtzeit voran. Dieses neuartige System nutzt Erkenntnisse aus leistungsstarken 2D-Vision-Modellen, um eine schnelle und genaue Objekterkennung und -umrandung zu ermöglichen, selbst in völlig neuen Szenen. In diesem Artikel werden die Hauptmerkmale, die Methodik und die Leistung von EmbodiedSAM erläutert und sein Potenzial für die Umgestaltung zahlreicher Anwendungen hervorgehoben.
Wesentliche Merkmale von EmbodiedSAM
EmbodiedSAM ist ein innovatives KI-System, das für die Segmentierung von 3D-Objekten in Echtzeit entwickelt wurde.
Es lernt, 3D-Szenen zu interpretieren, indem es das Wissen aus vorher trainierten 2D-Vision-Modellen nutzt.
Das System liefert schnelle und präzise Objektumrisse, selbst in unbekannten Umgebungen.
Die Architektur von EmbodiedSAM verwendet ein geometrisch orientiertes Abfrage-Lifting-Modul für ein besseres 3D-Verständnis.
Zusätzliche Trainingsaufgaben werden verwendet, um Objektbeschreibungen zu verfeinern und Zusammenführungsstrategien zu verbessern.
Leistungskennzahlen zeigen, dass EmbodiedSAM frühere 3D-SAM-Methoden sowohl in der Genauigkeit als auch in der Geschwindigkeit übertrifft.
Es zeigt eine starke Generalisierung über verschiedene Datensätze und Szenarien hinweg.
EmbodiedSAM kommt Echtzeit-Roboterinteraktion und verkörperten KI-Anwendungen zugute.
Verständnis von EmbodiedSAM: Die nächste Generation der 3D-Wahrnehmung
Was ist EmbodiedSAM?
EmbodiedSAM (ESAM) ist ein KI-System, das für die Segmentierung von 3D-Instanzen in Echtzeit entwickelt wurde. Es ermöglicht KI-Agenten, einzelne 3D-Objekte in ihrer Umgebung dynamisch zu identifizieren und zu umreißen. Diese Fähigkeit ist von grundlegender Bedeutung für die verkörperte KI, die sich auf die Entwicklung von Systemen konzentriert, die auf intelligente Weise mit der physischen Welt interagieren. Die Kerninnovation von EmbodiedSAM ist die Fähigkeit, Wissen aus 2D-Vision-Grundmodellen zu übertragen. Die herkömmliche 3D-Wahrnehmung hängt oft von großen, kostspielig zu beschaffenden 3D-Datensätzen ab. EmbodiedSAM überwindet diese Einschränkung, indem es vortrainierte KI-Modelle, die umfangreiche visuelle Repräsentationen aus großen 2D-Bildsammlungen gelernt haben, auf intelligente Weise anpasst.
Das System verarbeitet Live-RGBD-Videoströme, die sowohl Farb- als auch Tiefeninformationen enthalten. Diese Tiefendaten liefern wichtige geometrische Informationen über die Szene. Durch die Verschmelzung von Erkenntnissen aus 2D-Modellen mit diesen Geometriedaten erreicht EmbodiedSAM ein effizientes und skalierbares 3D-Szenenverständnis.
Die innovative Methode hinter EmbodiedSAM
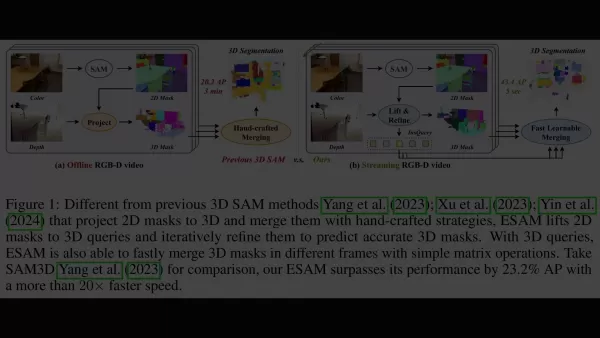
Die Grundlage der EmbodiedSAM-Architektur stellt eine Abkehr von früheren 3D-SAM-Ansätzen dar. Anstatt 2D-Masken einfach mit festen Regeln in den 3D-Raum zu projizieren, hebt EmbodiedSAM 2D-Masken in lernfähige 3D-Abfragen auf.
Hier ist eine Aufschlüsselung dieses Prozesses:
- 2D-Maskengenerierung mit SAM: Zunächst wird das Segment Anything Model (SAM) verwendet, um 2D-Instanzmasken (Objektumrisse) aus der Videoeingabe zu erzeugen.
- Geometrisch orientiertes Query Lifting: Ein Schlüsselmodul wandelt diese 2D-Masken dann in 3D-Abfragen um, wobei ihre detaillierten Forminformationen sorgfältig erhalten bleiben.
- Zweistufige Decoder-Verfeinerung: Diese 3D-Abfragen (Qt) werden von einem zweistufigen Decoder verfeinert, der Cross-Attention einsetzt, um präzise, punktuelle 3D-Masken zu erzeugen.
- Schnelle Abfrage-Zusammenführung: Schließlich werden die 3D-Masken mit einer effizienten Strategie zusammengeführt, die Informationen aus früheren Frames einbezieht, um eine konsistente Objektverfolgung über die Zeit zu gewährleisten.
Wie Yang et al. (2023) berichten, führt dieser Ansatz zu einer Verbesserung der durchschnittlichen Genauigkeit um 23,2 % und arbeitet mehr als 20 Mal schneller als frühere Methoden.
Wichtige architektonische Komponenten von EmbodiedSAM
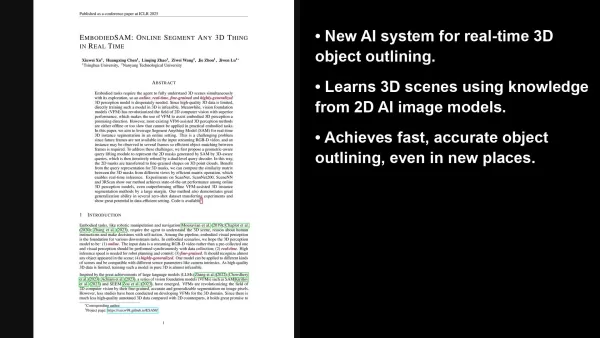
Die Effektivität von EmbodiedSAM ergibt sich aus dem Zusammenspiel mehrerer wichtiger Architekturkomponenten:
- Vision Foundation Models (VFMs): Es nutzt leistungsstarke vortrainierte 2D-Vision-Modelle und passt deren Wissen für 3D-Aufgaben an.
- Geometrisch orientiertes Query Lifting: Dieses Modul hebt 2D-Instanzmasken auf 3D-Abfragen an, wobei feinkörnige geometrische Details erhalten bleiben.
- Zweistufiger Decoder: Der Decoder verfeinert 3D-Abfragen, ermöglicht eine effektive Cross-Attention und erzeugt genaue punktuelle Segmentierungsmasken.
- Strategie zur Zusammenführung von Abfragen: Eine effiziente Merging-Strategie integriert Informationen über Videobilder hinweg für eine stabile und konsistente Objektverfolgung.
Verfeinerung von 3D-Abfragen: Die Rolle von Hilfsaufgaben
Hilfsaufgaben für verbesserte Leistung
EmbodiedSAM verfeinert seine 3D-Abfragen weiter durch zusätzliche Trainingsaufgaben. Diese spezialisierten Aufgaben helfen dabei, Objektbeschreibungen zu schärfen und den Zusammenführungsprozess zu verbessern. Es werden drei primäre Hilfsaufgaben verwendet:
- Geometrische Hilfsaufgabe: Konzentriert sich auf die Erfassung der gesamten 3D-Form eines Objekts, um sicherzustellen, dass die Abfragen seine Form genau wiedergeben.
- Kontrastive Hilfsaufgabe: Hilft bei der Unterscheidung zwischen verschiedenen Objektinstanzen, indem sie die Unähnlichkeit zwischen ihren Darstellungen erhöht.
- Semantische Hilfsaufgabe: Bezieht Informationen zur Objektkategorie ein (z. B. Stuhl, Tisch), um das Verständnis der Szene und die Erkennung zu verbessern.
Zusammen erzeugen diese Aufgaben deutlichere numerische Darstellungen für jedes Objekt. Das System vergleicht diese Repräsentationen dann effizient, filtert unwahrscheinliche Übereinstimmungen heraus und verwendet bipartite Matching, um die korrekten Korrespondenzen für die Objektverfolgung zu ermitteln.
Erschwingliches EmbodiedSAM
EmbodiedSAM Preistabelle
Da EmbodiedSAM derzeit ein Forschungsrahmenwerk ist, das in einer akademischen Arbeit vorgestellt wird, ist es nicht als kommerzielles SaaS-Produkt mit Standardpreisen erhältlich.
Plan Name Kosten Funktionen LiteFreeEingeschränkte Objekterkennung, grundlegende 3D-KonturierungProfessional$49/MonatErweiterte Objekterkennung, Echtzeit-FunktionenEnterpriseCustomHigh-Volume-Verarbeitung, dedizierter SupportEmbodiedSAM: Abwägung der Vor- und Nachteile
Vorteile
Ermöglicht zeitnahe Interaktion mit physischen Umgebungen durch 3D-Objektsegmentierung in Echtzeit.
Verringert die Abhängigkeit von teuren 3D-Datensätzen durch Nutzung vorhandener 2D-Vision-Modelle.
Zeigt starke Anpassungsfähigkeit und Generalisierung auf neue, unbekannte Umgebungen.
Das geometrisch ausgerichtete Abfrage-Lifting-Modul verbessert das räumliche 3D-Verständnis erheblich.
Effizientes Zusammenführen von Abfragen gewährleistet eine reibungslose und effektive Objektverfolgung im Zeitverlauf.
Zusätzliche Trainingsaufgaben tragen zu einer höheren Erkennungsqualität und Robustheit bei.
Nachteile
Die anfängliche Integration und Anpassung an bestehende Systeme kann eine Lernkurve aufweisen.
Die Leistung kann, wie bei jedem KI-Modell, von der Qualität und Vielfalt der Trainingsdaten beeinflusst werden.
Erkunden Sie die Kernfunktionen von EmbodiedSAM
Die innovativen Fähigkeiten von EmbodiedSAM
EmbodiedSAM bietet eine Reihe leistungsstarker Funktionen, die es zu einem der führenden Systeme für 3D-Wahrnehmung machen.
- 3D-Objekt-Segmentierung in Echtzeit: Sofortige Objekterkennung und -konturierung in Echtzeit.
- 2D-Wissen für 3D-Szenenverständnis: Überträgt das Wissen von vorab trainierten 2D-KI-Modellen und umgeht so die Notwendigkeit umfangreicher 3D-Datensätze.
- Generalisierungsfähigkeiten: Behält seine hohe Leistung in neuen und unbekannten Umgebungen bei und zeigt so seine robuste Anpassungsfähigkeit.
- Effiziente Zusammenführung von Suchanfragen: Bietet eine kontinuierliche, stabile Objektverfolgung über Videosequenzen hinweg.
EmbodiedSAM Anwendungsfälle
Die Anwendungen von EmbodiedSAM
EmbodiedSAM eröffnet neue Möglichkeiten in einer Reihe von Branchen und Anwendungen:
- Robotik: Ermöglicht es Robotern, Objekte in ihrer Umgebung intelligenter wahrzunehmen und zu manipulieren.
- Erweiterte Realität (AR): Ermöglicht eine präzisere und stabilere Platzierung von virtuellen Grafiken auf realen Objekten.
- Autonome Fahrzeuge: Verbessert das Szenenverständnis und die Objekterkennung für eine sicherere Navigation.
- Videoanalyse in Echtzeit: Bietet sofortige Objekterkennung und Segmentierungserkenntnisse für Live-Videoübertragungen und Überwachungen.
Häufig gestellte Fragen zu EmbodiedSAM
Wodurch unterscheidet sich EmbodiedSAM von anderen 3D-Wahrnehmungssystemen?
EmbodiedSAM nutzt in einzigartiger Weise das Wissen aus vortrainierten 2D-Sichtmodellen und ermöglicht so eine schnelle, genaue 3D-Segmentierung, die sich ohne umfangreiche 3D-Trainingsdaten gut auf neue Umgebungen übertragen lässt.
Wie erreicht EmbodiedSAM die Echtzeitleistung?
Es nutzt optimierte Matrixoperationen und eine optimierte Architektur, die für die Hochgeschwindigkeitsverarbeitung von Videoströmen ausgelegt ist.
Welche Art von Daten verwendet EmbodiedSAM?
EmbodiedSAM verarbeitet Live-RGBD-Video, das Standardfarbinformationen (RGB) mit Tiefeninformationen (D) pro Pixel kombiniert.
Wie bewältigt EmbodiedSAM die Objekterkennung in unbekannten Umgebungen?
Dank seines Designs und Trainings zeigt EmbodiedSAM eine starke Generalisierung, passt sich effektiv an verschiedene Datensätze an und behält die Genauigkeit in neuen Szenen bei.
Wie genau ist EmbodiedSAM bei der Erkennung von Objekten?
EmbodiedSAM erreicht hohe Werte bei Standardmetriken wie der durchschnittlichen Präzision (AP) und beweist damit seine Genauigkeit bei der Identifizierung und Segmentierung von Objekten in 3D.
Weitere Einblicke: Erforschung verwandter Fragen zu EmbodiedSAM
Wie trägt das geometrisch orientierte Query Lifting zur Leistung von EmbodiedSAM bei?
Das geometrisch orientierte Query-Lifting-Modul ist entscheidend für das genaue 3D-Verständnis. Es wandelt 2D-Masken in 3D-Abfragen um und bewahrt dabei detaillierte Forminformationen, was zu einer präziseren Objektsegmentierung und -umrandung führt.
Welche Rolle spielen die Hilfsaufgaben bei der Verfeinerung der Objektbeschreibungen?
Hilfsaufgaben fungieren als spezielle Trainingsziele, die die Objektdarstellungen verfeinern und den Zusammenführungsprozess verbessern. Geometrische, kontrastive und semantische Aufgaben arbeiten zusammen, um differenziertere und informativere Objektdeskriptoren zu erstellen.
Welche Leistungskennzahlen werden verwendet, um die Effektivität von EmbodiedSAM zu bewerten?
EmbodiedSAM wird anhand von Objekterkennungsmetriken wie Average Precision (AP, AP50, AP25) zur Messung der Segmentierungsgenauigkeit und Frames per Second (FPS) zur Messung der Verarbeitungsgeschwindigkeit in Echtzeit bewertet.
Verwandter Artikel
 Südkorea beginnt mit dem Bau des nationalen KI-Rechenzentrums und investiert 2,5 Billionen Won mit einem Zieljahr von 2028
Der südkoreanische Ableger von EtNews berichtet, dass am 3. August im Solar City-Datenzentrumspark in Sunan, Provinz Jeollanam-do, der Grundstein für das Korea AI Computing Center (KOACC) gelegt wurde. Mit einer Gesamtinvestition von 2,5 Billionen KR
Sechs Tech-Giganten unterstützen die Linux Foundation mit 12,5 Millionen US-Dollar, um das Rauschen bei KI-Schwachstellen zu bekämpfen
Um der Flut von Sicherheitsberichten niedriger Qualität, die durch KI-Automatisierungstools erzeugt werden, zu begegnen, haben sechs große Technologieunternehmen – Anthropic, Amazon (AWS), GitHub, Google, Microsoft und OpenAI – gemeinsam 12,5 Million
Musk erwog, OpenAI an seine Kinder zu übergeben, während Altman aussagte
Diesen Morgen trat OpenAI-CEO Sam Altman vor Gericht, um sich zur Klage von Ex-Mitbegründer Elon Musk zu äußern, die die Unternehmensstruktur der Firma anfechtet.Auf die Frage nach Musks Behauptung, andere Mitbegründer hätten „eine Wohltätigkeitsorg
Empfehlungen zu verwandten Spezialthemen
Musikkomposition
 KI-Stimm-Demo-Tools für Songwriter, Hooks, Toplines und mehrsprachige Entwurfs-Sessions
2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
 9 Tools
 xix.ai
Geschäft
Die besten KI-Tools zur Wettbewerbsanalyse für kleine Unternehmen
Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai
Bildbearbeitung
Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonstanz
2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai
Prompt
Die besten KI-Prompt-Bibliotheken für ChatGPT-Workflows
Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai
Bildung und Lernen
AI Quiz Builder Plattformen für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme
2026 Neueste und beste KI-Quiz-Erstellungstools für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die realen Tests unterzogen wurden, um genaue Rankings zu liefern. Diese unbedingt auszuprobierenden Plattformen helfen dabei, die Schreibeffizienz zu steigern, die Inhaltserstellung zu optimieren und das Quiz-Design in allen Lernszenarien zu vereinfachen. Entdecken Sie jetzt Ihr perfektes Tool, um Ihren KI-Vorteil im Unterricht voll auszuschöpfen!
13 Tools
xix.ai
Code
KI-Tools zur Überprüfung von Pull-Requests für GitHub-Teams, die sich mit Refactorings, Fehlern und Sicherheitslücken befassen
Die besten neuen KI-Tools zur Pull-Request-Prüfung für GitHub-Teams im Jahr 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Liste mit den besten Bewertungen präsentiert leistungsstarke, bahnbrechende Lösungen, die Refactoring, Fehlerbehebung und die Erkennung von Sicherheitslücken in allen Team-Workflows optimieren. Profitieren Sie von einem Vergleich zwischen kostenlosen und kostenpflichtigen Tools sowie von Praxistests und detaillierten Rankings, die Ihnen helfen, das perfekte Tool zu finden, mit dem Sie Ihre Produktivität deutlich steigern können. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Vorteil!
12 Tools
xix.ai

 Kommentare (1)
![HarryLewis]()
정말 흥미로운 기술이네요. 🤔 EmbodiedSAM이 어떻게 실시간 3D 물체 인식 속도를 개선하는지 제조 산업에 어떤 영향을 줄지 궁금해졌습니다. 단순히 기술적 설명만 있는 듯했는데, 실제 사용 사례가 더 자세히 나왔으면 더 도움이 됐을 거 같아요. 아무튼 AI가 물리 세계를 이해하는 방식이 이렇게 진화하고 있다는 게 참 놀랍습니다!
In der dynamischen Welt der künstlichen Intelligenz ist die Fähigkeit eines KI-Systems, die physische Welt wahrzunehmen und sich mit ihr auseinanderzusetzen, entscheidend. EmbodiedSAM, ein hochmodernes Modell, bringt den Bereich der 3D-Objektsegmentierung in Echtzeit voran. Dieses neuartige System nutzt Erkenntnisse aus leistungsstarken 2D-Vision-Modellen, um eine schnelle und genaue Objekterkennung und -umrandung zu ermöglichen, selbst in völlig neuen Szenen. In diesem Artikel werden die Hauptmerkmale, die Methodik und die Leistung von EmbodiedSAM erläutert und sein Potenzial für die Umgestaltung zahlreicher Anwendungen hervorgehoben.
Wesentliche Merkmale von EmbodiedSAM
EmbodiedSAM ist ein innovatives KI-System, das für die Segmentierung von 3D-Objekten in Echtzeit entwickelt wurde.
Es lernt, 3D-Szenen zu interpretieren, indem es das Wissen aus vorher trainierten 2D-Vision-Modellen nutzt.
Das System liefert schnelle und präzise Objektumrisse, selbst in unbekannten Umgebungen.
Die Architektur von EmbodiedSAM verwendet ein geometrisch orientiertes Abfrage-Lifting-Modul für ein besseres 3D-Verständnis.
Zusätzliche Trainingsaufgaben werden verwendet, um Objektbeschreibungen zu verfeinern und Zusammenführungsstrategien zu verbessern.
Leistungskennzahlen zeigen, dass EmbodiedSAM frühere 3D-SAM-Methoden sowohl in der Genauigkeit als auch in der Geschwindigkeit übertrifft.
Es zeigt eine starke Generalisierung über verschiedene Datensätze und Szenarien hinweg.
EmbodiedSAM kommt Echtzeit-Roboterinteraktion und verkörperten KI-Anwendungen zugute.
Verständnis von EmbodiedSAM: Die nächste Generation der 3D-Wahrnehmung
Was ist EmbodiedSAM?
EmbodiedSAM (ESAM) ist ein KI-System, das für die Segmentierung von 3D-Instanzen in Echtzeit entwickelt wurde. Es ermöglicht KI-Agenten, einzelne 3D-Objekte in ihrer Umgebung dynamisch zu identifizieren und zu umreißen. Diese Fähigkeit ist von grundlegender Bedeutung für die verkörperte KI, die sich auf die Entwicklung von Systemen konzentriert, die auf intelligente Weise mit der physischen Welt interagieren. Die Kerninnovation von EmbodiedSAM ist die Fähigkeit, Wissen aus 2D-Vision-Grundmodellen zu übertragen. Die herkömmliche 3D-Wahrnehmung hängt oft von großen, kostspielig zu beschaffenden 3D-Datensätzen ab. EmbodiedSAM überwindet diese Einschränkung, indem es vortrainierte KI-Modelle, die umfangreiche visuelle Repräsentationen aus großen 2D-Bildsammlungen gelernt haben, auf intelligente Weise anpasst.
Das System verarbeitet Live-RGBD-Videoströme, die sowohl Farb- als auch Tiefeninformationen enthalten. Diese Tiefendaten liefern wichtige geometrische Informationen über die Szene. Durch die Verschmelzung von Erkenntnissen aus 2D-Modellen mit diesen Geometriedaten erreicht EmbodiedSAM ein effizientes und skalierbares 3D-Szenenverständnis.
Die innovative Methode hinter EmbodiedSAM
Die Grundlage der EmbodiedSAM-Architektur stellt eine Abkehr von früheren 3D-SAM-Ansätzen dar. Anstatt 2D-Masken einfach mit festen Regeln in den 3D-Raum zu projizieren, hebt EmbodiedSAM 2D-Masken in lernfähige 3D-Abfragen auf.
Hier ist eine Aufschlüsselung dieses Prozesses:
- 2D-Maskengenerierung mit SAM: Zunächst wird das Segment Anything Model (SAM) verwendet, um 2D-Instanzmasken (Objektumrisse) aus der Videoeingabe zu erzeugen.
- Geometrisch orientiertes Query Lifting: Ein Schlüsselmodul wandelt diese 2D-Masken dann in 3D-Abfragen um, wobei ihre detaillierten Forminformationen sorgfältig erhalten bleiben.
- Zweistufige Decoder-Verfeinerung: Diese 3D-Abfragen (Qt) werden von einem zweistufigen Decoder verfeinert, der Cross-Attention einsetzt, um präzise, punktuelle 3D-Masken zu erzeugen.
- Schnelle Abfrage-Zusammenführung: Schließlich werden die 3D-Masken mit einer effizienten Strategie zusammengeführt, die Informationen aus früheren Frames einbezieht, um eine konsistente Objektverfolgung über die Zeit zu gewährleisten.
Wie Yang et al. (2023) berichten, führt dieser Ansatz zu einer Verbesserung der durchschnittlichen Genauigkeit um 23,2 % und arbeitet mehr als 20 Mal schneller als frühere Methoden.
Wichtige architektonische Komponenten von EmbodiedSAM
Die Effektivität von EmbodiedSAM ergibt sich aus dem Zusammenspiel mehrerer wichtiger Architekturkomponenten:
- Vision Foundation Models (VFMs): Es nutzt leistungsstarke vortrainierte 2D-Vision-Modelle und passt deren Wissen für 3D-Aufgaben an.
- Geometrisch orientiertes Query Lifting: Dieses Modul hebt 2D-Instanzmasken auf 3D-Abfragen an, wobei feinkörnige geometrische Details erhalten bleiben.
- Zweistufiger Decoder: Der Decoder verfeinert 3D-Abfragen, ermöglicht eine effektive Cross-Attention und erzeugt genaue punktuelle Segmentierungsmasken.
- Strategie zur Zusammenführung von Abfragen: Eine effiziente Merging-Strategie integriert Informationen über Videobilder hinweg für eine stabile und konsistente Objektverfolgung.
Verfeinerung von 3D-Abfragen: Die Rolle von Hilfsaufgaben
Hilfsaufgaben für verbesserte Leistung
EmbodiedSAM verfeinert seine 3D-Abfragen weiter durch zusätzliche Trainingsaufgaben. Diese spezialisierten Aufgaben helfen dabei, Objektbeschreibungen zu schärfen und den Zusammenführungsprozess zu verbessern. Es werden drei primäre Hilfsaufgaben verwendet:
- Geometrische Hilfsaufgabe: Konzentriert sich auf die Erfassung der gesamten 3D-Form eines Objekts, um sicherzustellen, dass die Abfragen seine Form genau wiedergeben.
- Kontrastive Hilfsaufgabe: Hilft bei der Unterscheidung zwischen verschiedenen Objektinstanzen, indem sie die Unähnlichkeit zwischen ihren Darstellungen erhöht.
- Semantische Hilfsaufgabe: Bezieht Informationen zur Objektkategorie ein (z. B. Stuhl, Tisch), um das Verständnis der Szene und die Erkennung zu verbessern.
Zusammen erzeugen diese Aufgaben deutlichere numerische Darstellungen für jedes Objekt. Das System vergleicht diese Repräsentationen dann effizient, filtert unwahrscheinliche Übereinstimmungen heraus und verwendet bipartite Matching, um die korrekten Korrespondenzen für die Objektverfolgung zu ermitteln.
Erschwingliches EmbodiedSAM
EmbodiedSAM Preistabelle
Da EmbodiedSAM derzeit ein Forschungsrahmenwerk ist, das in einer akademischen Arbeit vorgestellt wird, ist es nicht als kommerzielles SaaS-Produkt mit Standardpreisen erhältlich.
EmbodiedSAM: Abwägung der Vor- und Nachteile
Vorteile
Ermöglicht zeitnahe Interaktion mit physischen Umgebungen durch 3D-Objektsegmentierung in Echtzeit.
Verringert die Abhängigkeit von teuren 3D-Datensätzen durch Nutzung vorhandener 2D-Vision-Modelle.
Zeigt starke Anpassungsfähigkeit und Generalisierung auf neue, unbekannte Umgebungen.
Das geometrisch ausgerichtete Abfrage-Lifting-Modul verbessert das räumliche 3D-Verständnis erheblich.
Effizientes Zusammenführen von Abfragen gewährleistet eine reibungslose und effektive Objektverfolgung im Zeitverlauf.
Zusätzliche Trainingsaufgaben tragen zu einer höheren Erkennungsqualität und Robustheit bei.
Nachteile
Die anfängliche Integration und Anpassung an bestehende Systeme kann eine Lernkurve aufweisen.
Die Leistung kann, wie bei jedem KI-Modell, von der Qualität und Vielfalt der Trainingsdaten beeinflusst werden.
Erkunden Sie die Kernfunktionen von EmbodiedSAM
Die innovativen Fähigkeiten von EmbodiedSAM
EmbodiedSAM bietet eine Reihe leistungsstarker Funktionen, die es zu einem der führenden Systeme für 3D-Wahrnehmung machen.
- 3D-Objekt-Segmentierung in Echtzeit: Sofortige Objekterkennung und -konturierung in Echtzeit.
- 2D-Wissen für 3D-Szenenverständnis: Überträgt das Wissen von vorab trainierten 2D-KI-Modellen und umgeht so die Notwendigkeit umfangreicher 3D-Datensätze.
- Generalisierungsfähigkeiten: Behält seine hohe Leistung in neuen und unbekannten Umgebungen bei und zeigt so seine robuste Anpassungsfähigkeit.
- Effiziente Zusammenführung von Suchanfragen: Bietet eine kontinuierliche, stabile Objektverfolgung über Videosequenzen hinweg.
EmbodiedSAM Anwendungsfälle
Die Anwendungen von EmbodiedSAM
EmbodiedSAM eröffnet neue Möglichkeiten in einer Reihe von Branchen und Anwendungen:
- Robotik: Ermöglicht es Robotern, Objekte in ihrer Umgebung intelligenter wahrzunehmen und zu manipulieren.
- Erweiterte Realität (AR): Ermöglicht eine präzisere und stabilere Platzierung von virtuellen Grafiken auf realen Objekten.
- Autonome Fahrzeuge: Verbessert das Szenenverständnis und die Objekterkennung für eine sicherere Navigation.
- Videoanalyse in Echtzeit: Bietet sofortige Objekterkennung und Segmentierungserkenntnisse für Live-Videoübertragungen und Überwachungen.
Häufig gestellte Fragen zu EmbodiedSAM
Wodurch unterscheidet sich EmbodiedSAM von anderen 3D-Wahrnehmungssystemen?
EmbodiedSAM nutzt in einzigartiger Weise das Wissen aus vortrainierten 2D-Sichtmodellen und ermöglicht so eine schnelle, genaue 3D-Segmentierung, die sich ohne umfangreiche 3D-Trainingsdaten gut auf neue Umgebungen übertragen lässt.
Wie erreicht EmbodiedSAM die Echtzeitleistung?
Es nutzt optimierte Matrixoperationen und eine optimierte Architektur, die für die Hochgeschwindigkeitsverarbeitung von Videoströmen ausgelegt ist.
Welche Art von Daten verwendet EmbodiedSAM?
EmbodiedSAM verarbeitet Live-RGBD-Video, das Standardfarbinformationen (RGB) mit Tiefeninformationen (D) pro Pixel kombiniert.
Wie bewältigt EmbodiedSAM die Objekterkennung in unbekannten Umgebungen?
Dank seines Designs und Trainings zeigt EmbodiedSAM eine starke Generalisierung, passt sich effektiv an verschiedene Datensätze an und behält die Genauigkeit in neuen Szenen bei.
Wie genau ist EmbodiedSAM bei der Erkennung von Objekten?
EmbodiedSAM erreicht hohe Werte bei Standardmetriken wie der durchschnittlichen Präzision (AP) und beweist damit seine Genauigkeit bei der Identifizierung und Segmentierung von Objekten in 3D.
Weitere Einblicke: Erforschung verwandter Fragen zu EmbodiedSAM
Wie trägt das geometrisch orientierte Query Lifting zur Leistung von EmbodiedSAM bei?
Das geometrisch orientierte Query-Lifting-Modul ist entscheidend für das genaue 3D-Verständnis. Es wandelt 2D-Masken in 3D-Abfragen um und bewahrt dabei detaillierte Forminformationen, was zu einer präziseren Objektsegmentierung und -umrandung führt.
Welche Rolle spielen die Hilfsaufgaben bei der Verfeinerung der Objektbeschreibungen?
Hilfsaufgaben fungieren als spezielle Trainingsziele, die die Objektdarstellungen verfeinern und den Zusammenführungsprozess verbessern. Geometrische, kontrastive und semantische Aufgaben arbeiten zusammen, um differenziertere und informativere Objektdeskriptoren zu erstellen.
Welche Leistungskennzahlen werden verwendet, um die Effektivität von EmbodiedSAM zu bewerten?
EmbodiedSAM wird anhand von Objekterkennungsmetriken wie Average Precision (AP, AP50, AP25) zur Messung der Segmentierungsgenauigkeit und Frames per Second (FPS) zur Messung der Verarbeitungsgeschwindigkeit in Echtzeit bewertet.








 Südkorea beginnt mit dem Bau des nationalen KI-Rechenzentrums und investiert 2,5 Billionen Won mit einem Zieljahr von 2028
Der südkoreanische Ableger von EtNews berichtet, dass am 3. August im Solar City-Datenzentrumspark in Sunan, Provinz Jeollanam-do, der Grundstein für das Korea AI Computing Center (KOACC) gelegt wurde. Mit einer Gesamtinvestition von 2,5 Billionen KR
 Sechs Tech-Giganten unterstützen die Linux Foundation mit 12,5 Millionen US-Dollar, um das Rauschen bei KI-Schwachstellen zu bekämpfen
Um der Flut von Sicherheitsberichten niedriger Qualität, die durch KI-Automatisierungstools erzeugt werden, zu begegnen, haben sechs große Technologieunternehmen – Anthropic, Amazon (AWS), GitHub, Google, Microsoft und OpenAI – gemeinsam 12,5 Million
 Musk erwog, OpenAI an seine Kinder zu übergeben, während Altman aussagte
Diesen Morgen trat OpenAI-CEO Sam Altman vor Gericht, um sich zur Klage von Ex-Mitbegründer Elon Musk zu äußern, die die Unternehmensstruktur der Firma anfechtet.Auf die Frage nach Musks Behauptung, andere Mitbegründer hätten „eine Wohltätigkeitsorg

2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai

2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai

2026 Neueste und beste KI-Quiz-Erstellungstools für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die realen Tests unterzogen wurden, um genaue Rankings zu liefern. Diese unbedingt auszuprobierenden Plattformen helfen dabei, die Schreibeffizienz zu steigern, die Inhaltserstellung zu optimieren und das Quiz-Design in allen Lernszenarien zu vereinfachen. Entdecken Sie jetzt Ihr perfektes Tool, um Ihren KI-Vorteil im Unterricht voll auszuschöpfen!
13 Tools
xix.ai

Die besten neuen KI-Tools zur Pull-Request-Prüfung für GitHub-Teams im Jahr 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Liste mit den besten Bewertungen präsentiert leistungsstarke, bahnbrechende Lösungen, die Refactoring, Fehlerbehebung und die Erkennung von Sicherheitslücken in allen Team-Workflows optimieren. Profitieren Sie von einem Vergleich zwischen kostenlosen und kostenpflichtigen Tools sowie von Praxistests und detaillierten Rankings, die Ihnen helfen, das perfekte Tool zu finden, mit dem Sie Ihre Produktivität deutlich steigern können. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Vorteil!
12 Tools
xix.ai

정말 흥미로운 기술이네요. 🤔 EmbodiedSAM이 어떻게 실시간 3D 물체 인식 속도를 개선하는지 제조 산업에 어떤 영향을 줄지 궁금해졌습니다. 단순히 기술적 설명만 있는 듯했는데, 실제 사용 사례가 더 자세히 나왔으면 더 도움이 됐을 거 같아요. 아무튼 AI가 물리 세계를 이해하는 방식이 이렇게 진화하고 있다는 게 참 놀랍습니다!












