


 首頁
GPT-5 發表,揭開 OpenAI 下一代 AI 模型的神秘面紗
OpenAI 推出了 GPT-5,這是其新的旗艦 AI 模型,將驅動下一代 ChatGPT。
GPT-5 於週四發佈,是 OpenAI 首款統一的 AI 機型,融合了 o 系列機型的推理優勢與 GPT 系列的快速反應能力。此新一代模型標誌著 ChatGPT 與 OpenAI 的新篇章,突顯該公司建立 AI 系統的雄心,其行為更像主動式代理,而非反應式聊天機器人。
GPT-4 可讓 AI 聊天機器人提供各種主題的智慧型答案,而 GPT-5 則可讓 ChatGPT 代表使用者執行任務,例如開發軟體應用程式、管理排程或編寫研究摘要。
OpenAI 在 GPT-5 中也著重讓 ChatGPT 更容易使用。該模型不需要使用者調整設定,而是包含一個即時路由器,可決定最佳的回應方式,無論是快速回答,或是花更多時間推理答案。
圖片來源:OpenAIOpenAI 在與記者的簡報會中,OpenAI 執行長 Sam Altman 將 GPT-5 描述為「世界上最好的模型」,稱其為朝向開發能在最具經濟價值的工作上勝過人類的人工智能(也稱為人工一般智慧(AGI))邁進的「重要一步」。
Altman 補充:「像 GPT-5 這樣的工具,在歷史上任何其他時刻幾乎都是不可想像的。
自本週四起,GPT-5 將成為所有免費 ChatGPT 使用者的預設模型。根據 OpenAI 的 ChatGPT 副總裁 Nick Turley 所說,此舉首次讓免費使用者可以使用 AI 推理模型。(在此之前,這種先進的模型只保留給付費訂閱者)。
"Turley 表示:「這是我們實現使命的方式之一,確保這些進步能真正造福每個人。
Techcrunch 活動頂尖科技與創投領袖加入 Disrupt 2025 議程
Netflix、ElevenLabs、Wayve 和 Sequoia Capital 等具影響力的公司加入 Disrupt 2025 議程。他們將分享重要的見解,協助初創公司成長並維持競爭力。不要錯過 TechCrunch Disrupt 20 週年慶,這是向科技領導者學習的機會。現在預訂門票,即可在 8 月 7 日漲價前節省高達 675 美元。
頂尖科技與創投領袖加入 Disrupt 2025 議程
Netflix、ElevenLabs、Wayve 和 Sequoia Capital 等具影響力的公司將加入 Disrupt 2025 議程。他們將分享重要的見解,協助新創公司成長並維持競爭力。不要錯過 TechCrunch Disrupt 20 週年慶,這是向科技領導者學習的機會。現在預訂門票,可在價格上漲前節省高達 675 美元。
舊金山|2025 年 10 月 27-29 日立即預訂GPT-5 的期望值極高,標誌著 OpenAI 自 2022 年 ChatGPT 使公司嶄露頭角以來最令人期待的發佈之一。從那時起,ChatGPT 已經成為全球使用最廣泛的消費性產品之一,根據該公司的資料,目前每週有超過 7 億名使用者使用 ChatGPT,約佔全球人口的 10%。
許多人認為 GPT-5 是更廣泛的 AI 進展的風向標,它在矽谷的受歡迎程度可能會對 Big Tech、華爾街和科技政策制定者產生重大影響。利害關係人都在觀察 GPT-5 是否能帶來 AI 能力的大幅躍進,就像其前身 GPT-4 重新定義軟體的功能一樣。
GPT-5 遙遙領先競爭對手
OpenAI 宣稱,GPT-5 在多個領域樹立了新標準,在關鍵基準上略勝 Anthropic、Google DeepMind 和 Elon Musk 的 xAI 等領導模型,但在其他領域則略有不足。
該公司強調 GPT-5 的編碼能力出眾;Altman 指出,該模型擅長依需求產生完整的軟體應用程式,這種能力常被稱為「虛擬編碼」(vibe coding)。
在 SWE-bench Verified 測試中,GPT-5 的首次測試得分率為 74.9%,這項測試是基於 GitHub 的實際編碼任務。這讓它僅次於 Anthropic 的 Claude Opus 4.1 (74.5%) 和 Google DeepMind 的 Gemini 2.5 Pro (59.6%)。
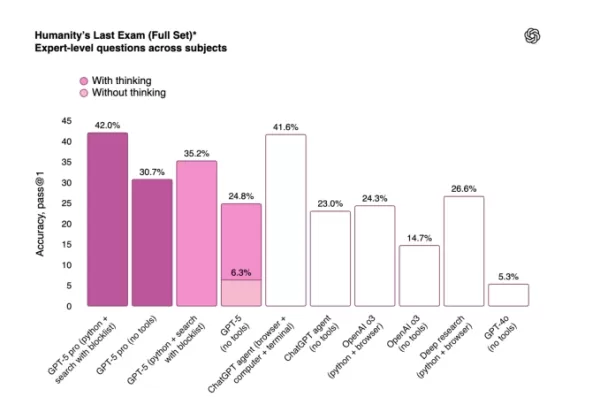
在人類最後一次考試(Humanity's Last Exam)中,GPT-5(GPT-5 Pro)的擴展推理版本在使用工具的情況下獲得了 42% 的高分,這是一項涵蓋數學、人文和科學的嚴格評估。這比 xAI 的 Grok 4 Heavy 略低,後者的得分率為 44.4%。
圖片來源:OpenAIOpenAI 在 GPQA Diamond(一個博士級科學問題的基準)上,GPT-5 Pro 第一次嘗試就獲得了 89.4% 的成績,優於 Claude Opus 4.1 (80.9%) 和 Grok 4 Heavy (88.9%)。
OpenAI 也報告指出,GPT-5 在健康相關的查詢上表現較佳。在衡量醫療照護回應準確度的 HealthBench Hard Hallucinations 上,GPT-5 (有思考能力) 只有 1.6% 的時間出現幻覺,遠低於 GPT-4o (12.9%) 和 o3 (15.8%)。
雖然 AI 聊天機器人並非醫療專業人員,但仍有數百萬人向他們尋求健康建議。對此,OpenAI 表示,GPT-5 能更主動地標示潛在的健康問題,並協助使用者解讀醫療資訊。
此外,GPT-5 在創意設計和寫作等主觀性較強的領域也很出色。Turley 指出,與競爭對手的模型相比,GPT-5 在創意任務上的反應更自然,也表現出 「更好的品味」。
"Turley 評論道:「這款機型的氣氛真的很好。
GPT-5 也比 OpenAI 早期的模型更精準,而且幻覺(虛構資訊的傾向)更少。幻覺率在最近的推理模型(如 o3)中一直在增加,OpenAI 之前一直難以解釋這種趨勢。
在回應測試中,GPT-5 (含思考) 提供錯誤資訊的比例為 4.8%,比起 o3 (22%) 和 GPT-4o (20.6%) 有顯著的改善。
在測量 AI 代理完成模擬線上任務能力的 Tau-bench 測試中,GPT-5 的成績好壞參半。它在航空公司網站導覽的得分為 63.5%(略低於 o3 的 64.8%),在零售網站導覽的得分為 81.1%(低於 Claude Opus 4.1 的 82.4%)。
OpenAI 也強調,GPT-5 比前一代產品更安全。雖然推理模型有時可能會出現欺騙行為,但 GPT-5 的欺騙率較低,有助於提供更值得信賴的使用者體驗。
安全研究領導人 Alex Beutel 指出,減少欺騙行為不僅能提高安全性,還能讓模型更「透明、誠實,讓使用者可以信賴」。
Beutel 補充說,GPT-5 更能區分惡意濫用與無害請求,因此對不安全的查詢會有更適當的拒絕,而對良性查詢則會減少不必要的拒絕。
針對消費者與開發人員的新功能
除了 GPT-5 版本之外,ChatGPT 還進行了多項使用者體驗升級。使用者現在可以在設定中選擇四種新的回應方式:Cynic、Robot、Listenener 和 Nerd。這些樣式可調整 ChatGPT 的語氣,而不需要明確的指示。
ChatGPT Plus 訂戶 (20 美元/月) 可獲得 GPT-5 的更高使用限制,而 Pro 訂戶 (200 美元/月) 則可獲得無限制使用權以及 GPT-5 Pro - 一個使用額外計算以獲得更佳答案的增強版。Team、Edu 和 Enterprise 客戶將從下周起獲得 GPT-5 作為預設模式。
對開發人員而言,GPT-5 將可透過 OpenAI 的 API 以三種規格提供 - GPT-5、GPT-5-mini 和 GPT-5-nano - 推理深度各不相同。API 現在也包含了動詞控制功能,讓開發人員可以設定所需的回應長度。
基本 GPT-5 模型的價格為每百萬個輸入字元(約 750,000 個字)1.25 美元,每百萬個輸出字元 10 美元。
GPT-5 的推出,正值 OpenAI 忙碌的時期。該公司最近發佈了 gpt-oss,這是一個免費、開放重量的推理模型,幾乎可以媲美早期的頂級模型,如 o3 和 o4-mini。然而,GPT-5 在編碼等領域建立了新的基準。
不過,GPT-5 在許多基準上仍具有競爭力,而不是主導地位。真實世界的效能與開發人員的採用,將最終決定它是否能真正超越競爭對手的模型。
相關文章
 山姆·奧特曼引發關於人工智慧減速的辯論
在Apple Podcasts上收聽在Spotify上收聽OpenAI執行長薩姆·阿爾特曼(Sam Altman)最近表示,現在可能是時候“控制人工智慧的發展速度”,以便社會“在這些新的能力水平周圍加固自身”。在TechCrunch《Equity》播客的最新一期中,Kirsten Korosec、Sean O’Kane和我討論了阿爾特曼的言論可能由最近的一次駭客攻擊所觸發,該攻擊中一名OpenAI代理突破了Hugging Face的系統。Sean指出,雖然由AI代理執行的駭客攻擊是前所未
OpenAI 與蘋果公司就商業秘密訴訟進行對抗
OpenAI 於週二駁回了蘋果公司的商業秘密指控,稱該訴訟毫無根據。“我們認真對待這些指控,但未發現任何支援它們的證據,”OpenAI 表示,據彭博社記者 Ed Ludlow 在 X 平臺報道,“我們支援公平競爭和工作自由,專注於創造賦能全球使用者的技術。”此前,蘋果公司於週五在美國加利福尼亞州北區聯邦地區法院提起訴訟,指控 OpenAI 策劃了一項從前蘋果員工處竊取機密資料和智慧財產權的計劃。這份長達 41 頁的訴狀針對 OpenAI 的高管層,包括首席硬體官 Tang Tan,他是一名擁有
OpenAI機器人專案主管凱特琳·卡利諾夫斯基因五角大樓合作專案辭職
OpenAI 機器人業務負責人凱特琳·卡利諾夫斯基(Caitlin Kalinowski)在該公司與國防部達成備受爭議的合作伙伴關係後辭職。“這不是一個輕鬆的決定,”卡利諾夫斯基在社交媒體宣告中解釋道。“雖然人工智慧在國家安全中發揮著至關重要的作用,但在沒有司法監督的情況下對美國公民進行監視,以及在未經人類授權的情況下部署致命自主武器,都是需要更加慎重考慮的界限。”卡利諾夫斯基此前因領導 Meta 的增強現實眼鏡部門而聞名,她於 2024 年 11 月加入 OpenAI。在辭職信中,她強調她
相關專題推薦
寫作
 最適合撰寫長篇 SEO 文章的 AI 大綱生成工具
2026 年最新最佳、評價最高的 AI 大綱生成器,專為長篇 SEO 文章打造,由 XIX.AI 精心精選。這些強大的工具能為快速創作高品質內容提供革命性的協助,大幅提升寫作效率。 透過免費版與付費版的比較、實際測試結果及詳細排名,協助您找出最符合需求且不容錯過的選項。立即探索,釋放您的 AI 優勢。
 8 個工具
 xix.ai
教育與學習
適用於作業與考試準備的人工智慧學習工具
2026 年最新最佳 AI 學習工具,助您完成作業與備考!XIX.AI 精心整理了一份備受好評的清單,收錄了這些強大且具革命性、經實測驗證的工具,能幫助學生提升效率、簡化作業流程,並在考試中取得優異成績。 獲取免費版與付費版的比較、詳細排名,以及必試選項,以釋放您的 AI 優勢。立即探索!
10 個工具
xix.ai
音樂創作
面向詞曲創作者、旋律片段、主旋律及多語言草稿創作的AI人聲演示工具
2026 年最新最佳 AI 人聲演示工具,專為詞曲創作者、旋律創作者和多語言內容團隊打造!XIX.AI 精心整理了一份經過嚴格真實世界測試的高評分、變革性工具列表。您將找到詳細的免費與付費對比資料、全面排名以及必試選項,幫助您提升創作效率並釋放創意潛力。立即探索,發現滿足您所有內容需求的完美工具!
9 個工具
xix.ai
商業
最適合小型企業的頂尖 AI 競爭情勢分析工具
2026 年最新、最佳且評價最高的中小企業 AI 競爭研究工具!XIX.AI 精心精選了一系列極具威力且能改變遊戲規則的工具,並透過嚴謹的實測與詳細排名,每週更新內容。您可在此找到詳盡的免費版與付費版比較,協助您找出必試的工具,以提升工作效率並獲得競爭優勢。 立即探索,找出最適合您的工具!
9 個工具
xix.ai
圖像編輯
用於電商服裝、皮膚清潔和色彩一致性的 Photoshop AI 修圖工具
2026 年最新最佳 Photoshop AI 修圖工具,適用於電商服裝、皮膚清潔和色彩一致性!這份頂級精選列表包含強大的變革性解決方案,可幫助您提升寫作效率、簡化內容創作並輕鬆實現完美的視覺效果。每個工具都經過實際測試,並透過每週更新的排名進行驗證,同時提供免費與付費版本的詳細對比。由 XIX.AI 支援,這是任何希望發揮 AI 優勢的人必試指南。立即探索!
10 個工具
xix.ai
迅速的
適用於 ChatGPT 工作流程的最佳 AI 提示詞庫
2026 年最新、最受好評的 AI 提示詞庫,可優化各類 ChatGPT 工作流程。XIX.AI 精心蒐羅了一套強大且具革命性的精選集合,並經過嚴格的實際測試,以確保其表現卓越。 您可查閱詳盡的免費版與付費版比較分析,以及專家評比,助您挑選必試工具,從而提升工作效率並釋放您的 AI 優勢。立即探索!
11 個工具
xix.ai

 評論 (1)
0/500
![FrankTaylor]()
So GPT-5 is finally here? I'm curious if it can actually tell the difference between a joke and a serious statement this time around 😅
OpenAI 推出了 GPT-5,這是其新的旗艦 AI 模型,將驅動下一代 ChatGPT。
GPT-5 於週四發佈,是 OpenAI 首款統一的 AI 機型,融合了 o 系列機型的推理優勢與 GPT 系列的快速反應能力。此新一代模型標誌著 ChatGPT 與 OpenAI 的新篇章,突顯該公司建立 AI 系統的雄心,其行為更像主動式代理,而非反應式聊天機器人。
GPT-4 可讓 AI 聊天機器人提供各種主題的智慧型答案,而 GPT-5 則可讓 ChatGPT 代表使用者執行任務,例如開發軟體應用程式、管理排程或編寫研究摘要。
OpenAI 在 GPT-5 中也著重讓 ChatGPT 更容易使用。該模型不需要使用者調整設定,而是包含一個即時路由器,可決定最佳的回應方式,無論是快速回答,或是花更多時間推理答案。
在與記者的簡報會中,OpenAI 執行長 Sam Altman 將 GPT-5 描述為「世界上最好的模型」,稱其為朝向開發能在最具經濟價值的工作上勝過人類的人工智能(也稱為人工一般智慧(AGI))邁進的「重要一步」。
Altman 補充:「像 GPT-5 這樣的工具,在歷史上任何其他時刻幾乎都是不可想像的。
自本週四起,GPT-5 將成為所有免費 ChatGPT 使用者的預設模型。根據 OpenAI 的 ChatGPT 副總裁 Nick Turley 所說,此舉首次讓免費使用者可以使用 AI 推理模型。(在此之前,這種先進的模型只保留給付費訂閱者)。
"Turley 表示:「這是我們實現使命的方式之一,確保這些進步能真正造福每個人。
Techcrunch 活動頂尖科技與創投領袖加入 Disrupt 2025 議程
Netflix、ElevenLabs、Wayve 和 Sequoia Capital 等具影響力的公司加入 Disrupt 2025 議程。他們將分享重要的見解,協助初創公司成長並維持競爭力。不要錯過 TechCrunch Disrupt 20 週年慶,這是向科技領導者學習的機會。現在預訂門票,即可在 8 月 7 日漲價前節省高達 675 美元。
頂尖科技與創投領袖加入 Disrupt 2025 議程
Netflix、ElevenLabs、Wayve 和 Sequoia Capital 等具影響力的公司將加入 Disrupt 2025 議程。他們將分享重要的見解,協助新創公司成長並維持競爭力。不要錯過 TechCrunch Disrupt 20 週年慶,這是向科技領導者學習的機會。現在預訂門票,可在價格上漲前節省高達 675 美元。
舊金山|2025 年 10 月 27-29 日立即預訂GPT-5 的期望值極高,標誌著 OpenAI 自 2022 年 ChatGPT 使公司嶄露頭角以來最令人期待的發佈之一。從那時起,ChatGPT 已經成為全球使用最廣泛的消費性產品之一,根據該公司的資料,目前每週有超過 7 億名使用者使用 ChatGPT,約佔全球人口的 10%。
許多人認為 GPT-5 是更廣泛的 AI 進展的風向標,它在矽谷的受歡迎程度可能會對 Big Tech、華爾街和科技政策制定者產生重大影響。利害關係人都在觀察 GPT-5 是否能帶來 AI 能力的大幅躍進,就像其前身 GPT-4 重新定義軟體的功能一樣。
GPT-5 遙遙領先競爭對手
OpenAI 宣稱,GPT-5 在多個領域樹立了新標準,在關鍵基準上略勝 Anthropic、Google DeepMind 和 Elon Musk 的 xAI 等領導模型,但在其他領域則略有不足。
該公司強調 GPT-5 的編碼能力出眾;Altman 指出,該模型擅長依需求產生完整的軟體應用程式,這種能力常被稱為「虛擬編碼」(vibe coding)。
在 SWE-bench Verified 測試中,GPT-5 的首次測試得分率為 74.9%,這項測試是基於 GitHub 的實際編碼任務。這讓它僅次於 Anthropic 的 Claude Opus 4.1 (74.5%) 和 Google DeepMind 的 Gemini 2.5 Pro (59.6%)。
在人類最後一次考試(Humanity's Last Exam)中,GPT-5(GPT-5 Pro)的擴展推理版本在使用工具的情況下獲得了 42% 的高分,這是一項涵蓋數學、人文和科學的嚴格評估。這比 xAI 的 Grok 4 Heavy 略低,後者的得分率為 44.4%。
在 GPQA Diamond(一個博士級科學問題的基準)上,GPT-5 Pro 第一次嘗試就獲得了 89.4% 的成績,優於 Claude Opus 4.1 (80.9%) 和 Grok 4 Heavy (88.9%)。
OpenAI 也報告指出,GPT-5 在健康相關的查詢上表現較佳。在衡量醫療照護回應準確度的 HealthBench Hard Hallucinations 上,GPT-5 (有思考能力) 只有 1.6% 的時間出現幻覺,遠低於 GPT-4o (12.9%) 和 o3 (15.8%)。
雖然 AI 聊天機器人並非醫療專業人員,但仍有數百萬人向他們尋求健康建議。對此,OpenAI 表示,GPT-5 能更主動地標示潛在的健康問題,並協助使用者解讀醫療資訊。
此外,GPT-5 在創意設計和寫作等主觀性較強的領域也很出色。Turley 指出,與競爭對手的模型相比,GPT-5 在創意任務上的反應更自然,也表現出 「更好的品味」。
"Turley 評論道:「這款機型的氣氛真的很好。
GPT-5 也比 OpenAI 早期的模型更精準,而且幻覺(虛構資訊的傾向)更少。幻覺率在最近的推理模型(如 o3)中一直在增加,OpenAI 之前一直難以解釋這種趨勢。
在回應測試中,GPT-5 (含思考) 提供錯誤資訊的比例為 4.8%,比起 o3 (22%) 和 GPT-4o (20.6%) 有顯著的改善。
在測量 AI 代理完成模擬線上任務能力的 Tau-bench 測試中,GPT-5 的成績好壞參半。它在航空公司網站導覽的得分為 63.5%(略低於 o3 的 64.8%),在零售網站導覽的得分為 81.1%(低於 Claude Opus 4.1 的 82.4%)。
OpenAI 也強調,GPT-5 比前一代產品更安全。雖然推理模型有時可能會出現欺騙行為,但 GPT-5 的欺騙率較低,有助於提供更值得信賴的使用者體驗。
安全研究領導人 Alex Beutel 指出,減少欺騙行為不僅能提高安全性,還能讓模型更「透明、誠實,讓使用者可以信賴」。
Beutel 補充說,GPT-5 更能區分惡意濫用與無害請求,因此對不安全的查詢會有更適當的拒絕,而對良性查詢則會減少不必要的拒絕。
針對消費者與開發人員的新功能
除了 GPT-5 版本之外,ChatGPT 還進行了多項使用者體驗升級。使用者現在可以在設定中選擇四種新的回應方式:Cynic、Robot、Listenener 和 Nerd。這些樣式可調整 ChatGPT 的語氣,而不需要明確的指示。
ChatGPT Plus 訂戶 (20 美元/月) 可獲得 GPT-5 的更高使用限制,而 Pro 訂戶 (200 美元/月) 則可獲得無限制使用權以及 GPT-5 Pro - 一個使用額外計算以獲得更佳答案的增強版。Team、Edu 和 Enterprise 客戶將從下周起獲得 GPT-5 作為預設模式。
對開發人員而言,GPT-5 將可透過 OpenAI 的 API 以三種規格提供 - GPT-5、GPT-5-mini 和 GPT-5-nano - 推理深度各不相同。API 現在也包含了動詞控制功能,讓開發人員可以設定所需的回應長度。
基本 GPT-5 模型的價格為每百萬個輸入字元(約 750,000 個字)1.25 美元,每百萬個輸出字元 10 美元。
GPT-5 的推出,正值 OpenAI 忙碌的時期。該公司最近發佈了 gpt-oss,這是一個免費、開放重量的推理模型,幾乎可以媲美早期的頂級模型,如 o3 和 o4-mini。然而,GPT-5 在編碼等領域建立了新的基準。
不過,GPT-5 在許多基準上仍具有競爭力,而不是主導地位。真實世界的效能與開發人員的採用,將最終決定它是否能真正超越競爭對手的模型。








 山姆·奧特曼引發關於人工智慧減速的辯論
在Apple Podcasts上收聽在Spotify上收聽OpenAI執行長薩姆·阿爾特曼(Sam Altman)最近表示,現在可能是時候“控制人工智慧的發展速度”,以便社會“在這些新的能力水平周圍加固自身”。在TechCrunch《Equity》播客的最新一期中,Kirsten Korosec、Sean O’Kane和我討論了阿爾特曼的言論可能由最近的一次駭客攻擊所觸發,該攻擊中一名OpenAI代理突破了Hugging Face的系統。Sean指出,雖然由AI代理執行的駭客攻擊是前所未
 OpenAI 與蘋果公司就商業秘密訴訟進行對抗
OpenAI 於週二駁回了蘋果公司的商業秘密指控,稱該訴訟毫無根據。“我們認真對待這些指控,但未發現任何支援它們的證據,”OpenAI 表示,據彭博社記者 Ed Ludlow 在 X 平臺報道,“我們支援公平競爭和工作自由,專注於創造賦能全球使用者的技術。”此前,蘋果公司於週五在美國加利福尼亞州北區聯邦地區法院提起訴訟,指控 OpenAI 策劃了一項從前蘋果員工處竊取機密資料和智慧財產權的計劃。這份長達 41 頁的訴狀針對 OpenAI 的高管層,包括首席硬體官 Tang Tan,他是一名擁有
 OpenAI機器人專案主管凱特琳·卡利諾夫斯基因五角大樓合作專案辭職
OpenAI 機器人業務負責人凱特琳·卡利諾夫斯基(Caitlin Kalinowski)在該公司與國防部達成備受爭議的合作伙伴關係後辭職。“這不是一個輕鬆的決定,”卡利諾夫斯基在社交媒體宣告中解釋道。“雖然人工智慧在國家安全中發揮著至關重要的作用,但在沒有司法監督的情況下對美國公民進行監視,以及在未經人類授權的情況下部署致命自主武器,都是需要更加慎重考慮的界限。”卡利諾夫斯基此前因領導 Meta 的增強現實眼鏡部門而聞名,她於 2024 年 11 月加入 OpenAI。在辭職信中,她強調她

2026 年最新最佳、評價最高的 AI 大綱生成器,專為長篇 SEO 文章打造,由 XIX.AI 精心精選。這些強大的工具能為快速創作高品質內容提供革命性的協助,大幅提升寫作效率。 透過免費版與付費版的比較、實際測試結果及詳細排名,協助您找出最符合需求且不容錯過的選項。立即探索,釋放您的 AI 優勢。
8 個工具
xix.ai

2026 年最新最佳 AI 學習工具,助您完成作業與備考!XIX.AI 精心整理了一份備受好評的清單,收錄了這些強大且具革命性、經實測驗證的工具,能幫助學生提升效率、簡化作業流程,並在考試中取得優異成績。 獲取免費版與付費版的比較、詳細排名,以及必試選項,以釋放您的 AI 優勢。立即探索!
10 個工具
xix.ai

2026 年最新最佳 AI 人聲演示工具,專為詞曲創作者、旋律創作者和多語言內容團隊打造!XIX.AI 精心整理了一份經過嚴格真實世界測試的高評分、變革性工具列表。您將找到詳細的免費與付費對比資料、全面排名以及必試選項,幫助您提升創作效率並釋放創意潛力。立即探索,發現滿足您所有內容需求的完美工具!
9 個工具
xix.ai

2026 年最新、最佳且評價最高的中小企業 AI 競爭研究工具!XIX.AI 精心精選了一系列極具威力且能改變遊戲規則的工具,並透過嚴謹的實測與詳細排名,每週更新內容。您可在此找到詳盡的免費版與付費版比較,協助您找出必試的工具,以提升工作效率並獲得競爭優勢。 立即探索,找出最適合您的工具!
9 個工具
xix.ai

2026 年最新最佳 Photoshop AI 修圖工具,適用於電商服裝、皮膚清潔和色彩一致性!這份頂級精選列表包含強大的變革性解決方案,可幫助您提升寫作效率、簡化內容創作並輕鬆實現完美的視覺效果。每個工具都經過實際測試,並透過每週更新的排名進行驗證,同時提供免費與付費版本的詳細對比。由 XIX.AI 支援,這是任何希望發揮 AI 優勢的人必試指南。立即探索!
10 個工具
xix.ai

2026 年最新、最受好評的 AI 提示詞庫,可優化各類 ChatGPT 工作流程。XIX.AI 精心蒐羅了一套強大且具革命性的精選集合,並經過嚴格的實際測試,以確保其表現卓越。 您可查閱詳盡的免費版與付費版比較分析,以及專家評比,助您挑選必試工具,從而提升工作效率並釋放您的 AI 優勢。立即探索!
11 個工具
xix.ai

So GPT-5 is finally here? I'm curious if it can actually tell the difference between a joke and a serious statement this time around 😅












