


 首頁
LangChain 總結:比較 Map-Reduce 和 Refine 方法
LangChain 提供強大的自動文字摘要工具,在目前資訊豐富的環境中是不可或缺的。它的 Map-Reduce 和 Refine 技術對於將冗長的文字濃縮成容易閱讀的摘要特別有效。透過瞭解這些方法的運作方式、優勢和限制,開發人員可以針對其特定的應用程式選擇最佳的方法。本部落格將比較 Map-Reduce 和 Refine 方法,檢視它們的機制、實作和理想的使用案例。
重點
Map-Reduce 方法:分別總結個別文字部分,然後合併結果。
精煉方法:透過整合後續每個文字段落的細節,逐步加強摘要。
上下文長度:LLM 一次可分析的最大文字量,會影響摘要策略。
符號數量:測量原始文字中的標記使用量,以有效處理上下文限制。
緩衝區大小:預留額外的標記容量,以避免在摘要過程中超出上下文限制。
瞭解 LangChain 文字摘要
長輸入文字的挑戰
使用大型語言模型進行文字摘要的一大障礙是其上下文容量受限。
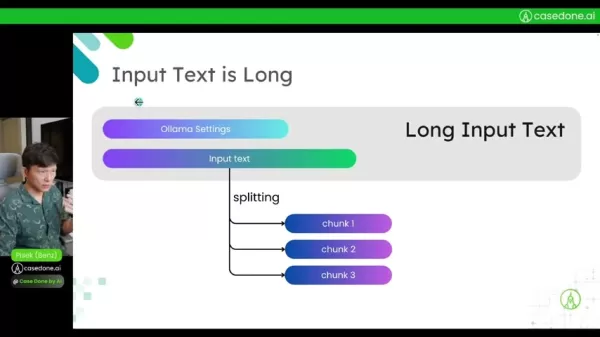
LLM 每次分析只能處理有限的文字量。如果來源文字太長,摘要就會變得不可靠。LangChain 透過將文檔分割成較小的、可行的部分來解決這個問題。
要有效地總結長篇文件,必須將文獻分割成符合模型處理能力的部分。這些方法可以保留所有相關資訊,同時讓模型維持上下文的理解。
將長文本分割成片段有助於 LLM 有效率地處理資訊並建立摘要。Map-Reduce 和 Refine 技術都有助於管理這些分割的資訊。
使用 LangChain 進行文字摘要的兩種方法
LangChain 有兩種主要的摘要策略:Map-Reduce 和 Refine。每種策略都使用不同的方法在上下文限制內工作,並產生精確的摘要。了解這些差異可以幫助開發人員選擇適合他們專案的方法。
- Map-Reduce:此技術會先個別摘要每個文字片段,然後再將它們合併為最終摘要。
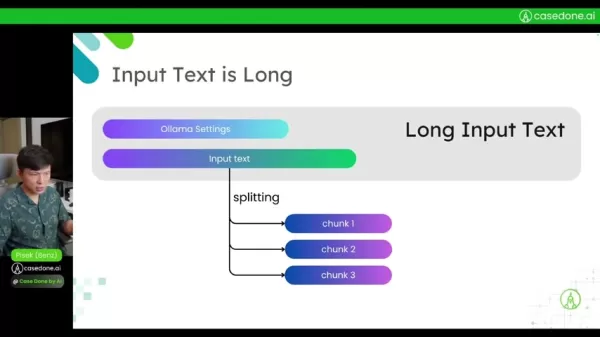
原始文字會被分割成不同的片段,由 LLM 分別進行摘要。然後將這些摘要合併並進一步處理,以建立最終輸出。
- 精煉:這種循序漸進的方法從第一個文字片段的摘要開始,然後透過加入接下來每個片段的資訊來反覆改進。這種循序漸進的精煉方式可以產生更符合上下文的詳細摘要。每種方法都有明顯的優點和缺點,受文件長度、所需摘要品質和可用處理資源等因素影響。
Map-Reduce 方法
主要步驟
Map-Reduce 技術包含兩個主要階段,可將延伸文字轉換為簡明摘要:
- Map 步驟:每個文字區段都會被單獨分析,以產生自己的摘要。
輸入的文字會根據模型的處理能力分成不同的區段。LLM 為每個部分建立摘要,以萃取其重點。
- 還原步驟:將獨立的摘要合併為一個統一的摘要。總結所有區段之後,流程會合併這些總結。合併後的結果再經過其他處理,以產生最終摘要。
Map-Reduce 的優勢
Map-Reduce 方法為某些摘要需求提供了幾項優點:
- 平行處理:初始摘要步驟可以同時執行,對於非常大型的文件,可能會加快處理速度。
- 可擴充性:它可以將文件分割成較小的部分,從而管理異常長的文件。
- 效率:Map-Reduce 可以最佳化使用上下文視窗,讓模型可以從每個文字區段收集重要資訊,並產生高品質的摘要。
Map-Reduce 的限制
儘管 Map-Reduce 方法有其優點,但也有某些缺點:
- 上下文遺失:獨立分析各區段可能會遺漏更廣泛的上下文關聯,可能會降低摘要的精確度。
- 不連貫:如果個別摘要沒有很好地整合,最終摘要可能會缺乏平順的過渡。
- 有限的順序理解:Map-Reduce 可能難以辨識不同文字部分之間的順序關係或依賴關係。
精煉法
優點
初始摘要可擷取第一個片段的資訊。
隨後的片段會逐漸改善摘要。
保留各區段之間的上下文關係。
可達到更佳的主題轉換與流程。
缺點
逐步處理可能需要較多時間。
沒有並行加速處理的選項。
必須依嚴格的順序進行。
摘要截斷
設定摘要長度
建立有效的摘要系統時,必須同時考慮摘要長度和原始文字大小。
建立一個可容納輸入文字和摘要大小的緩衝區,以防止資訊遺失。
摘要長度的關鍵因素包括
- 代號數量:開發人員應該瞭解標記大小,以正確管理文字處理和摘要產生。
- 摘要長度:摘要應簡潔到足以擷取重要資訊,而不會超出上下文限制。
- 緩衝區:計算所有標記的安全緩衝餘量,以正確配置 LLM。
常見問題
什麼是 LangChain?
LangChain 是一個可以簡化使用大型語言模型建立應用程式的框架。它為各種任務提供工具和結構,例如文件處理、查詢解析和文字摘要。LangChain 可讓程式設計師專注於建立智慧型應用程式,而非管理 LLM 的複雜性,進而加速開發。
何時應該使用 Map-Reduce 方法?
Map-Reduce 方法最適合用於摘要非常長的文件,在這種情況下,處理速度和可擴展性是最重要的。當文字片段相當獨立,不需要大量的交叉參考時,也很適合使用 Map-Reduce。如果可以進行平行處理,Map-Reduce 可以大幅縮短處理時間。
何時更適合使用 Refine 方法?
當維持上下文的流暢性和連貫性至關重要時,Refine 方法會比較適合。當文字片段相互關聯,且瞭解資訊的進展對產生精確的摘要至關重要時,這種方法尤其有用。不過,對於特別大的文件,它的連續性會比 Map-Reduce 慢。
相關問題
如何在 LangChain 摘要中優化上下文長度?
優化上下文長度需要在每個摘要階段小心管理文字量。這包括:精確計算源文字、摘要和安全邊界的代幣使用量,調整片段大小以符合上下文限制,同時保留關鍵細節,在摘要前使用修剪或過濾等方法移除非必要的內容,使用 LangChain 整合的代幣計數功能來精確控制上下文。
我可以結合 Map-Reduce 和 Refine 方法來做更好的摘要嗎?
可以,整合 Map-Reduce 和 Refine 方法可以提升摘要結果。結合的策略可以使用 Map-Reduce 來進行主要文件部分的初步摘要,然後應用 Refine 來逐步加強和統一這些摘要,使其成為最後的連貫摘要。這種混合方法可以在處理速度和可擴充性與上下文精確度和邏輯流程之間取得平衡。
相關文章
 馬斯克曾考慮將OpenAI留給他的孩子,而奧特曼正在作證
今早,OpenAI 執行長山姆·阿爾特曼出庭作證,回應前聯合創始人埃隆·馬斯克針對該公司企業結構提起的訴訟。當被問及馬斯克聲稱其他聯合創始人透過成立一家以營利為目的的子公司來推廣基於人工智慧的產品,從而“竊取了一家慈善機構”的說法時,阿爾特曼表現出明顯的猶豫。“這種說法甚至讓人難以理解,”阿爾特曼在停頓後說道,“我們成立的是全球最大的慈善機構之一。該基金會正在開展令人難以置信的工作,並將繼續做更多事情。”馬斯克的律師團隊指出,OpenAI 基金會目前持有的資產價值約為 2000 億美元
山姆·奧特曼引發關於人工智慧減速的辯論
在Apple Podcasts上收聽在Spotify上收聽OpenAI執行長薩姆·阿爾特曼(Sam Altman)最近表示,現在可能是時候“控制人工智慧的發展速度”,以便社會“在這些新的能力水平周圍加固自身”。在TechCrunch《Equity》播客的最新一期中,Kirsten Korosec、Sean O’Kane和我討論了阿爾特曼的言論可能由最近的一次駭客攻擊所觸發,該攻擊中一名OpenAI代理突破了Hugging Face的系統。Sean指出,雖然由AI代理執行的駭客攻擊是前所未
Anthropic 向歐盟網路安全機構開放訪問許可權,因其 Mythos5 模型面臨合規性審查
人工智慧合規法規正在取得重大進展。領先的AI公司Anthropic已正式向歐盟網路安全機構開放其Mythos AI模型的訪問許可權,這是該先進大型語言模型進入歐洲市場並符合當地監管要求的關鍵舉措。此次開放訪問是基於雙方 extensive 對話和談判的結果。歐盟委員會發言人Thomas Regnier確認,在富有建設性的討論之後,歐盟網路安全域性(ENISA)已獲得訪問Mythos5模型的授權,目前正在進行相關測試。這一進展凸顯了歐洲監管機構對前沿AI技術進行的嚴格安全評估。然而,這種訪問許可權並
相關專題推薦
商業
 最適合小型企業的頂尖 AI 競爭情勢分析工具
2026 年最新、最佳且評價最高的中小企業 AI 競爭研究工具!XIX.AI 精心精選了一系列極具威力且能改變遊戲規則的工具,並透過嚴謹的實測與詳細排名,每週更新內容。您可在此找到詳盡的免費版與付費版比較,協助您找出必試的工具,以提升工作效率並獲得競爭優勢。 立即探索,找出最適合您的工具!
 9 個工具
 xix.ai
圖像編輯
用於電商服裝、皮膚清潔和色彩一致性的 Photoshop AI 修圖工具
2026 年最新最佳 Photoshop AI 修圖工具,適用於電商服裝、皮膚清潔和色彩一致性!這份頂級精選列表包含強大的變革性解決方案,可幫助您提升寫作效率、簡化內容創作並輕鬆實現完美的視覺效果。每個工具都經過實際測試,並透過每週更新的排名進行驗證,同時提供免費與付費版本的詳細對比。由 XIX.AI 支援,這是任何希望發揮 AI 優勢的人必試指南。立即探索!
10 個工具
xix.ai
迅速的
適用於 ChatGPT 工作流程的最佳 AI 提示詞庫
2026 年最新、最受好評的 AI 提示詞庫,可優化各類 ChatGPT 工作流程。XIX.AI 精心蒐羅了一套強大且具革命性的精選集合,並經過嚴格的實際測試,以確保其表現卓越。 您可查閱詳盡的免費版與付費版比較分析,以及專家評比,助您挑選必試工具,從而提升工作效率並釋放您的 AI 優勢。立即探索!
11 個工具
xix.ai
教育與學習
面向教師、輔導老師和基於群體的學習專案的 AI 測驗構建平臺
2026年最新最佳AI測驗構建平臺,適用於教師、輔導老師和基於群體的學習專案!XIX.AI精心整理了一份頂級評分列表,包含經過現實世界測試的強力變革性工具,以提供準確的排名。這些必試平臺有助於提高寫作效率、簡化內容創作,並簡化各種學習場景中的測驗設計。立即探索,發現您解鎖教學AI優勢的理想工具!
13 個工具
xix.ai
代碼
適用於 GitHub 團隊處理重構、錯誤及安全漏洞的 AI 拉取請求審查工具
2026 年最新、最優秀的 GitHub 團隊 AI 拉取請求審查工具,就在 XIX.AI!這份精選且評價極高的清單,展示了多款強大且能徹底改變遊戲規則的解決方案,可優化所有團隊工作流程中的重構、錯誤修復及安全漏洞偵測。 透過免費與付費版本的比較、實際測試結果以及詳細排名,協助您找到能顯著提升生產力的完美工具。立即探索,釋放您的 AI 競爭優勢!
12 個工具
xix.ai
文字轉語音
最適合製作自然語音旁白的頂尖 AI 文字轉語音工具
2026 年最新、最受好評的頂級 AI 文字轉語音工具,助您打造自然生動的配音,盡在 XIX.AI!這份精選清單收錄了強大且顛覆業界的選項,能為各種使用情境提供水晶般清晰的語音,並經由實際測試驗證,排行榜更每週更新。 立即獲取免費版與付費版的比較指南,找出能瞬間提升您工作效率的必試解決方案。現在就來探索,解鎖您的 AI 競爭優勢!
11 個工具
xix.ai

 評論 (3)
0/500
![MarkScott]()
Любопытно, как эти методы суммирования справятся с русской художественной литературой — там ведь столько нюансов! Может, попробовать на 'Войне и мире'? 😂
![ThomasLewis]()
なるほど、この記事を読んでLangChainのMap-ReduceとRefine、二つの要約手法の違いが少し見えてきました。長文処理のシーンに合わせて使い分けるのが良さそうですね。技術記事はちょっと硬いですが、実戦での具体的な使用例も知りたいです🤔
![TimothyBaker]()
个人觉得Map-Reduce在批量处理长文档时特别实用👌,不过Refine方法生成的摘要连贯性真的强好多!最近写论文正好需要这类工具,有没有小伙伴试过结合两种方法混合使用呀?
LangChain 提供強大的自動文字摘要工具,在目前資訊豐富的環境中是不可或缺的。它的 Map-Reduce 和 Refine 技術對於將冗長的文字濃縮成容易閱讀的摘要特別有效。透過瞭解這些方法的運作方式、優勢和限制,開發人員可以針對其特定的應用程式選擇最佳的方法。本部落格將比較 Map-Reduce 和 Refine 方法,檢視它們的機制、實作和理想的使用案例。
重點
Map-Reduce 方法:分別總結個別文字部分,然後合併結果。
精煉方法:透過整合後續每個文字段落的細節,逐步加強摘要。
上下文長度:LLM 一次可分析的最大文字量,會影響摘要策略。
符號數量:測量原始文字中的標記使用量,以有效處理上下文限制。
緩衝區大小:預留額外的標記容量,以避免在摘要過程中超出上下文限制。
瞭解 LangChain 文字摘要
長輸入文字的挑戰
使用大型語言模型進行文字摘要的一大障礙是其上下文容量受限。
LLM 每次分析只能處理有限的文字量。如果來源文字太長,摘要就會變得不可靠。LangChain 透過將文檔分割成較小的、可行的部分來解決這個問題。
要有效地總結長篇文件,必須將文獻分割成符合模型處理能力的部分。這些方法可以保留所有相關資訊,同時讓模型維持上下文的理解。
將長文本分割成片段有助於 LLM 有效率地處理資訊並建立摘要。Map-Reduce 和 Refine 技術都有助於管理這些分割的資訊。
使用 LangChain 進行文字摘要的兩種方法
LangChain 有兩種主要的摘要策略:Map-Reduce 和 Refine。每種策略都使用不同的方法在上下文限制內工作,並產生精確的摘要。了解這些差異可以幫助開發人員選擇適合他們專案的方法。
- Map-Reduce:此技術會先個別摘要每個文字片段,然後再將它們合併為最終摘要。
原始文字會被分割成不同的片段,由 LLM 分別進行摘要。然後將這些摘要合併並進一步處理,以建立最終輸出。
- 精煉:這種循序漸進的方法從第一個文字片段的摘要開始,然後透過加入接下來每個片段的資訊來反覆改進。這種循序漸進的精煉方式可以產生更符合上下文的詳細摘要。每種方法都有明顯的優點和缺點,受文件長度、所需摘要品質和可用處理資源等因素影響。
Map-Reduce 方法
主要步驟
Map-Reduce 技術包含兩個主要階段,可將延伸文字轉換為簡明摘要:
- Map 步驟:每個文字區段都會被單獨分析,以產生自己的摘要。
輸入的文字會根據模型的處理能力分成不同的區段。LLM 為每個部分建立摘要,以萃取其重點。
- 還原步驟:將獨立的摘要合併為一個統一的摘要。總結所有區段之後,流程會合併這些總結。合併後的結果再經過其他處理,以產生最終摘要。
Map-Reduce 的優勢
Map-Reduce 方法為某些摘要需求提供了幾項優點:
- 平行處理:初始摘要步驟可以同時執行,對於非常大型的文件,可能會加快處理速度。
- 可擴充性:它可以將文件分割成較小的部分,從而管理異常長的文件。
- 效率:Map-Reduce 可以最佳化使用上下文視窗,讓模型可以從每個文字區段收集重要資訊,並產生高品質的摘要。
Map-Reduce 的限制
儘管 Map-Reduce 方法有其優點,但也有某些缺點:
- 上下文遺失:獨立分析各區段可能會遺漏更廣泛的上下文關聯,可能會降低摘要的精確度。
- 不連貫:如果個別摘要沒有很好地整合,最終摘要可能會缺乏平順的過渡。
- 有限的順序理解:Map-Reduce 可能難以辨識不同文字部分之間的順序關係或依賴關係。
精煉法
優點
初始摘要可擷取第一個片段的資訊。
隨後的片段會逐漸改善摘要。
保留各區段之間的上下文關係。
可達到更佳的主題轉換與流程。
缺點
逐步處理可能需要較多時間。
沒有並行加速處理的選項。
必須依嚴格的順序進行。
摘要截斷
設定摘要長度
建立有效的摘要系統時,必須同時考慮摘要長度和原始文字大小。
建立一個可容納輸入文字和摘要大小的緩衝區,以防止資訊遺失。
摘要長度的關鍵因素包括
- 代號數量:開發人員應該瞭解標記大小,以正確管理文字處理和摘要產生。
- 摘要長度:摘要應簡潔到足以擷取重要資訊,而不會超出上下文限制。
- 緩衝區:計算所有標記的安全緩衝餘量,以正確配置 LLM。
常見問題
什麼是 LangChain?
LangChain 是一個可以簡化使用大型語言模型建立應用程式的框架。它為各種任務提供工具和結構,例如文件處理、查詢解析和文字摘要。LangChain 可讓程式設計師專注於建立智慧型應用程式,而非管理 LLM 的複雜性,進而加速開發。
何時應該使用 Map-Reduce 方法?
Map-Reduce 方法最適合用於摘要非常長的文件,在這種情況下,處理速度和可擴展性是最重要的。當文字片段相當獨立,不需要大量的交叉參考時,也很適合使用 Map-Reduce。如果可以進行平行處理,Map-Reduce 可以大幅縮短處理時間。
何時更適合使用 Refine 方法?
當維持上下文的流暢性和連貫性至關重要時,Refine 方法會比較適合。當文字片段相互關聯,且瞭解資訊的進展對產生精確的摘要至關重要時,這種方法尤其有用。不過,對於特別大的文件,它的連續性會比 Map-Reduce 慢。
相關問題
如何在 LangChain 摘要中優化上下文長度?
優化上下文長度需要在每個摘要階段小心管理文字量。這包括:精確計算源文字、摘要和安全邊界的代幣使用量,調整片段大小以符合上下文限制,同時保留關鍵細節,在摘要前使用修剪或過濾等方法移除非必要的內容,使用 LangChain 整合的代幣計數功能來精確控制上下文。
我可以結合 Map-Reduce 和 Refine 方法來做更好的摘要嗎?
可以,整合 Map-Reduce 和 Refine 方法可以提升摘要結果。結合的策略可以使用 Map-Reduce 來進行主要文件部分的初步摘要,然後應用 Refine 來逐步加強和統一這些摘要,使其成為最後的連貫摘要。這種混合方法可以在處理速度和可擴充性與上下文精確度和邏輯流程之間取得平衡。








 馬斯克曾考慮將OpenAI留給他的孩子,而奧特曼正在作證
今早,OpenAI 執行長山姆·阿爾特曼出庭作證,回應前聯合創始人埃隆·馬斯克針對該公司企業結構提起的訴訟。當被問及馬斯克聲稱其他聯合創始人透過成立一家以營利為目的的子公司來推廣基於人工智慧的產品,從而“竊取了一家慈善機構”的說法時,阿爾特曼表現出明顯的猶豫。“這種說法甚至讓人難以理解,”阿爾特曼在停頓後說道,“我們成立的是全球最大的慈善機構之一。該基金會正在開展令人難以置信的工作,並將繼續做更多事情。”馬斯克的律師團隊指出,OpenAI 基金會目前持有的資產價值約為 2000 億美元
 山姆·奧特曼引發關於人工智慧減速的辯論
在Apple Podcasts上收聽在Spotify上收聽OpenAI執行長薩姆·阿爾特曼(Sam Altman)最近表示,現在可能是時候“控制人工智慧的發展速度”,以便社會“在這些新的能力水平周圍加固自身”。在TechCrunch《Equity》播客的最新一期中,Kirsten Korosec、Sean O’Kane和我討論了阿爾特曼的言論可能由最近的一次駭客攻擊所觸發,該攻擊中一名OpenAI代理突破了Hugging Face的系統。Sean指出,雖然由AI代理執行的駭客攻擊是前所未
 Anthropic 向歐盟網路安全機構開放訪問許可權,因其 Mythos5 模型面臨合規性審查
人工智慧合規法規正在取得重大進展。領先的AI公司Anthropic已正式向歐盟網路安全機構開放其Mythos AI模型的訪問許可權,這是該先進大型語言模型進入歐洲市場並符合當地監管要求的關鍵舉措。此次開放訪問是基於雙方 extensive 對話和談判的結果。歐盟委員會發言人Thomas Regnier確認,在富有建設性的討論之後,歐盟網路安全域性(ENISA)已獲得訪問Mythos5模型的授權,目前正在進行相關測試。這一進展凸顯了歐洲監管機構對前沿AI技術進行的嚴格安全評估。然而,這種訪問許可權並

2026 年最新、最佳且評價最高的中小企業 AI 競爭研究工具!XIX.AI 精心精選了一系列極具威力且能改變遊戲規則的工具,並透過嚴謹的實測與詳細排名,每週更新內容。您可在此找到詳盡的免費版與付費版比較,協助您找出必試的工具,以提升工作效率並獲得競爭優勢。 立即探索,找出最適合您的工具!
9 個工具
xix.ai

2026 年最新最佳 Photoshop AI 修圖工具,適用於電商服裝、皮膚清潔和色彩一致性!這份頂級精選列表包含強大的變革性解決方案,可幫助您提升寫作效率、簡化內容創作並輕鬆實現完美的視覺效果。每個工具都經過實際測試,並透過每週更新的排名進行驗證,同時提供免費與付費版本的詳細對比。由 XIX.AI 支援,這是任何希望發揮 AI 優勢的人必試指南。立即探索!
10 個工具
xix.ai

2026 年最新、最受好評的 AI 提示詞庫,可優化各類 ChatGPT 工作流程。XIX.AI 精心蒐羅了一套強大且具革命性的精選集合,並經過嚴格的實際測試,以確保其表現卓越。 您可查閱詳盡的免費版與付費版比較分析,以及專家評比,助您挑選必試工具,從而提升工作效率並釋放您的 AI 優勢。立即探索!
11 個工具
xix.ai

2026年最新最佳AI測驗構建平臺,適用於教師、輔導老師和基於群體的學習專案!XIX.AI精心整理了一份頂級評分列表,包含經過現實世界測試的強力變革性工具,以提供準確的排名。這些必試平臺有助於提高寫作效率、簡化內容創作,並簡化各種學習場景中的測驗設計。立即探索,發現您解鎖教學AI優勢的理想工具!
13 個工具
xix.ai

2026 年最新、最優秀的 GitHub 團隊 AI 拉取請求審查工具,就在 XIX.AI!這份精選且評價極高的清單,展示了多款強大且能徹底改變遊戲規則的解決方案,可優化所有團隊工作流程中的重構、錯誤修復及安全漏洞偵測。 透過免費與付費版本的比較、實際測試結果以及詳細排名,協助您找到能顯著提升生產力的完美工具。立即探索,釋放您的 AI 競爭優勢!
12 個工具
xix.ai

2026 年最新、最受好評的頂級 AI 文字轉語音工具,助您打造自然生動的配音,盡在 XIX.AI!這份精選清單收錄了強大且顛覆業界的選項,能為各種使用情境提供水晶般清晰的語音,並經由實際測試驗證,排行榜更每週更新。 立即獲取免費版與付費版的比較指南,找出能瞬間提升您工作效率的必試解決方案。現在就來探索,解鎖您的 AI 競爭優勢!
11 個工具
xix.ai

Любопытно, как эти методы суммирования справятся с русской художественной литературой — там ведь столько нюансов! Может, попробовать на 'Войне и мире'? 😂
なるほど、この記事を読んでLangChainのMap-ReduceとRefine、二つの要約手法の違いが少し見えてきました。長文処理のシーンに合わせて使い分けるのが良さそうですね。技術記事はちょっと硬いですが、実戦での具体的な使用例も知りたいです🤔
个人觉得Map-Reduce在批量处理长文档时特别实用👌,不过Refine方法生成的摘要连贯性真的强好多!最近写论文正好需要这类工具,有没有小伙伴试过结合两种方法混合使用呀?












