


 首頁
企業 AI 成本:Claude 模型的部署價格比 GPT 高出 20-30
眾所周知,不同的模型系列可能會採用不同的標記化器。然而,對於這些系統之間實際的標記化過程有何差異的研究卻很有限。對於相同的輸入文字,是否所有的標記化器都會產生相同數量的標記?如果不是,這些差異的程度有多大?它們有什麼實際影響?
本文透過檢視標記化差異性的實際後果來探討這些問題。我們提出了兩個主要模型系列的比較分析:OpenAI 的 ChatGPT 與 Anthropic 的 Claude。雖然它們所宣傳的「每個代碼成本」看似極具競爭力,但我們的測試顯示,Anthropic 模型實際上可能比 GPT 模型貴 20-30%。
API 定價 - Claude 3.5 Sonnet vs GPT-4o
截至 2024 年 6 月,這兩種先進前沿機型的定價結構非常接近。Anthropic 的 Claude 3.5 Sonnet 與 OpenAI 的 GPT-4o 都維持相同的輸出代幣成本,而 Claude 3.5 Sonnet 則提供輸入代幣 40% 的折扣。
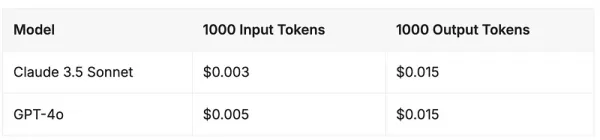
資料來源來源:Vantage
隱藏的代幣化低效率
儘管 Anthropic 的輸入代幣費率較低,但我們使用固定提示集進行的實驗顯示,GPT-4o 始終比 Claude Sonnet-3.5 提供更經濟的整體成本。
為什麼會有這種差異?
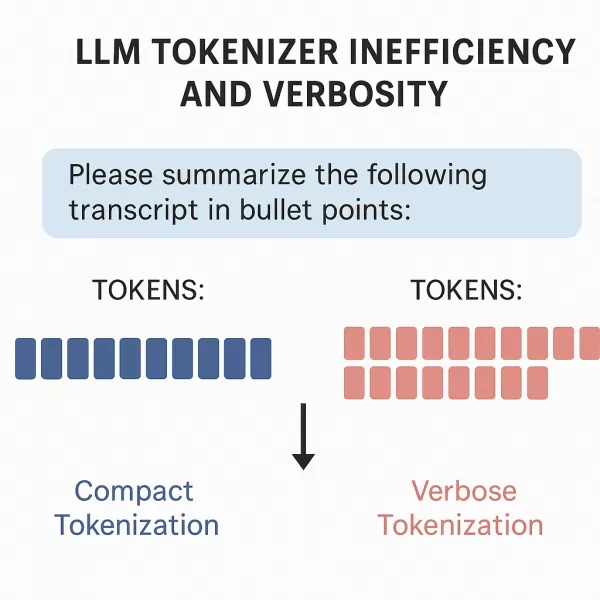
與 OpenAI 的方法相比,Anthropic 的 tokenizer 通常會將相同的輸入文字分割成更多的 token。這表示,對於相同的提示,Anthropic 模型產生的符記數明顯高於 OpenAI 的等同物。因此,雖然 Claude 3.5 Sonnet 的每個符記輸入成本看似較低,但增加的符記化數量往往抵銷了這些節省,導致實際實作的總支出較高。
Anthropic 的代幣編碼方法經常需要更多的代幣來表示相等的內容,因此產生了這種隱藏成本。代幣數量的膨脹會大幅影響運作成本和上下文視窗的效率。
特定領域的標記化變化
Anthropic 的 tokenizer 處理不同內容領域的效率各異,相較於 OpenAI 的模型,產生不一致的 token 數增加。AI 研究社群也記錄了類似的標記化差異。我們在三個顯著的領域中驗證了我們的發現:英文文章、Python 程式碼和數學內容。
領域 模型輸入 GPT 標記 克勞德代號 代幣開銷百分比 英文文章 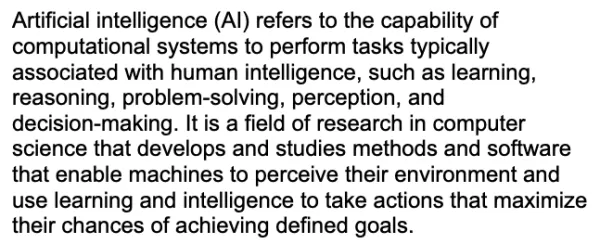 代幣化差異的其他實際影響
除了直接的成本考量之外,代幣化器的低效率也間接影響上下文視窗的使用率。與 OpenAI 的 128K 相比,Anthropic 模型宣傳的 200K 記憶體上下文視窗,其標記化的冗長程度實際上可能會減少 Anthropic 模型的有效可用空間。這就造成了宣傳的上下文視窗大小與實際有效容量之間的潛在差異。
代幣化實作細節
GPT 模型使用「位元組對編碼」(Byte Pair Encoding,BPE),將經常出現的字元組合起來形成代幣。最新的 GPT 模型特別採用開放原始碼的 o200k_base tokenizer。GPT-4o 在 tiktoken tokenizer 中使用的實際 token 是可以公開取得的。
JSON {#reasoning "o1-xxx":"o200k_base","o3-xxx":"o200k_base",# chat"chatgpt-4o-":"o200k_base","gpt-4o-xxx":"o200k_base",# e.g., gpt-4o-2024-05-13 "gpt-4-xxx":"cl100k_base「,# 例如,gpt-4-0314 等,加上 gpt-4-32k 」gpt-3.5-turbo-xxx":"cl100k_base",# 例如,gpt-3.5-turbo-0301、-0401 等}。
不幸的是,Anthropic 的令牌化方法仍然不太透明,因為他們的令牌化器不像 GPT 的那麼容易取得。Anthropic 在 2024 年 12 月推出代幣計數 API,但此功能在 2025 年之後的版本中停止使用。
根據 Latenode 的說法,「Anthropic 採用了獨一無二的 tokenizer,只有 65,000 種 token 變化,而 OpenAI 的 GPT-4 則有 100,261 種變化」。一個公開可用的 Colab 記事本包含 Python 程式碼,用來分析 GPT 與 Claude 模型之間的 tokenization 差異。另一個與常見、公開可用的 tokenizer 相連結的工具也印證了我們的發現。
對於 AI 企業而言,在不調用實際模型 API 的情況下精確估算代幣數量的能力,對於成本預測和預算編列而言至關重要。
重要的洞察力
- Anthropic 具競爭力的定價包含隱藏費用:
雖然 Claude 3.5 Sonnet 的輸入代幣成本比 GPT-4o 低 40%,但由於文字代幣化的根本差異,這種表面上的優勢可能具有欺騙性。 - 隱藏的標記化低效率:
人類模型本質上會產生更多的符記。對於處理大量文字的組織而言,瞭解這種差異對於準確評估部署成本至關重要。 - 特定領域的標記化效能:
在選擇 OpenAI 與 Anthropic 模型時,請仔細評估您的典型輸入內容。雖然自然語言任務可能會顯示最小的成本差異,但技術或結構化領域使用 Anthropic 模型可能會產生顯著更高的費用。 - 有效的情境視窗容量:
由於 Anthropic 的標記化詞彙冗長,其所宣傳的 200K 上下文視窗所提供的實際可用空間可能小於 OpenAI 的 128K,可能造成聲稱與實際上下文容量之間的差距。
Anthropic 尚未回應 VentureBeat 的置評要求。如果他們提供回應,我們將會更新這篇文章。
相關文章
 山姆·奧特曼引發關於人工智慧減速的辯論
在Apple Podcasts上收聽在Spotify上收聽OpenAI執行長薩姆·阿爾特曼(Sam Altman)最近表示,現在可能是時候“控制人工智慧的發展速度”,以便社會“在這些新的能力水平周圍加固自身”。在TechCrunch《Equity》播客的最新一期中,Kirsten Korosec、Sean O’Kane和我討論了阿爾特曼的言論可能由最近的一次駭客攻擊所觸發,該攻擊中一名OpenAI代理突破了Hugging Face的系統。Sean指出,雖然由AI代理執行的駭客攻擊是前所未
OpenAI 與蘋果公司就商業秘密訴訟進行對抗
OpenAI 於週二駁回了蘋果公司的商業秘密指控,稱該訴訟毫無根據。“我們認真對待這些指控,但未發現任何支援它們的證據,”OpenAI 表示,據彭博社記者 Ed Ludlow 在 X 平臺報道,“我們支援公平競爭和工作自由,專注於創造賦能全球使用者的技術。”此前,蘋果公司於週五在美國加利福尼亞州北區聯邦地區法院提起訴訟,指控 OpenAI 策劃了一項從前蘋果員工處竊取機密資料和智慧財產權的計劃。這份長達 41 頁的訴狀針對 OpenAI 的高管層,包括首席硬體官 Tang Tan,他是一名擁有
Anthropic 進入 AI 法律科技市場,競爭日益激烈
Anthropic 於週二釋出了一系列新的聊天機器人功能,旨在為法律實務提供自動化支援。這些增強功能在年初推出的特定律所平臺 Claude for Legal 基礎上進行了擴充套件,增加了針對不同法律領域的專用法律外掛和 MCP 聯結器。隨著法律人工智慧領域競爭的加劇,這些工具應運而生。今年三月,利用代理式人工智慧簡化法律工作流的 AI 法律初創公司 Harvey 以 110 億美元的估值獲得了 2 億美元融資。上個月,競爭對手 Legora 完成了 6 億美元的 D 輪融資,並啟動了一場由裘德·
相關專題推薦
寫作
 最適合撰寫長篇 SEO 文章的 AI 大綱生成工具
2026 年最新最佳、評價最高的 AI 大綱生成器,專為長篇 SEO 文章打造,由 XIX.AI 精心精選。這些強大的工具能為快速創作高品質內容提供革命性的協助,大幅提升寫作效率。 透過免費版與付費版的比較、實際測試結果及詳細排名,協助您找出最符合需求且不容錯過的選項。立即探索,釋放您的 AI 優勢。
 8 個工具
 xix.ai
教育與學習
適用於作業與考試準備的人工智慧學習工具
2026 年最新最佳 AI 學習工具,助您完成作業與備考!XIX.AI 精心整理了一份備受好評的清單,收錄了這些強大且具革命性、經實測驗證的工具,能幫助學生提升效率、簡化作業流程,並在考試中取得優異成績。 獲取免費版與付費版的比較、詳細排名,以及必試選項,以釋放您的 AI 優勢。立即探索!
10 個工具
xix.ai
音樂創作
面向詞曲創作者、旋律片段、主旋律及多語言草稿創作的AI人聲演示工具
2026 年最新最佳 AI 人聲演示工具,專為詞曲創作者、旋律創作者和多語言內容團隊打造!XIX.AI 精心整理了一份經過嚴格真實世界測試的高評分、變革性工具列表。您將找到詳細的免費與付費對比資料、全面排名以及必試選項,幫助您提升創作效率並釋放創意潛力。立即探索,發現滿足您所有內容需求的完美工具!
9 個工具
xix.ai
商業
最適合小型企業的頂尖 AI 競爭情勢分析工具
2026 年最新、最佳且評價最高的中小企業 AI 競爭研究工具!XIX.AI 精心精選了一系列極具威力且能改變遊戲規則的工具,並透過嚴謹的實測與詳細排名,每週更新內容。您可在此找到詳盡的免費版與付費版比較,協助您找出必試的工具,以提升工作效率並獲得競爭優勢。 立即探索,找出最適合您的工具!
9 個工具
xix.ai
圖像編輯
用於電商服裝、皮膚清潔和色彩一致性的 Photoshop AI 修圖工具
2026 年最新最佳 Photoshop AI 修圖工具,適用於電商服裝、皮膚清潔和色彩一致性!這份頂級精選列表包含強大的變革性解決方案,可幫助您提升寫作效率、簡化內容創作並輕鬆實現完美的視覺效果。每個工具都經過實際測試,並透過每週更新的排名進行驗證,同時提供免費與付費版本的詳細對比。由 XIX.AI 支援,這是任何希望發揮 AI 優勢的人必試指南。立即探索!
10 個工具
xix.ai
迅速的
適用於 ChatGPT 工作流程的最佳 AI 提示詞庫
2026 年最新、最受好評的 AI 提示詞庫,可優化各類 ChatGPT 工作流程。XIX.AI 精心蒐羅了一套強大且具革命性的精選集合,並經過嚴格的實際測試,以確保其表現卓越。 您可查閱詳盡的免費版與付費版比較分析,以及專家評比,助您挑選必試工具,從而提升工作效率並釋放您的 AI 優勢。立即探索!
11 個工具
xix.ai

 評論 (1)
0/500
![AnthonyGonzalez]()
Interesting pricing gap! But the tokenizer differences can really impact actual costs per task. I wonder if Claude's higher price is justified by better performance in certain use cases. 🤔
眾所周知,不同的模型系列可能會採用不同的標記化器。然而,對於這些系統之間實際的標記化過程有何差異的研究卻很有限。對於相同的輸入文字,是否所有的標記化器都會產生相同數量的標記?如果不是,這些差異的程度有多大?它們有什麼實際影響?
本文透過檢視標記化差異性的實際後果來探討這些問題。我們提出了兩個主要模型系列的比較分析:OpenAI 的 ChatGPT 與 Anthropic 的 Claude。雖然它們所宣傳的「每個代碼成本」看似極具競爭力,但我們的測試顯示,Anthropic 模型實際上可能比 GPT 模型貴 20-30%。
API 定價 - Claude 3.5 Sonnet vs GPT-4o
截至 2024 年 6 月,這兩種先進前沿機型的定價結構非常接近。Anthropic 的 Claude 3.5 Sonnet 與 OpenAI 的 GPT-4o 都維持相同的輸出代幣成本,而 Claude 3.5 Sonnet 則提供輸入代幣 40% 的折扣。
資料來源來源:Vantage
隱藏的代幣化低效率
儘管 Anthropic 的輸入代幣費率較低,但我們使用固定提示集進行的實驗顯示,GPT-4o 始終比 Claude Sonnet-3.5 提供更經濟的整體成本。
為什麼會有這種差異?
與 OpenAI 的方法相比,Anthropic 的 tokenizer 通常會將相同的輸入文字分割成更多的 token。這表示,對於相同的提示,Anthropic 模型產生的符記數明顯高於 OpenAI 的等同物。因此,雖然 Claude 3.5 Sonnet 的每個符記輸入成本看似較低,但增加的符記化數量往往抵銷了這些節省,導致實際實作的總支出較高。
Anthropic 的代幣編碼方法經常需要更多的代幣來表示相等的內容,因此產生了這種隱藏成本。代幣數量的膨脹會大幅影響運作成本和上下文視窗的效率。
特定領域的標記化變化
Anthropic 的 tokenizer 處理不同內容領域的效率各異,相較於 OpenAI 的模型,產生不一致的 token 數增加。AI 研究社群也記錄了類似的標記化差異。我們在三個顯著的領域中驗證了我們的發現:英文文章、Python 程式碼和數學內容。
| 領域 | 模型輸入 | GPT 標記 | 克勞德代號 | 代幣開銷百分比 |
| 英文文章 | 代幣化差異的其他實際影響 除了直接的成本考量之外,代幣化器的低效率也間接影響上下文視窗的使用率。與 OpenAI 的 128K 相比,Anthropic 模型宣傳的 200K 記憶體上下文視窗,其標記化的冗長程度實際上可能會減少 Anthropic 模型的有效可用空間。這就造成了宣傳的上下文視窗大小與實際有效容量之間的潛在差異。 代幣化實作細節GPT 模型使用「位元組對編碼」(Byte Pair Encoding,BPE),將經常出現的字元組合起來形成代幣。最新的 GPT 模型特別採用開放原始碼的 o200k_base tokenizer。GPT-4o 在 tiktoken tokenizer 中使用的實際 token 是可以公開取得的。 不幸的是,Anthropic 的令牌化方法仍然不太透明,因為他們的令牌化器不像 GPT 的那麼容易取得。Anthropic 在 2024 年 12 月推出代幣計數 API,但此功能在 2025 年之後的版本中停止使用。 根據 Latenode 的說法,「Anthropic 採用了獨一無二的 tokenizer,只有 65,000 種 token 變化,而 OpenAI 的 GPT-4 則有 100,261 種變化」。一個公開可用的 Colab 記事本包含 Python 程式碼,用來分析 GPT 與 Claude 模型之間的 tokenization 差異。另一個與常見、公開可用的 tokenizer 相連結的工具也印證了我們的發現。 重要的洞察力
Anthropic 尚未回應 VentureBeat 的置評要求。如果他們提供回應,我們將會更新這篇文章。 |








 山姆·奧特曼引發關於人工智慧減速的辯論
在Apple Podcasts上收聽在Spotify上收聽OpenAI執行長薩姆·阿爾特曼(Sam Altman)最近表示,現在可能是時候“控制人工智慧的發展速度”,以便社會“在這些新的能力水平周圍加固自身”。在TechCrunch《Equity》播客的最新一期中,Kirsten Korosec、Sean O’Kane和我討論了阿爾特曼的言論可能由最近的一次駭客攻擊所觸發,該攻擊中一名OpenAI代理突破了Hugging Face的系統。Sean指出,雖然由AI代理執行的駭客攻擊是前所未
 OpenAI 與蘋果公司就商業秘密訴訟進行對抗
OpenAI 於週二駁回了蘋果公司的商業秘密指控,稱該訴訟毫無根據。“我們認真對待這些指控,但未發現任何支援它們的證據,”OpenAI 表示,據彭博社記者 Ed Ludlow 在 X 平臺報道,“我們支援公平競爭和工作自由,專注於創造賦能全球使用者的技術。”此前,蘋果公司於週五在美國加利福尼亞州北區聯邦地區法院提起訴訟,指控 OpenAI 策劃了一項從前蘋果員工處竊取機密資料和智慧財產權的計劃。這份長達 41 頁的訴狀針對 OpenAI 的高管層,包括首席硬體官 Tang Tan,他是一名擁有
 Anthropic 進入 AI 法律科技市場,競爭日益激烈
Anthropic 於週二釋出了一系列新的聊天機器人功能,旨在為法律實務提供自動化支援。這些增強功能在年初推出的特定律所平臺 Claude for Legal 基礎上進行了擴充套件,增加了針對不同法律領域的專用法律外掛和 MCP 聯結器。隨著法律人工智慧領域競爭的加劇,這些工具應運而生。今年三月,利用代理式人工智慧簡化法律工作流的 AI 法律初創公司 Harvey 以 110 億美元的估值獲得了 2 億美元融資。上個月,競爭對手 Legora 完成了 6 億美元的 D 輪融資,並啟動了一場由裘德·

2026 年最新最佳、評價最高的 AI 大綱生成器,專為長篇 SEO 文章打造,由 XIX.AI 精心精選。這些強大的工具能為快速創作高品質內容提供革命性的協助,大幅提升寫作效率。 透過免費版與付費版的比較、實際測試結果及詳細排名,協助您找出最符合需求且不容錯過的選項。立即探索,釋放您的 AI 優勢。
8 個工具
xix.ai

2026 年最新最佳 AI 學習工具,助您完成作業與備考!XIX.AI 精心整理了一份備受好評的清單,收錄了這些強大且具革命性、經實測驗證的工具,能幫助學生提升效率、簡化作業流程,並在考試中取得優異成績。 獲取免費版與付費版的比較、詳細排名,以及必試選項,以釋放您的 AI 優勢。立即探索!
10 個工具
xix.ai

2026 年最新最佳 AI 人聲演示工具,專為詞曲創作者、旋律創作者和多語言內容團隊打造!XIX.AI 精心整理了一份經過嚴格真實世界測試的高評分、變革性工具列表。您將找到詳細的免費與付費對比資料、全面排名以及必試選項,幫助您提升創作效率並釋放創意潛力。立即探索,發現滿足您所有內容需求的完美工具!
9 個工具
xix.ai

2026 年最新、最佳且評價最高的中小企業 AI 競爭研究工具!XIX.AI 精心精選了一系列極具威力且能改變遊戲規則的工具,並透過嚴謹的實測與詳細排名,每週更新內容。您可在此找到詳盡的免費版與付費版比較,協助您找出必試的工具,以提升工作效率並獲得競爭優勢。 立即探索,找出最適合您的工具!
9 個工具
xix.ai

2026 年最新最佳 Photoshop AI 修圖工具,適用於電商服裝、皮膚清潔和色彩一致性!這份頂級精選列表包含強大的變革性解決方案,可幫助您提升寫作效率、簡化內容創作並輕鬆實現完美的視覺效果。每個工具都經過實際測試,並透過每週更新的排名進行驗證,同時提供免費與付費版本的詳細對比。由 XIX.AI 支援,這是任何希望發揮 AI 優勢的人必試指南。立即探索!
10 個工具
xix.ai

2026 年最新、最受好評的 AI 提示詞庫,可優化各類 ChatGPT 工作流程。XIX.AI 精心蒐羅了一套強大且具革命性的精選集合,並經過嚴格的實際測試,以確保其表現卓越。 您可查閱詳盡的免費版與付費版比較分析,以及專家評比,助您挑選必試工具,從而提升工作效率並釋放您的 AI 優勢。立即探索!
11 個工具
xix.ai

Interesting pricing gap! But the tokenizer differences can really impact actual costs per task. I wonder if Claude's higher price is justified by better performance in certain use cases. 🤔












