


 首頁
阿里巴巴的開源 Qwen AI 模型打破推理紀錄
阿里巴巴的 Qwen 團隊推出了新版本的開源推理 AI 模型,展示了非凡的基準結果。
Introducing Qwen3-235B-A22B-Thinking-2507.在過去的三個月裡,Qwen 團隊一直在強化模型的「思考能力」,努力提升推理過程的質量和深度。
其結果是,該模型在邏輯推理、複雜數學、科學挑戰和先進編碼等要求最嚴苛的領域中真正大放異彩。在通常需要人類專業知識的領域中,最新的 Qwen 模型為開源 AI 設定了新的標準。
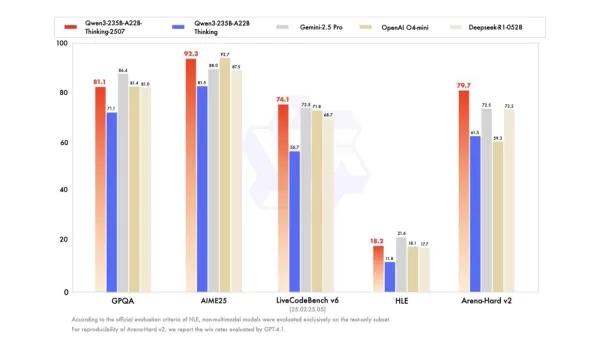
在推理基準上,Qwen 最新的開源 AI 模型在 AIME25 上獲得 92.3 分,在 LiveCodeBench v6 的編碼上獲得 74.1 分。它在更廣泛的能力評估中也表現優異,在Arena-Hard v2(一項評估與人類偏好一致性的指標)中獲得79.7分。
基本上,這是來自 Qwen 團隊的大型推理 AI 模型,總共擁有 2,350 億個參數。然而,它採用的是 Mixture-of-Experts (MoE) 架構,意即在任何特定時間,只有這些參數的子集 (約 220 億個) 處於活躍狀態。將它想像成一個由 128 位待命專家組成的龐大團隊,但實際上只有最頂尖的八位專家在處理特定任務。
它最突出的特質之一就是超強的記憶體容量。Qwen 的開放原始碼推理 AI 模型原生支援 262,144 個字元的上下文長度,為需要理解大量資訊的任務提供了顯著的優勢。
對於開發者和愛好者而言,Qwen 團隊簡化了入門流程。該模型可在 Hugging Face 上存取,並可使用 sglang 或 vllm 等工具來設定個人 API 端點。該團隊也強調他們的 Qwen-Agent 框架是利用模型的工具呼叫功能的最佳方法。
為了讓這個開放原始碼的 AI 推理模型達到最佳效能,Qwen 團隊提供了幾項建議。他們建議標準任務的輸出長度約為 32,768 個字元,但對於高度複雜的問題,可增加至 81,920 個字元,讓 AI 有足夠的空間「思考」。他們也建議在您的提示中使用明確的指示,例如針對數學問題要求「逐步推理」的方法,以獲得最精確、最有條理的回覆。
全新 Qwen 模型的推出,提供了一個強大、開放源碼的推理人工智能,能夠與領先的專利模型競爭,尤其是在處理複雜、智力要求高的挑戰時。觀察開發者社群如何運用這項技術,將會是一件非常有趣的事。
另請參閱:AI 行動計劃:美國的領導地位不容挑戰
有興趣從業界專家身上加深您對 AI 和大資料的認識嗎?參加在阿姆斯特丹、加州和倫敦舉行的 AI & Big Data Expo。這項綜合活動與其他大型會議同時舉行,包括智慧自動化會議 (Intelligent Automation Conference)、BlockX、數位轉型週 (Digital Transformation Week),以及網路安全與雲端博覽會 (Cyber Security & Cloud Expo)。
在此瞭解更多由 TechForge 提供的即將舉行的企業技術活動和網路研討會。
相關文章
 Google 測試 Remy AI 代理,以 Gemini 為重點轉向使用者控制
根據《商業內幕》的報道,谷歌正在測試 Remy,這是 Gemini 的一款全新 AI 個人代理工具。該工具旨在代表使用者執行任務,從而簡化專業工作流程和日常事務。目前,Remy 正在 Gemini 應用的內部員工專屬版本中進行測試。該報告引用了一份內部檔案以及對兩位熟悉該專案的個人的採訪。內部資料將 Remy 描述為“全天候個人代理”,將 Gemini 定位為能夠代表使用者行事的主動助手。接近該專案的訊息人士證實,谷歌員工正在積極測試 Remy。谷歌發言人拒絕提供進一步評論。該報告未提及公開發布
奧利押注隱私保護,力爭在 AI 助理競賽中勝出
要真正發揮實用價值,人工智慧助理必須深入了解其使用者。Ollie 是一款專為日常生活設計的個人助理,其運作前提是:這無需您交出個人資料,亦不會損害您的隱私。雖然某些企業級 AI 工具提供資料隱私保障,但 Ollie 作為首批獲得 SOC 2 合規認證的主流、以家庭為導向的 AI 服務之一,顯得格外突出。此框架允許企業透過獨立稽核證明,其已建立正式的管控措施來保護客戶資料,並確保系統運作的安全性。達
「AI LIVE:倫敦」將如何探討人工智慧與工業自動化
本次峰會將匯聚來自全球的高階主管,共同探討全球產業面臨的迫切挑戰,涵蓋範圍從人工智慧驅動的顛覆性變革到經濟波動。AI LIVE:倫敦峰會將以「科技+人類使命」為主題,匯聚逾 2,000 位國際領袖,共同探討人工智慧新興時代的發展。隸屬於 BizClik 旗下的《AI Magazine》已公佈其於「AI LIVE:倫敦峰會」上舉辦的「人工智慧與工業自動化」聯合爐邊談話的與會陣容。該座談會定於 10
相關專題推薦
寫作
 最適合撰寫長篇 SEO 文章的 AI 大綱生成工具
2026 年最新最佳、評價最高的 AI 大綱生成器,專為長篇 SEO 文章打造,由 XIX.AI 精心精選。這些強大的工具能為快速創作高品質內容提供革命性的協助,大幅提升寫作效率。 透過免費版與付費版的比較、實際測試結果及詳細排名,協助您找出最符合需求且不容錯過的選項。立即探索,釋放您的 AI 優勢。
 8 個工具
 xix.ai
教育與學習
適用於作業與考試準備的人工智慧學習工具
2026 年最新最佳 AI 學習工具,助您完成作業與備考!XIX.AI 精心整理了一份備受好評的清單,收錄了這些強大且具革命性、經實測驗證的工具,能幫助學生提升效率、簡化作業流程,並在考試中取得優異成績。 獲取免費版與付費版的比較、詳細排名,以及必試選項,以釋放您的 AI 優勢。立即探索!
10 個工具
xix.ai
音樂創作
面向詞曲創作者、旋律片段、主旋律及多語言草稿創作的AI人聲演示工具
2026 年最新最佳 AI 人聲演示工具,專為詞曲創作者、旋律創作者和多語言內容團隊打造!XIX.AI 精心整理了一份經過嚴格真實世界測試的高評分、變革性工具列表。您將找到詳細的免費與付費對比資料、全面排名以及必試選項,幫助您提升創作效率並釋放創意潛力。立即探索,發現滿足您所有內容需求的完美工具!
9 個工具
xix.ai
商業
最適合小型企業的頂尖 AI 競爭情勢分析工具
2026 年最新、最佳且評價最高的中小企業 AI 競爭研究工具!XIX.AI 精心精選了一系列極具威力且能改變遊戲規則的工具,並透過嚴謹的實測與詳細排名,每週更新內容。您可在此找到詳盡的免費版與付費版比較,協助您找出必試的工具,以提升工作效率並獲得競爭優勢。 立即探索,找出最適合您的工具!
9 個工具
xix.ai
圖像編輯
用於電商服裝、皮膚清潔和色彩一致性的 Photoshop AI 修圖工具
2026 年最新最佳 Photoshop AI 修圖工具,適用於電商服裝、皮膚清潔和色彩一致性!這份頂級精選列表包含強大的變革性解決方案,可幫助您提升寫作效率、簡化內容創作並輕鬆實現完美的視覺效果。每個工具都經過實際測試,並透過每週更新的排名進行驗證,同時提供免費與付費版本的詳細對比。由 XIX.AI 支援,這是任何希望發揮 AI 優勢的人必試指南。立即探索!
10 個工具
xix.ai
迅速的
適用於 ChatGPT 工作流程的最佳 AI 提示詞庫
2026 年最新、最受好評的 AI 提示詞庫,可優化各類 ChatGPT 工作流程。XIX.AI 精心蒐羅了一套強大且具革命性的精選集合,並經過嚴格的實際測試,以確保其表現卓越。 您可查閱詳盡的免費版與付費版比較分析,以及專家評比,助您挑選必試工具,從而提升工作效率並釋放您的 AI 優勢。立即探索!
11 個工具
xix.ai

 評論 (1)
0/500
![HaroldMoore]()
AlibabaのオープンソースAIがまたすごい成果を出しましたね!Qwenの推論能力、本当に進化が早い。最近は色んな企業が自社モデルを公開して競争が激しいけど、オープンソースでここまでできると、商用モデルもプレッシャー感じるんじゃないかな?個人的には、こういう技術がもっと手軽に使えるようになったら、普段の仕事の効率も上がりそうで楽しみです✨
阿里巴巴的 Qwen 團隊推出了新版本的開源推理 AI 模型,展示了非凡的基準結果。
Introducing Qwen3-235B-A22B-Thinking-2507.在過去的三個月裡,Qwen 團隊一直在強化模型的「思考能力」,努力提升推理過程的質量和深度。
其結果是,該模型在邏輯推理、複雜數學、科學挑戰和先進編碼等要求最嚴苛的領域中真正大放異彩。在通常需要人類專業知識的領域中,最新的 Qwen 模型為開源 AI 設定了新的標準。
在推理基準上,Qwen 最新的開源 AI 模型在 AIME25 上獲得 92.3 分,在 LiveCodeBench v6 的編碼上獲得 74.1 分。它在更廣泛的能力評估中也表現優異,在Arena-Hard v2(一項評估與人類偏好一致性的指標)中獲得79.7分。
基本上,這是來自 Qwen 團隊的大型推理 AI 模型,總共擁有 2,350 億個參數。然而,它採用的是 Mixture-of-Experts (MoE) 架構,意即在任何特定時間,只有這些參數的子集 (約 220 億個) 處於活躍狀態。將它想像成一個由 128 位待命專家組成的龐大團隊,但實際上只有最頂尖的八位專家在處理特定任務。
它最突出的特質之一就是超強的記憶體容量。Qwen 的開放原始碼推理 AI 模型原生支援 262,144 個字元的上下文長度,為需要理解大量資訊的任務提供了顯著的優勢。
對於開發者和愛好者而言,Qwen 團隊簡化了入門流程。該模型可在 Hugging Face 上存取,並可使用 sglang 或 vllm 等工具來設定個人 API 端點。該團隊也強調他們的 Qwen-Agent 框架是利用模型的工具呼叫功能的最佳方法。
為了讓這個開放原始碼的 AI 推理模型達到最佳效能,Qwen 團隊提供了幾項建議。他們建議標準任務的輸出長度約為 32,768 個字元,但對於高度複雜的問題,可增加至 81,920 個字元,讓 AI 有足夠的空間「思考」。他們也建議在您的提示中使用明確的指示,例如針對數學問題要求「逐步推理」的方法,以獲得最精確、最有條理的回覆。
全新 Qwen 模型的推出,提供了一個強大、開放源碼的推理人工智能,能夠與領先的專利模型競爭,尤其是在處理複雜、智力要求高的挑戰時。觀察開發者社群如何運用這項技術,將會是一件非常有趣的事。
另請參閱:AI 行動計劃:美國的領導地位不容挑戰
有興趣從業界專家身上加深您對 AI 和大資料的認識嗎?參加在阿姆斯特丹、加州和倫敦舉行的 AI & Big Data Expo。這項綜合活動與其他大型會議同時舉行,包括智慧自動化會議 (Intelligent Automation Conference)、BlockX、數位轉型週 (Digital Transformation Week),以及網路安全與雲端博覽會 (Cyber Security & Cloud Expo)。
在此瞭解更多由 TechForge 提供的即將舉行的企業技術活動和網路研討會。







 Google 測試 Remy AI 代理,以 Gemini 為重點轉向使用者控制
根據《商業內幕》的報道,谷歌正在測試 Remy,這是 Gemini 的一款全新 AI 個人代理工具。該工具旨在代表使用者執行任務,從而簡化專業工作流程和日常事務。目前,Remy 正在 Gemini 應用的內部員工專屬版本中進行測試。該報告引用了一份內部檔案以及對兩位熟悉該專案的個人的採訪。內部資料將 Remy 描述為“全天候個人代理”,將 Gemini 定位為能夠代表使用者行事的主動助手。接近該專案的訊息人士證實,谷歌員工正在積極測試 Remy。谷歌發言人拒絕提供進一步評論。該報告未提及公開發布
 奧利押注隱私保護,力爭在 AI 助理競賽中勝出
要真正發揮實用價值,人工智慧助理必須深入了解其使用者。Ollie 是一款專為日常生活設計的個人助理,其運作前提是:這無需您交出個人資料,亦不會損害您的隱私。雖然某些企業級 AI 工具提供資料隱私保障,但 Ollie 作為首批獲得 SOC 2 合規認證的主流、以家庭為導向的 AI 服務之一,顯得格外突出。此框架允許企業透過獨立稽核證明,其已建立正式的管控措施來保護客戶資料,並確保系統運作的安全性。達
 「AI LIVE:倫敦」將如何探討人工智慧與工業自動化
本次峰會將匯聚來自全球的高階主管,共同探討全球產業面臨的迫切挑戰,涵蓋範圍從人工智慧驅動的顛覆性變革到經濟波動。AI LIVE:倫敦峰會將以「科技+人類使命」為主題,匯聚逾 2,000 位國際領袖,共同探討人工智慧新興時代的發展。隸屬於 BizClik 旗下的《AI Magazine》已公佈其於「AI LIVE:倫敦峰會」上舉辦的「人工智慧與工業自動化」聯合爐邊談話的與會陣容。該座談會定於 10

2026 年最新最佳、評價最高的 AI 大綱生成器,專為長篇 SEO 文章打造,由 XIX.AI 精心精選。這些強大的工具能為快速創作高品質內容提供革命性的協助,大幅提升寫作效率。 透過免費版與付費版的比較、實際測試結果及詳細排名,協助您找出最符合需求且不容錯過的選項。立即探索,釋放您的 AI 優勢。
8 個工具
xix.ai

2026 年最新最佳 AI 學習工具,助您完成作業與備考!XIX.AI 精心整理了一份備受好評的清單,收錄了這些強大且具革命性、經實測驗證的工具,能幫助學生提升效率、簡化作業流程,並在考試中取得優異成績。 獲取免費版與付費版的比較、詳細排名,以及必試選項,以釋放您的 AI 優勢。立即探索!
10 個工具
xix.ai

2026 年最新最佳 AI 人聲演示工具,專為詞曲創作者、旋律創作者和多語言內容團隊打造!XIX.AI 精心整理了一份經過嚴格真實世界測試的高評分、變革性工具列表。您將找到詳細的免費與付費對比資料、全面排名以及必試選項,幫助您提升創作效率並釋放創意潛力。立即探索,發現滿足您所有內容需求的完美工具!
9 個工具
xix.ai

2026 年最新、最佳且評價最高的中小企業 AI 競爭研究工具!XIX.AI 精心精選了一系列極具威力且能改變遊戲規則的工具,並透過嚴謹的實測與詳細排名,每週更新內容。您可在此找到詳盡的免費版與付費版比較,協助您找出必試的工具,以提升工作效率並獲得競爭優勢。 立即探索,找出最適合您的工具!
9 個工具
xix.ai

2026 年最新最佳 Photoshop AI 修圖工具,適用於電商服裝、皮膚清潔和色彩一致性!這份頂級精選列表包含強大的變革性解決方案,可幫助您提升寫作效率、簡化內容創作並輕鬆實現完美的視覺效果。每個工具都經過實際測試,並透過每週更新的排名進行驗證,同時提供免費與付費版本的詳細對比。由 XIX.AI 支援,這是任何希望發揮 AI 優勢的人必試指南。立即探索!
10 個工具
xix.ai

2026 年最新、最受好評的 AI 提示詞庫,可優化各類 ChatGPT 工作流程。XIX.AI 精心蒐羅了一套強大且具革命性的精選集合,並經過嚴格的實際測試,以確保其表現卓越。 您可查閱詳盡的免費版與付費版比較分析,以及專家評比,助您挑選必試工具,從而提升工作效率並釋放您的 AI 優勢。立即探索!
11 個工具
xix.ai

AlibabaのオープンソースAIがまたすごい成果を出しましたね!Qwenの推論能力、本当に進化が早い。最近は色んな企業が自社モデルを公開して競争が激しいけど、オープンソースでここまでできると、商用モデルもプレッシャー感じるんじゃないかな?個人的には、こういう技術がもっと手軽に使えるようになったら、普段の仕事の効率も上がりそうで楽しみです✨












